SQLAlchemy
معمارية تطبيقات المصادر المفتوحة (المجلد الثاني)SQLAlchemy
معمارية تطبيقات المصادر المفتوحة (المجلد الثاني) SQLAlchemy
مايكل باير
إن استمتعت بهذه الكتب، فقد يعجبك أيضًا التصميم البرمجي بالأمثلة في Python والتصميم البرمجي بالأمثلة في JavaScript.
SQLAlchemy مجموعة أدوات لقواعد البيانات ونظام رسم خرائط الكائنات والعلاقات (Object-Relational Mapping, ORM) للغة البرمجة Python، ظهرت أولًا عام 2005. ومنذ بدايتها سعى إلى توفير نظام متكامل من طرف إلى طرف للعمل مع قواعد البيانات العلائقية في Python، مستخدمًا واجهة بايثون لقواعد البيانات (Python Database API, DBAPI) في التفاعل مع قاعدة البيانات. وحتى في إصداراتها الأولى لفتت قدرات SQLAlchemy انتباهًا كبيرًا. وتشمل ميزاتها الرئيسة رفةً عالية في التعامل مع استعلامات SQL المعقّدة وعمليات تعيين الكائنات، فضلًا عن تنفيذ لنمط «وحدة العمل» (unit of work)، الذي يوفّر نظامًا آليًّا إلى حدٍّ كبير لحفظ البيانات في قاعدة البيانات.
انطلقت SQLAlchemy من مفهوم صغير لم يكتمل تطبيقه بعد، ثم أحرزت تقدّمًا سريعًا عبر سلسلة من التحويلات وإعادة الصوغة، إذ كانت تطرح دورات جديدة من معماريتها الداخلية وواجهتها العلنية بالتوازي مع نمو قاعدة مستخدميها. وحلول إصدار النسخة 0.5 في يناير من عام 2009، بدأت SQLAlchemy تكتسب صورةً مستقرة ثبتت جدارتها في مجموعة واسعة من عمليات النشر الإنتاجية. طوال مرحلتي 0.6 (أبريل، 2010) و0.7 (مايو، 2011)، واصلت تحسينات المعمارية والواجهة عملية إنتاج أنفع مكتبة وأكثرها ثباتًا ممكنة. وحتى وقت كتابة هذا الكتاب، تستخدم SQLAlchemy عددًا كبيرًا من المؤسسات في مجالات متنوّعة، ويعتبرها كثيرون المعيار الفعلي للعمل مع قواعد البيانات العلائقية في Python.
20.1. تحدّي تجريد قواعد البيانات
يُفترض غالبًا أن مصطلح «تجريد قاعدة البيانات» (database abstraction) يعني نظامًا للتواصل مع قاعدة البيانات يخفي معظم تفاصيل كيفية تخزين البيانات والاستعلام عنها. غيرّ أن هذا المصطلح يُؤخذ أحيانًا إلى حدّه الأقصى، إذ يُفترض بالنظام ألّا يخفي تفاصيل قاعدة البيانات العلائقية المستخدَمة فحسب، بل أيضًا تفاصيل البنى العلائقية نفسها، بل وحتمًا ما إذا كان التخزين الأساسي علائقيًا أصلًا.
تركّز أكثر انتقادات أنظمة ORM حول ما يفترض أنّه الغرض الأساسي لأداة من هذا النوع—أي «إخفاء» استخدام قاعدة بيانات علائقية، مع تولي مهمة بناء التفاعل مع قاعدة البيانات والاكتفاء بتمريره كتفصيل تنفيذي. والأساس في هذا النهج القائم على الإخفاء هو حرمان المطوّر من القدرة على تصميم البنى العلائقية والاستعلام فيها، ليتولى ذلك بدلًا منه مكتبة معتمة (opaque).
من يعمل بكثافة مع قواعد البيانات العلائقية يعلم أنّ هذا النهج غير عملي تمامًا. فالبنى العلائقية واستعلامات SQL وظيفية إلى حدٍّ بعيد، وتشكّل جوهر تصميم التطبيق. وكيف ينبغي تصميم هذه البنى وتنظيمها والتعامل معها في الاستعلامات يختلف لا بحسب البيانات المرغوبة فحسب، بل أيضًا بحسب بنية المعلومات. وإذا حُجبت هذه الأداة، فلا معنى لاستخدام قاعدة بيانات علائقية من الأساس.
غالبًا ما تُشار إلى مسألة التوفيق بين التطبيقات التي تسعى إلى إخفاء قاعدة بيانات علائقية أساسية، وبين اشتراط قواعد البيانات العلائقية درجة عالية من التحديد، على أنها مسألة «عدم التطابق في المعاوقة بين النموذجين الكائني والعلائقي» (object-relational impedance mismatch). ويتخذ SQLAlchemy من هذه المسألة موقفًا جديدًا إلى حدٍّ ما.
منهج SQLAlchemy في تجريد قواعد البيانات
يتبنّى SQLAlchemy موقفًا مؤدّاه أنّ المطوّر لا بدّ أن يكون مستعدًا لمراعاة الصيغة العلائقية لبياناته. وأي نظام يحدّد مسبقًا قرارات تصميم المخطط والاستعلامات ويخفيها يقلّل من جدوى استخدام قاعدة بيانات علائقية، ويؤدي إلى كل مشكلات عدم التطابق الكلاسيكية.
وفي الوقت نفسه، يمكن —> وي ينبغي — أن تُنفَّذ هذه القرارات قدر الإمكان عبر أنماط عالية المستوى. فنسبة نموذج كائنات إلى مخطط، ثم حفظه عبر استعلامات SQL، مهمة شديدة التكرار. والإذن للأدوات بأتمتة هذه المهام يسمح بتطوير تطبيق أكثر إيجازًا وقدرة وكفاءة، ويمكن إنشاؤه في جزء بسيط من الزمن الذي يستغرقه تنفيذ هذه العمليات يدويًا.
ولهذا الغرض تسمّي SQLAlchemy نفسها مجموعة أدوات (toolkit)، مركِّزةً على دور المطوّر بوصفه المصمِّم/الباني لكل البنى العلائقية والروابط بين تلك البنى والتطبيق، لا مستهلكًا سلبيًا لقرارات تتخذها مكتبة. وبكشف المفاهيم العلائقية، تتبنّى SQLAlchemy فكرة «التجريد المتسرّب» (leaky abstraction)، فضفّ على المطوّر تهيئة طبقة تفاعل مخصَّصة ومؤتمتة بالكامل رغم ذلك بين التطبيق وقاعدة البيانات العلائقية. وتتمثّل ابتكار SQLAlchemy في أنه يتيح درجة عالية من الأتمتة من دون التضحية تقريبًا بالتحكّم في قاعدة البيانات العلائقية.
20.2. الثنائية بين Core وORM
يقوم هدف SQLAlchemy في تقديم منهج مجموعة الأدوات على كشف كل طبقة من طبقات التفاعل مع قاعدة البيانات بوصفها واجهة برمجية (API) غنية، مع تقسيم المهمة إلى فئتين رئيسيتين تُعرفان بـ Core وORM. وتتضمّن Core التفاعل عبر Python Database API (DBAPI)، وتوليد جمل SQL النصية التي تفهمها قاعدة البيانات، وإدارة المخطط. وتُقدَّم كل هذه الميزات كواجهات برمجية عامة. أما ORM، أي مُرسِل الكائنات والعلاقات، فهو مكتبة معيّنة مبنية فوق Core. وORM المرفق مع SQLAlchemy ليس إلّا إحدى طبقات تجريد الكائنات الممكنة العديدة التي يمكن بناؤها على Core، وكثير من المطوّرين والمؤسسات يبنون تطبيقاتهم مباشرةً فوق Core.
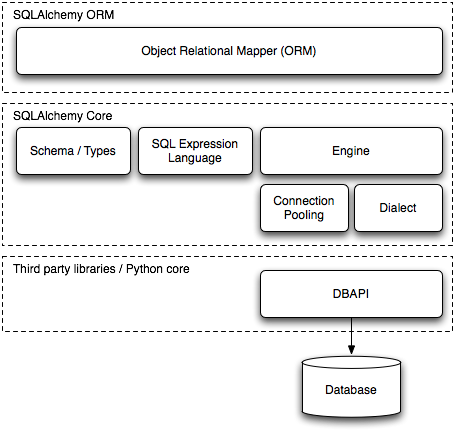 الشكل 20.1: مخطط طبقات SQLAlchemy
ظلّ الفصل بين Core وORM أبرز سمات SQLAlchemy تعريفًا على الإطلاق، وهو ذو إيجابيات وسلبيات معًا. فوجود Core الصريح في SQLAlchemy يدفع ORM إلى ربط سمات الأصناف المعيّنة بقاعدة البيانات ببنية تُدعى Table، لا بأسماء أعمدتها النصية كما هي معبَّرة عنها في قاعدة البيانات؛ وإلى إنتاج استعلام SELECT باستخدام بنية تُدعى select، لا إلى تجميع سمات الكائنات مباشرةً في جملة نصية؛ وإلى تلقّي صفوف النتائج عبر واجهة تُدعى ResultProxy، تربط select بشكل شفاف بكل صف ناتج، بدلًا من نقل البيانات مباشرةً من مؤشّر قاعدة البيانات إلى كائن يعرّفه المستخدم.
قد لا تكون عناصر Core ظاهرة في تطبيق بسيط جدًا يتمحور حول ORM. لكن، بما أنّ Core مدمج بعناية داخل ORM للسماح بانتقال سلس بين بنى ORM وبنى Core، يستطيع التطبيق المعقّد المتمحور حول ORM «النزول» مستوى أو مستويين للتعامل مع قاعدة البيانات بطريقة أكثر تحديدًا ودقة، بحسب ما تتطلبه الحالة. ومع نضج SQLAlchemy، صارت واجهة Core أقلّ وضوحًا في الاستخدام المعتاد مع استمرار ORM في توفير أنماط أكثر رقيًّا وشمولًا. غير أنّ توفّر Core كان أيضًا أحد أسباب نجاح SQLAlchemy المبكر، إذ أتاح للمستخدمين الأوائل إنجاز الكثير أكثر مما كان ممكنًا في حينها والـ ORM ما زال قيد التطوير.
الجانب السلبي في نهج ORM/Core هو أنّ التعليمات يجب أن تعبر خطوات أكثر. فلتنفيذ C التقليدي في Python عبء إضافي كبير لكل استدعاء دالة على حدة، وهذه هي السبب الرئيسي لبطء زمن التنفيذ. وتشمل الطرق التقليدية لتحسين ذلك تقصير سلاسل الاستدعاءات عبر إعادة الترتيب والدالة المضمَّنة (inlining)، واستبدال المواضع الحرجة للأداء بشيفرة C. وقد أمضى SQLAlchemy سنوات في استخدام كلتا الطريقتين لتحسين الأداء. غير أنّ الزخم المتزايد في قبول مُفسِّر PyPy للغة Python قد يعدو أن يسحق مشكلات الأداء المتبقّية دون الحاجة إلى استبدال معظم أجزاء SQLAlchemy الداخلية بشيفرة C، إذ يقلّل PyPy إلى حدٍّ بعيد من أثر السلاسل الطويلة من الاستدعاءات عبر الدمج والترجمة في اللحظة الأخيرة (just-in-time).
20.3. ترويض DBAPI
في قاعدة SQLAlchemy يوجد نظام يتفاعل مع قاعدة البيانات عبر DBAPI. وDBAPI ليست مكتبة فعلية، بل مواصفة فحسب. وعليه تتوفّر تطبيقات DBAPI لقاعدة بيانات بعينها، مثل MySQL أو PostgreSQL، أو بدلًا thereof تطبيقات لمهاولات قواعد بيانات بديلة لا تعتمد على DBAPI، مثل ODBC وJDBC.
يطرح DBAPI تحدّيين. الأول هو توفير واجهة سهلة الاستخدام ومتكاملة المزايا حول أنماط استخدام DBAPI الأولية. والثاني هو التعامل مع التغيّر الشديد في سلوك تنفيذات DBAPI المعيّنة، وكذلك مع محرّكات قواعد البيانات التي تقف خلفها.
نظام اللهجات
الواجهة التي تصفها DBAPI بسيطة إلى حدٍّ أقصى. ومكوّناتها الأساسية هي وحدة DBAPI نفسها، وكائن الاتصال (connection)، وكائن المؤشّر (cursor)—فـ«المؤشّر» في لغة قواعد البيانات يمثّل سياق جملة بعينها ونتائجها المرتبطة. وتفاعل بسيط مع هذه الكائنات للاتصال بقاعدة البيانات وسحب البيانات منها يبدو كالتالي:
connection = dbapi.connect(user="user", pw="pw", host="host")
cursor = connection.cursor()
cursor.execute("select * from user_table where name=?", ("jack",))
print "Columns in result:", [desc[0] for desc in cursor.description]
for row in cursor.fetchall():
    print "Row:", row
cursor.close()
connection.close()
يوفّر SQLAlchemy واجهة أمامية (facade) حول حوار DBAPI الكلاسيكي. ونقطة الدخول إلى هذه الواجهة هي استدعاء create_engine، ومنه تُجمَع معلومات الاتصال والإعداد. وتكون النتيجة كائن Engine. وهذا الكائن يمثّل بعدها البوابة إلى DBAPI، التي لا تُكشف أبدًا بصورة مباشرة.
بالنسبة إلى عمليات تنفيذ الجمل البسيطة، يقدّم Engine ما يُعرف بواجهة التنفيذ الضمني (implicit execution). إذ يتولّى النظام في الخلفية كلًّا من تلقّي اتصال DBAPI ومؤشّره وإغلاقهما:
engine = create_engine("postgresql://user:pw@host/dbname")
result = engine.execute("select * from table")
print result.fetchall()
وعندما أُطلقت SQLAlchemy 0.2 أُضيف كائن Connection، الذي وفّر القدرة على صيانة نطاق اتصال DBAPI صراحةً:
conn = engine.connect()
result = conn.execute("select * from table")
print result.fetchall()
conn.close()
النتيجة التي تُعيدها الدالة execute في Engine أو Connection تُدعى ResultProxy، وهي تقدّم واجهة تشبه مؤشّر DBAPI لكن بسلوك أغنى. وEngine وConnection وResultProxy تقابل، على الترتيب، وحدة DBAPI، ومثيلًا لاتصال DBAPI معيّن، ومثيلًا لمؤشّر DBAPI معيّن.
في الكواليس، تشير Engine إلى كائن يُدعى Dialect. وDialect صنف مجرّد تتوفّر له تطبيقات كثيرة، كلٌّ منها موجَّه إلى تركيبة معيّنة من DBAPI وقاعدة بيانات. وستحيل Connection المنشأة نيابةً عن Engine إلى هذه Dialect في كل القرارات، والتي قد تختلف تبعًا لـ DBAPI وقاعدة البيانات الهدف المستخدَمة.
وعند إنشائها، تحصل Connection على اتصال DBAPI فعلي وتحافظ عليه من مستودع يُعرف بـ Pool المرتبط أيضًا بـ Engine. وPool مسؤولة عن إنشاء اتصالات DBAPI جديدة، وعادةً الاحتفاظ بها في تجمّع داخل الذاكرة لإعادة الاستخدام المتكرّر.
أثناء تنفيذ جملة ما، تنشئ Connection كائنًا إضافيًا يُدعى ExecutionContext. ويبقى هذا الكائن قائمًا من لحظة التنفيذ وحتى انتهاء دورة حياة ResultProxy. وقد يتوفّر أيضًا بصيغة صنف فرعي معيّن لبعض تركيبات DBAPI وقواعد البيانات.
يوضّح الشكل 20.2 جميع هذه الكائنات وعلاقاتها ببعضها، فضلًا عن علاقاتها بمكوّنات DBAPI.
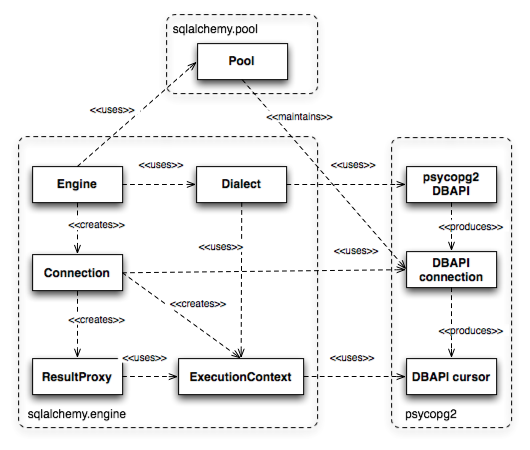 الشكل 20.2: واجهة Engine وConnection وResultProxy
التعامل مع تغيّر DBAPI
لمهمة إدارة التغيّر في سلوك DBAPI، لنبدأ أولًا بتحديد حجم المشكلة. فمواصفة DBAPI، وهي في نسختها الثانية حاليًا، كُتبت بوصفها سلسلة من تعريفات الواجهات البرمجية التي تتيح درجة واسعة من التغيّر في السلوك، وتترك عددًا كبيرًا من الجوانب غير معرَّفة. ونتيجة لذلك، تُظهر تطبيقات DBAPI في الواقع درجة كبيرة من التغيّر في عدة جوانب، منها متى تُقبل سلاسل بايثون النصية (unicode) ومتى لا تُقبل؛ وكيف يمكن الحصول على «آخر مُعرَّف مُدرج»—أي مفتاح أساسي مُولَّد تلقائيًا— بعد تنفيذ جملة INSERT؛ وكيف يمكن تحديد قيم المعاملات المربوطة وتفسيرها. كما تمتلك أيضًا عددًا كبيرًا من السلوكات الخاصة بالأنواع، بما فيها التعامل مع البيانات الثنائية (binary) والأرقام ذات الدقة (precision numeric) والتاريخ والمنطقي (Boolean) والنص Unicode.
يتعامل SQLAlchemy مع ذلك بالسماح بالتغيّر في كل من Dialect وExecutionContext عبر الوراثة متعددة المستويات. ويوضّح الشكل 20.3 العلاقة بين Dialect وExecutionContext عند استخدامها مع لهجة psycopg2. إذ يوفّر الصنف PGDialect سلوكيات خاصة باستخدام قاعدة بيانات PostgreSQL، مثل نوع البيانات ARRAY وفهارس المخططات (schema catalogs)؛ ويوفّر الصنف PGDialect_psycopg2 بعد ذلك سلوكيات خاصة بـ DBAPI الخاص بـ psycopg2، بما في ذلك معالِج بيانات Unicode وسلوك المؤشّرات من جهة الخادم.
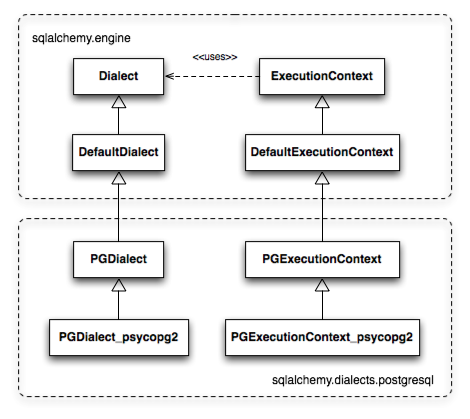 الشكل 20.3: تسلسل هرمي مبسَّط للهجة/ExecutionContext
يظهر أحد نُسخ النمط أعلاه عند التعامل مع DBAPI يدعم قواعد بيانات متعدّدة. ومن أمثلتها pyodbc الذي يتعامل مع أي عدد من واجهات قواعد البيانات الخلفية (backends) عبر ODBC، وzxjdbc وهو مشغّل خاص بـ Jython يتعامل مع JDBC. وتُثرى العلاقة أعلاه باستخدام صنف مخلوط (mixin) من حزمة sqlalchemy.connectors يوفّر سلوك DBAPI المشترك بين الواجهات الخلفية المتعدّدة. ويوضّح الشكل 20.4 الوظائف المشتركة في sqlalchemy.connectors.pyodbc بين لهجتي MySQL وMicrosoft SQL Server المخصّصتين لـ pyodbc.
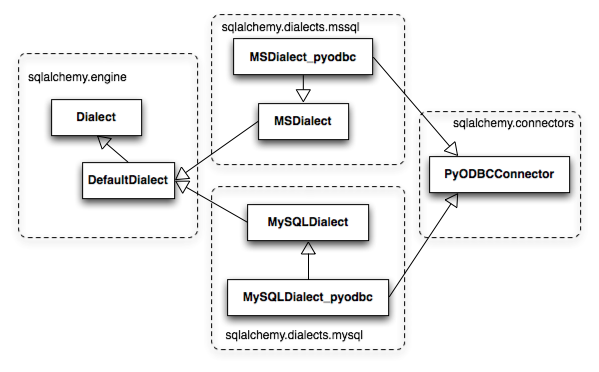 الشكل 20.4: سلوك DBAPI مشترك بين تسلسلات اللهجات الهرمية
توفّر كائنات Dialect وExecutionContext وسيلة لتعريف كل تفاعل مع قاعدة البيانات وDBAPI، بما في ذلك كيفية تنسيق وسائط الاتصال وكيف تُعالَج التفرّحات الخاصة (quirks) أثناء تنفيذ الجمل. كما أنّ Dialect هي مصنع لبنات ترجمة SQL التي تولّد SQL صحيحًا لقاعدة البيانات الهدف، ولأنواع البيانات التي تعرّف كيف ينبغي تحويل بيانات بايثون من وإلى DBAPI وقاعدة البيانات الهدف.
20.4. تعريف المخطط
بعد إتمام الاتصال بقاعدة البيانات والتفاعل معها، تتمثّل المهمة التالية في إنشاء عبارات SQL التي لا تعتمد على نظام إدارة قواعد البيانات بعينه والتحكّم فيها. ولتحقيق ذلك، نحتاج أولًا إلى تعريف كيفية إشارتنا إلى الجداول والأعمدة الموجودة في قاعدة البيانات—وهي ما يُسمّى «المخطط» (schema). وتمثّل الجداول والأعمدة تنظيم البيانات، وتتكوّن معظم جمل SQL من تعبيرات وأوامر تشير إلى هذه البنى.
يحتاج ORM أو طبقة الوصول إلى البيانات إلى توفير وصول برمجي إلى لغة SQL؛ وتُعدّ الأساس هنا منظومة برمجية لوصف الجداول والأعمدة. وهنا يقدّم SQLAlchemy أول انقسام قوي بين Core وORM، إذ يوفّر البنيتين Table وColumn اللتين تصفان بنية قاعدة البيانات بمعزل عن تعريف صنف النموذج لدى المستخدم. والمنطق وراء الفصل بين تعريف المخطط ورسم خرائط الكائنات والعلاقات هو أنّ المخطط العلائقي يمكن تصميمه بوضوح تام انطلاقًا من قاعدة البيانات العلائقية، بما في ذلك التفاصيل الخاصة بالمنصّة عند الحاجة، دون أن تختلط به المفاهيم الكائنية العلائقية—فهذه تبقى مسألة منفصلة. كما يعني الاستقلال عن مكوّن ORM أنّ نظام وصف المخطط مفيد بالقدر نفسه لأي نظام آخر من نوع الكائنات والعلاقات قد يُبنى على Core.
تندرج نمذجان Table وColumn ضمن ما يُشار إليه بـ البيانات الوصفية (metadata)، مع كائن مجموعة يُدعى MetaData يمثّل مجموعة من كائنات Table. وقد استُمدت هذه البنية إلى حدٍّ بعيد من وصف مارتن فاولر لـ«تعيين البيانات الوصفية» (Metadata Mapping) في كتابه Patterns of Enterprise Application Architecture. ويوضّح الشكل 20.5 بعض العناصر الرئيسة في حزمة sqlalchemy.schema.
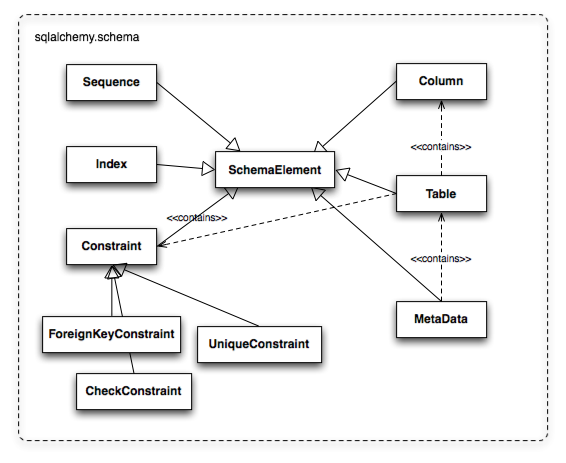 الشكل 20.5: كائنات sqlalchemy.schema الأساسية
يمثّل Table اسم جدول فعلي موجود في مخطط محدّد وسماته الأخرى. وتمثّل مجموعته من كائنات Column معلومات التسمية والأنواع الخاصة بكل عمود من أعمدة الجدول على حدة. كما تُوفَّر مجموعة كاملة من الكائنات التي تصف القيود والفهارس والتسلسلات لاستكمال مزيد من التفاصيل، بعضها يؤثّر في سلوك محرّك قاعدة البيانات ونظام بناء SQL. وبصفة خاصة، تتجلّى أهمية ForeignKeyConstraint تحديدًا في تحديد كيفية ربط جدولين.
يتسم Table وColumn في حزمة schema بالتفرّد مقارنةً ببقية الحزمة، إذ يرثان وراثةً مزدوجة، من حزمة sqlalchemy.schema ومن حزمة sqlalchemy.sql.expression معًا، قلّ ما يكونا بُنيتين على مستوى المخطط فحسب، بل أيضًا وحدات نحوية جوهرية في لغة تعبيرات SQL. ويوضّح هذه العلاقة الشكل 20.6.
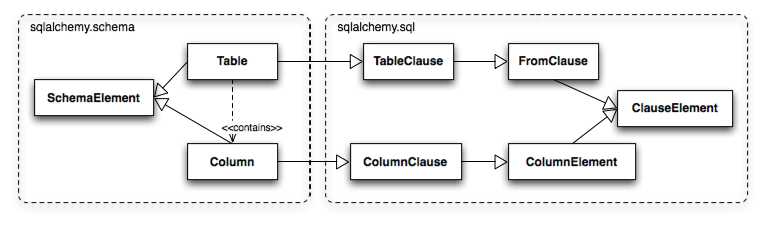 الشكل 20.6: الحياة المزدوجة لـ Table وColumn
نرى في الشكل 20.6 أنّ Table وColumn يرثان من عالم SQL بصيغتين محدّدتين: «الأشياء التي يمكنك الاختيار منها»، المعروفة بـ FromClause، و«الأشياء التي يمكنك استخدامها في تعبير SQL»، المعروفة بـ ColumnElement.
20.5. تعبيرات SQL
أثناء إنشاء SQLAlchemy، لم يكن منهج توليد SQL واضحًا. وكان المرشَّح الأرجح لغةً نصية؛ وهذا نهج شائع يقوم جوهره في أدوات رسم خرائط الكائنات والعلاقات المعروفة مثل HQL الخاصة بـ Hibernate. لكنّ المتاح في حالة Python كان خيارًا أكثر إثارة للاهتمام: استخدام كائنات بايثون وتعبيراتها لبناء هياكل أشجار التعبير بشكل توليدي، بل وإعادة استغلال معاملات بايثون نفسها بحيث تُعطى المعاملات سلوك جملة SQL.
ولو لم تكن SQLAlchemy أول أداة تفعل ذلك، فإنّ الفضل الكامل يعود إلى مكتبة SQLBuilder المُضمَّنة في مشروع SQLObject لإيان بيكنغ بوصفها مصدر إلهام نظام كائنات بايثون ومعاملاتها المستخدَم في لغة تعبيرات SQLAlchemy. وفي هذا النهج تمثّل كائنات بايثون الأجزاء المعجمية (lexical) من تعبير SQL. وتُنتج الدوال المُعرَّفة على تلك الكائنات، فضلًا عن المعاملات المُحمَّلة (overloaded operators)، بنًى معجمية جديدة مشتقّة منها. وأكثر الكائنات شيوعًا هو كائن «Column»—فكان SQLObject يمثّل هذه الكائنات على صنف معيَّن عبر ORM باستخدام نطاق أسماء يُطالَع عبر السمة .q؛ بينما اختار SQLAlchemy تسمية السمة .c. ولا تزال السمة .c موجودة اليوم على عناصر Core القابلة للاختيار، مثل تلك التي تمثّل الجداول وجمل select.
أشجار التعبيرات
بنية تعبير SQL في SQLAlchemy هي إلى حدٍّ كبير نوع البنية التي كنت ستنشئها لو كنت تُحلِّل جملة SQL—إلّا أنها شجرة تحليل، غير أنّ المطوّر ينشئ شجرة التحليل مباشرةً بدلًا من اشتقاقها من سلسلة نصية. ويُسمّى النوع الأساسي من العقد في شجرة التحليل هذه ClauseElement، ويوضّح الشكل 20.7 علاقة ClauseElement ببعض الأصناف الرئيسة.
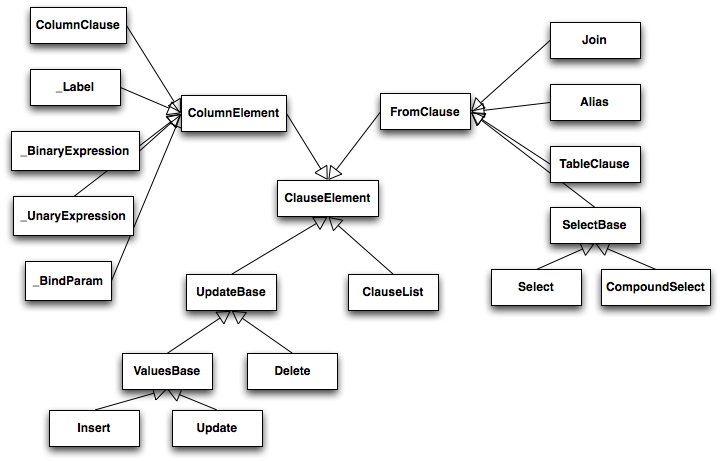 الشكل 20.7: تسلسل هرمي أساسي للتعبيرات
باستخدام دوال الإنشاء والدوال المُعرَّفة على الأصناف ودوال معاملات بايثون المُحمَّلة، يمكن بناء البنية الخاصة بجملة مثل:
SELECT id FROM user WHERE name = ?
قد تُبنى في بايثون على النحو التالي:
from sqlalchemy.sql import table, column, select
user = table('user', column('id'), column('name'))
stmt = select([user.c.id]).where(user.c.name=='ed')
يوضّح الشكل 20.8 بنية بنية select أعلاه. ولاحظ أنّ تمثيل القيمة الحرفية 'ed' مُضمَّن داخل البنية _BindParam، ما يجعله يُعرض كعلامة معامل مربوط في سلسلة SQL باستخدام علامة استفهام.
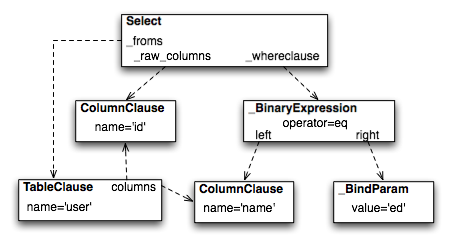 الشكل 20.8: شجرة تعبير نموذجية
يتّضح من مخطط الشجرة أنّ اجتيازًا تنازليًّا بسيطًا عبر العقد كفيلٌ بسرعة إنتاج جملة SQL معروضة، كما سنرى بمزيد من التفصيل في قسم ترجمة الجمل.
نهج معاملات بايثون
في SQLAlchemy، تعبير مثل هذا:
column('a') == 2
لا ينتج إمّا True ولا False، بل ينتج بدلًا منهما بنية تعبير SQL. والمفتاح إلى ذلك هو تحميل المعاملات (overloading) باستخدام دوال معاملات بايثون الخاصة: مثل __eq__ و__ne__ و__le__ و__lt__ و__add__ و__mul__. وتوفّر عقد التعبيرات الموجَّهة بالأعمدة سلوك معاملات بايثون المُحمَّلة عبر استخدام صنف مخلوط (mixin) يُدعى ColumnOperators. ومع تحميل المعاملات، يصبح التعبير column('a') == 2 مكافئًا لـ:
from sqlalchemy.sql.expression import _BinaryExpression
from sqlalchemy.sql import column, bindparam
from sqlalchemy.operators import eq

_BinaryExpression(
    left=column('a'),
    right=bindparam('a', value=2, unique=True),
    operator=eq
)
البنية eq هي في الواقع دالة مصدرها الوحدة المدمجة operator في بايثون. وتمثيل المعاملات ككائن (أي operator.eq) بدلًا من سلسلة نصية (أي =) يتيح تعريف التمثيل النصي وقت ترجمة الجملة، حين تكون معلومات لهجة قاعدة البيانات معروفة.
الترجمة
الصنف المسؤول عن تحويل أشجار تعبيرات SQL إلى SQL نصي هو صنف Compiled. ويملك هذا الصنف صنفين رئيسيين فرعين هما SQLCompiler وDDLCompiler. يتولّى SQLCompiler عمليات توليد SQL لجمل SELECT وINSERT وUPDATE وDELETE، المصنَّفة جماعيًا بوصفها DQL (لغة استعلام البيانات) وDML (لغة معالجة البيانات)، بينما يتولّى DDLCompiler جمل CREATE وDROP المختلفة، المصنَّفة بوصفها DDL (لغة تعريف البيانات). وهناك تسلسل هردي إضافي من الأصناف يركّز على التمثيلات النصية للأنواع، يبدأ عند TypeCompiler. ثم توفّر كل لهجة بدورها أصنافها الفرعية من الأنواع الثلاثة للمترجِمات، لتعريف جوانب لغة SQL الخاصة بقاعدة البيانات الهدف. ويقدّم الشكل 20.9 لمحةً عن هذا التسلسل الهرمي من الأصناف فيما يتعلّق بلهجة PostgreSQL.
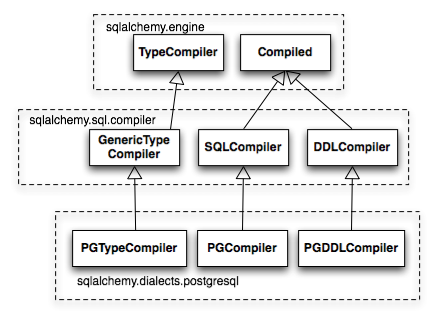 الشكل 20.9: تسلسل مترجِمات هرمي، بما فيه التطبيق الخاص بـ PostgreSQL
تعرّف الأصناف الفرعية لـ Compiled سلسلةً من توابع الزيارة (visit)، يُشار إلى كل منها بصنف فرعي معيّن من ClauseElement. ويُقطع الشجرة من الصنف ClauseElement وتُبنى الجملة عبر وصل ناتج كل دالة زيارة على الأخرى تكراريًا. وخلال ذلك يحافظ كائن Compiled على حالة تتعلّق بأسماء المعرّفات المجهولة وأسماء المعاملات المربوطة وتعشيش الاستعلامات الفرعية، وغيرها من الأمور، وكلّها تهدف إلى إنتاج جملة SQL نصية، فضلًا عن مجموعة نهائية من المعاملات المربوطة ذات القيم الافتراضية. ويوضّح الشكل 20.10 كيف تنتهي توابع الزيارة إلى وحدات نصية.
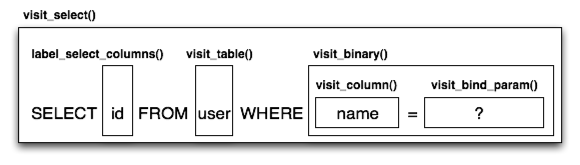 الشكل 20.10: التسلسل الهرمي للاستدعاءات في ترجمة جملة
تحتوي البنية المكتملة لـ Compiled على سلسلة SQL كاملة ومجموعة قيم مربوطة. ثم يُجبرها ExecutionContext على الصيغة التي يتوقّعها أسلوب execute في DBAPI، بما في ذلك ما يتعلّق بمعالجة كائن الجملة النصي (unicode)، ونوع المجموعة المستخدَمة لتخزين القيم المربوطة، وكذلك تفاصيل كيفية تحويل القيم المربوطة نفسها إلى تمثيلات ملائمة لـ DBAPI وقاعدة البيانات الهدف.
20.6. تعيين الأصناف عبر ORM
نحوّل الآن انتباهنا إلى ORM. والهدف الأول هو استعمال منظومة البيانات الوصفية للجداول التي عرّفناها للسماح بتعيين صنف يعرّفه المستخدم على مجموعة أعمدة في جدول بقاعدة البيانات. أما الهدف الثاني فيتمثّل في السماح بتعريف العلاقات بين الأصناف التي يعرّفها المستخدم، استنادًا إلى العلاقات بين الجداول في قاعدة البيانات.
يسمّي SQLAlchemy ذلك «التعيين» (mapping)، تبعًا لنمط Data Mapper المعروف الذي وصفه فاولر في كتابه Patterns of Enterprise Architecture. وإجمالًا، يستمد ORM الخاص بـ SQLAlchemy كثيرًا من الممارسات التي فصّلها فاولر. كما تأثّر كثيرًا بشاعرة أداة تعيين العلاقات في جافا وهي Hibernate، وبمنتج SQLObject لإيان بيكنغ الخاص بـ Python.
الكلاسيكي مقابل التصريحي
نستخدم مصطلح التعيين الكلاسيكي (classical mapping) للإشارة إلى نظام SQLAlchemy في تطبيق تعيين بيانات كائن-علائقي على صنف موجود يعرّفه المستخدم. وتتعامل هذه الصيغة مع كائن Table والصنف المعرَّف من المستخدم بوصفهما كيانين مُعرَّفين كلٌّ منهما على حدة، يُربطان معًا بواسطة دالة تُدعى mapper. وبعد تطبيق mapper على صنف معرَّف من المستخدم، يكتسب الصنف سمات جديدة تطابق أعمدة الجدول:
class User(object):
    pass

mapper(User, user_table)

# now User has an ".id" attribute
User.id
ويمكن لـ mapper أيضًا أن يُلحق بالصنف أنواعًا أخرى من السمات، بما في ذلك سمات تمثّل إشارات إلى أنواع أخرى من الكائنات، فضلًا عن تعبيرات SQL عشوائية. وتُعرَف عملية إلحاق سمات عشوائية بصنف في عالم بايثون بأنها «رقع القرد» (monkeypatching)؛ لكن، بما أننا نفعل ذلك بطريقة قائمة على البيانات لا اعتباطية، فإنّ روح العملية تُعبَّر عن مصطلح تجهيز الصنف (class instrumentation) بدقة أكبر.
يرتكز الاستخدام الحديث لـ SQLAlchemy حول امتداد Declarative، وهو نظام إعدادات يشبه أنظمة تعريف الأصناف الشبيهة بـ active record المستخدَمة في كثير من أدوات رسم خرائط الكائنات والعلاقات الأخرى. وفي هذا النظام يعرّف المستخدم النهائي سماته صراحةً وداخل تعريف الصنف، كلٌّ منها يمثّل سمة على الصنف ستُعيَّن. وكائن Table، في معظم الحالات، لا يُذكر صراحةً، ولا دالة mapper؛ إنما يُسمّى الصنف فحسب وكائنات Column والسمات الأخرى المتعلّقة بـ ORM:
class User(Base):
    __tablename__ = 'user'
    id = Column(Integer, primary_key=True)
قد يبدو ممّا سبق أنّ تجهيز الصنف يتحقّق مباشرةً بوضع id = Column()، لكنّ الأمر ليس كذلك. فامتداد Declarative يستخدم صنفًا خارقًا (metaclass) في بايثون، وهي طريقة عملية لتشغيل سلسلة من العمليات في كل مرة يُعلَن فيها صنف جديد لأول مرة، لتوليد كائن Table جديد عمّا صرّح به، وتمريره إلى دالة mapper مع الصنف. ثم تقوم mapper بعملها على النحو نفسه تمامًا، إذ تلحق سماتها بالصنف نفسه، وفي هذه الحالة نحو السمة id، لتحلّ محلّ ما كان فيها سابقًا. وبحلول وقت اكتمال تهيئة الصنف الخارق (أي عندما يغدُ تدفّق التنفيذ الكتلة المحدّدة بـ User)، تكون كائنات Column المعلَّمة بـ id قد نُقلت إلى Table جديد، وقد استُبدل User.id بسمة جديدة خاصة بالتعيين.
كان المقصود دائمًا أن توفّر SQLAlchemy صيغةً مختصرة وتصريحية للإعداد. غير أنّ إنشاء Declarative قد أُجّل لصالح مواصلة العمل على ترسيخ آليات التعيين الكلاسيكي. وقد كانت هناك إضافة مبكّرة تُدعى ActiveMapper، ثم استحالت لاحقًا إلى مشروع Elixir. وهي تعيد تعريف بنى التعيين في نظام تصريحي أعلى مستوى. وكان هدف Declarative هو عكس اتجاه نهج Elixir شديد التجريد، عبر إنشاء نظام يحفظ مفاهيم التعيين الكلاسيكي في SQLAlchemy شبه كاملة، مع إعادة تنظيم طريقة استخدامها فحسب لتصبح أقلّ إسهابًا وأكثر ملاءمة لامتدادات على مستوى الصنف مما هو عليه في التعيين الكلاسيكي.
سواء استُخدم التعيين الكلاسيكي أو التصريحي، يكتسب الصنف المُعيَّن سلوكيات جديدة تمكّنه من التعبير عن بنى SQL بدلالة سماته. وقد اتّبع SQLAlchemy في الأصل سلوك SQLObject في استخدام سمة خاصة بوصفها مصدرًا لتعبيرات أعمدة SQL، وتشار إليها SQLAlchemy بـ .c، كما في هذا المثال:
result = session.query(User).filter(User.c.username == 'ed').all()
غير أنّ SQLAlchemy نقلت في النسخة 0.4 هذه الوظيفة إلى السمات المُعيَّنة نفسها:
result = session.query(User).filter(User.username == 'ed').all()
ثبت أنّ تغيير الوصول إلى السمات تحسينٌ كبير، إذ أتاح للكائنات الشبيهة بالأعمدة الموجودة على الصنف أن تكتسب قدرات إضافية خاصة بالصنف لا تتوفّر في نظائرها الواردة مباشرةً من كائن Table الأساسي. كما أتاح التكامل في الاستخدام بين أنواع مختلفة من سمات الصنف، مثل السمات التي تشير مباشرةً إلى أعمدة الجداول، والسمات التي تشير إلى تعبيرات SQL مشتقّة من تلك الأعمدة، والسمات التي تشير إلى صنف مرتبط. وأخيرًا، وفّر تناظرًا بين الصنف المُعيَّن ومثيل ذلك الصنف، إذ يمكن للسمة نفسها أن تكتسب سلوكًا مختلفًا حسب نوع الأصل. فالسمات المرتبطة بالصنف تُعيد تعبيرات SQL، في حين تُعيد السمات المرتبطة بالمثيل البيانات الفعلية.
تشريح التعيين
السمة id الملحقة بصنف User عندنا هي نوع من الكائنات المعروف في بايثون بـ الواصف (descriptor)، وهو كائن له توابع __get__ و__set__ و__del__، يعتمد عليها بايثون في زمن التنفيذ في جميع عمليات الصنف والمثيل التي تتضمّن هذه السمة. ويُعرَف تنفيذ SQLAlchemy لها بـ InstrumentedAttribute، وسنوضّح العالم الكامن خلف هذه الواجهة بمثال آخر. إذ نبدأ بكائن Table وصنف معرَّف من المستخدم، ثم نُنشئ تعيينًا فيه عمود مُعيَّن واحد فقط، فضلًا عن relationship تعرّف إشارة إلى صنف مرتبط:
user_table = Table("user", metadata,
    Column('id', Integer, primary_key=True),
)

class User(object):
    pass

mapper(User, user_table, properties={
    'related':relationship(Address)
})
وحين يكتمل التعيين، تفصّل الشكل 20.11 بنية الكائنات المرتبطة بالصنف.
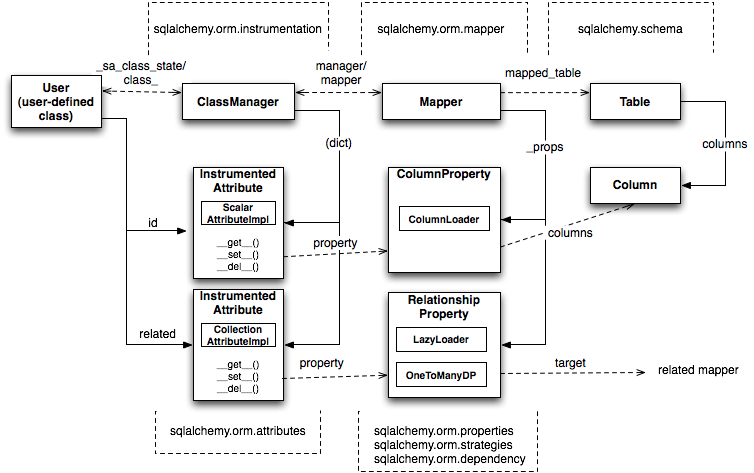 الشكل 20.11: تشريح التعيين
يوضّح الشكل تعيين SQLAlchemy على هيئة طبقتين منفصلتين من التفاعل بين الصنف المعرَّف من المستخدم والبيانات الوصفية للجدول الذي عُيّن إليه. ويُصوَّر تجهيز الصنف على اليسار، فيما يُصوَّر وظائف SQL وقاعدة البيانات على اليمين. والنمط العام الحاكم هنا هو استخدام تركيب الكائنات (object composition) لعزل الأدوار السلوكية، واستخدام وراثة الكائنات للتمييز بين الاختلافات السلوكية داخل دور بعينه.
داخل مجال تجهيز الأصناف، يرتبط ClassManager بالصنف المُعيَّن، فيما ترتبط مجموعته من كائنات InstrumentedAttribute بكل سمة مُعيَّنة على الصنف. وInstrumentedAttribute هو أيضًا واصف بايثون العام المشار إليه سابقًا، وهو ينتج تعبيرات SQL عند استخدامه في تعبير قائم على الصنف (مثل User.id==5). وعندما نتعامل مع مثيل من User، يفوّض InstrumentedAttribute سلوك السمة إلى كائن AttributeImpl، وهو أحد عدة أنواع مصمَّمة بحسب نوع البيانات التي يُمثَّل.
على جانب التعيين، تمثّل Mapper الربط بين صنف معرَّف من المستخدم ووحدة قابلة للاختيار، وهي في الغالب Table. وتحتفظ Mapper بمجموعة من الكائنات لكل سمة تُعرف بـ MapperProperty، وتتكفّل بالتمثيل SQL لسمة بعينها. وأشيع تنويعات MapperProperty هي ColumnProperty، ويمثّل عمودًا مُعيَّنًا أو تعبير SQL، وRelationshipProperty، ويمثّل ارتباطًا مع مُرسِل خرائط آخر.
تفوّض MapperProperty سلوك تحميل السمة—بما في ذلك كيفية ظهورها في جملة SQL وكيف تُملأ من صف نتائج—إلى كائن LoaderStrategy، وهناك عدة أنواع منه. وتحدّد استراتيجيات LoaderStrategies المختلفة إن كان سلوك تحميل السمة مؤجَّلًا أو سابقًا (eager) أو فوريًا. ويُختار الإصدار الافتراضي وقت إعداد المُرسِل، مع إمكانية استخدام استراتيجية بديلة وقت الاستعلام. وتشير RelationshipProperty أيضًا إلى DependencyProcessor، الذي يعالج كيفية سير التبعيات بين المُرسِلات ومزامنة السمات وقت التفريغ. ويُستند اختيار DependencyProcessor إلى الهندسة العلائقية للوحدتين القابلتين للاختيار الأصل والهدف المرتبطتين بالعلاقة.
تشكّل البنية Mapper/RelationshipProperty رسمًا بيانيًا، تكون فيه كائنات Mapper عقدًا وكائنات RelationshipProperty ضروعًا موجَّهة. وبعد أن يعلن التطبيق مجموعة المُرسِلات كاملة، تُنفَّذ خطوة «تهيئة» مؤجَّلة تُعرف بـ الإعداد (configuration). وتُستخدم أساسًا من كل RelationshipProperty لترسيخ التفاصيل بين مُرسِليها الأصل والهدف، بما في ذلك اختيار AttributeImpl وكذلك DependencyProcessor. وهذا الرسم البياني بنية بيانات محورية في مختلف عمليات ORM. وهو يشارك في عمليات مثل سلوك «التسلسل» (cascade) الذي يعرّف كيف ينبغي أن تنتشر العمليات على مسارات الكائنات، وفي عمليات الاستعلام حيث تُحمَّل الكائنات والمجموعات المرتبطة «مسبقًا» (eagerly) دفعة واحدة، فضلًا عن جانب تفريغ الكائنات حيث يُنشأ رسم بياني للتبعيات يجمع كل الكائنات قبل إطلاق سلسلة من خطوات الحفظ.
20.7. الاستعلام وسلوك التحميل
تبدأ SQLAlchemy كل سلوكيات تحميل الكائنات عبر كائن يُدعى Query. وتتضمّن الحالة الأساسية التي يبدأ بها Query ما يُسمّى الكيانات (entities)، وهي قائمة الأصناف المُعيَّنة و/أو تعبيرات SQL الفردية المطلوب الاستعلام عنها. كما أنه يحمل إشارة إلى Session، التي تمثّل الاتصال بقاعدة بيانات واحدة أو أكثر، فضلًا عن ذاكرة مؤقتة للبيانات المتراكمة بخصوص المعاملات على تلك الاتصالات. وفيما يلي مثال استخدام أوّلي:
from sqlalchemy.orm import Session
session = Session(engine)
query = session.query(User)
ننشئ Query يُنتج مثيلات من User، بالاستناد إلى Session جديدة أنشأناها. ويوفّر Query نمط باني توليدي (generative builder pattern) بالطريقة نفسها التي توفّرها بنية select التي ناقشناها سابقًا، حيث تُربط معايير إضافية ومُعدِّلات ببنية الجملة استدعاءً بعد استدعاء. وعندما تُستدعى عملية تكرارية على Query، فإنها تبني بنية تعبير SQL تمثّل SELECT، وتُصدرها إلى قاعدة البيانات، ثم تفسّر صفوف مجموعة النتائج بوصفها نتائج موجَّهة للـ ORM، مقابلةً لمجموعة الكيانات الأولية المطلوبة.
يميّز Query تمييزًا حاسمًا بين جزأَي توليد SQL وتحميل البيانات في العملية. فالأول يعني بناء جملة SELECT، والثاني يعني تفسير صفوف نتائج SQL في بنى مُعيَّنة للـ ORM. ويمكن في الواقع أن يجري تحميل البيانات دون خطوة توليد SQL، إذ قد يُطلب من Query تفسير نتائج استعلام نصي ألّفه المستخدم يدويًا.
يستخدم كلٌّ من توليد SQL وتحميل البيانات اجتيازًا هابطًا تكراريًا (recursive descent) عبر الرسم البياني الذي تشكّله سلسلة مُرسِلات Mapper القائدة، بحيث تُعدّ كل ColumnProperty تحتفظ بعمود أو بتعبير SQL عقدة ورقة، وتُعدّ كل RelationshipProperty المُدرَجة في الاستعلام عبر ما يُسمّى «التحميل السابق» (eager-load) ضلعًا يقود إلى عقدة Mapper أخرى. أمّا اجتياز كل عقدة والإجراء المتخذ بشأنه فيعود في النهاية إلى كل LoaderStrategy المرتبطة بكل MapperProperty، إذ تضيف الأعمدة والوصلات (joins) إلى جملة SELECT قيد البناء في مرحلة توليد SQL، وتنتج دوال بايثون تعالج صفوف النتائج في مرحلة تحميل البيانات.
تتلقّى كل دالة من دوال بايثون المنتَجة في مرحلة تحميل البيانات صف قاعدة بيانات عند جلبه، وتنتج نتيجةً لذلك تغيّرًا محتملًا في حالة سمة مُعيَّنة في الذاكرة. وقد تُنتَج بشكل مشروط لسمة بعينها، استنادًا إلى فحص أول صف وارد في مجموعة النتائج، وإلى خيارات التحميل. وإذا كان تحميل السمة لن يتم، فلا تُنتَج أي دالة قابلة للاستدعاء.
يوضّح الشكل 20.12 اجتياز عدة كائنات LoaderStrategy في سيناريو التحميل السابق المُدمج بالوصلات (joined eager loading)، ويوضّح صلةَها بجملة SQL معروضة تقع أثناء طريقة _compile_context في Query. كما يوضّح توليد دوال تعبئة الصفوف (row population) التي تتلقّى صفوف النتائج وتملأ سمات الكائنات على حدة، وهي عملية تقع ضمن طريقة instances في Query.
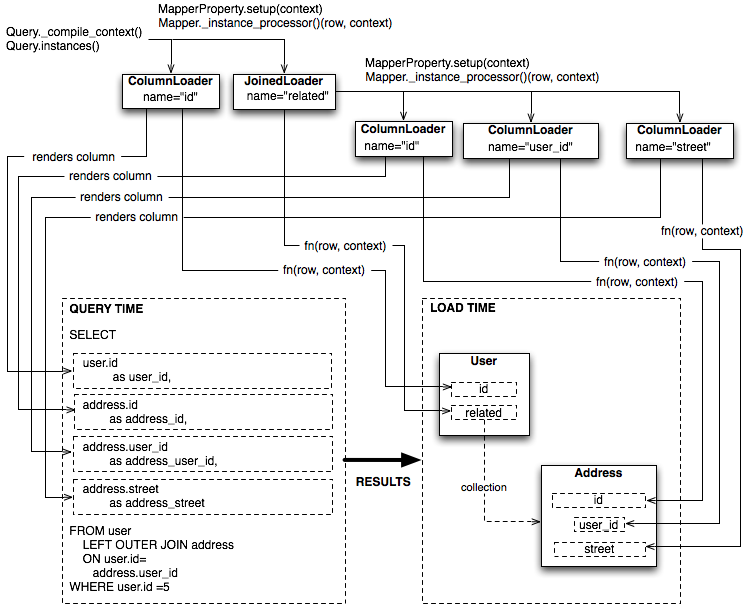 الشكل 20.12: اجتياز استراتيجيات التحميل بما فيه تحميل سابق مدموج بالوصلات
اعتمد نهج SQLAlchemy المبكر في ملء النتائج اجتيازًا تقليديًا لطرق كائنات ثابتة مرتبطة بكل استراتيجية لاستقبال كل صف والتصرّف بناءً عليه. ومثّل نظام دوال التحميل القابلة للاستدعاء، الذي أُدخل أولًا في النسخة 0.5، قفزةً هائلة في الأداء، إذ أمكن اتخاذ قرارات كثيرة بشأن معالجة الصفوف مرة واحدة في مقدّمة العملية بدلًا من اتخاذها لكل صف على حدة، وأمكن تجاوز ذلك بإزالة عدد كبير من استدعاءات الدوال عديمة الأثر.
20.8. الجلسة وخريطة الهوية
في SQLAlchemy، يقدّم كائن Session الواجهة العامة للاستخدام الفعلي للـ ORM—أي تحميل البيانات وحفظها. وهو يوفّر نقطة البداية للاستعلامات وعمليات الحفظ بالنسبة إلى اتصال بقاعدة بيانات معيّن.
وإضافةً إلى كونه البوابة للاتصال بقاعدة البيانات، تحتفظ Session بإشارة نشطة إلى مجموعة جميع الكيانات المُعيَّنة الموجودة في الذاكرة بالنسبة إلى تلك Session. وبهذه الطريقة تطبّق Session واجهةً لنمطي خريطة الهوية (identity map) ووحدة العمل (unit of work)، وكلاهما صنّفه فاولر. وتحافظ خريطة الهوية على تعيينٍ متمايز بهوية قاعدة البيانات لكل الكائنات في Session معيّنة، فتُزيل المشكلات التي يسبّبها تكرار الهوية. أمّا وحدة العمل فتبني على خريطة الهوية لتوفّر نظامًا يوتّر عملية حفظ كل تغييرات الحالة في قاعدة البيانات بأكثر طريقة فعّالة ممكنة. وخطوة الحفظ الفعلية تُعرف بـ«التفريغ» (flush)، وفي SQLAlchemy الحديث تكون هذه الخطوة تلقائية عادةً.
تاريخ التطور
بدأت Session بوصفها نظامًا مخفيًّا في معظمه، مسؤولًا عن مهمة واحدة فقط: إصدار تفريغ. وتتضمّن عملية التفريغ إصدار جمل SQL إلى قاعدة البيانات، بما يقابله من تغييرات في حالة الكائنات التي يتتبّعها نظام وحدة العمل، وبذلك تتزامن الحالة الحالية لقاعدة البيانات مع ما في الذاكرة. وقد كان التفريغ أحد أكثر العمليات تعقيدًا التي نفّذها SQLAlchemy على الإطلاق.
بدأ استدعاء التفريغ في الإصدارات الأوّلية جدًا خلف دالة تُدعى commit، وكانت دالة موجودة على كائن ضمني نطاقه خيطي (thread-local) يُدعى objectstore. فعند استخدام SQLAlchemy 0.1 لم تكن هناك حاجة إلى استدعاء Session.add، ولم يكن هناك أي مفهوم لـ Session صريحة على الإطلاق. وكانت الخطوات الوحيدة الموجّهة للمستخدم هي إنشاء المُرسِلات، وإنشاء كائنات جديدة، وتعديل الكائنات المحمّلة عبر الاستعلامات (حيث كانت الاستعلامات نفسها تُستدعى مباشرةً من كل كائن Mapper)، ثم حفظ كل التغييرات عبر الأمر objectstore.commit. وكان مجمّع الكائنات لمجموعة من العمليات عامًّا على مستوى الوحدة، وغير مشروط نطاقه خيطيًا.
كان نموذج objectstore.commit نجاحًا فوريًا مع أول مجموعة من المستخدمين، لكنّ جمود هذا النموذج اصطدم سريعًا بجدار. فالمستخدمون الجدد في SQLAlchemy الحديث يشكون أحيانًا من الحاجة إلى تعريف مصنع (factory)، وربما سجلّ (registry) لكائنات Session، فضلًا عن الحاجة إلى إبقاء كائناتهم منظّمة في Session واحدة فقط في كل مرة، لكنّ هذا أفضل بكثير من الأيام الأولى حين كان النظام كلّه ضمنيًا تمامًا. ولا تزال سهولة نمط الاستخدام في النسخة 0.1 حاضرة إلى حدٍّ كبير في SQLAlchemy الحديث، الذي يتميّز بسجلّ جلسات يُهيَّأ عادةً لاستخدام نطاق خيطي.
أمّا Session نفسها فلم تُقدَّم إلّا في النسخة 0.2 من SQLAlchemy، وكان نموذجها مستوحى إلى حدٍّ بعيد من كائن Session الموجود في Hibernate. وتضمّ هذه النسخة تحكّمًا معامليًّا مدمجًا، حيث يمكن وضع Session في معاملة عبر الدالة begin، وإتمامها عبر الدالة commit. وأُعيدت تسمية دالة objectstore.commit إلى objectstore.flush، وأصبح بالإمكان إنشاء كائنات Session جديدة في أي وقت. وقد فصلت Session نفسها عن كائن آخر يُدعى UnitOfWork، الذي يظل كائنًا خاصًا مسؤولًا عن تنفيذ عملية التفريغ الفعلية.
ولأنّ عملية التفريغ بدأت كدالة يستدعيها المستخدم صراحةً، أدخلت سلسلة إصدارات 0.4 في SQLAlchemy مفهوم التفريغ التلقائي (autoflush)، أي أنّ التفريغ يُصدر فورًا قبل كل استعلام. وتتمثّل ميزة التفريغ التلقائي في أنّ جملة SQL التي يُصدرها الاستعلام يكون لها دائمًا، على الجانب العلائقي، وصول إلى الحالة الدقيقة الموجودة في الذاكرة، إذ أُرسلت كل التغييرات. ولم تستطع الإصدارات الأوّلية من SQLAlchemy تضمين هذه الميزة، لأنّ نمط الاستخدام الأشيع كان يجعل جملة التفريغ تودع التغييرات نهائيًا أيضًا. غير أنّه عند إدخال التفريغ التلقائي رافقته ميزة أخرى تُدعى Session المعامِلية (transactional)، وقد وفّرت Session تبدأ تلقائيًا في معاملة تبقى حتى يستدعي المستخدم commit صراحةً. ومع إدخال هذه الميزة، لم تعد flush تودع البيانات التي تفرّغها، وأصبح بالإمكان استدعاؤها على أساس آلي بأمان. وأصبح بإمكان Session الآن أن توفّر مزامنةً خطوة بخطوة بين الحالة في الذاكرة وحالة استعلامات SQL عبر التفريغ عند الحاجة، دون أن يُحفظ أي شيء نهائيًا حتى خطوة commit الصريحة. وهذا السلوك هو نفسه في Hibernate الخاص بـ Java. غير أنّ SQLAlchemy تبنّى هذا النمط من الاستخدام استنادًا إلى السلوك نفسه في ORM Storm الخاص بـ Python، الذي أُدخل حين كانت SQLAlchemy في نسختها 0.3.
أحضرت النسخة 0.5 تكاملًا أكبر مع المعاملات حين أُدخل انتهاء الصلاحية بعد المعاملة (post-transaction expiration)؛ فبعد كل commit أو rollback، تنتهي صلاحية كل الحالات داخل Session افتراضيًا (تُمحى)، لتُملأ مجدّدًا عندما تعيد جمل SQL التالية تحديد البيانات، أو حين تُطالَع سمات مجموعة الكائنات المنتهية الصلاحية المتبقّية في سياق المعاملة الجديدة. وصُيِّر SQLAlchemy في الأصل على افتراض أنّ جمل SELECT يجب أن تُصدر بأقل قدر ممكن، بلا استثناء. ولهذا السبب جاء سلوك انتهاء الصلاحية عند الإيداع متأخرًا؛ غير أنّه حلّ بالكامل مشكلة Session التي تحتفظ ببيانات قديمة بعد المعاملة دون وسيلة بسيطة لتحميل بيانات أحدث من دون إعادة بناء مجموعة الكائنات المحمّلة كاملة. وفي البداية بدا أنّ هذه المشكلة لا يمكن حلّها بصورة معقولة، إذ لم يتبيّن متى ينبغي لـ Session أن تعتبر الحالة الحالية قديمة، وبالتالي أن تُنتج مجموعة مكلفة جديدة من جمل SELECT عند العرض التالي. غير أنّه بمجرد انتقال Session إلى نموذج «دائمًا في معاملة»، اتّضح طرف المعاملة بوصفه النقطة الطبيعية لانتهاء صلاحية البيانات، إذ طبيعة المعاملة المعزولة بدرجة عالية هي أنّها لا تستطيع رؤية بيانات جديدة إلّا بعد إيداعها أو التراجع عنها على أي حال. وقواعد البيانات والإعدادات المختلفة، بالطبع، تتفاوت في درجات عزل المعاملات، ومنها ما لا يدعم المعاملات أصلًا. وهذه الأنماط من الاستخدام مقبولة تمامًا مع نموذج انتهاء الصلاحية في SQLAlchemy؛ ولا يحتاج المطوّر سوى أن يكون على وعي بأنّ مستوى العزل الأدنى قد يكشف تغييرات غير معزولة داخل Session إذا تشاركت عدة جلسات الصفوف نفسها. وهذا لا يختلف إطلاقًا عمّا يمكن أن يحدث عند استخدام اتصالي قاعدة بيانات مباشرةً.
لمحة عن الجلسة
يوضّح الشكل 20.13 جلسة Session والبنى الرئيسة التي تتعامل معها. 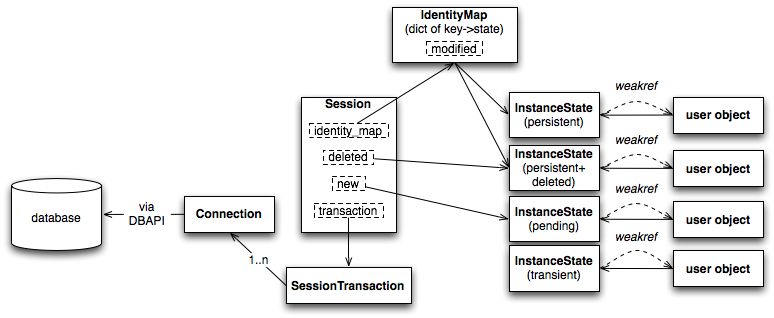 الشكل 20.13: لمحة عن الجلسة
الأجزاء المواجهة للمستخدم أعلاه هي Session نفسها ومجموعة كائنات المستخدم، كلٌّ منها مثيل لصنف مُعيَّن. وهنا نرى أنّ الكائنات المُعيَّنة تحتفظ بإشارة إلى بنية في SQLAlchemy تُدعى InstanceState، تتبّع حالة ORM لمثيل بعينه، بما في ذلك تغييرات السمات المعلّقة وحالة انتهاء صلاحية السمات. وInstanceState هي الجانب الخاص بالمثيل في تجهيز السمات الذي ناقشناه في القسم السابق تشريح التعيين، وتوازي ClassManager على مستوى الصنف، وتحافظ نيابةً عن كائنات AttributeImpl المرتبطة بالصنف على حالة قاموس الكائن المُعيَّن (أي السمة __dict__ في بايثون).
تتبّع الحالة
تمثّل IdentityMap تعيينًا من هويات قاعدة البيانات إلى كائنات InstanceState، بالنسبة إلى الكائنات التي لها هوية في قاعدة البيانات، وتُشار إليها بأنّها دائمة (persistent). ويعمل التطبيق الافتراضي لـ IdentityMap مع InstanceState على ضبط حجمه ذاتيًا بإزالة المثيلات المُعيَّنة لدى المستخدم بعد إزالة جميع المراجع القوية إليها—وبهذه الطريقة يعمل بالطريقة نفسها التي يعمل بها WeakValueDictionary في بايثون. وتحمي Session مجموعة كل الكائنات المُعلَّمة بأنّها متّسخة (dirty) أو محذوفة (deleted)، فضلًا عن الكائنات المعلّقة المُعلَّمة بأنّها جديدة (new)، من جمع القمامة، عبر إنشاء مراجع قوية لتلك الكائنات ذات التغييرات المعلّقة. ثم تُلغى جميع المراجع القوية بعد التفريغ.
كما تؤدّي InstanceState المهمة الحرجة المتمثّلة في متابعة «ما تغيّر» في سمات كائن بعينه، باستخدام نظام «النقل عند التغيير» الذي يخزّن قيمة السمة «السابقة» في قاموس يُدعى committed_state قبل إسناد القيمة الواردة إلى قاموس الكائن الحالي. وعند وقت التفريغ، تُقارن محتويات committed_state بـ __dict__ المرتبطة بالكائن لإنتاج مجموعة التغييرات الصافية في كل كائن.
وفي حالة المجموعات، تنسّق حزمة collections منفصلة مع نظام InstrumentedAttribute/InstanceState للحفاظ على مجموعة التغييرات الصافية لمجموعة معيّنة من الكائنات المُعيَّنة. إذ تُشتق أصناف بايثون الشائعة مثل set وlist وdict قبل استخدامها وتُثرى بطرق تعديل تتتبّع التاريخ. وقد أُعيد تصميم نظام المجموعات في النسخة 0.4 ليصبح مفتوحًا وقابلًا للاستخدام مع أي كائن شبيه بالمجموعة.
التحكّم المعاملي
Session، في حالة الاستخدام الافتراضية، تحافظ على معاملة مفتوحة لكل العمليات، وتُستكمل عند استدعاء commit أو rollback. وتحافظ SessionTransaction على مجموعة من صفر أو أكثر من كائنات Connection، يمثّل كلٌّ منها معاملة مفتوحة على قاعدة بيانات بعينها. وSessionTransaction كائن يُهيَّأ كسولًا ويبدأ بلا أي حالة لقاعدة بيانات فيه. وحين تُشغَّل واجهة خلفية بعينها للمشاركة في تنفيذ جملة ما، تُضاف Connection مقابلة لتلك قاعدة البيانات إلى قائمة اتصالات SessionTransaction. وفعلى الرغم من شيوع وجود اتصال واحد في كل مرة، فإنّ سيناريو تعدّد الاتصالات مدعوم، إذ يُحدَّد الاتصال المستخدَم لعملية بعينها استنادًا إلى الإعدادات المرتبطة بـ Table أو Mapper أو بنية SQL نفسها المشاركة في تلك العملية. كما يمكن لعدة اتصالات أيضًا أن تنسّق المعاملة باستخدام سلوك مرحلي (two-phase)، بالنسبة إلى واجهات DBAPI التي توفّره.
20.9. وحدة العمل
تسلّم دالة flush التي توفّرها Session عملها إلى وحدة منفصلة تُدعى unitofwork. وكما ذُكر سابقًا، تُعَدّ عملية التفريغ على الأرجح أكثر دوال SQLAlchemy تعقيدًا.
مهمة وحدة العمل هي نقل كل الحالة المعلّقة الموجودة في Session معيّنة إلى قاعدة البيانات، وإفراغ المجموعات new وdirty وdeleted التي تحتفظ بها Session. وبعد اكتمال ذلك تتطابق الحالة في ذاكرة Session مع ما هو موجود في المعاملة الحالية. والتحدي الرئيس هو تحديد سلسلة خطوات الحفظ الصحيحة، ثم تنفيذها بالترتيب الصحيح. ويشمل ذلك تحديد قائمة جمل INSERT وUPDATE وDELETE، بما فيها ما ينتج عن تسلسل (cascade) حذف صف مرتبط أو نقله لسبب آخر؛ وضمان احتواء جمل UPDATE على الأعمدة التي عُدِّلت فعليًا فحسب؛ وإنشاء عمليات «التزامن» التي تنسخ حالة أعمدة المفتاح الأساسي إلى أعمدة المفاتيح الأجنبية المشار إليها، في اللحظة التي تصبح فيها معرّفات المفاتيح الأساسية المُولَّدة حديثًا متاحة؛ وضمان وقوع عمليات INSERT بالترتيب الذي أُضيفت به الكائنات إلى Session وبأقصى قدر من الكفاءة؛ وضمان وقوع جمل UPDATE وDELETE ضمن ترتيب حتمي، من أجل تقليل احتمال حدوث حالات التوقف (deadlocks).
التاريخ
بدأ تنفيذ وحدة العمل بوصفه نظامًا متشابكًا من البنى كُتب بطريقة ارتجالية؛ ويمكن مقارنة تطوّره بالعثور على مخرج من غابة من دون خريطة. حُلّت الأخطاء المبكرة والسلوكيات الناقصة بإصلاحات مرقّعة، وعلى الرغم من أن عدة عمليات إعادة هيكلة حسّنت الأمور حتى النسخة 0.5، لم يكن حتى النسخة 0.6 أن أمكن إعادة كتابة وحدة العمل—وهي في ذلك الوقت مستقرة ومفهومة جيدًا ومغطّاة بمئات الاختبارات— كليًّا من الصفر. وبعد أسابيع من التفكير في منهج جديد يُقاد ببنى بيانات متّسقة، استغرقت عملية إعادة كتابته لاستخدام هذا النموذج الجديد أيامًا قليلة فقط، إذ كانت الفكرة مفهومة جيدًا في تلك المرحلة. كما ساعده كثيرًا أن سلوك التنفيذ الجديد كان بالإمكان التحقّق منه بعناية مقابل النسخة القائمة. وتُظهر هذه العملية كيف تبقى النسخة الأولى من أي شيء، مهما كانت سيّئة، ذات قيمة ما دامَت تقدّم نموذجًا عاملًا. كما تُظهر أيضًا كيف تكون إعادة الكتابة الكاملة لنظام فرعي، في غير قليل من الحالات، أمرًا مناسبًا لا أكثر، بل جزءًا جوهريًا من تطوير الأنظمة الصعبة التطوير.
الفرز الطوبولوجي
النموذج المفاهيمي الرئيس خلف وحدة العمل هو تجميع القائمة الكاملة بالإجراءات الواجب اتخاذها في بنية بيانات، تمثّل فيها كل عقدة خطوة واحدة؛ وهو ما يُعرف في أنماط التصميم بـ نمط الأمر (command pattern). ثم يُنظَّم تسلسل «الأوامر» داخل هذه البنية في ترتيب معيَّن باستخدام فرز طوبولوجي (topological sort). والفرز الطوبولوجي عملية ترتيب العناصر استنادًا إلى ترتيب جزئي (partial ordering)، بمعنى أنّ عناصر بعينها فقط يجب أن تسبق غيرها. ويوضّح الشكل 20.14 سلوك الفرز الطوبولوجي.
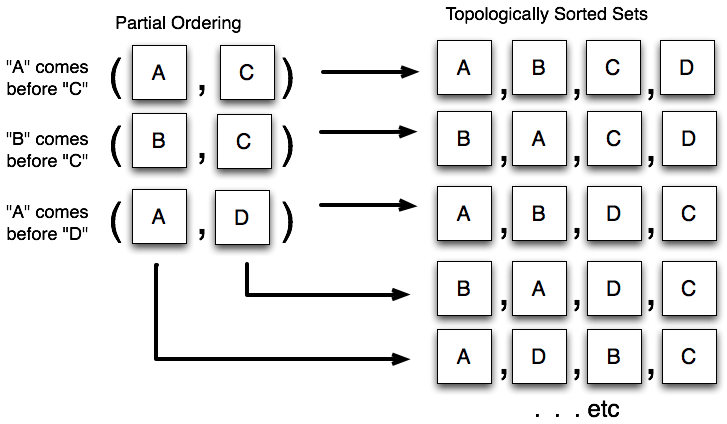 الشكل 20.14: الفرز الطوبولوجي
تبني وحدة العمل ترتيبًا جزئيًّا استنادًا إلى أوامر الحفظ التي يجب أن تسبق غيرها. ثم تُفرَّز الأوامر طوبولوجيًّا وتُستدعى بالترتيب. أمّا تحديد أي الأوامر يسبق أيّها فيستمدّ أساسًا من وجود relationship تصل بين كائنَي Mapper—فعمومًا تُعدّ أحد Mapper معتمدًا على الآخر، إذ تفترض relationship أنّ لدى أحد Mapper تبعية مفتاح أجنبي على الآخر. وثمة قواعد مماثلة لجداول الربط متعدد إلى متعدد، لكنّنا نتركّز هنا على حالة العلاقات من واحد إلى متعدد ومتعدد إلى واحد. وتُحلّ تبعية المفاتيح الأجنبية لمنع وقوع قيود، من دون الاعتماد على الحاجة إلى تعليم القيود بأنّها «مؤجَّلة». والأهم من ذلك، يتيح الترتيب تعبئة معرّفات المفاتيح الأساسية، التي لا تُولَّد في كثير من المنصّات إلّا عند وقوع INSERT فعليًا، من نتيجة جملة INSERT نُفِّذت لتوّها في قائمة وسائط صفٍّ معتمد على وشيك الإدراج. أمّا عمليات الحذف فيستخدم الترتيب نفسه بالمقلوب—فالصفوف المعتمدة تُحذف قبل الصفوف التي تعتمد عليها، إذ لا يمكن لهذه الصفوف أن تكون موجودة دون وجود الصف المُشار إليه في مفتاحها الأجنبي.
تضمّ وحدة العمل نظامًا يُجرى فيه الفرز الطوبولوجي على مستويين مختلفين، استنادًا إلى بنية التبعيات الموجودة. ينظّم المستوى الأول خطوات الحفظ في «دلاء» (buckets) استنادًا إلى التبعيات بين المُرسِلات، أي «دلاء» كاملة من الكائنات مقابلةً لصنف بعينه. ويقسّم المستوى الثاني صفرًا أو أكثر من هذه «الدلاء» إلى دفعات أصغر، للتعامل مع حالة دورات المراجع أو الجداول التي تشير إلى نفسها. ويوضّح الشكل 20.15 «الدلاء» المولَّدة لإدراج مجموعة من كائنات User، ثم مجموعة من كائنات Address، حيث تنسخ خطوة وسيطة قيم المفاتيح الأساسية المُولَّدة حديثًا لـ User إلى عمود المفتاح الأجنبي user_id في كل كائن Address.
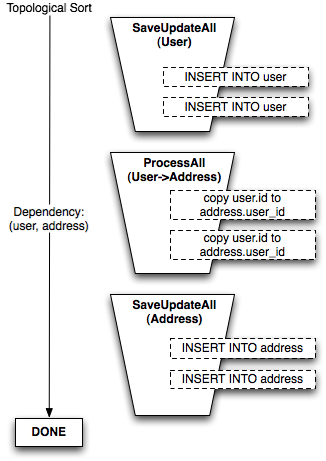 الشكل 20.15: تنظيم الكائنات بحسب المُرسِل
في حالة الفرز بحسب المُرسِل، يمكن تفريغ أي عدد من كائنات User وAddress من دون أثر في تعقيد الخطوات أو في عدد «التبعيات» الواجب أخذها في الحسبان.
ينظّم المستوى الثاني من الفرز خطوات الحفظ استنادًا إلى التبعيات المباشرة بين الكائنات الفردية في نطاق مُرسِل واحد. وأبسط مثال على حدوث ذلك هو جدول يحتوي قيد مفتاح أجنبي إلى نفسه؛ إذ يلزم إدراج صف بعينه في الجدول قبل إدراج صف آخر في الجدول نفسه يشير إليه. ومن الأمثلة الأخرى حالة سلسلة جداول تحوي دورة مراجع: الجدول A يشير إلى الجدول B، الذي يشير إلى الجدول C، الذي يشير بدوره إلى الجدول A. ويجب إدراج بعض كائنات A قبل غيرها حتى يتيسّر إدراج كائنات B وC أيضًا. أمّا الجدول الذي يشير إلى نفسه فهو حالة خاصة من دورة المراجع.
لتحديد العمليات التي يمكن أن تظلّ في «دلاء»ها المجمَّعة لكل Mapper، وأيّها سيُفكَّك إلى مجموعة أكبر من أوامر لكل كائن على حدة، تُطبَّق خوارزمية لكشف الدورات على مجموعة التبعيات الموجودة بين المُرسِلات، باستخدام نسخة معدَّلة من خوارزمية لكشف الدورات موجودة في مدوّنة Guido Van Rossum. ثم تُفكَّك «الدلاء» المتورّطة في دورات إلى عمليات لكل كائن على حدة وتُدمج في مجموعة «الدلاء» الخاصة بكل مُرسِل، عبر إضافة قواعد تبعيات جديدة من الدلاء الخاصة بكل كائن إلى الدلاء الخاصة بكل مُرسِل. ويوضّح الشكل 20.16 دلو كائنات User وهو يُفكَّك إلى أوامر فردية لكل كائن، نتيجةً لإضافة relationship جديدة من User إلى نفسه تُدعى contact.
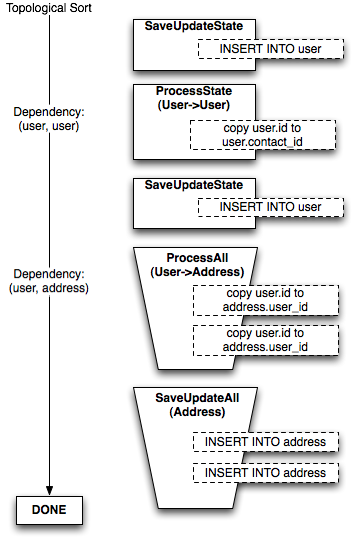 الشكل 20.16: تنظيم دورات المراجع في خطوات فردية
المنطق وراء بنية «الدلاء» هو أنها تتيح تجميع الجمل المتشابهة قدر الإمكان، فتقلّل بذلك عدد الخطوات المطلوبة في بايثون، وتجعل التفاعل مع DBAPI أكثر كفاءة، إذ يمكنه أحيانًا تنفيذ آلاف الجمل في استدعاء دالة واحد في بايثون. ولا يظهر النمط الأعلى تكلفة القائم على تبعيات لكل كائن إلّا عند وجود دورة مراجع بين المُرسِلات، وحتى حينها لا يقع إلّا في تلك الأجزاء من رسم الكائنات التي تتطلّبه.
20.10. الخاتمة
سعت SQLAlchemy منذ إنشائها إلى أهداف بالغة الطموح، وأن تكون أغنى منتجات قواعد البيانات تنوّعًا وأوسعها مرونة. وقد حقّقت ذلك مع حفاظها على تركيزها على قواعد البيانات العلائقية، مدركةً أنّ دعم جدوى قواعد البيانات العلائقية بصورة عميقة وشاملة مهمّة كبرى؛ وحتى الآن، يواصل نطاق هذه المهمّة يكشف عن نفسه بوصفه أكبر مما كان يُظنّ سابقًا.
يهدف النهج القائم على المكوّنات إلى استخراج أقصى قيمة ممكنة من كل مجال وظيفي، توفيرًا وحدات متعدّدة ومتنوّعة يمكن للتطبيقات أن تستخدمها منفردة أو مجتمعة. وقد كان هذا النظام تحديًا في الإنشاء والصيانة والإيصال.
كان مسار التطوير مقصودًا أن يكون بطيئًا، انطلاقًا من فكرة أنّ بناءً منهجيًّا وشاملًا لوظائفٍ متينة أثمن في نهاية المطاف من تسليم سريع لميزات بلا أساس. وقد استغرق الأمر وقتًا طويلًا كي تبني SQLAlchemy قصة مستخدم متّسقة وموثّقة جيدًا، لكنّ البنية الأساسية كانت دائمًا متقدّمة خطوةً إلى الأمام طوال هذه العملية، مما أدّى في بعض الحالات إلى أثر «الآلة الزمنية» حيث يمكن إضافة الميزات قبل أن يطلبها المستخدمون تقريبًا.
كانت لغة Python مضيفًا موثوقًا (وإن كانت بعض غرائبها، ولا سيما في مجال الأداء، تستدعي بعض العناية). وقد سمح اتّساق اللغة ونموذج تنفيذها المفتوح على نطاق هائل لـ SQLAlchemy أن يقدّم تجربة أفضل مما تقدّمه المنتجات المماثلة المكتوبة بلغات أخرى.
من أمل مشروع SQLAlchemy أن تنعم Python بقبولٍ متعمّق أكثر يومًا بعد يوم في أوسع مجموعة ممكنة من الحقول والقطاعات، وأن يظلّ استخدام قواعد البيانات العلائقية نشيطًا ومتطوّرًا. والهدف من SQLAlchemy هو أن تُظهر أن قواعد البيانات العلائقية وPython ونماذج الكائنات المدروسة جيدًا هي جميعها أدوات تطوير بالغة الجدارة.