PyPy
معمارية تطبيقات المصادر المفتوحة (المجلد الثاني)PyPy
معمارية تطبيقات المصادر المفتوحة (المجلد الثاني) PyPy
Benjamin Peterson
إذا استمتعت بهذه الكتب، فقد يعجبك أيضًا التصميم البرمجي بالأمثلة في Python والتصميم البرمجي بالأمثلة في JavaScript.
PyPy هو تنفيذ للغة بايثون (Python)، وهو أيضًا إطار عمل لتنفيذ اللغات الديناميكية.
يفترض هذا الفصل معرفةً ببعض المفاهيم الأساسية في المفسّرات والمصرّفات، مثل شيفرة البايت (bytecode) وطيّ الثوابت (constant folding).
19.1. تاريخ موجز
بايثون لغة برمجة ديناميكية عالية المستوى. اخترعها المبرمج الهولندي Guido van Rossum في أواخر الثمانينيات من القرن الماضي. والتنفيذ الأصلي الذي كتبه Guido هو مفسّر بايت كلاسيكي مكتوب بلغة C، ويشار إليه تبعًا لذلك باسم CPython. وهناك اليوم تنفيذات بايثون أخرى كثيرة، ومن أبرزها Jython المكتوب بلغة Java والذي يسمح بالتكامل مع شيفرة Java، وIronPython المكتوب بلغة C# والمتكامل مع إطار عمل .NET من مايكروسوفت، وPyPy وهو موضوع هذا الفصل. ولا تزال CPython أكثر التنفيذات انتشارًا، وهي حاليًا التنفيذ الوحيد الذي يدعم Python 3، وهو الجيل التالي من لغة بايثون. وسيشرح هذا الفصل قرارات التصميم في PyPy التي تجعله مختلفًا عن تنفيذات بايثون الأخرى، بل وعن أي تنفيذ آخر للغة ديناميكية.
19.2. نظرة عامة على PyPy
كُتب PyPy بالكامل بلغة بايثون، باستثناء عدد ضئيل جدًّا من دوال الكعب (stubs) المكتوبة بلغة C. وتحتوي شجرة مصدر PyPy على مكوّبين رئيسيين: مُفسِّر بايثون، وسلسلة أدوات ترجمة RPython. ومُفسِّر بايثون هو بيئة التشغيل التي يواجهها المبرمج، وهي ما يستدعيه كل من يستخدم PyPy بوصفه تنفيذًا للغة بايثون. وهو مكتوب فعليًا بمجموعة فرعية من بايثون تُسمّى بايثون المقيّدة (Restricted Python)، ويشار إليها عادةً بالاختصار RPython. والهدف من كتابة مُفسِّر بايثون بلغة RPython هو تمكين تمريره إلى الجزء الرئيسي الثاني من PyPy، وهو سلسلة أدوات ترجمة RPython. فمُصرِّف RPython يأخذ شيفرة RPython ويحوّلها إلى لغة أدنى مستوى يختارها، وهي عادةً C. وهذا يتيح لـ PyPy أن يكون تنفيذًا ذاتيَّ الاستضافة (self-hosting)، أي أنه مكتوب باللغة التي ينفّذها. وكما سنرى في طول هذا الفصل، فإن مُصرِّف RPython يجعل PyPy أيضًا إطار عمل عامًا لتنفيذ اللغات الديناميكية.
تجعل تجريدات PyPy القوية منه أكثر تنفيذات بايثون مرونةً. فهو يملك نحو 200 خيار ضبط، تتراوح بين اختيار تطبيقات مختلفة لجامع القمامة (garbage collector) وتغيير معاملات عمليات تحسين الترجمة المختلفة.
19.3. مُفسِّر بايثون
ولأن RPython مجموعة فرعية صارمة من بايثون، يمكن تشغيل مُفسِّر بايثون الخاص بـ PyPy فوق تنفيذ آخر للغة بايثون من دون ترجمته. وهذا بطبيعة الحال شديد البطء، لكنه يتيح اختبار أي تغييرات تُجرى على المُفسِّر بسرعة. كما يتيح استعمال أدوات تنقيح بايثون المعتادة في تنقيح المُفسِّر. ويمكن تشغيل معظم اختبارات مُفسِّر PyPy على المُفسِّر غير المترجَم وعلى المُفسِّر المترجَم معًا. وهذا يتيح اختبارًا سريعًا أثناء التطوير، ويضمن في الوقت نفسه أن المُفسِّر المترجَم يتصرّف تصرّفًا مطابقًا للمُفسِّر غير المترجَم.
في معظمه، تتقارب تفاصيل مُفسِّر بايثون في PyPy كثيرًا مع نظيرها في CPython؛ إذ يستخدم PyPy وCPython شيفرة بايت وبنى بيانات شبه متطابقة أثناء التفسير. والفرق الأساسي بينهما أن PyPy يملك تجريدًا ذكيًّا اسمه مساحات الكائنات (object spaces)، ويُختصر في النصوص بـ objspaces. يغلّف objspace كل ما يلزم من معرفة لتمثيل أنواع بيانات بايثون والتعامل معها. فمثلًا، إجراء عملية ثنائية على كائنَي بايثون، أو جلب خاصية من كائن ما، تتولاه مساحة الكائنات بالكامل. وهذا يُعفي المُفسِّر من معرفة أي شيء عن تفاصيل تنفيذ كائنات بايثون. يتعامل مُفسِّر شيفرة البايت مع كائنات بايثون بوصفها صناديق سوداء (black boxes)، وينادي دوال مساحة الكائنات كلما احتاج إلى التعامل معها. فمثلًا، إليك تنفيذًا تقريبيًا لأمر الثنائي BINARY_ADD، الذي يُستدعى عند دمج كائنين بالمعامل +. ولاحظ أن المُفسِّر لا يفحص المعاملات؛ فكل المعالجة تُفوَّض فورًا إلى مساحة الكائنات.
def BINARY_ADD(space, frame):
    object1 = frame.pop() # pop left operand off stack
    object2 = frame.pop() # pop right operand off stack
    result = space.add(object1, object2) # perform operation
    frame.push(result) # record result on stack
يحمل تجريد مساحة الكائنات فوائد عديدة. فهو يسمح بتبديل تطبيقات أنواع البيانات الجديدة وإدخالها من دون تعديل المُفسِّر. كما أن الطريقة الوحيدة للتعامل مع الكائنات هي عبر مساحة الكائنات، ولذلك يمكن لمساحة الكائنات أن تعترض العمليات على الكائنات أو تولّد وسيطًا لها، أو تسجّلها. وباستخدام هذا التجريد القوي لمساحات الكائنات، جرّب PyPy ما يُعرف بـ الاستدعاء المؤجَّل (thunking)، حيث يمكن حساب النتائج عند الطلب على نحو كسول لكن بشفافية تامة، وكذلك التلويث (tainting)، حيث يرفع أي عملية على كائن استثناءً، وهي مفيدة لتمرير بيانات حسّاسة عبر شيفرة غير موثوقة. أما أهمّ تطبيقات مساحات الكائنات فسيُناقش في القسم 19.4.
مساحة الكائنات المستخدَمة في مُفسِّر PyPy القياسي تُسمّى مساحة الكائنات القياسية (standard objspace)، وتُختصر في النصوص بـ std objspace. وإلى جانب التجريد الذي يوفّره نظام مساحات الكائنات، تضيف مساحة الكائنات القياسية مستوى آخر من التسيير (indirection): إذ قد يكون لنوع البيانات الواحد عدة تطبيقات. وعندئذٍ تُوزَّع العمليات على أنواع البيانات باستخدام التوافقيات (multimethods). وهذا يتيح اختيار أنسب تمثيل لعنصر بيانات بعينه. فمثلًا، يمكن تمثيل نوع الأعداد الصحيحة الطويلة في بايثون (long، وهو في ظاهره نوع بيانات bigint) بوصفه عددًا صحيحًا قياسيًا بحجم كلمة الآلة، متى كان صغيرًا بما يكفي. ولا يلجأ التنفيذ ذو الدقة التعسّبية (arbitrary-precision) للأعداد الطويلة، وهو أكثف كلفةً من حيث الذاكرة والحساب، إلا عند الحاجة. بل وهناك حتى تنفيذ متاح لأعداد بايثون الصحيحة باستخدام المؤشرات الموسومة (tagged pointers). كما يمكن تخصيص أنواع الحاويات لأنواع بيانات بعينها. فمثلًا، لدى PyPy تنفيذ لقاموس بايثون (وهو نوع بيانات جدول التجزئة في بايثون) مخصّص لمفاتيح النصوص. وإن كان النوع نفسه من البيانات يمكن تمثيله بتنفيذات مختلفة، فإن ذلك يظل شفافًا تمامًا أمام شيفرة مستوى التطبيق؛ إذ إن القاموس المخصّص للنصوص مطابق للقاموس العام، وسينحدر بسلاسة إلى القاموس العام إذا ما أُدخلت فيه مفاتيح غير نصية.
يميّز PyPy بين شيفرة مستوى المُفسِّر (interp-level) وشيفرة مستوى التطبيق (app-level). ويجب أن تكون شيفرة مستوى المُفسِّر، التي كُتب معظم المُفسِّر بها، بلغة RPython وأن تُترجم. وهي تعمل مباشرةً مع مساحة الكائنات وكائنات بايثون المُغلَّفة. أما شيفرة مستوى التطبيق فيشغّلها دائمًا مُفسِّر شيفرة البايت في PyPy. وبرغم بساطة شيفرة RPython على مستوى المُفسِّر مقارنةً بـ C أو Java، وجد مطوّرو PyPy أن استخدام شيفرة مستوى التطبيق الخالصة لبعض أجزاء المُفسِّر هو الأسهل. وعليه، يدعم PyPy تضمين شيفرة مستوى التطبيق داخل المُفسِّر. فمثلًا، وظيفة عبارة بايثون print، التي تكتب الكائنات إلى الإخراج القياسي، منفَّذة بلغة بايثون على مستوى التطبيق. كما يمكن كتابة الوحدات المدمجة جزئيًا بشيفرة مستوى المُفسِّر وجزئيًا بشيفرة مستوى التطبيق.
19.4. مُصرِّف RPython
مُصرِّف RPython هو سلسلة أدوات تتألف من عدة مراحل تخفيض (lowering) تعيد كتابة RPython إلى لغة الهدف، وهي عادةً C. وتُعرض المراحل الأعلى مستوى من الترجمة في الشكل 19.1. والمُصرِّف نفسه مكتوب بلغة بايثون (غير المقيّدة)، وهو مرتبط ارتباطًا وثيقًا بمُفسِّر بايثون في PyPy لأسباب سيتضح معنا قريبًا.
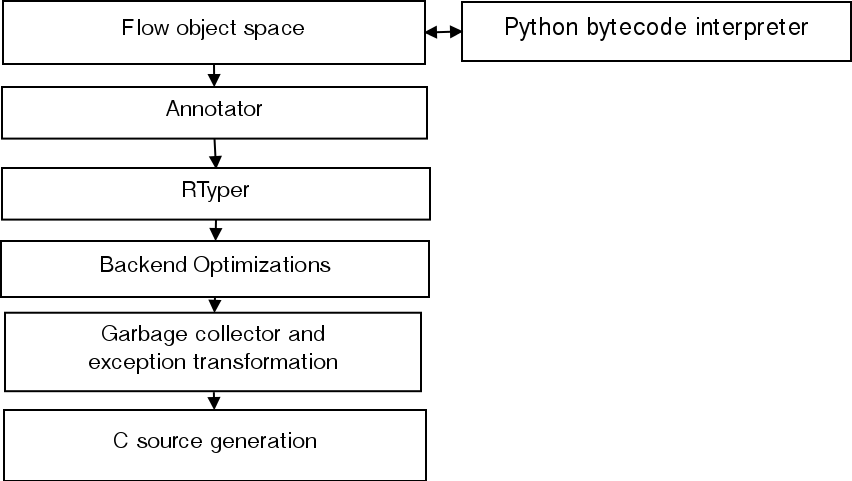 الشكل 19.1: مراحل الترجمة
أول ما يفعله المُصرِّف هو تحميل برنامج RPython إلى عمليته (process). (ويُنفَّذ ذلك عبر آلية تحميل الوحدات المعتادة في بايثون.) ويفرض RPython مجموعة قيود على بايثون الديناميكية المعتادة. فمثلًا، لا يمكن إنشاء الدوال في وقت التشغيل، ولا يمكن لمتغيّر واحد أن تكون له إمكانية حمل أنواع غير متوافقة، مثل عدد صحيح وكائن ما. غير أن البرنامج، حين يُحمَّل أولًا بواسطة المُصرِّف، يكون قيد التشغيل على مُفسِّر بايثون عادي، فيستطيع استعمال كل سمات بايثون الديناميكية. ويستخدم مُفسِّر بايثون في PyPy، وهو برنامج RPython ضخم، هذه الميزة بكثرة في البرمجة بالميتاكود (metaprogramming). فمثلًا، يولّد شيفرة لتوزيع التوافقيات في مساحة الكائنات القياسية. والاشتراط الوحيد هو أن يكون البرنامج RPython صالحًا بحلول الوقت الذي يبدأ فيه المُصرِّف مرحلة الترجمة التالية.
يبني المُصرِّف رسومًا بيانية للتدفّق (flow graphs) لبرنامج RPython عبر عملية تُسمّى التفسير المجرّد (abstract interpretation). ويعيد التفسير المجرّد استعمال مُفسِّر بايثون في PyPy لتفسير برامج RPython باستخدام مساحة كائنات خاصة تُسمّى مساحة كائنات التدفّق (flow objspace). وتذكّر أن مُفسِّر بايثون يتعامل مع كائنات البرنامج بوصفها صناديق سوداء، فينادي مساحة الكائنات لإنجاز أي عملية. أمّا مساحة كائنات التدفّق، فبدلًا من المجموعة القياسية من كائنات بايثون، لا تملك سوى نوعين: المتغيّرات والثوابت. وتمثّل المتغيّرات قيمًا لا تُعرف وقت الترجمة، بينما تمثّل الثوابت، وهو واضح بذاته، قيمًا غير قابلة للتغيير معروفة. وتتوفّر لمساحة كائنات التدفّق إمكانية أساسية لطيّ الثوابت؛ فإذا طُلب منها تنفيذ عملية تكون كل وسائطها ثوابت، فإنها تُقيّمها إحصائيًا. وما يجب أن يكون غير قابل للتغيير، وبالتالي ثابتًا، في RPython أوسع مما هو عليه في بايثون المعتادة. فمثلًا، الوحدات (modules)، وهي قابلة للتغيير قطعًا في بايثون، تُعدّ ثوابت في مساحة كائنات التدفّق لأنها لا وجود لها في RPython ويجب أن تُطوى ثابتًا بواسطة مساحة كائنات التدفّق. ومع أن مُفسِّر بايثون يفسّر شيفرة بايت دوال RPython، فإن مساحة كائنات التدفّق تسجّل العمليات المطلوبة منها. وتحرص على تسجيل جميع فروع بنى التحكم في التدفّق الشرطية. والنتيجة النهائية للتفسير المجرّد لدالة ما هي رسم بياني للتدفّق مكوّن من كتل مترابطة، تحمل كل كتلة عملية واحدة أو أكثر.
لنرَ ذلك بمثال يوضّح عملية توليد الرسوم البيانية للتدفّق. خُذ دالة مضروب (factorial) بسيطة:
def factorial(n):
    if n == 1:
        return 1
    return n * factorial(n - 1)
يبدو الرسم البياني للتدفّق لهذه الدالة على النحو التالي:
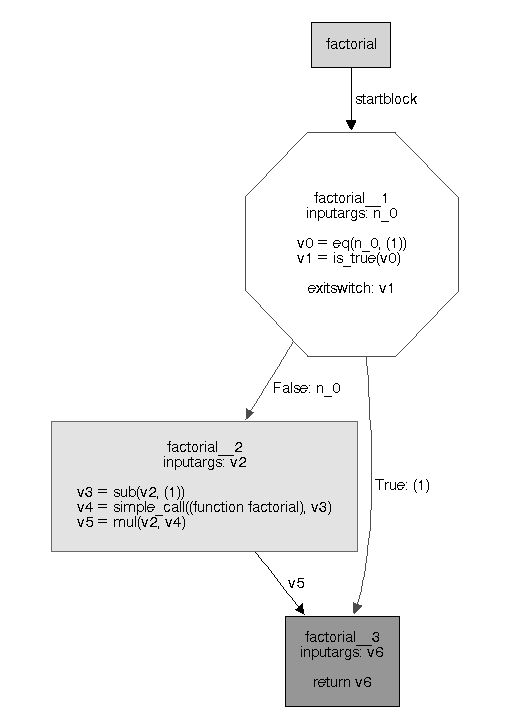 الشكل 19.2: الرسم البياني لتدفّق دالة المضروب
قُسِّمت دالة المضروب إلى كتل تضمّ العمليات التي سجّلتها مساحة التدفّق. ولكل كتلة وسائط دخل وقائمة عمليات على المتغيّرات والثوابت. أمّا الكتلة الأولى فلها مفتاح خروج (exit switch) في نهايتها، يحدّد الكتلة التي سينتقل إليها التدفّق بعد تنفيذ الكتلة الأولى. وقد يستند مفتاح الخروج إلى قيمة متغيّر ما أو إلى ما إذا كان قد وقع استثناء في آخر عملية داخل الكتلة. ويتبع تدفّق التحكّم الخطوطَ التي تصل بين الكتل.
يأتي الرسم البياني للتدفّق الذي تولّده مساحة كائنات التدفّق على الصيغة الساكنة للتخصيص المفرد (static single assignment form، أو SSA)، وهي تمثيل وسيط شائع في المصرّفات. والخاصية الجوهرية في SSA هي أن كل متغيّر يُسنَد إليه القيمة مرة واحدة فقط. وهذه الخاصية تبسّط تنفيذ كثير من تحويلات المصرّف وتحسيناته.
بعد توليد رسم الدالة البياني، تبدأ مرحلة الإيضاح (annotation). ويُسند المُوَضِّح (annotator) نوعًا إلى نتائج كل عملية ووسائطها. فمثلًا، ستُوضَح دالة المضروب أعلاه بأنها تقبل عددًا صحيحًا وتُعيده.
المرحلة التالية تُسمّى RTyping. وتستخدم هذه المرحلة معلومات الأنواع التي وفّرها المُوَضِّح لتوسيع كل عملية عالية المستوى في الرسم البياني للتدفّق إلى عمليات أدنى مستوى. وهي أول جزء من الترجمة تصبح فيه الواجهة الخلفية (backend) مهمّة. وتختار الواجهة الخلفية نظام أنواع لمُكتِّب RTyper ليتخصّص البرنامج على أساسه. ويملك RTyper حاليًا نظامَي أنواع: نظام أنواع منخفض المستوى للواجهات الخلفية مثل C، وآخر لأنظمة الأنواع الأعلى مستوى التي تضمّ أصنافًا (classes). وتُحوَّل عمليات بايثون وأنواعها العالية المستوى إلى مستوى نظام الأنواع المختار. فمثلًا، ستولّد عملية add مُعاملاتِها موسومةً كأعداد صحيحة عمليةَ int_add في نظام الأنواع المنخفض المستوى. أما العمليات الأكثر تعقيدًا، مثل البحث في جداول التجزئة، فتولّد استدعاءات دوال.
بعد RTyping، تُجرى بعض عمليات التحسين على الرسم البياني منخفض المستوى. وهي في معظمها من طراز التحسينات التقليدية للمصرّفات، مثل طيّ الثوابت، وإغراق المخازن (store sinking)، وإزالة الشيفرة الميتة.
تتكاثر عمليات تخصيص الذاكرة الديناميكية عادةً في شيفرة بايثون. وRPython، بوصفه مشتقًّا من بايثون، يرث هذا النمط كثيف التخصيص. غير أن هذه التخصيصات، في كثير من الحالات، مؤقتة ومحصورة في دالة واحدة. وإزالة التخصيصات (malloc removal) هي تحسين يعالج هذه الحالات. وهي تزيل هذه التخصيصات عبر «تسطيح» الكائن الذي كان مخصَّصًا ديناميكيًا قبل ذلك إلى قيمه العددية المكوّنات، متى أمكن.
ولكي ترى كيف تعمل إزالة التخصيصات، خُذ الدالة التالية التي تحسب المسافة الإقليدية بين نقطتين في المستوية بطريقة ملتفّة:
def distance(x1, y1, x2, y2):
    p1 = (x1, y1)
    p2 = (x2, y2)
    return math.hypot(p1[0] - p2[0], p1[1] - p2[1])
عند تطبيق RTyping أولًا، يحتوي جسم الدالة على العمليات التالية:
v60 = malloc((GcStruct tuple2))
v61 = setfield(v60, ('item0'), x1_1)
v62 = setfield(v60, ('item1'), y1_1)
v63 = malloc((GcStruct tuple2))
v64 = setfield(v63, ('item0'), x2_1)
v65 = setfield(v63, ('item1'), y2_1)
v66 = getfield(v60, ('item0'))
v67 = getfield(v63, ('item0'))
v68 = int_sub(v66, v67)
v69 = getfield(v60, ('item1'))
v70 = getfield(v63, ('item1'))
v71 = int_sub(v69, v70)
v72 = cast_int_to_float(v68)
v73 = cast_int_to_float(v71)
v74 = direct_call(math_hypot, v72, v73)
هذه الشيفرة دون المُثلى في جوانب عديدة. فأُنشئ صفّان (tuples) لا يفلتان من الدالة أبدًا. إضافةً إلى ذلك، يوجد تسيير (indirection) غير ضروري عند الوصول إلى حقول الصفّين.
ويُنتج تشغيل إزالة التخصيصات الشيفرة المختصرة التالية:
v53 = int_sub(x1_0, x2_0)
v56 = int_sub(y1_0, y2_0)
v57 = cast_int_to_float(v53)
v58 = cast_int_to_float(v56)
v59 = direct_call(math_hypot, v57, v58)
أُزيلت تخصيصات الصفّين تمامًا، وسُطِّحت مسارات التسيير. وسنرى لاحقًا كيف تُستعمل تقنية تشبه إزالة التخصيصات على بايثون مستوى التطبيق في مُصرِّف PyPy الفوري (القسم 19.5).
ويُجري PyPy أيضًا تضمين الدوال (function inlining). وكما في اللغات الأدنى مستوى، يحسّن التضمين الأداء في RPython. ومما يُثير الدهشة أنه يخفّض حجم الملف التنفيذي النهائي أيضًا. والسبب في ذلك أنه يتيح مزيدًا من طيّ الثوابت ومن إزالة التخصيصات، مما يُقلّص حجم الشيفرة الإجمالية.
يُمرَّر البرنامج، وهو الآن في رسوم بيانية للتدفّق محسّنة ومنخفضة المستوى، إلى الواجهة الخلفية لتوليد الشيفرة المصدرية. وقبل أن تتمكّن من توليد شيفرة C، على الواجهة الخلفية الخاصة بـ C إجراء بعض التحويلات الإضافية. ومن هذه التحويلات تحويل الاستثناءات (exception transformation)، حيث تُعاد كتابة معالجة الاستثناءات لتستخدم فتح المكدس يدويًا (manual stack unwinding). ومنها أيضًا إدراج فحوص عمق المكدس (stack depth checks). وهذه ترفع استثناءً في وقت التشغيل إذا كان التعاود عميقًا أكثر من اللازم. وتُحدَّد المواضع التي يلزم فيها فحص عمق المكدس بحساب الدورات في رسم استدعاءات (call graph) البرنامج.
ومن التحويلات الأخرى التي تُجريها الواجهة الخلفية لـ C إضافة جمع القمامة (GC). وRPython، مثل بايثون، لغة يديرها جامع القمامة، لكن C ليست كذلك، لذا لا بد من إضافة جامع قمامة. ولتحقيق ذلك، يحوّل محوّل جمع القمامة (garbage collection transformer) الرسوم البيانية للتدفّق للبرنامج إلى برنامج مُدار بجمع القمامة. وتقدّم محوّلات جمع القمامة في PyPy برهانًا ممتازًا على كيف تحجب الترجمة التفاصيل اليومية. ففي CPython، الذي يستخدم عدّ المراجع (reference counting)، يجب أن يتابع شيفرة C في المُفسِّر بعناية المراجع إلى كائنات بايثون التي يتعامل معها. وهذا لا يثبّت مخطّط جمع القمامة في قاعدة الشيفرة فحسب، بل يميل إلى الوقوع في أخطاء بشرية دقيقة. ويحلّ محوّل جمع القمامة في PyPy المشكلتين معًا؛ فهو يسمح باستبدال مخطّطات جمع القمامة المختلفة وإدخالها بسلاسة. ويُشترى تقييم أي تنفيذ لجامع القمامة (ولدى PyPy منها الكثير) بتعديل خيار ضبط واحد عند الترجمة. وبخلاف أخطاء المحوّلات، لا يخطئ محوّل جمع القمامة أبدًا في مراجعه، ولا ينسى إعلام الجامع عندما يتوقّف الكائن عن الاستخدام. وتجعل قوة تجريد جمع القمامة ممكنًا تطبيقاتَ لجمع القمامة يستحيل عمليًا تثبيتها برمجيًا داخل مُفسِّر. فمثلًا، تتطلب عدة من تطبيقات جمع القمامة في PyPy حاجز كتابة (write barrier). وحاجز الكتابة هو فحص يجب تنفيذه في كل مرة يوضع فيها كائن مُدار من قِبل الجامع في مصفوفة أو بنية أخرى مُدارة من قِبل الجامع. ولو أُنجز إدراج حواجز الكتابة يدويًا لكان مرهقًا مليئًا بالأخطاء، لكنه تافه حين يتولّاه محوّل جمع القمامة تلقائيًا.
أخيرًا، تستطيع الواجهة الخلفية لـ C أن تُصدر شيفرة C المصدرية. والشيفرة المُولَّدة، لأنها مبنية على رسوم بيانية منخفضة المستوى، هي فوضى قبيحة من تعليمات goto ومتغيّرات ذات أسماء غامضة. ومن مزايا الكتابة بلغة C أن مصرّف C يستطيع أن يتولّى معظم أعمال التحويل الساكنة المعقّدة اللازمة لتحويل الشيفرة إلى ملف تنفيذي نهائي، مثل تحسين الحلقات (loop optimizations) وتخصيص السجلات (register allocation).
19.5. مُصرِّف PyPy في الوقت المناسب (JIT)
بايثون، مثل معظم اللغات الديناميكية، ضحّت تاريخيًا بالكفاءة مقابل المرونة. وبنية PyPy، بما هي غنية على وجه خاص بالمرونة والتجريد، تجعل التفسير فائق السرعة صعبًا. وتجريدا مساحة الكائنات والتوافقيات القويّان في مساحة الكائنات القياسية لا يأتيان بلا ثمن. ونتيجةً لذلك، يُنفِّذ المُفسِّر القياسي في PyPy أبطأ بما يصل إلى 4 أضعاف مقارنةً بـ CPython. ولمعالجة هذا الأمر لا سمعة بايثون كلغة بطيئة فحسب، جهّز PyPy مصرّفًا في الوقت المناسب (just-in-time compiler، ويُكتب عادةً JIT). ويصرّف JIT المسارات الشيفرية كثيرة الاستخدام إلى شيفرة تجميع (assembly) أثناء تشغيل البرنامج.
يستفيد مُصرِّف PyPy الفوري من بنية الترجمة الفريدة في PyPy الموصوفة في القسم 19.4. وفي الواقع لا يملك PyPy مُصرِّفًا فوريًا مخصَّصًا لبايثون؛ بل يملك مولِّد مُصرِّفات فورية. وقد نُفِّذ توليد الـ JIT بوصفه مجرد تمريرة اختيارية إضافية أثناء الترجمة. ولا يحتاج المُفسِّر الراغب في توليد JIT إلا إلى إجراء استدعاءَي دالتين خاصتين تُسمّيان تلميحات JIT (jit hints).
مُصرِّف PyPy الفوري هو مُصرِّف تتبّعي (tracing JIT). أي أنه يكتشف الحلقات «ساخنة»، أي التي تُنفَّذ كثيرًا، ليُحسّنها بالتصريف إلى شيفرة تجميع. وحين يقرّر JIT أنه سينصرّف إلى تصريف حلقة ما، فإنه يسجّل عمليات تكرار واحد من تلك الحلقة في عملية تُسمّى التتبّع (tracing). ثم تُصرَّف هذه العمليات لاحقًا إلى شيفرة آلة.
كما ذُكر أعلاه، لا يحتاج مولِّد الـ JIT في المُفسِّر إلى سوى تلميحين لتوليد مُصرِّف فوري: merge_point وcan_enter_jit. ويخبر can_enter_jit الـ JIT بأين تبدأ الحلقة في المُفسِّر. وفي مُفسِّر بايثون، هذا هو نهاية شيفرة البايت JUMP_ABSOLUTE. (وJUMP_ABSOLUTE تجعل المُفسِّر يقفز إلى رأس الحلقة على مستوى التطبيق.) أما merge_point فيخبر الـ JIT بالنقطة التي يُجوز عندها العودة من JIT إلى المُفسِّر. وهذه هي بداية حلقة توزيع شيفرة البايت في مُفسِّر بايثون.
يُستدعى مولِّد الـ JIT بعد مرحلة RTyping في الترجمة. وتذكّر أن الرسوم البيانية للتدفّق للبرنامج، في هذه المرحلة، تتألف من عمليات منخفضة المستوى شبه جاهزة لتوليد شيفرة الهدف. ويبحث مولِّد الـ JIT عن التلميحين المذكورين أعلاه داخل المُفسِّر، ثم يستبدلهما باستدعاءات تُشغّل JIT في وقت التشغيل. ويكتب مولِّد الـ JIT بعد ذلك تمثيلًا مسلسلًا (serialized) للرسوم البيانية للتدفّق لكل دالة يريد المُفسِّر تصريفها فوريًا. وتُسمّى هذه الرسوم المسلسلة شيفرات jitcodes. وبذلك يُصوَّف المُفسِّر بأكمله الآن بعبارات عمليات RPython منخفضة المستوى. وتُحفظ شيفرات jitcodes في الملف التنفيذي النهائي لاستخدامها في وقت التشغيل.
في وقت التشغيل، يحتفظ JIT بعدّاد لكل حلقة تُنفَّذ في البرنامج. وحين يتجاوز عدّاد الحلقة عتبة قابلة للضبط، يُستدعى JIT ويبدأ التتبّع. والكائن المفتاح في التتبّع هو المُفسِّر الفوقي (meta-interpreter). وينفّذ المُفسِّر الفوقي شيفرات jitcodes التي أُنشئت أثناء الترجمة، فهو إذن يفسّر المُفسِّر الرئيسي، ومن هنا اسمُه. وهو إذ يتتبّع الحلقة ينشئ قائمة بالعمليات التي ينفّذها ويسجّلها في التمثيل الوسيط (intermediate representation، أو IR) الخاص بـ JIT، وهو صيغة عمليات أخرى. وتُسمّى هذه القائمة أثر الحلقة (trace). وحين يصادف المُفسِّر الفوقي استدعاءً لدالة مصروفة فوريًا (أي دالة توجد لها شيفرة jitcode)، فإنه يدخلها ويسجّل عملياتها في الأثر الأصلي. وبذلك يكون للتتبّع أثر تسطيح مكدّس الاستدعاءات؛ إذ لا توجد في الأثر إلا استدعاءات إلى دوال مُفسِّر تقع خارج معرفة JIT.
يُضطر المُفسِّر الفوقي إلى تخصيص الأثر لخصائص تكرار الحلقة التي يتتبّعها. فمثلًا، حين يصادف المُفسِّر الفوقي جملة شرطية في شيفرة jitcode، فإنه يُضطر بطبيعة الحال إلى اختيار مسار واحد بالاستناد إلى حالة البرنامج. وحين يتخذ قرارًا بالاستناد إلى معلومات وقت التشغيل، يسجّل المُفسِّر الفوقي عملية IR تُسمّى حارسًا (guard). وفي حالة الجملة الشرطية، ستكون هذه عملية guard_true أو guard_false على متغيّر الشرط. ولكثير من العمليات الحسابية حراسةً أيضًا، تتحقّق من أن العملية لم تتجاوز حدودها (overflow). وبجوهرها، تُرمِّز الحراسات بوصفها الافتراضات التي يراهن عليها المُفسِّر الفوقي أثناء تتبّعه. وحين يُولَّد شيفرة التجميع، تحمي الحراساتُ الشيفرةَ من أن تُنفَّذ في سياق لم تخصَّص له. وينتهي التتبّع حين يبلغ المُفسِّر الفوقي عملية can_enter_jit نفسها التي بدأ عندها التتبّع. ويمكن الآن تمرير IR الحلقة إلى المحسِّن.
يضمّ محسِّن الـ JIT عددًا قليلًا من التحسينات الكلاسيكية للمصرّفات، والعديد من التحسينات المخصّصة للّغات الديناميكية. ومن أهمّ هذه التحسينات الأخيرة الكائنات الافتراضية (virtuals) والكائنات القابلة للافتراضية (virtualizables).
الكائنات الافتراضية هي كائنات لا يُعرف أنها تفلت من الأثر، أي أنها لا تُمرَّر وسائطَ إلى استدعاءات دوال خارجية غير مصروفة فوريًا. ويمكن أن تكون البنى والمصفوفات ذات الطول الثابت افتراضية. وليس على الكائنات الافتراضية أن تُخصَّص في الذاكرة، إذ يمكن تخزين بياناتها مباشرةً في السجلات وعلى المكدس. (وهذا يشبه إلى حد كبير مرحلة إزالة التخصيصات الساكنة الموصوفة في قسم تحسينات الواجهة الخلفية للترجمة.) وتحلّ تحسينات الكائنات الافتراضية مشكلات التسيير وكفاءة تخصيص الذاكرة في مُفسِّر بايثون. فمثلًا، بمجرد أن يصير كائن العدد الصحيح في بايثون افتراضيًّا، يُفكّ صندوقه (unboxed) ليصير عددًا صحيحًا بسيطًا بحجم الكلمة، ويمكن تخزينه مباشرةً في سجلات الآلة.
يتصرّف الكائن القابل للافتراضية إلى حد كبير كالكائن الافتراضي، لكنه قد يفلت من الأثر، أي أنه يُمرَّر إلى دوال غير مصروفة فوريًا. وفي مُفسِّر بايثون، يُعلَّم كائن الإطار (frame object)، الذي يحتفظ بقيم المتغيّرات ومؤشّر التعليمة، بأنه قابل للافتراضية. وهذا يتيح تحسين عمليات المكدس وغيرها من العمليات على الإطار وإزالتها. وبرغم تشابه الكائنات الافتراضية والقابلة للافتراضية، فلا يشتركان في شيء من حيث التنفيذ. تُعالَج القابلة للافتراضية أثناء التتبّع على يد المُفسِّر الفوقي، بخلاف الكائنات الافتراضية التي تُعالَج أثناء تحسين الأثر. والسبب في ذلك أن القابلة للافتراضية تحتاج معالجة خاصة، لأنها قد تفلت من الأثر. وتحديدًا، ينبغي للمُفسِّر الفوقي أن يضمن ألا تحاول الدوال غير المصروفة فوريًا التي قد تستخدم الكائن القابل للافتراضية جلب حقوله فعليًا. والسبب أن حقول الكائن القابل للافتراضية في الشيفرة المصروفة فوريًا مخزَّنة في المكدس والسجلات، فقد يكون الكائن نفسه قديم القيمة بالنسبة لقيمه الحالية في الشيفرة المصروفة فوريًا. وأثناء توليد JIT، تُعاد كتابة الشيفرة التي تصل إلى كائن قابل للافتراضية لتفحص ما إذا كانت شيفرة التجميع المصروفة فوريًا قيد التشغيل. فإن كانت كذلك، يُطلب من JIT تحديث الحقول انطلاقًا من البيانات الموجودة في شيفرة التجميع. إضافةً إلى ذلك، حين يعود الاستدعاء الخارجي إلى شيفرة مصروفة فوريًا، يعود التنفيذ إلى المُفسِّر.
بعد التحسين، يكون الأثر جاهزًا للتجميع. ولأن IR الخاص بـ JIT منخفض المستوى إلى حد كبير، فإن توليد شيفرة التجميع ليس صعبًا جدًا. وتناظر معظم عمليات IR بضع عمليات فقط من شيفرة تجميع x86. ومُخصِّص السجلات (register allocator) هنا خوارزمية خطّية بسيطة. وفي الوقت الحالي، لم يكن الزمن الإضافي الذي سيُقضاه في الواجهة الخلفية مع خوارزمية تخصيص سجلات أكثر تطوّرًا، مقابل شيفرة أفضل قليلًا، مبرَّرًا. وأصعب أجزاء توليد شيفرة التجميع هي تكامل جامع القمامة واستعادة الحراسات (guard recovery). ويجب أن يطّلع جامع القمامة على جذور المكدس (stack roots) الموجودة في شيفرة JIT المُولَّدة. ويُتحقَّق من ذلك عبر دعم خاص في جامع القمامة لخرائط الجذور الديناميكية (dynamic root maps).
حين يفشل حارس، تصير شيفرة التجميع المصرَّفة غير صالحة، ولا بد من إعادة التحكم إلى مُفسِّر شيفرة البايت. وهذه العودة المفاجئة (bail out) هي أصعب أجزاء تنفيذ JIT، إذ لا بد من إعادة بناء حالة المُفسِّر من حالة السجلات والمكدس عند نقطة فشل الحارس. ولكل حارس، يكتب المُجمِّع (assembler) وصفًا مضغوطًا بمواضع جميع القيم اللازمة لإعادة بناء حالة المُفسِّر. وعند فشل الحارس، يقفز التنفيذ إلى دالة تفكّ ترميز هذا الوصف وتُمرِّر قيم الاستعادة إلى مستوى أعلى حيث تُعاد بناؤها. وقد يقع الحارس الفاشل في منتصف تنفيذ أمر (opcode) معقّد، لذا لا يستطيع المُفسِّر أن يبدأ مجددًا بالأمر التالي. وحلّ ذلك يستعمل PyPy مُفسِّر ثقب أسود (blackhole interpreter). وينفّذ مُفسِّر الثقب الأسود شيفرات jitcodes بدءًا من نقطة فشل الحارس حتى يبلغ نقطة الدمج التالية. وهناك يستأنف المُفسِّر الحقيقي عمله. ويُسمّى مُفسِّر الثقب الأسود بهذا الاسم لأنه، بخلاف المُفسِّر الفوقي، لا يسجّل أيًّا من العمليات التي ينفّذها. ويُصوَّر في الشكل 19.3 عملية فشل الحارس.
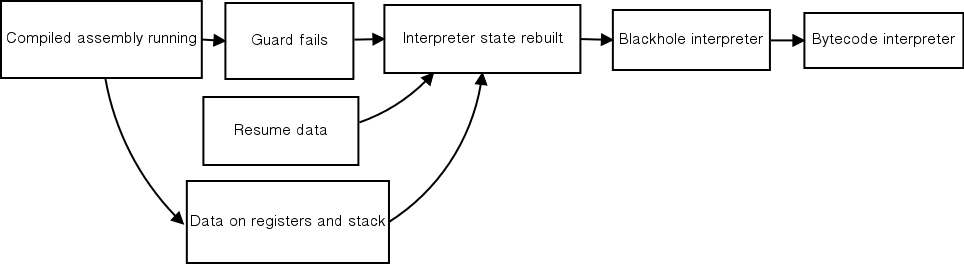 الشكل 19.3: العودة إلى المُفسِّر عند فشل حارس
على النحو الموصوف حتى الآن، سيكون JIT عديم الفائدة عمليًا مع أي حلقة ذات شرط متغيّر باستمرار، لأن فشل الحارس سيمنع شيفرة التجميع من تشغيل عدد كبير من التكرارات. ولكل حارس عدّاد للفشل. وبعد أن يتجاوز عدد مرات الفشل عتبةً معيّنة، يبدأ JIT بالتتبّع انطلاقًا من نقطة فشل الحارس بدلًا من العودة إلى المُفسِّر. وتُسمّى هذا الأثر الفرعي الجديد جسرًا (bridge). وحين يبلغ التتبّع نهاية الحلقة، يُحسَّن الجسر ويُصرَّف، وتُرقَّع الحلقة الأصلية عند الحارس لتقفز إلى الجسر الجديد بدلًا من شيفرة الفشل. وهكذا يمكن تصريف الحلقات ذات الشروط الديناميكية فوريًا.
إلى أي حد أثبتت التقنيات المستخدمة في مُصرِّف PyPy الفوري نجاحها؟ ففي وقت كتابة هذا الفصل، يكون PyPy أسرع من CPython بمعامل قدره خمسة أضعاف في المتوسط الهندسي على مجموعة شاملة من اختبارات الأداء (benchmarks). ومع JIT، بات من الممكن أن يتفوّق بايثون على مستوى التطبيق في السرعة على شيفرة مستوى المُفسِّر. وقد واجه مطوّرو PyPy مؤخرًا المشكلة الرائعة تتمثل في اضطرارهم إلى كتابة حلقات مستوى المُفسِّر بلغة بايثون على مستوى التطبيق من أجل الأداء.
والأهم من ذلك، أن كون الـ JIT غير مخصّص لبايثون يعني أنه قابل للتطبيق على أي مُفسِّر مكتوب داخل إطار عمل PyPy. وليس بالضرورة أن يكون مُفسِّر لغة. فمثلًا، يُستخدم JIT في محرّك التعبيرات النمطية (regular expression) الخاص ببايثون. أما NumPy فهو وحدة قويّة للمصفوفات في بايثون، تُستخدم في الحوسبة العددية والبحث العلمي. ويملك PyPy إعادة تنفيذ تجريبية لـ NumPy. وهو يستثمر قوة مُصرِّف PyPy الفوري لتسريع العمليات على المصفوفات. ومع أن تنفيذ NumPy لا يزال في مراحله المبكرة، فإن نتائج الأداء الأولية تبدو واعدة.
19.6. عيوب التصميم
ولأنه يتفوّق على C في أي يوم، فإن الكتابة بلغة RPython قد تكون تجربة محبِطة. فأنواعه الضمنية (implicit typing) يصعب التعوّد عليها في البداية. وليست كل مزايا لغة بايثون مدعومة، وبعضها الآخر مقيّد بشكل اعتباطي. وRPython غير موصَّل رسميًا في أي مكان، وما يقبله المُصرِّف قد يتغيّر من يوم إلى آخر مع تكيّف RPython مع احتياجات PyPy. وكثيرًا ما ينتهي مؤلّف الفصل إلى إنشاء برامج تدور في المُصرِّف نصف ساعة، لتفشل في النهاية بخطأ غامض.
إن كون مُصرِّف RPython محلّلًا للبرنامج كله (whole-program analyzer) يخلق بعض المشكلات العملية. فأصغر تغيير في أي موضع من الشيفرة المترجَمة يستلزم إعادة ترجمة المُفسِّر بأكمله. ويستغرق ذلك حاليًا نحو 40 دقيقة على نظام سريع حديث. ويكون التأخير مزعجًا بصفة خاصة عند اختبار أثر التغييرات في JIT، لأن قياس الأداء يستلزم مُفسِّرًا مترجَمًا. واشتراط حضور البرنامج بأكمله وقت الترجمة يعني أن الوحدات التي تحوي RPython لا يمكن بناؤها وتحميلها بمعزل عن مُفسِّر النواة.
ليست مستويات التجريد في PyPy دائمًا بهذه الحدة التي تنظّر لها النظرية. فبينما يُفترض تقنيًا أن يملك مولِّد الـ JIT القدرة على إنتاج مُصرِّف فوري ممتاز لأي لغة بالاعتماد على التلميحين المذكورين أعلاه وحدهما، فإن الواقع أنه يتصرّف على بعض الشيفرة أفضل من تصرّفه على غيرها. وقد لقي مُفسِّر بايثون عملًا كثيرًا في جعله أكثر «ملاءمةً للـ JIT»، بما في ذلك تلميحات JIT كثيرة أكثر، وحتى بنى بيانات جديدة محسّنة من أجل JIT.
قد تجعل طبقات PyPy العديدة تتبّع الأعطال عملية شاقة. فقد يكون خلل في مُفسِّر بايثون موجودًا مباشرةً في شيفرة المُفسِّر، أو مدفونًا في دلالات RPython وسلسلة أدوات الترجمة. ويعمل خاصةً عندما يتعذّر إعادة إنتاج الخلل على المُفسِّر غير المترجَم، تصبح عملية التنقيح صعبة. وهي تتطلّب عادةً تشغيل GDB على مصادر C المُولَّدة التي تكاد تكون غير مقروءة.
حتى ترجمة مجموعة فرعية مقيّدة من بايثون إلى لغة أدنى مستوى بكثير مثل C ليست مهمة سهلة. فمراحل التخفيض (lowering passes) الموصوفة في القسم 19.4 ليست مستقلة في الواقع. إذ تُوضَّح الدوال وتُكتَب أنواعها (rtyped) في طول عملية الترجمة، والمُوَضِّح لديه بعض المعرفة بأنواع المنخفضة المستوى. وهكذا يكون مُصرِّف RPython شبكة متشابكة من الاعتماديات المتبادلة. والمُصرِّف بحاجة إلى تنظيف في عدة مواضع، غير أن ذلك ليس سهلًا ولا ممتعًا.
19.7. ملاحظة على منهجية العمل
إلى حدّ ما، من أجل مواجهة تعقيده هو (راجع القسم 19.6)، تبنّى PyPy عدة منهجيات تطويرٍ ما تُسمّى «رشيقة» (agile). وأهمّ هذه المنهجيات على الإطلاق هو التطوير المُوجَّه بالاختبارات (test-driven development). ويُشترط لكل ميزة جديدة وكل إصلاح خلل أن تتوفّر له اختبارات تتحقّق من صحّته. ويُشغَّل مُفسِّر بايثون في PyPy أيضًا مقابل مجموعة اختبارات الانحدار (regression test suite) الخاصة بـ CPython. وقد انفصل مشغّل اختبارات PyPy، وهو py.test، ليُستخدم اليوم في كثير من المشاريع الأخرى. كما يملك PyPy نظام تكامل مستمر (continuous integration) يشغّل مجموعة الاختبارات ويترجم المُفسِّر على منصّات متنوّعة. ويُنتَج ملف تنفيذي لكل المنصّات يوميًا، كما تُشغَّل مجموعة اختبارات الأداء. وتضمن كل هذه الاختبارات سلوك المكوّنات المختلفة مهما كان التغيير الذي أُدخل في البنية المعقّدة.
تتميّز مشاريع PyPy ثقافةً قويّة من التجريب. ويُشجَّع المطورون على إنشاء فروع (branches) في مستودع Mercurial. وهناك يمكن صقل الأفكار قيد التطوير من دون زعزعة الفرع الرئيسي. وليست الفروع ناجحة دائمًا، وبعضها يُهجر. لكن مطوّري PyPy، إن صفة واحدة اجتمعت فيهم، فإنهم مثابرون. وأشهر مثال على ذلك أن مُصرِّف PyPy الفوري الحالي هو المحاولة الخامسة لإضافة مُصرِّف فوري إلى PyPy!
كما يفتخر مشروع PyPy بأدوات التمثيل المرئي. ومخطّطات الرسوم البيانية للتدفّق في القسم 19.4 مثال على ذلك. كما يملك PyPy أدوات لعرض استدعاءات جامع القمامة عبر الزمن، ولعرض أشجار تحليل التعبيرات النمطية. ومن الأدوات ذات الاهتمام الخاص jitviewer، وهو برنامج يتيح لك كشط طبقات الدالة المصروفة فوريًا بصريًا، من شيفرة بايت بايثون إلى IR الخاص بـ JIT وصولًا إلى شيفرة التجميع. (ويُعرض jitviewer في الشكل 19.4). وتساعد أدوات التمثيل المرئي المطورين على فهم كيف تتفاعل طبقات PyPy العديدة فيما بينها.
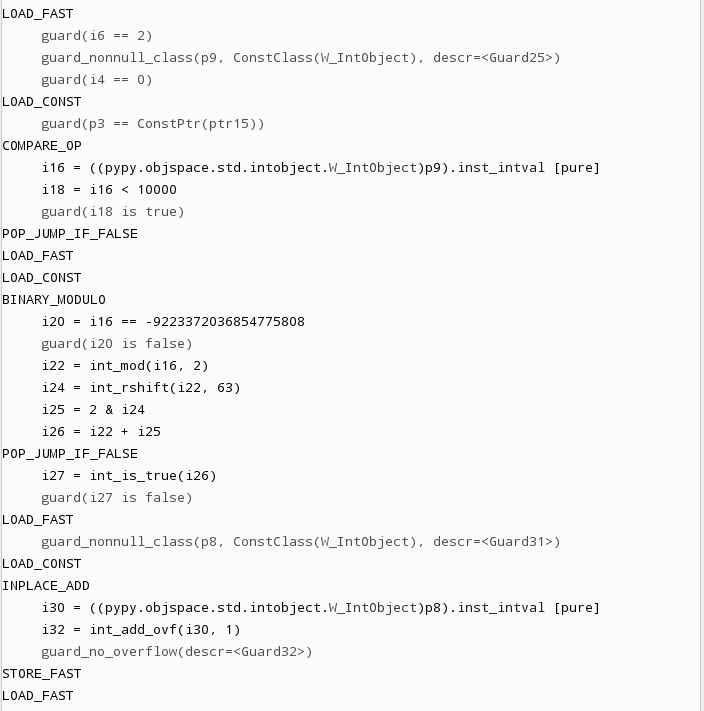 الشكل 19.4: jitviewer يعرض شيفرة بايت بايثون وعمليات IR الخاصة بـ JIT المرتبطة بها
19.8. الخلاصة
يتعامل مُفسِّر بايثون مع كائنات بايثون بوصفها صناديق سوداء ويترك كل السلوك ليُعرَّف بواسطة مساحة الكائنات. ويمكن لمساحات الكائنات الفردية أن توفّر سلوكًا خاصًا موسَّعًا لكائنات بايثون. كما يتيح نهج مساحة الكائنات استعمال تقنية التفسير المجرّد المستخدَمة في الترجمة.
يسمح مُصرِّف RPython بتجريد تفاصيل مثل جمع القمامة ومعالجة الاستثناءات عن مُفسِّر اللغة. كما يفتح إمكانية تشغيل PyPy على منصّات وقت التشغيل (runtime platforms) العديدة باستخدام واجهات خلفية مختلفة.
ومن أهمّ استعمالات بنية الترجمة مولِّد الـ JIT. فالعمومية التي يتميّز بها مولِّد الـ JIT تتيح إضافة مُصرِّفات فورية للغات جديدة ولغات فرعية مثل التعبيرات النمطية. وPyPy هو أسرع تنفيذات بايثون اليوم بفضل مولِّد الـ JIT.
ولرغم أن معظم جهد التطوير في PyPy قد ذهب إلى مُفسِّر بايثون، فإن PyPy يمكن استعماله لتنفيذ أي لغة ديناميكية. وعلى مرّ السنين، كُتبت باستخدام PyPy مُفسّرات جزئية لـ JavaScript وProlog وScheme وIO.
19.9. الدروس المستفادة
أخيرًا، هذه بعض الدروس التي يمكن استخلاصها من مشروع PyPy:
إن إعادة الهيكلة المتكرّرة (refactoring) عملية ضرورية في كثير من الأحيان. فمثلًا، كان التصوّر الأصلي أن تتمكّن الواجهة الخلفية C للمُصرِّف من العمل مباشرةً على الرسوم البيانية عالية المستوى للتدفّق! واستغرق ظهور عملية الترجمة متعددة المراحل الحالية عدّة دورات تكرار.
أهمّ درس تعلّمه PyPy هو قوة التجريد. ففي PyPy تفصل التجريداتُ مختلفَ الاعتبارات الخاصة بالتنفيذ. فمثلًا، يتيح جمع القمامة الآلي في RPython للمطوّر الذي يعمل على المُفسِّر ألّا يقلق بشأن إدارة الذاكرة. وفي الوقت نفسه، للتجريد كلفة ذهنية. فالعمل على سلسلة الترجمة ينطوي على موازنة مختلف مراحل الترجمة في الوقت نفسه داخل الذهن. كما قد تحجب التجريداتُ الطبقةَ التي يسكن فيها الخلل؛ وتسريب التجريد (abstraction leakage)، حيث يؤدي استبدال مكوّنات أدنى المستوى المفترض أنها قابلة للتبادل إلى إتلاف شيفرة أعلى مستوى، مشكلة متكرّرة. ومن المهم استخدام الاختبارات للتحقّق من عمل جميع أجزاء النظام، بحيث لا يؤدّي تغيير في نظام واحد إلى إتلاف نظام آخر. وبعبارة أكثر ملموسة، يمكن للتجريدات أن تُبطئ البرنامج بنشأة قدر مفرط من التسيير (indirection).
إن مرونة (R)Python كلغة تنفيذ تجعل التجريب في مزايا بايثون الجديدة (أو حتى في لغات جديدة) أمرًا سهلًا. وبفضل بنيته الفريدة، سينال PyPy نصيبًا وافرًا في مستقبل بايثون وفي تنفيذ اللغات الديناميكية.