Puppet
بنية تطبيقات المصادر المفتوحة (المجلد 2)Puppet
بنية تطبيقات المصادر المفتوحة (المجلد 2) Puppet
Luke Kanies
إن استمتعت بهذه الكتب، فربما يعجبك أيضًا التصميم البرمجي بالأمثلة في Python والتصميم البرمجي بالأمثلة في JavaScript.
18.1. مقدمة
Puppet أداة مفتوحة المصدر لإدارة تقنية المعلومات، مكتوبة بلغة Ruby، تُستخدم لأتمتة مراكز البيانات وإدارة الخوادم في Google وTwitter وبورصة نيويورك وغيرها كثير. ويتولى صيانتها في الأساس Puppet Labs، وهي أيضًا من أسّس المشروع. ويستطيع Puppet إدارة جهازين فقط بقدر ما يستطيع إدارة خمسين ألف جهاز، في فرق يكون فيها مدير النظام واحدًا أو مئات المديرين.
Puppet أداة لإعداد حواسيبك وصيانتها؛ وفي لغته البسيطة للإعداد تشرح له كيف تريد أن تكون إعدادات أجهزتك، فيغيّرها عند الحاجة لتطابق مواصفاتك. ومع تغيّر تلك المواصفات بمرور الوقت—مثلًا عند تحديث الحزم، أو إضافة مستخدمين جدد، أو إجراء تحديثات على الإعدادات—يُحدّث Puppet أجهزتك تلقائيًا لتطابقها. أمّا إذا كانت مُعدّة بالفعل كما تريد، فلا يفعل Puppet شيئًا.
بشكل عام، يسعى Puppet إلى توظيف ميزات النظام الموجودة كلّما أمكنه ذلك لإنجاز عمله؛ فعلى Red Hat مثلًا يستخدم yum للحزم وinit.d للخدمات، وعلى OS X يستخدم dmg للحزم وlaunchd للخدمات. ومن الأهداف التوجيهية في Puppet أن يكون ما ينفّذه ذا معنى سواء كنت تقرأ شيفرة Puppet أو النظام نفسه، لذا فإن الالتزام بمعايير النظام أمر حاسم.
ينحدر Puppet من تقاليد متعددة لأدوات أخرى. في عالم المصادر المفتوحة أكثر ما أثّر فيه CFEngine، وهو أول أداة إعدادات عامة مفتوحة المصدر، وISconf، الذي استُلهِم منه استخدام make في كل الأعمال فأسّس التركيز على التبعيات الصريحة في النظام كله. أما في عالم المنتجات التجارية، فإن Puppet استجابة لـ BladeLogic وOpsware (وقد استحوذت عليهما شركات أكبر منذ ذلك الحين)، وكلاهما كان ناجحًا في السوق حين بدأ Puppet، لكنهما كانا مركزَين على بيع المنتج لكبار التنفيذيين في الشركات الكبرى بدلًا من بناء أدوات عظيمة مباشرةً لمديري الأنظمة. ويهدف Puppet إلى حل مشكلات مشابهة لتلك الأدوات، لكنه موجَّه إلى مستخدم مختلف تمامًا.
ولنأخذ مثالًا بسيطًا على كيفية استخدام Puppet، فإليك مقطعًا من الشيفرة يضمن تثبيت خدمة الصدفة الآمنة (secure shell) وضبطها على نحو صحيح:
class ssh {
    package { ssh: ensure => installed }
    file { "/etc/ssh/sshd_config":
        source => 'puppet:///modules/ssh/sshd_config',
        ensure => present,
        require => Package[ssh]
    }
    service { sshd:
        ensure => running,
        require => [File["/etc/ssh/sshd_config"], Package[ssh]]
    }
}
وهذا يضمن أن الحزمة مثبَّتة، وأن الملف في موضعه، وأن الخدمة قيد التشغيل. ولاحظ أننا حدَّدنا تبعيات بين الموارد، بحيث يُنفَّذ أي عمل دائمًا بالترتيب الصحيح. ومن ثمّ يمكن ربط هذا الصنف بأي مضيف لتطبيق هذا الإعداد عليه. ولاحظ أيضًا أن لبنات بناء إعداد Puppet هي كائنات مُهيكَلة، وهي في هذه الحالة package وfile وservice. ونسمّي هذه الكائنات الموارد في Puppet، وكل ما في إعداد Puppet ينحصر في هذه الموارد والتبعيات بينها.
سيكون في موقع Puppet المعتاد عشرات أو حتى مئات من مقاطع الشيفرة هذه، التي نسمّيها الأصناف؛ ونخزّن هذه الأصناف على القرص في ملفات تسمّى manifests، ونجمعها في مجموعات ذات صلة تسمّى الوحدات. فعلى سبيل المثال، قد تكون لديك وحدة ssh تحوي الصنف ssh هذا إضافة إلى أي أصناف أخرى ذات صلة، إلى جانب وحدات لـ mysql وapache وsudo.
معظم التفاعلات مع Puppet تمرّ عبر سطر الأوامر أو عبر خدمات HTTP طويلة التشغيل، لكن توجد واجهات رسومية لبعض الأمور مثل معالجة التقارير. كما تُنتج Puppet Labs منتجات تجارية مرتبطة بـ Puppet، وهي تميل بقدر أكبر نحو واجهات ويب رسومية.
كُتبت النسخة الأولية (prototype) من Puppet في صيف عام 2004، وتحوّلت إلى عمل بدوام كامل في فبراير عام 2005. صُمِّم وكُتب في البداية من Luke Kanies، وهو مدير أنظمة كانت خبرته الكبيرة في كتابة أدوات صغيرة، وخاليًا تمامًا من كتابة أدوات تتجاوز 10,000 سطر برمجي. وبعبارة أخرى، تعلّم Luke أن يكون مبرمجًا أثناء كتابة Puppet، وهذا يظهر في معماريته بصورة إيجابية وسلبية على حدٍّ سواء.
بُني Puppet أولًا وقبل كل شيء ليكون أداةً لمديري الأنظمة، تتيح لهم تسهيل حياتهم والعمل بسرعة وكفاءة أكبر وبأخطاء أقل. وأولى الابتكارات الرئيسية الموضوعة لتحقيق ذلك هي الموارد المذكورة آنفًا، وهي لبنات Puppet الأولية؛ إذ كانت ستتمتع بقابلية النقل عبر معظم أنظمة التشغيل، وكانت ستُخفي أيضًا تفاصيل التنفيذ، مما يسمح للمستخدم بالتركيز على النتائج بدلًا من كيفية بلوغها. وقد نُفِّذت هذه المجموعة من اللبِّنات في طبقة تجريد الموارد (Resource Abstraction Layer) في Puppet.
يجب أن تكون موارد Puppet فريدة على مضيف بعينه. لا يمكنك أن تملك أكثر من حزمة واحدة اسمها "ssh"، ولا أكثر من خدمة واحدة اسمها "sshd"، ولا أكثر من ملف واحد اسمه "/etc/ssh/sshd_config". وهذا يمنع أجزاءً مختلفة من إعداداتك من التعارض فيما بينها، ويكشف لك عن هذه التعارضات مبكرًا جدًا في عملية الإعداد. ونشير إلى هذه الموارد بنوعها وعنوانها؛ مثل Package[ssh] وService[sshd]. ويمكن أن تكون لديك حزمة وخدمة بالاسم نفسه لأنهما من نوعين مختلفين، لكن ليس لديك حزمتان أو خدمتان بالاسم نفسه.
أمّا الابتكار الرئيسي الثاني في Puppet فيوفّر القدرة على تحديد التبعيات بين الموارد مباشرةً. فقد تركّزت الأدوات السابقة على العمل الفردي المطلوب إنجازه، لا على كيفية ارتباط أجزاء العمل ببعضها؛ وكان Puppet أول أداة تنصّ صراحةً على أن التبعيات جزء أساسي من إعداداتك ويجب أن يُنمذَج على هذا النحو. وهو يبني رسمًا بيانيًا للموارد وتبعياتها بوصفه أحد أنواع البيانات الأساسية، وبالأساس كل شيء في Puppet يتدلّى من هذا الرسم البياني (المسمّى Catalog) ورؤوسه وحوافه.
آخر مكوّن رئيسي في Puppet هو لغته للإعداد. وهذه اللغة تصريحية (declarative)، والمقصود بها أن تكون بيانات إعداد أكثر منها برمجة بالمعنى الكامل—فهي تشبه إلى حدٍّ كبير تنسيق إعدادات Nagios، لكنها تأثّرت أيضًا تأثيرًا كبيرًا بـ CFEngine وبـ Ruby.
إلى جانب المكوّنات الوظيفية، اتّبع Puppet مبدأين توجيهيين طوال تطوّره: أن يكون أبسط ما يمكن، مع تفضيل سهولة الاستخدام دائمًا حتى على حساب الإمكانات؛ وأن يُبنى إطارًا أولًا وتطبيقًا ثانيًا، كي يتمكّن الآخرون من بناء تطبيقاتهم الخاصة على داخل Puppet كما يشاؤون. وقد أُدرك أن إطار Puppet يحتاج إلى تطبيق قاتل (killer application) كي يُعتمد على نطاق واسع، لكن الإطار ظل دائمًا هو محور التركيز لا التطبيق. ويعتقد معظم الناس أن Puppet هو ذلك التطبيق، لا الإطار الذي يقف خلفه.
حين بُنيت النسخة الأولية من Puppet، كان Luke في جوهره مبرمجًا متمكنًا في Perl ذا خبرة واسعة في الـ shell وبعض الخبرة في C، وكان يعمل أساسًا في CFEngine. والأمر الطريف أنه كان ذا خبرة في بناء محلّلات للغات بسيطة، إذ بنى اثنين منها كجزء من أدوات أصغر، كما أعاد كتابة محلّل CFEngine من الصفر سعيًا إلى جعله أكثر قابلية للصيانة (لم تُقدَّم هذه الشيفرة قط إلى المشروع بسبب بعض حالات عدم التوافق الصغيرة).
استقرّ الأمر بسهولة على اختيار لغة ديناميكية لتنفيذ Puppet، استنادًا إلى إنتاجية المطوّر الأعلى بكثير وسرعة الوصول إلى السوق، لكن اختيار اللغة نفسها أثبت أنه صعب. فالنسخ الأولية المكتوبة بـ Perl لم تسلك أي طريق، فسُعِي إلى تجريب لغات أخرى. وجُرِّبت Python، لكن وجد Luke أن اللغة بعيدة كل البعد عن الطريقة التي يفكّر بها. واستنادًا إلى ما سمعه من صديق على أنها شائعة عن فائدتها، جرّب Luke لغة Ruby، فأنجز خلال أربع ساعات نسخة أولية قابلة للاستخدام. وحين أصبح Puppet عملًا بدوام كامل في عام 2005 كانت Ruby مجهولة تمامًا، لذا كان قرار التمسك بها مخاطرة كبيرة، لكن رُئي مجددًا أن إنتاجية المبرمج هي العامل الحاكم في اختيار اللغة. والميزة الرئيسية الفارقة في Ruby، على الأقل في مقابل Perl، كانت سهولة بناء علاقات أصناف غير هرمية، لكنها أيضًا كانت تنطبق على ذهن Luke بدرجة ممتازة، وهو ما ثبت أنه أمر حاسم.
18.2. نظرة عامة على المعمارية
هذا الفصل يتناول في المقام الأول معمارية تنفيذ Puppet (أي الشيفرة التي استخدمناها لجعل Puppet يفعل ما هو مفترض أن يفعله)، لكنه يستحق أن نتحدث بإيجاز عن معمارية تطبيقه (أي كيفية تواصل أجزاءه)، حتى تصبح زوايا التنفيذ مفهومة بعض الشيء.
بُني Puppet في ضوء وضعين: وضع عميل/خادم بخادم مركزي ووكلاء يعملون على مضيفات منفصلة، أو وضع «بلا خادم» تتولى فيه عملية واحدة كل العمل. ولضمان الاتساق بين هذين الوضعين، حافظ Puppet دائمًا على شفافية الشبكة (network transparency) داخليًا، بحيث يستخدم الوضعان مسارات الشيفرة نفسها سواء مرّا عبر الشبكة أم لم يمرّا. ويمكن لكل ملف تنفيذي إعداد الوصول إلى الخدمات محليًا أو عن بُعد حسب الحاجة، لكن سلوكهما يتطابق فيما عدا ذلك. ولاحظ أيضًا أنه يجوز لك استخدام الوضع «بلا خادم» فيما يمكن اعتباره إعداد عميل/خادم، بأن تسحب جميع ملفات الإعداد إلى كل عميل فيحلّلها مباشرة. وسيركّز هذا القسم على وضع العميل/الخادم، لأنه أسهل في الفهم بوصفه مكوّنات منفصلة، لكن تذكّر أن كل ما سبق ينطبق على الوضع «بلا خادم» أيضًا.
من أبرز الخيارات المحدِّدة في معمارية تطبيق Puppet أن لا يحصل العملاء على وصول مباشر إلى وحدات Puppet الخام؛ بل يتلقّون إعدادًا مُصرَّفًا خصيصًا لهم. ويحقّق هذا فوائد متعددة: أولًا، يلتزم بمبدأ الحد الأدنى من الصلاحيات (principle of least privilege)، إذ يعرف كل مضيف بدقة ما يحتاج إلى معرفته فحسب (كيف ينبغي أن يُعدّ)، ولا يعرف كيف تُعدّ أي خوادم أخرى. ثانيًا، يمكنك فصل الصلاحيات اللازمة لتجميع إعداد (والتي قد تتضمن الوصول إلى مخازن بيانات مركزية) عن الحاجة إلى تطبيق ذلك الإعداد. ثالثًا، يمكنك تشغيل المضيفات في وضع مفصول، تطبّق فيه إعدادًا بصورة متكررة دون أي اتصال بخادم مركزي، ما يعني أنك تبقى ملتزمًا للمتطلبات حتى لو كان الخادم متوقفًا أو كان العميل مفصولًا عن الشبكة (كما هو الحال في التثبيت المتنقّل، أو حين تقع العملاء في منطقة منزوعة السلاح (DMZ)).
ومعه هذا الاختيار، يصبح مسار العمل (workflow) نسبيًا مباشرًا:
- تجمع عملية وكيل Puppet معلومات عن المضيف الذي تعمل عليه، ثم تمرّرها إلى الخادم.
- يستخدم المحلّل (parser) معلومات النظام تلك ووحدات Puppet الموجودة على القرص المحلي لتجميع إعداد لهذا المضيف بعينه، ثم يعيده إلى الوكيل.
- يطبّق الوكيل ذلك الإعداد محليًا، مما يؤثّر في الحالة المحلية للمضيف، ثم يودع التقرير الناتج لدى الخادم.
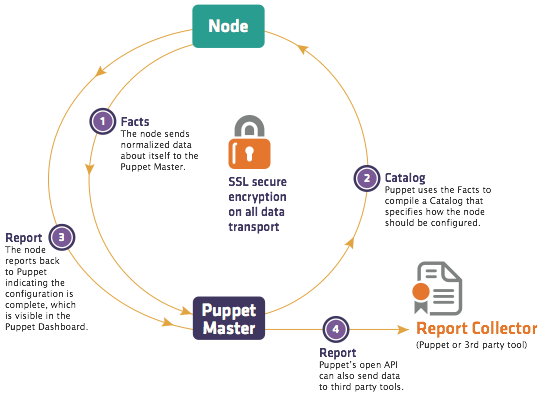 الشكل 18.1: تدفّق بيانات Puppet
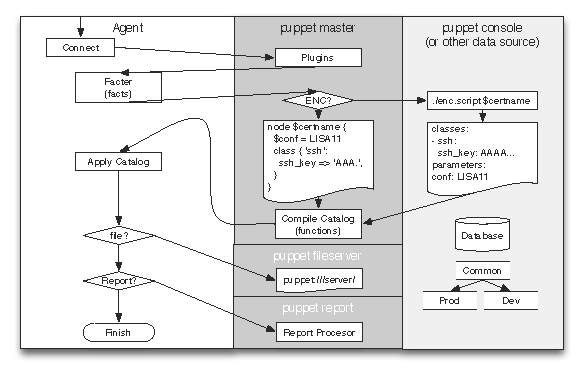 الشكل 18.2: تنسيق تدفّق البيانات بين عمليات Puppet ومكوّناته
وهكذا يملك الوكيل وصولًا إلى معلومات نظامه، وإعداده، وكل تقرير ينتجه. أمّا الخادم فيملك نسخًا من كل هذه البيانات، إضافةً إلى الوصول إلى جميع وحدات Puppet، وإلى أي قواعد بيانات وخدمات خلفية قد تلزم لتجميع الإعداد.
إلى جانب المكوّنات التي تدخل في مسار العمل هذا، والتي سنتناولها تاليًا، هناك كثير من أنواع البيانات التي يستخدمها Puppet في التواصل الداخلي. وهذه الأنواع حاسمة، لأنها الوسيلة التي يتم بها كل التواصل، وهي أنواع عامة يمكن لأي أدوات أخرى أن تنتجها أو تستهلكها.
أهم أنواع البيانات هي:
- الحقائق (Facts): بيانات النظام التي تُجمع على كل جهاز وتُستخدم لتجميع الإعدادات.
- الملفات التعريفية (Manifest): ملفات تحوي شيفرة Puppet، منظَّمةً عادةً في مجموعات تسمّى «الوحدات».
- الكتالوج (Catalog): رسم بياني لموارد مضيف بعينه المُزمع إدارتها والتبعيات بينها.
- التقرير (Report): مجموعة كل الأحداث التي أُنشئت أثناء تطبيق كتالوج بعينه.
إلى جانب الحقائق (Facts) والملفات التعريفية (Manifests) والكتالوجات (Catalogs) والتقارير (Reports)، يدعم Puppet أنواع بيانات للملفات والشهادات (ويستخدمها في المصادقة)، وغيرها.
18.3. تحليل المكوّنات
الوكيل (Agent)
أوّل مكوّن نلتقي به في تشغيل Puppet هو عملية agent. وقد كان هذا في الأصل ملفًا تنفيذيًا منفصلًا اسمه puppetd، لكن في الإصدار 2.6 اختزّلناه إلى ملف تنفيذي واحد، لذا يُستدعى الآن بالأمر puppet agent، على نحو يشبه طريقة عمل Git. والوكيل نفسه ذو وظائف خاصة قليلة جدًا؛ فهو في المقام الأول إعداد وشيفرة ينفّذان جانب العميل من مسار العمل الموصوف أعلاه.
Facter
المكوّن التالي بعد الوكيل هو أداة خارجية اسمها Facter، وهي أداة بالغة البساطة تُستخدم لاكتشاف معلومات عن المضيف الذي تعمل عليه. وهذه معلومات مثل نظام التشغيل وعنوان IP واسم المضيف، لكن Facter قابلة للتوسعة بسهولة، لذا تضيف كثير من المؤسسات إضافاتها الخاصة لاكتشاف بيانات مخصّصة. ويرسل الوكيل البيانات التي يكتشفها Facter إلى الخادم، وعند تلك النقطة يتولّى الخادم استئناف مسار العمل.
مصنِّف العُقد الخارجية (External Node Classifier)
على الخادم، أوّل مكوّن نلتقي به هو ما نسمّيه مصنِّف العُقد الخارجية (External Node Classifier) أو باختصار ENC. ويقبل ENC اسم المضيف ويعيد بنية بيانات بسيطة تحوي الإعداد عالي المستوى لذلك المضيف. وENC هو عمومًا خدمة أو تطبيق منفصل: إمّا مشروع مفتوح المصدر آخر مثل Puppet Dashboard أو Foreman، أو تكامل مع مخازن بيانات موجودة مثل LDAP. والغرض من ENC هو تحديد الأصناف الوظيفية التي ينتمي إليها مضيف بعينه، وما الوسيطات التي ينبغي استخدامها لإعداد تلك الأصناف. فعلى سبيل المثال، قد يكون مضيف ما في الصنفين debian وwebserver، وتكون الوسيطة datacenter مضبوطة على atlanta.
لاحظ أن اعتبارًا من إصدار Puppet 2.7 لم يعد ENC مكوّنًا إلزاميًا؛ فبإمكان المستخدمين تحديد إعدادات العُقد مباشرةً في شيفرة Puppet. أُضيف دعم ENC قبل نحو عامين من إطلاق Puppet لأننا أدركنا أن تصنيف المضيفات يختلف جوهريًا عن إعدادها، وأن فصل المشكلتين إلى أدوات منفصلة كان أكثر منطقية من توسيع اللغة لدعم الخاصيتين معًا. ويُوصى دائمًا باستخدام ENC، وسيصبح في وقت قريب مكوّنًا إلزاميًا (وعندها سيأتي Puppet مع واحد مفيد بما يكفي بحيث لا يكون هذا الشرط عبئًا).
بمجرد أن يستلم الخادم معلومات التصنيف من ENC ومعلومات النظام من Facter (عبر الوكيل)، يجمع كل تلك المعلومات في كائن عقدة (Node) ويمرّرها إلى المُصرِّف.
المُصرِّف (Compiler)
كما ذُكر أعلاه، لدى Puppet لغة خاصة مبنية لتحديد إعدادات الأنظمة. ومُصرِّفها في الواقع ثلاث قطع: مولِّد محلّلات بأسلوب Yacc ومحلّل لِمَعاد مخصّص؛ ومجموعة أصناف تُستخدم لبناء شجرة الصياغة المجرّدة (AST) لدينا؛ وصنف Compiler الذي يدير تفاعلات كل هذه الأصناف ويؤدي أيضًا وظيفة واجهة البرمجة (API) لهذا الجزء من النظام.
أكثر ما يسبّب تعقيدًا في المُصرِّف هو أن معظم شيفرة إعدادات Puppet تُحمَّل بشكل كسول عند أول إشارة إليها (وذلك لتقليل زمن التحميل وتقليل السجلات غير المهمة عن اعتماديات مفقودة غير محتاج إليها)، ما يعني عمليًا أنه لا توجد استدعاءات صريحة لتحميل الشيفرة وتحليلها.
يستخدم محلّل Puppet مولِّد محلّلات عاديًا بأسلوب Yacc مبنيًا باستخدام أداة Racc مفتوحة المصدر. لكن للأسف لم تكن هناك أي مولِّدات لِمَعاد مفتوحة المصدر حين بدأ Puppet، لذا فهو يستخدم محلّلًا لِمَعاد مخصّصًا.
ولأننا نستخدم شجرة صياغة مجرّدة (AST) في Puppet، فإن كل عبارة في قواعد لغة Puppet تُقيَّم إلى نسخة من صنف من أصناف AST في Puppet (مثل Puppet::Parser::AST::Statement)، بدلًا من أن تتصرّف مباشرة، وتُجمَع نسخ AST هذه في شجرة مع تصغير شجرة القواعد. وتوفّر شجرة الصياغة المجرّدة هذه فائدة في الأداء عندما يكون خادم واحد يجمّع الإعدادات لعُقد كثيرة مختلفة، لأننا نستطيع أن نحلّل مرة واحدة ونجمّع مرات عديدة. كما تتيح لنا أيضًا إجراء بعض الفحص الداخلي لشجرة الصياغة، مما يوفّر لنا معلومات وقدرات ما كان لنا أن نحصل عليها لو كان التحليل يعمل مباشرةً.
لم تكن ثمّة أمثلة ميسّرة تقريبًا على أشجار الصياغة المجرّدة عند بدء Puppet، لذا مرّ هذا الجانب بتطور كبير، ووصلنا إلى صياغة تبدو فريدة نسبيًا. وبدلًا من إنشاء شجرة صياغة مجرّدة واحدة للإعداد بأكمله، ننشئ أشجارًا صغيرة كثيرة، مفهرسةً بأسمائها. فعلى سبيل المثال، تنشئ هذه الشيفرة:
class ssh {
    package { ssh: ensure => present }
}
شجرة صياغة مجرّدة جديدة تحوي نسخة واحدة من Puppet::Parser::AST::Resource، ويخزّن تلك الشجرة باسم "ssh" في جدول تجزئة جميع أصناف هذه البيئة بعينها. (وقد أسقطتُ تفاصيل البنى الأخرى المشابهة للأصناف، لأنها غير ضرورية لهذا النقاش.)
ومعطى شجرة الصياغة المجرّدة وكائن عقدة (من ENC)، يأخذ المُصرِّف الأصناف المحدّدة في كائن العقدة (إن وُجدت)، ويبحث عنها ويقيّمها. وخلال هذه العملية يبني المُصرِّف شجرة من نطاقات المتغيّرات؛ ويحصل كل صنف على نطاقه الخاص الذي يُربط بالنطاق الذي أنشأه. ويترتّب على ذلك نطاق ديناميكي (dynamic scoping) في Puppet: إذا ضمّ صنفٌ صنفًا آخر، فيمكن للصنف المُضمَّن أن يبحث عن المتغيّرات مباشرةً في الصنف المُضمِّن. وقد كان هذا دائمًا كابوسًا، وقد كنتّا في طريقنا للتخلّص من هذه القدرة.
شجرة النطاقات (Scope) مؤقتة وتُهمَل بمجرد انتهاء التجميع، لكن ناتج التجميع يُبنى كذلك تدريجيًا طوال فترة التجميع. ونسمّي هذا الناتج كتالوجًا (Catalog)، لكنه في الحقيقة مجرد رسم بياني للموارد وعلاقاتها. ولا شيء من المتغيّرات أو بنى التحكم أو استدعاءات الدوال ينتقل إلى الكتالوج؛ فهو بيانات خالصة، ويمكن تحويله بسهولة تامة إلى JSON أو YAML أو أي شيء آخر تقريبًا.
أثناء التجميع، ننشئ علاقات احتواء؛ فكل صنف «يحتوي» كل الموارد التي تأتي معه (فحزمة ssh أعلاه مثلًا محتواة في الصنف ssh). وقد يحتوي الصنف على تعريف (definition)، وبدوره يحتوي هذا التعريف إما على مزيد من التعريفات أو على موارد فردية. ويميل الكتالوج إلى أن يكون رسمًا بيانيًا أفقيًا جدًا ومنقطعًا: أصناف كثيرة، كل منها لا يتجاوز عمقه مستويين.
ومن الجوانب المحرجة في هذا الرسم البياني أنه يحتوي أيضًا على علاقات «اعتماد»، مثل خدمة تتطلب حزمة (ربما لأن تثبيت الحزمة هو ما ينشئ الخدمة فعلًا)، لكن علاقات الاعتماد هذه تُحدَّد في الحقيقة كقيم وسيطات على الموارد، لا كحواف في بنية الرسم البياني. ولا يدعم صنف الرسم البياني لدينا (واسمه SimpleGraph لأسباب تاريخية) وجود حواف الاحتواء وحواف الاعتماد في الرسم البياني نفسه، لذا علينا التحويل بينهما لأغراض مختلفة.
المعاملة (Transaction)
بمجرد اكتمال بناء الكتالوج بالكامل (بافتراض عدم حدوث أي فشل)، يُمرَّر إلى المعاملة. وفي نظام يفصل بين العميل والخادم، تعمل المعاملة على العميل، الذي يسحب الكتالوج عبر HTTP كما في الشكل 18.2.
يوفّر صنف معاملة Puppet الإطار الذي يتمّ من خلاله العمل على النظام فعليًا، بينما كل ما ناقشناه سابقًا لا يقوم سوى ببناء الكائنات وتمريرها فيما بين. وبخلاف المعاملات في الأنظمة الأشيع مثل قواعد البيانات، لا تتّسم معاملات Puppet بخصائص مثل الذرّية (atomicity).
تؤدي المعاملة مهمةً نسبيًا مباشرة: تسير في الرسم البياني بالترتيب الذي تحدّده العلاقات المختلفة، وتتأكد من أن كل مورد متزامن مع الحالة المطلوبة له. وكما ذُكر أعلاه، عليها أن تحوّل الرسم البياني من حواف الاحتواء (مثل: الصنف Class[ssh] يحتوي Package[ssh] وService[sshd]) إلى حواف اعتماد (مثل: Service[sshd] يعتمد على Package[ssh])، ثم تجري فرزًا طوبولوجيًا معياريًا للرسم البياني، تختار فيه كل مورد على حدة.
بالنسبة إلى مورد بعينه، ننفّذ عملية من ثلاث خطوات: نسترجع الحالة الحالية لذلك المورد، ونقارنها بالحالة المرغوبة، ونجري أي تغييرات لازمة لتصحيح أي اختلاف. فعلى سبيل المثال، بالنظر إلى هذه الشيفرة:
file { "/etc/motd":
    ensure => file,
    content => "Welcome to the machine",
    mode => 644
}
تتحقق المعاملة من محتوى /etc/motd ومن أذونياته، وإذا لم يُطابقَا الحالة المحدّدة، فستصحّح أحدهما أو كليهما. وإذا كان /etc/motd في أي من الأحوال مجلدًا، فإنها ستحفظ نسخة احتياطية من كل الملفات الموجودة في ذلك المجلد، وتحذفه، ثم تستبدله بملف له المحتوى والأذونية المناسبان.
تتكفّل بهذه العملية صنف ResourceHarness بسيط يعرّف الواجهة الكاملة بين Transaction وResource. وهذا يقلّل عدد الروابط بين الأصناف، ويجعل تعديل أيٍّ منهما على حدة أسهل.
طبقة تجريد الموارد (Resource Abstraction Layer)
صنف Transaction هو قلب إنجاز العمل بـ Puppet، لكن العمل كله ينفَّذ فعليًا بواسطة طبقة تجريد الموارد (Resource Abstraction Layer) أو RAL، وهي أيضًا المكوّن الأكثر إثارة للاهتمام في Puppet من الناحية المعمارية.
كانت RAL أوّل مكوّن أُنشئ في Puppet، وهي، بخلاف اللغة، تحدّد بوضوح تام ما يستطيع المستخدم فعله. ومهمّة RAL هي تعريف معنى أن تكون موردًا، وكيف يمكن للموارد إنجاز عملها على النظام، ولغة Puppet مبنية تحديدًا لتحديد الموارد وفق ما تصوره RAL. ولهذا السبب فإنها أيضًا أهم مكوّن في النظام، وأصعبها تغييرًا. وهناك أشياء كثيرة نودّ إصلاحها في RAL، وقد أجرينا عليها تحسينات جوهرية كثيرة على مر السنين (أهمها إضافة المزوّدات (Providers))، ومع ذلك ما زال هناك الكثير من العمل الواجب على RAL في الأجل الطويل.
في نظام المُصرِّف، نمثّل الموارد وأنواع الموارد بأصناف منفصلة (تُسمّى، بشكل مريح، Puppet::Resource وPuppet::Resource::Type). وهدفنا أن تشكل هذه الأصناف أيضًا قلب RAL، لكن هذين السلوكين (المورد والنوع) ما زالا يُنمذجان داخل صنف واحد، وهو Puppet::Type. (واسم الصنف سيئ لأنه يسبق إلى حدٍّ بعيد استخدامنا لمصطلح Resource، وقد كنا في ذلك الوقت نُسلسِل بنى الذاكرة مباشرةً عند التواصل بين المضيفات، لذا كان تغيير أسماء الأصناف معقدًا للغاية في الواقع.)
حين أُنشئ Puppet::Type لأول مرة، بدا منطقيًا وضع سلوك المورد وسلوك نوع المورد في الصنف نفسه؛ فبعد كل شيء، الموارد ليست سوى نسخ من أنواع الموارد. لكن مع مرور الوقت تبيّن أن العلاقة بين المورد ونوعه لا تُنمذَج جيدًا في بنية وراثة تقليدية. فأنواع الموارد تحدّد ما الوسيطات التي يمكن أن يملكها المورد، لكنها لا تحدّد ما إذا كان يقبل وسيطات (فهي كلها تقبلها) مثلًا. لذلك، يملك صنفنا الأساسي Puppet::Type سلوكيات على مستوى الصنف تحدّد كيف تتصرّف أنواع الموارد، وسلوكيات على مستوى النسخة تحدّد كيف تتصرّف نسخ الموارد. كما يتحمّل على نحو إضافي مسؤولية إدارة تسجيل أنواع الموارد واسترجاعها؛ فإذا أردت نوع "user"، فإنك تستدعي Puppet::Type.type(:user).
هذا الخلط من السلوكيات يجعل Puppet::Type صعب الصيانة إلى حدٍّ كبير. فالصنف كله أقل من 2000 سطر برمجي، لكن العمل على ثلاثة مستويات—المورد، ونوع المورد، ومدير أنواع الموارد—يجعله معقّدًا. ومن ثمّ واضح أنه هدف رئيسي لإعادة الهيكلة، لكنه أقرب إلى التوصيلات الداخلية منه إلى واجهة المستخدم، لذا كان التبرير للجهد المبذول هنا دائمًا أصعب من تبريره مباشرةً في المزايا.
إلى جانب Puppet::Type، هناك نوعان رئيسيان من الأصناف في RAL، أكثرهما إثارةً للاهتمام هو ما نسمّيه المزوّدات (Providers). حين طُوِّر RAL لأول مرة، كان كل نوع مورد يمزج تعريف الوسيطة بشيفرة تعرف كيف تديرها. فعلى سبيل المثال، كنا نعرّف وسيطة "content"، ثم نقدّم تابعًا يقرأ محتوى ملف، وتابعًا آخر يغيّر المحتوى:
Puppet::Type.newtype(:file) do
    ...
    newproperty(:content) do
        def retrieve
            File.read(@resource[:name])
        end
        def sync
            File.open(@resource[:name], "w") { |f| f.print @resource[:content] }
        end
    end
end
هذا المثال مبسَّط إلى حدٍّ كبير (مثلًا، نستخدم داخليًا تجزئات تحقّق (checksums) بدلًا من سلاسل المحتوى الكاملة)، لكن الفكرة واضحة.
أصبح هذا مستحيلًا في الإدارة مع احتاجنا إلى دعم تنوّعات متعددة لنوع مورد بعينه. يدعم Puppet الآن أكثر من 30 نوعًا من إدارة الحزم، وكان دعمها جميعًا داخل نوع مورد Package واحد مستحيلًا. وبدلًا من ذلك، نوفّر واجهة نظيفة تفصل بين تعريف نوع المورد—أي، في جوهره، ما اسم نوع المورد وما الخصائص التي يدعمها— وبين كيفية إدارتك لذلك النوع من الموارد. وتعرّف المزوّدات توابع القراءة (getter) والكتابة (setter) لكل خصائص نوع المورد، بأسماء بديهية. فعلى سبيل المثال، هكذا يبدو مزوّد الخاصية السابقة:
Puppet::Type.newtype(:file) do
    newproperty(:content)
end
Puppet::Type.type(:file).provide(:posix) do
    def content
        File.read(@resource[:name])
    end
    def content=(str)
        File.open(@resource[:name], "w") { |f| f.print(str) }
    end
end
هذا قدرٌ أكبر قليلًا من الشيفرة في أبسط الحالات، لكنه أسهل بكثير في الفهم والصيانة، ولا سيما مع ازدياد عدد الخصائص أو عدد المزوّدات.
قلتُ في بداية هذا القسم إن المعاملة لا تؤثّر في النظام مباشرةً، وإنما تعتمد على RAL في ذلك. والآن صار واضحًا أن المزوّدات هي التي تؤدّي العمل الفعلي. بل إن المزوّدات، على العموم، هي الجزء الوحيد من Puppet الذي يلامس النظام فعليًا. فالمعاملة تطلب محتوى ملف، والمزوّد يجمعه؛ والمعاملة تحدّد أن محتوى ملف ينبغي تغييره، والمزوّد يغيّره. ولاحظ مع ذلك أن المزوّد لا يقرّر أبدًا تأثير النظام—المعاملة هي صاحبة القرارات، والمزوّد هو من ينفّذ العمل. وهذا يمنح المعاملة تحكمًا كاملًا دون أن تضطر إلى فهم أي شيء عن الملفات أو المستخدمين أو الحزم، وهذا الفصل هو ما يتيح لـ Puppet أن يوفّر وضع محاكاة كامل نضمن فيه إلى حدٍّ كبير ألا يتأثّر النظام.
النوع الرئيسي الثاني من الأصناف في RAL مسؤول عن الوسيطات نفسها. ولدينا في الواقع ثلاثة أنواع من الوسيطات: الوسائط فوقية (metaparameters) التي تؤثّر في جميع أنواع الموارد (مثل: هل ينبغي لك التشغيل في وضع المحاكاة)؛ والوسيطات، وهي قيم لا تنعكس على القرص (مثل: هل ينبغي اتباع الروابط الرمزية في الملفات)؛ والخصائص (properties)، وهي التي تنمذج جوانب المورد التي يمكنك تغييرها على القرص (مثل: محتوى ملف، أو هل الخدمة قيد التشغيل). والفرق بين الخصائص والوسيطات مربك بشكل خاص للناس، لكن إن فكّرت في الخصائص بوصفها تملك توابع قراءة وكتابة في المزوّدات، فالأمر بسيط نسبيًا.
الإبلاغ (Reporting)
بينما تسير المعاملة في الرسم البياني وتستخدم RAL لتغيير إعدادات النظام، فإنها تبني تقريرًا على نحو تدريجي. يتكوّن هذا التقرير إلى حدٍّ بعيد من الأحداث المولّدة بفعل التغييرات على النظام. وهذه الأحداث، بدورها، انعكاسات شاملة لما أُنجز من عمل: فهي تحتفظ بطابع زمني لتغيّر المورد، وبالقيمة السابقة، وبالقيمة الجديدة، وبأي رسالة أُنتجت، وبما إذا كان التغيير قد نجح أو فشل (أو كان في وضع المحاكاة).
تُلفَّ هذه الأحداث في كائن ResourceStatus يقابل كل مورد. وبذلك، وبالنسبة إلى معاملة بعينها، تعرف كل الموارد التي نُفِّذت، وتعرف أي تغييرات وقعت، مع كل البيانات الوصفية التي قد تحتاج إليها عن تلك التغييرات.
بمجرد اكتمال المعاملة، تُحسب بعض المقاييس الأساسية وتُخزَّن في التقرير، ثم يُرسَل إلى الخادم (إن كان الإعداد قد نُظِّم هكذا). وبإرسال التقرير تكتمل عملية الإعداد، فيعود الوكيل إلى وضع السكون أو تنتهي العملية ببساطة.
18.4. البنية التحتية
الآن وقد اكتسبنا فهمًا شاملاً لما يفعله Puppet وكيف يفعله، من المفيد أن نخصّص بعض الوقت للأجزاء التي لا تظهر كقدرات لكنها تظل حاسمة لإنجاز المهمة.
الإضافات (Plugins)
من أروع مزايا Puppet أنه قابل للتوسعة إلى حدٍّ كبير. فهناك 12 نوعًا على الأقل من أشكال قابلية التوسعة في Puppet، ومعظمها مقصود أن يكون متاحًا لكل شخص تقريبًا. فعلى سبيل المثال، يمكنك إنشاء إضافات مخصّصة لهذه المجالات:
- أنواع الموارد والمزوّدات المخصّصة
- معالِج التقارير (report handlers)، مثل لتخزين التقارير في قاعدة بيانات مخصّصة
- إضافات Indirector للتعامل مع مخازن البيانات الموجودة
- الحقائق (facts) لاكتشاف معلومات إضافية عن مضيفاتك
غير أن الطابع الموزَّع لـ Puppet يعني أن الوكلاء يحتاجون وسيلة لاسترجاع الإضافات الجديدة وتحميلها. ومن ثمّ، في بداية كل تشغيل لـ Puppet، أول ما نفعله هو تنزيل جميع الإضافات التي لدى الخادم. وقد تشمل أنواع موارد أو مزوّدات جديدة، أو حقائق جديدة، أو حتى معالجات تقارير جديدة.
وهذا يجعل من الممكن ترقية وكلاء Puppet ترقية كبيرة دون تغيير حِزَم Puppet الأساسية أبدًا. وهذا مفيد خصوصًا مع تثبيتات Puppet شديدة التخصيص.
Indirector
لقد لاحظت على الأرجح حتى الآن أن لدينا تقليدًا في اختيار أسماء الأصناف السيئة في Puppet، وأن اسم هذا الصنف يتصدّرها جميعًا. وIndirector إطار معكوس التحكم (Inversion of Control) نسبيًا قياسي ذو قابلية توسعة كبيرة. تتيح لك أنظمة عكس التحكم فصل تطوير الوظائف عن طريقة تحكمك في اختيار الوظائف التي تستخدمها. وفي حالة Puppet، يتيح لنا ذلك امتلاك إضافات كثيرة توفّر وظائف مختلفة تمامًا، مثل الوصول إلى المُصرِّف عبر HTTP أو تحميله في العملية نفسها، والتبديل بينها بتغيير صغير في الإعداد بدلًا من تغيير في الشيفرة. بمعنى آخر، إن Indirector في Puppet هو في جوهره تطبيق لمُحدِّد الخدمات (service locator)، كما هو موصوف في صفحة ويكيبيديا لـ "Inversion of Control". فكل عمليات التسليم من صنف إلى آخر تمرّ عبر Indirector، عبر واجهة شبيهة بـ REST (مثلًا: نُدعم find وsearch وsave وdestroy كتوابع). والتحوّل من وضع «بلا خادم» إلى وضع العميل/الخادم مسألة في جوهرها ضبط الوكيل ليعتمد نقطة طرف HTTP في استرجاع الكتالوجات، بدلًا من نقطة طرف المُصرِّف.
ولأنه إطار عكس تحكم يفصل الإعدادات فصلًا تامًا عن مسارات الشيفرة، فإن هذا الصنف قد يكون صعب الفهم أيضًا، ولا سيما حين تنهمك في تصحيح سبب استخدام مسار شيفرة بعينه.
الشبكات (Networking)
كُتبت النسخة الأولية من Puppet في صيف عام 2004، حين كان السؤال الكبير في الشبكات هو: هل نستخدم XMLRPC أم SOAP؟ اخترنا XMLRPC، وقد عملت جيدًا لكنها كانت تعاني معظم المشكلات التي كان يعانيها الجميع: فهي لم تشجّع وجود واجهات معيارية بين المكوّنات، ومالت إلى التعقيد الشديد بسرعة نتيجة لذلك. كما واجهنا مشكلات كبيرة في الذاكرة، لأن الترميز اللازم لـ XMLRPC كان يجعل كل كائن يظهر على الأقل مرتين في الذاكرة، وهو ما يصبح سريعًا الثمن مع الملفات الكبيرة.
ولإصدارنا 0.25 (الذي بدأ عام 2008)، شرعنا في عملية تحويل كل التواصل الشبكي إلى نموذج شبيه بـ REST، لكننا اخترنا طريقًا أعقد بكثير من مجرد تبديل طبقة الشبكة. فقد طوّرنا Indirector بوصفه الإطار المعياري للتواصل بين المكوّنات، وجعلنا نقاط طرف REST مجرد خيار من الخيارات. واستغرق الأمر إصدارَين للحصول على دعم كامل لـ REST، ولم نتم تمامًا بعد التحوّل إلى استخدام JSON (بدلًا من YAML) في كل عمليات التسلسل. وقد بدأنا التحوّل إلى JSON لسببين رئيسيين: أولًا، معالجة YAML في Ruby بطيئة على نحو مؤلم، بينما معالجة JSON في Ruby النقي أسرع بكثير؛ ثانيًا، يبدو أن معظم الويب يميل إلى JSON، وأنه يميل إلى أن يكون أكثر قابلية للنقل من YAML. وعلى نحو خاص في حالة Puppet، لم يكن أول استخدام لـ YAML قابلًا للنقل عبر اللغات، ولم يكن غالبًا قابلًا للنقل عبر إصدارات مختلفة من Puppet، لأنه كان في جوهره تسلسلًا لكائنات Ruby الداخلية.
وستزيل الإصدارة الرئيسية التالية من Puppet دعم XMLRPC بالكامل.
18.5. الدروس المستفادة
من حيث التنفيذ، أكثر ما نفتخر به في Puppet هو أشكال الفصل المختلفة الموجودة فيه: فاللغة منفصلة تمامًا عن RAL، والمعاملة لا تستطيع المساس بالنظام مباشرةً، وRAL لا تستطيع أن تقرّر تنفيذ عمل من تلقاء نفسها. وهذا يمنح مطوّر التطبيق تحكمًا كبيرًا في مسار عمل التطبيق، ومع وصول واسع إلى المعلومات عمّا يجري ولماذا.
قابلية Puppet للتوسعة والإعداد لهما أيضًا أصول رئيسية، لأن أي شخص يستطيع البناء فوق Puppet بسهولة تامة دون الحاجة إلى العبث بالنواة. وقد بنينا دائمًا قدراتنا الخاصة على الواجهات نفسها التي نوصي بها مستخدمينا.
بساطة Puppet وسهولة استخدامه كانتا دائمًا أبرز ما يجذبه. فما زال تشغيله أصعب مما ينبغي، لكنه أسهل بكثير من أي أداة أخرى في السوق. وهذه البساطة تأتي بكلفة هندسية كبيرة، وبخاصة في صورة الصيانة والعمل التصميمي الإضافي، لكنها تستحق ذلك كي نتيح للمستخدمين التركيز على مشكلاتهم بدلًا من الأداة.
قابلية Puppet للإعداد ميزة حقيقية، لكننا أخذناها إلى حدٍّ أبعد قليلًا مما ينبغي. فهناك طرق أكثر من اللازم لتوصيل أجزاء Puppet ببعضها، ومن السهل أكثر مما ينبغي بناء مسار عمل فوق Puppet سيجعل الحياة تعيسة. ومن أهدافنا الرئيسية القريبة، تقليص عدد مفاتيح الضبط المتاحة في إعداد Puppet بدرجة كبيرة، بحيث لا يستطيع المستخدم إعداده بصورة سيئة بسهولة تامة، وحيث نستطيع ترقيةه بمرور الوقت بسهولة أكبر من القلق بشأن الحالات الحدّية (edge cases) غامضة.
كما أننا ببساطة تغيّرنا ببطء أكثر مما ينبغي. فهناك عمليات إعادة هيكلة كبرى نودّ تنفيذها منذ سنوات لكننا لم نبدأ بها قط. وقد أدّى ذلك إلى نظام أكثر استقرارًا لمستخدمينا في الأجل القصير، لكنه أيضًا أدّى إلى نظام أصعب في الصيانة، وإلى نظام أصعب بكثير في المساهمة فيه.
وأخيرًا، استغرق الأمر وقتًا أطول مما ينبغي لندرك أن أهدافنا في البساطة كانت تُعبَّر عنها على نحو أفضل بلغة التصميم. فما إن بدأنا نتحدث عن التصميم بدلًا من مجرد البساطة، حتى اكتسبنا إطارًا أفضل بكثير لاتخاذ القرارات بشأن إضافة المزايا أو إزالتها، مع وسيلة أفضل للتواصل عن المبررات وراء تلك القرارات.
18.6. الخاتمة
Puppet نظام بسيط ومعقّد في آن واحد. فله أجزاء كثيرة متحركة، لكنها موصولة ببعضها بخفة تامة، وقد تغيّر كل منها تغيّرًا لافتًا منذ تأسيسه عام 2005. وهو إطار يمكن استخدامه لجميع أنواع مشكلات الإعداد، لكنه كتطبيق يظل بسيطًا وميسّرًا.
يقوم نجاحنا المستقبلي على أن يصبح ذلك الإطار أكثر متانة وأبسط، وعلى أن يظل ذلك التطبيق ميسّرًا وهو يكتسب قدرات جديدة.