OSCAR
معمارية تطبيقات المصادر المفتوحة (المجلد الثاني)OSCAR
معمارية تطبيقات المصادر المفتوحة (المجلد الثاني) OSCAR
جينيفر روتان
إذا استمتعت بهذه الكتب، فقد يعجبك أيضًا التصميم البرمجي بالأمثلة في Python والتصميم البرمجي بالأمثلة في JavaScript.
منذ اعتمادها الأول، سعت أنظمة السجلات الطبية الإلكترونية (EMR) إلى ردم الفجوة بين العالمين المادي والرقمي في رعاية المرضى. وحاولت حكومات دول مختلفة حول العالم إطلاق حلّ يمكّن من رعاية أفضل للمرضى بتكلفة أقل، مع تقليل حجم الأوراق التي تولّدها الطبّ عادةً. وقد كانت محاولات كثير من هذه الحكومات لإنشاء مثل هذا النظام ناجحة إلى حدٍّ كبير—غير أنّ بعضها، مثل ما نفّذته مقاطعة أونتاريو الكندية، لم ينجح (قد يتذكّر بعضُهم ما عُرف بـ«فضيحة الصحة الإلكترونية» في أونتاريو، والتي كلّفت دافعي الضرائب، بحسب المراقب المالي، مليار دولار كندي).
يسمح السجل الطبي الإلكتروني (EMR) بتحويل ملف المريض إلى صيغة رقمية، وأن يجعل استخدامه على النحو الصحيح من الأسهل على الطبيب تقديم الرعاية. وينبغي أن يوفّر النظام الجيد للطبيب رؤية شاملة للحالات الحالية والمستمرة للمريض، وسجل الوصفات الطبية له، ونتائج التحاليل الأخيرة، وتاريخ زياراته السابقة، وهكذا. أما OSCAR (Open Source Clinical Application Resource) فهو مشروع من جامعة ماكماستر في هاميلتون، أونتاريو، كندا، عمره نحو عشر سنوات، وهو محاولة مجتمع المصادر المفتوحة لتوفير مثل هذا النظام للأطباء بتكلفة منخفضة أو معدومة.
يتضمّن OSCAR عددًا كبيرًا من الأنظمة الفرعية التي توفّر وظائفها مكوّنًا تلو الآخر. فمثلًا يوفّر oscarEncounter واجهةً للتفاعل مع ملف المريض مباشرةً، بينما Rx3 هي وحدة لوصفات طبية تتحقّق تلقائيًا من الحساسية وتفاعلات الأدوية، وتتيح للطبيب إرسال الوصفة إلى الصيدلية بالبريد الفاكس مباشرةً من واجهة المستخدم؛ أمّا Integrator فهو مكوّن يتيح تبادل البيانات بين عدّة أنظمة EMR متوافقة. ويجتمع كل هذه المكوّنات المتفرّقة معًا لتُشكّل تجربة المستخدم النموذجية في OSCAR.
لن يكون OSCAR مناسبًا لكل طبيب؛ فقد لا يجد الاختصاصي مثلًا كل ميزات النظام مفيدة، كما أنّه ليس قابلًا للتخصيص بسهولة. غير أنّه يقدّم مجموعة متكاملة من الميزات للطبيب العام الذي يتعامل مع المرضى على أساس يومي.
بالإضافة إلى ذلك، فإنّ OSCAR حاصل على شهادة CMS 3.0 (وقد تقدّم بطلب للحصول على شهادة CMS 4.0)—وهذا يتيح للأطباء الحصول على تمويل لتركيبه في عياداتهم (تفصيل ذلك في EMR Advisor). ويتطلب الحصول على شهادة CMS اجتياز مجموعة من المتطلبات التي تضعها حكومة أونتاريو إلى جانب دفع رسوم.
سيناقش هذا الفصل معمارية OSCAR بمصطلحات عامة إلى حدٍّ ما، وسيفصّل التسلسل الهرمي والمكوّنات الرئيسة، والأهم من ذلك أثر القرارات السابقة في المشروع. أمّا في الخاتمة فستُناقش مسألة كيفية التصميم التي كان يمكن أن يُصمَّم بها OSCAR اليوم لو توفّرت الفرصة لذلك.
16.1. تسلسل النظام
بصفته تطبيق ويب يعمل على Tomcat، يتبع OSCAR عمومًا نمط تصميم «نموذج-المشاهد-المتحكم» (Model-View-Controller). ويقصد بذلك أن شيفرة النموذج (كائنات الوصول إلى البيانات، أو DAOs) مفصولة عن شيفرة المتحكم (servlet)، وأن كلاهما مفصول عن المشاهد (صفحات خادم Java، أو JSPs). وأهم فرق بين الاثنين هو أنّ servlet أصناف (classes) في حين أنّ JSPs صفحات HTML موسومة بشيفرة Java. وتُدرَج البيانات في الذاكرة عند تنفيذ servlet، ثم تقرأ JSP البيانات نفسها، وهو ما يتم عادةً عبر القراءة والكتابة في سمات كائن الطلب. وتقريبًا كل صفحة JSP في OSCAR مصمَّمة على هذا النحو.
16.2. القرارات السابقة
لقد ذكرت أنّ OSCAR مشروع قديم نسبيًا. ولهذا الأمر آثار على مدى فاعلية تطبيق نمط MVC. وباختصار، هناك أجزاء من الشيفرة تتجاهل هذا النمط تمامًا، لأنها كُتبت قبل أن يبدأ التطبيق الصارم لنمط MVC. وبعض أكثر الميزات شيوعًا مكتوبة على هذا النحو؛ فمثلًا، تُنفَّذ كثير من الإجراءات المتعلقة بالبيانات الديموغرافية (سجلات المرضى) عبر الملف demographiccontrol.jsp—ومن ذلك إنشاء المرضى وتحديث بياناتهم.
يُعثِّر قُدم المشروع على معالجة كثير من المشكلات التي تواجه شجرة المصدر اليوم. وقد بُذل جهد كبير لتحسين الوضع، بما في ذلك فرض قواعد التصميم عبر عملية مراجعة الشيفرة. وهذا نهج قرر المجتمع في الوقت الحالي أنّه سيتيح تعاونًا أفضل مستقبلًا، ويمنع الشيفرة الرديئة من أن تصبح جزءًا من قاعدة الشيفرة، وهي مشكلة أبدتها الماضي.
هذا لا يعني بأي حال من الأحوال تقييدًا لطريقة تصميمنا لأجزاء النظام الآن؛ لكنّه بالفعل يجعل من القرار المتعلق بإصلاح الأخطاء في جزء قديم من OSCAR أكثر تعقيدًا. فهل أنت، بوصفك مكلَّفًا بإصلاح خطأ في دالة Demographic Creation، تُصلح الخطأ بشيفرة على النمط نفسه القائم حاليًا؟ أم أنك تعيد كتابة الوحدة بالكامل بحيث تلتزم عن قرب بنمط تصميم MVC؟
يطّلِب منا، كمطوّرين، أن نزن خياراتنا بعناية في مثل هذه المواقف. ولا يوجد ضمان بأنّك لن تُنشئ أخطاءً جديدة إذا أعدت معمارية جزء من النظام، وحين تكون بيانات المرضى على المحكّ، علينا أن نتّخذ القرار بعناية.
16.3. التحكّم بالإصدارات
جرى استخدام مستودع CVS طوال الجزء الأكبر من عمر OSCAR. ولم تكن الإيداعات (commits) تُفحص عادةً من حيث الاتّساق، وكان من الممكن إيداع شيفرة تكسر عملية البناء. وكان يصعب على المطوّرين مواكبة التغييرات—خاصةً المطوّرين الجدد الذين انضمّوا إلى المشروع في مرحلة متأخّرة من دورة حياته. فقد كان بإمكان مطوّر جديد أن يرى شيئًا ويرغب في تغييره، فيُجري التغيير، ويصل به إلى فرع المصدر قبل عدة أسابيع دون أن يلاحظ أحد أنّ تعديلًا مهمًّا قد حدث (وكان هذا واردًا بصفة خاصة خلال العطلات الطويلة، مثل عطلة عيد الميلاد، حين لا يراقب شجرة المصدر كثيرون).
لقد تغيّر الأمر؛ فأصبحت شجرة مصدر OSCAR موضوعة تحت التحكّم عبر git. وأي إيداع في الفرع الرئيسي يجب أن يجتاز فحوص أسلوب الشيفرة واختبارات الوحدات، وأن يُترجَم بنجاح، وأن يخضع لمراجعة من قِبل المطوّرين. (معظم ذلك يتولّاه مزيج من Hudson، وهو خادم تكامل مستمر، وGerrit، وهي أداة مراجعة شيفرة.) وقد أصبح المشروع موضوعًا تحت تحكّم أكثر إحكامًا بكثير. وقد حُلّت كل المشكلات تقريبًا، أو كثير منها، التي ناجمت عن سوء التعامل مع شجرة المصدر.
16.4. نماذج البيانات/DAOs
عند تصفّح شيفرة OSCAR، قد تلاحظ أنّ هناك طرقًا كثيرة مختلفة للوصول إلى قاعدة البيانات: يمكنك استخدام اتصال مباشر بقاعدة البيانات عبر صنف اسمه DBHandler، أو استخدام نموذج Hibernate قديم، أو استخدام نموذج JPA عام. وبينما كانت نماذج الوصول الأحدث والأسهل إلى قاعدة البيانات تصبح متاحة، أُدمجت في OSCAR. والنتيجة أنّ هناك الآن صورة مشوّشة لكيفية تفاعل OSCAR مع البيانات في MySQL، وأفضل طريقة لوصف الفروق بين أنواع طرق الوصول الثلاثة إلى البيانات هي تقديم الأمثلة.
نماذج EForms (DBHandler)
يسمح نظام EForm للمستخدمين بإنشاء نماذجهم الخاصة لإرفاقها بسجلات المرضى—وتُستخدم هذه الميزة عادةً لاستبدال نموذج ورقي بإصدار رقمي. وعند كل إنشاء لنموذج من نوع بعينه، يُحمَّل ملف قالب النموذج؛ ثم تُخزَّّن بيانات النموذج في قاعدة البيانات لكل نسخة. وتُرفَق كل نسخة بسجل مريض.
تتيح EForms لك سحب أنواع معيّنة من البيانات من ملف مريض أو من جزء آخر من النظام عبر استعلامات SQL حرة (تُعرَّف في ملف اسمه apconfig.xml). وقد يكون هذا مفيدًا إلى حدٍّ كبير، إذ يمكن للنموذج أن يُحمَّل ثم تُملأ بياناته الديموغرافية أو غيرها من المعلومات ذات الصلة فورًا دون تدخّل من المستخدم؛ فمثلًا لن تحتاج إلى كتابة اسم المريض أو سنّه أو تاريخ ميلاده أو مدينته أو رقم هاتفه أو آخر ملاحظة سُجّلت له.
اتُّخذ قرار تصميمي عند تطوير وحدة EForm في الأصل يقضي باستخدام استعلامات قاعدة بيانات خام لتغذية كائن POJO (كائن Java بسيط، plain-old Java object) اسمه EForm داخل المتحكم، ثم يُمرَّر بدوره إلى طبقة المشاهدة لعرض البيانات على الشاشة، على نحو أشبه بـ JavaBean. واستخدام POJO في هذه الحالة في الواقع أقرب تصميميًا إلى معمارية Hibernate أو JPA، كما سأشرح في الأقسام التالية.
يتم تنفيذ جميع وظائف حفظ نسخ EForm وقوالبها عبر استعلامات SQL خام تُنفَّذ من خلال الصنف DBHandler. وفي نهاية المطاف، DBHandler مجلِّد (wrapper) لكائن JDBC بسيط ولا يفحص الاستعلام قبل إرساله إلى خادم SQL. ومن الواجب الإشارة هنا إلى أنّ DBHandler يمثّل ثغرة أمنية محتملة، إذ يسمح بإرسال شيفرة SQL غير مفحوصة إلى الخادم. وأي صنف يستخدم DBHandler ملزَم بتنفيذ الفحص الخاص به للتأكّد من عدم وقوع حقن SQL (SQL injection).
قد يكون الوصول المباشر إلى قاعدة البيانات مقبولًا أحيانًا تبعًا لنوع التطبيق الذي تكتبه. وفي حالات معيّنة، قد يسرّع ذلك حتى من عملية التطوير. لكنّ هذه الطريقة في الوصول إلى قاعدة البيانات لا تفي بنمط تصميم «نموذج-المشاهد-المتحكم»: فإذا أردت تغيير بنية قاعدة البيانات (أي النموذج)، فعليك تعديل استعلام SQL في مكان آخر (في المتحكم). وأحيانًا، يتطلّب إضافة أعمدة معيّنة أو تغيير أنواعها في جداول قاعدة بيانات OSCAR اتّباع هذا الإجراء التداخلي لمجرّد تنفيذ ميزات صغيرة.
قد لا يدهشك أن تكتشف أنّ كائن DBHandler إحدى أقدم قطع الشيفرة التي لا تزال قائمة في المصدر. شخصيًا لا أعرف من أين أتى، لكنّي أعتبره أكثر أنواع الوصول إلى قاعدة البيانات «بدائية» الموجودة في شيفرة OSCAR. ولا يُسمح لأي شيفرة جديدة باستخدام هذا الصنف، وإذا أُودعت شيفرة تستخدمه فسيُرفض الإيداع تلقائيًا.
السجلات الديموغرافية (Hibernate)
يحتوي السجل الديموغرافي على بيانات وصفية عامة عن مريض؛ مثل اسمه وسنّه وعنوانه ولغته وجنسه؛ فكّر فيه بوصفه نتيجة استمارة تسجيل يستكملها المريض خلال أول زيارة له عند طبيب. وتُسترجَع كل هذه البيانات وتُعرَض كجزء من السجل الرئيسي (Master Record) في OSCAR لسجل ديموغرافي بعينه.
إنّ استخدام Hibernate للوصول إلى قاعدة البيانات أكثر أمانًا بكثير من استخدام DBHandler. فأولًا، عليك صراحةً أن تعرّف أي الأعمدة يطابق أي الحقول في كائن النموذج (في هذه الحالة، صنف Demographic). وإذا أردت تنفيذ عمليات دمج (joins) معقّدة، فيلزم تنفيذها بوصفها عبارات مُجهَّزة (prepared statements). وأخيرًا، لن تتلقّى سوى كائن من النوع الذي تطلبه عند تنفيذ استعلام، وهو أمر مريح إلى حدٍّ كبير.
العملية العاملة مع زوج من صنف DAO وصنف Model بنمط Hibernate بسيطة إلى حدٍّ كبير. وفي حالة كائن Demographic، هناك ملف اسمه Demographic.hbm.xml يصف الخرائط (mapping) بين حقول الكائن وأعمدة قاعدة البيانات. ويصف الملف أي جدول ينبغي الاطلاع عليه، وما نوع الكائن الذي ينبغي إرجاعه. وعندما يبدأ OSCAR، تُىرَأ ويجري فحص سلامة للتأكّد من أنّ هذا النوع من الخرائط يمكن إنشاؤه فعلًا (يفشل بدء تشغيل الخادم إن تعذّر ذلك). وبعد التشغيل، تحصل على نسخة من كائن DemographicDao وتنفّذ الاستعلامات عليه.
أفضل ما في استخدام Hibernate بدلًا من DBHandler هو أنّ جميع الاستعلامات المُرسَلة إلى الخادم هي عبارات مُجهَّزة. وهذا يحصر قدرتك على تنفيذ SQL حر أثناء وقت التشغيل، لكنه يمنع أيضًا أي نوع من هجمات حقن SQL. وغالبًا ما يبني Hibernate استعلامات كبيرة لجلب البيانات، ولا يكون أداؤه فائق الكفاءة دائمًا.
ذكرت في القسم السابق مثالًا لوحدة EForm تستخدم DBHandler لتغذية POJO. وهذه هي الخطوة المنطقية التالية لمنع كتابة هذا النوع من الشيفرة. فإذا كان على النموذج أن يتغيّر، فإنّ ملف .hbm.xml وصنف النموذج وحدهما هما ما يحتاج إلى التعديل (حقل جديد مع دالتي getter/setter للعمود الجديد)، ولن يؤثر ذلك على بقية التطبيق.
على الرغم إلك أحدث من DBHandler، فإنّ طريقة Hibernate بدأت أيضًا في إظهار عمرها. فهي ليست مريحة في الاستخدام دائمًا، وتتطلب ملف إعداد كبير لكل جدول تريد الوصول إليه. ويستغرق تجهيز زوج جديد من الأصناف وقتًا، وإذا أخطأت في ذلك فلن يبدأ OSCAR أصلًا. ولهذا السبب أيضًا، لا ينبغي لأحد أن يكتب شيفرة جديدة تستخدم Hibernate صِرفًا.
موافقة Integrator (JPA)
أحدث أشكال الوصول إلى قاعدة البيانات يتم عبر JPA العام. وإذا قرر مشروع OSCAR الانتقال من Hibernate إلى واجهة برمجية أخرى للوصول إلى قاعدة البيانات، فإنّ الالتزام بمعيار JPA في كائنات DAO وكائنات Model يجعل الترحيل سهلًا إلى حدٍّ كبير. وللأسف، ولأنّ هذا الأمر «جديد» إلى حدٍّ كبير على مشروع OSCAR، فهناك مناطق شبه معدومة من النظام تستخدم هذه الطريقة فعليًا لجلب البيانات.
على أي حال، دعني أشرح كيف يعمل. فبدلًا من ملف .hbm.xml، تضيف شروحًا (annotations) إلى كائنات Model وكائنات DAO. وتصف هذه الشروح الجدول الذي ينبغي الاطلاع عليه، وخرائط الأعمدة للحقول، واستعلامات الدمج. وكل شيء محتوٍ داخل الملفين، ولا يلزم أي شيء آخر لتشغيلهما. ومع ذلك، لا يزال Hibernate يعمل في الخلفية عند جلب البيانات فعليًا من قاعدة البيانات.
جميع نماذج Integrator مكتوبة باستخدام JPA—وهي أمثلة جيدة إلى حدٍّ كبير على أسلوب الوصول الجديد إلى قاعدة البيانات، كما تبيّن أنّ هذه التقنية الجديدة، عند تطبيقها في OSCAR، لم تُستخدم إلّا في أماكن قليلة جدًا حتى الآن. يُعدّ Integrator إضافة حديثة نسبيًا إلى المصدر. ومن المعقول تمامًا استخدام نموذج الوصول هذا الجديد بدلًا من Hibernate.
ولنعد إلى موضوع شائع في هذا القسم من الفصل: فالـ POJO المشروح الذي يستخدمه JPA يتيح تجربة أكثر انسيابية بكثير. فمثلًا، أثناء عملية بناء Integrator، يُنشأ ملف SQL يُنشئ كل الجداول نيابةً عنك—وهي ميزة مفيدة إلى حدٍّ هائل. ومع هذه القدرة، يستحيل إنشاء جداول وكائنات نموذج غير متطابقة (كما يمكنك فعله مع أي نوع آخر من طرق الوصول إلى قاعدة البيانات)، ولن تحتاج قطّ إلى القلق بشأن تسمية الأعمدة والجداول. ولا توجد استعلامات SQL مباشرة، ومن ثمّ يستحيل تنفيذ هجمات حقن SQL. باختصار، هو «يعمل فحسب».
يمكن القول إنّ طريقة عمل JPA متشابهة إلى حدٍّ كبير مع طريقة عمل ActiveRecord في Ruby on Rails. فصنف النموذج يعرّف نوع البيانات وقاعدة البيانات تخزّنه؛ أمّا ما يجري بينهما—إدخال البيانات وإخراجها—فليس بيد المستخدم.
المشكلات في Hibernate و JPA
يقدّم Hibernate و JPA معًا بعض الفوائد الجوهرية في حالات الاستخدام النموذجية. فبالنسبة للاسترجاع والتخزين البسيط، فإنهما يختصران حقًا وقت التطوير والتصحيح (debugging).
غير أنّ ذلك لا يعني أنّ دمجهما في OSCAR تمّ بلا مشكلات. وبما أنّ المستخدم لا يعرّف عبارات SQL بين قاعدة البيانات و POJO الذي يشير إلى صف بعينه، فإنّ Hibernate يحقّ له اختيار أفضل طريقة للقيام بذلك. وقد تتجلّى «أفضل طريقة» بصورتين: إما أن يختار Hibernate مجرّدًا استرجاع البيانات البسيطة من الصف، وإما أن ينفّذ عملية دمج (join) فيسترجع كمية كبيرة من المعلومات دفعة واحدة. وأحيانًا ما تخرج عمليات الدمج هذه عن السيطرة.
وهنا مثال آخر: يخزّن الجدول casemgmt_note جميع ملاحظات المرضى. ويخزّن كل كائن ملاحظة قدرًا كبيرًا من البيانات الوصفية عن الملاحظة—لكنّه يخزّن أيضًا قائمة بكل المشكلات التي تتناولها الملاحظة (ويمكن أن تكون المشكلات أمورًا مثل «الإقلاع عن التدخين» أو «السكري»، وهي أوصاف لمحتوى الملاحظة). وتُمثَّل قائمة المشكلات في كائن الملاحظة بوصفها List. وللحصول على تلك القائمة، يُدمَج الجدول casemgmt_note مع الجدول casemgmt_issue_notes (الذي يعمل كجدول ربط) ثم أخيرًا مع الجدول casemgmt_issue.
وحين تريد كتابة استعلام مخصّص في Hibernate، وهو ما تتطلّبه هذه الحالة، فإنّك لا تكتب SQL قياسيًا—بل تكتب HQL (لغة استعلام Hibernate، Hibernate Query Language) يُترجَم لاحقًا إلى SQL (بإدراج أسماء أعمدة داخلية لكل الحقول المطلوب اختيارها) قبل إدراج الوسائط وإرسال الاستعلام إلى خادم قاعدة البيانات. وفي هذه الحالة بالذات، كُتب الاستعلام بعمليات دمج أساسية من دون أعمدة دمج—بمعنى أنّه حين تُرجم الاستعلام في النهاية إلى SQL، كان حجمه كبيرًا إلى حدّ أنّه لم يكن واضحًا فورًا ما الذي يجمعه الاستعلام. وإلى جانب ذلك، ففي كل الحالات تقريبًا لم يُنشئ هذا جدولًا مؤقتًا كبيرًا بما يكفي ليهمّ. وبالنسبة لمعظم المستخدمين، يعمل هذا الاستعلام بسرعة كافية فعلًا بحيث لا يلاحظونه. ومع ذلك، هذا الاستعلام غير فعّال إلى درجة لا تُصدَّق.
ولنتراجع خطوة إلى الخلف للحظة. حين تنفّذ عملية دمج على جدولين، على الخادم أن ينشئ جدولًا مؤقتًا في الذاكرة. وفي أكثر أنواع عمليات الدمج عمومية، يساوي عدد الصفوف عدد صفوف الجدول الأول مضروبًا في عدد صفوف الجدول الثاني. فإذا كان جدولك يضمّ 500,000 صف وقمت بدمجه مع جدول يضمّ 10,000,000 صف، فقد أنشأت للتو جدولًا مؤقتًا في الذاكرة بـ 5×10¹² صف، ثم يُنفَّذ عليه عبارة select ويُهمَل ذلك الجدول المؤقت.
وفي إحدى الحالات القصوى التي واجهناها، أدّى الدمج عبر ثلاثة جداول إلى إنشاء جدول مؤقت بلغ طوله نحو 7×10¹² صف، اختير منها نحو 1000 صف فقط. استغرقت هذه العملية نحو 5 دقائق وأغلقت القفل على الجدول casemgmt_note طوال فترة تنفيذها.
أمّا المشكلة فحُلّت في النهاية باستخدام عبارة مُجهَّزة قيّدت نطاق الجدول الأول قبل الدمج مع الجدولين الآخرين. وخفّض الاستعلام الأحدث والأكفأ بكثير عدد الصفوف المطلوب اختيارها إلى 300,000 وهو رقم قابل للإدارة إلى حدٍّ كبير، وحسّن أداء عملية استرجاع الملاحظات تحسّنًا هائلًا (انخفض إلى نحو 0.1 ثانية لتنفيذ عبارة select نفسها).
الدرس المستفاد من القصة هو ببساطة أنّ Hibernate، وإن كان يؤدّي عملًا جيدًا إلى حدٍّ معقول، فإنّه ما لم يكن الدمج (join) معرَّفًا ومضبوطًا على نحو صريح (إمّا في ملف .hbm.xml أو في شرح دمج داخل صنف الكائن لنموذج JPA)، فإنه سريعًا ما يخرج عن السيطرة. فالتعامل مع الكائنات بدلًا من استعلامات SQL يفرض عليك ترك التنفيذ الفعلي للاستعلام إلى مكتبة الوصول إلى قاعدة البيانات، ولا يتيح لك عمليًا سوى التحكم في تعريفه. ما لم تكن حذرًا في كيفية تعريف الأشياء، يمكن أن ينهار كل شيء في الظروف المتطرّفة. وإلى جانب ذلك، فإنّ كنت مبرمج قواعد بيانات موسوعًا بمعرفة SQL، فلن يفيدك ذلك كثيرًا عند تصميم صنف يدعم JPA، كما أنّه يسلبك بعض التحكّم الذي كان لك لو كنت تكتب عبارة SQL يدويًا. وفي نهاية المطاف، فإنّ المعرفة الجيدة بعبارات SQL وبشروح JPA وبكيفية تأثيرها في الاستعلامات أمر ضروري.
16.5. الصلاحيات
كان CAISI (Client Access to Integrated Services and Information) في الأصل منتجًا مستقلًا—وهو تفرّع (fork) من OSCAR—يساعد على إدارة مأوى المشردين في تورونتو. واتُّخذ قرار في النهاية بدمج شيفرة CAISI في الفرع الرئيسي للمصدر. ومشروع CAISI الأصلي لم يعد قائمًا على الأرجح، لكن ما منحه لـ OSCAR مهم إلى حدٍّ كبير: نموذج الصلاحيات لديه.
نموذج الصلاحيات في OSCAR قوي إلى حدٍّ كبير ويمكن استخدامه لإنشاء عدد من الأدوار ومجموعات الصلاحيات يصل إلى أقصى حد ممكن. ينتمي مقدّمو الخدمة (providers) إلى البرامج (programs) بوصفهم موظفين (staff) لديهم دور (role) محدّد. يجري كل برنامج في منشأة (facility) بعينها. ولكل دور وصف (مثل «طبيب» أو «ممرّض» أو «أخصائي اجتماعي»، وهكذا) ومجموعة من الصلاحيات العالمية المرتبطة به. وتُكتب الصلاحيات بصيغة تجعل فهمها سهلًا إلى حدٍّ كبير: قد تكون «قراءة ملاحظات الممرضين» صلاحية يملكها دور الطبيب، في حين قد لا يملك دور الممرّض صلاحية «قراءة ملاحظات الأطباء».
قد تكون هذه الصيغة سهلة الفهم، لكنّها تتطلّب في باطنها قدرًا كبيرًا من العمل الشاقّ للتحقّق فعليًا من هذا النوع من الصلاحيات. إذ يُطابَق اسم الدور الذي يحمله مقدّم الخدمة الحالي مع قائمة صلاحياته بحثًا عن تطابق مع الإجراء الذي يحاول تنفيذه. فمثلًا، إذا حاول مقدّم خدمة قراءة ملاحظات طبيب، فسيجري التحقّق من «قراءة ملاحظات الأطباء» لكل ملاحظة وكل واحدة دون استثناء كتبها طبيب.
وثمة مشكلة أخرى هي الاعتماد على الإنجليزية في تعريف الصلاحيات. فمن يستخدم OSCAR بلغة غير الإنجليزية سيظل مضطرًا إلى كتابة صلاحياته بصيغة مثل "read [role] notes"، باستخدام الكلمات الإنجليزية "read" و "write" و "notes"، وهكذا.
يُعدّ نموذج صلاحيات CAISI جزءًا مهمًّا من OSCAR، لكنّه ليس النموذج الوحيد المعمول به. وقبل تنفيذ CAISI، جرى تطوير نظام آخر قائم على الأدوار (لكن ليس قائمًا على البرامج) ولا يزال مستخدمًا في أجزاء كثيرة من النظام حتى اليوم.
في هذا النظام الثاني، يُسنَد إلى مقدّمي الخدمة دور واحد أو عدّة أدوار (مثل «طبيب» أو «ممرّض» أو «مدير»، وهكذا). ويمكن أن يُسنَد إليهم ما يحتاجون إليه من أدوار—فتتراكم صلاحيات الأدوار فوق بعضها. وتُستخدم هذه الصلاحيات عمومًا لتقييد الوصول إلى أجزاء من النظام، على النقيض من صلاحيات CAISI التي تقيّد الوصول إلى أجزاء معيّنة من البيانات في ملف المريض. فمثلًا، يجب أن يملك المستخدم صلاحية "_admin" "read" على أحد الأدوار المسندة إليه كي يتمكّن من الوصول إلى لوحة الإدارة. غير أن امتلاكه صلاحية "read" يُعفيه من إمكانية تنفيذ المهام الإدارية؛ إذ سيحتاج إلى صلاحية "write" أيضًا ذاك.
تحقّق كلا النظامين الغاية نفسها تقريبًا؛ ووجودهما معًا سببه دمج CAISI في مرحلة متأخّرة من دورة حياة المشروع. ولا يتعايشان دائمًا على نحو منسجم، لذا يكفي في الواقع أن تقتصر على استخدام أحدهما في العمليات اليومية لـ OSCAR. ويمكن عمومًا تحديد زمن كتابة الشيفرة في OSCAR بمعرفة أي نموذج صلاحيات سبق أيّهما: نوع مقدّم الخدمة (Provider Type) ثم أدوار مقدّمي الخدمة (Provider Roles) ثم برامج/أدوار CAISI (CAISI Programs/Roles)
أمّا أقدم أنواع نماذج الصلاحيات، وهو «نوع مقدّم الخدمة»، فقديم إلى حدّ أنّه لم يعد مستخدمًا فعليًا في معظم أجزاء النظام، بل تُضبط قيمته افتراضيًا على «طبيب» عند إنشاء مقدّم خدمة جديد—وتعيينه على أي قيمة أخرى (مثل «موظف استقبال») يسبّب مشكلات كبيرة في النظام كله. والتحكّم في الصلاحيات عبر أدوار مقدّمي الخدمة أسهل وأدقّ تفصيلًا.
16.6. Integrator
مكوّن Integrator في OSCAR هو تطبيق ويب منفصل تستخدمه نسخ OSCAR المستقلة لتبادل معلومات المرضى والبرامج ومقدّمي الخدمة عبر وصلة آمنة. ويمكن تركيبه اختياريًا كمكوّن ضمن تثبيت في بيئة مثل شبكة صحة محلية (LHN، Local Health Network) أو مستشفى. وأبسط طريقة لوصف Integrator هي اعتباره منشأة تخزين مؤقّت.
تأمّل حالة الاستخدام التالية والحجّة التي تُبرّر استخدام Integrator: في مستشفى X توجد عيادة أنف وأذن وحنجرة (ENT) إضافةً إلى عيادة غدد صمّاء. فإذا أحال طبيب ENT مريضه إلى أخصائي غدد صمّاء في الطابق الأعلى، فقد يُطلب منه إرسال تاريخ المريض وسجلاته. وهذا أمر مثير للانزعاج ويولّد قدرًا من الأوراق يفوق الحاجة—فربّما لا يرى المريض أخصائي الغدد الصمّاء إلا مرة واحدة. وباستخدام Integrator، يمكن الوصول إلى بيانات المريض على EMR الخاص بأخصائي الغدد الصمّاء، ويمكن سحب الإذن بالوصول إلى محتوى ملف المريض بعد الزيارة.
ومثال أكثر تطرّفًا: لو ظهر رجل فاقد للوعي في قسم الطوارئ ومعه بطاقة صحته فقط، فإنّ العيادة الأصلية ونظام المستشفى متصلان عبر Integrator، ويمكن جلب سجل الرجل، ويمكن إدراك بسرعة أنه وُصف له دواء مميّع للدم هو الوارفارين (warfarin). وفي نهاية المطاف، فإنّ استرجاع المعلومات من هذا النوع هو ما يستطيع فعله نظام EMR مثل OSCAR المقترن بـ Integrator.
التفاصيل التقنية
يتوفّر Integrator في صيغة الشيفرة المصدرية فقط، وهذا يتطلّب من المستخدم استرجاعه وبنائه يدويًا. وكما OSCAR، فهو يعمل على تثبيت قياسي من Tomcat مع MySQL.
وعند الوصول إلى عنوان URL الذي يوجد فيه Integrator، لا يبدو أنه يعرض أي شيء مفيد. فهذا المكوّن عمليًا خدمة ويب خالصة؛ إذ يتواصل OSCAR مع عنوان URL الخاص بـ Integrator عبر طلبات POST و GET.
وبصفه مشروعًا مطوَّرًا باستقلال (في البداية كجزء من مشروع CAISI)، فإنّ Integrator ملتزم إلى حدٍّ كبير بنمط تصميم MVC. وقد أحسن المطوّرون الأصليون عملهم في تهيئته بحدود واضحة جدًا بين النماذج والمشاهد والمتحكمات. وأحدث أنواع طبقات الوصول إلى قاعدة البيانات الذي ذكرته سابقًا—وهي JPA العام—هو النوع الوحيد من هذه الطبقات في المشروع. (وكملاحظة جانبية مثيرة للاهتمام: لكون المشروع بالكامل مهيّأ على النحو الصحيح بشروح JPA على جميع أصناف النموذج، فإنّه يُنشأ سكربت SQL وقت البناء يمكن استخدامه لتهيئة بنية قاعدة البيانات؛ وبالتالي فإنّ Integrator لا يأتي مع سكربت SQL مستقل.)
ويُدار التواصل عبر نداءات خدمات الويب الموصوفة في ملفات WSDL XML المتاحة على الخادم. ويستطيع أي عميل أن يستعلم من Integrator ليعرف ما هي الدوال المتاحة ثم يتكيّف معها. ويعني هذا فعليًا أنّ Integrator متوافق مع أي نوع من أنظمة EMR يقرّر أحدهم كتابة عميل له؛ فصيغة البيانات عامة بما يكفي لي يسهل ربطها بالأنواع المحلية.
لكنّ OSCAR، من أجل تبسيط الأمور، يبني مكتبة عميل تُدرَج ضمن شجرة المصدر الرئيسية. ولا تحتاج تلك المكتبة إلى التحديث إلا إذا توفّرت دوال جديدة في Integrator. أما إصلاح خطأ في Integrator فلا يتطلّب تحديث ذلك الملف.
التصميم
تصل بيانات Integrator من جميع أنظمة EMR المتصلة في أوقات مجدولة، وبمجرد وصولها إلى هناك يستطيع نظام EMR آخر طلب تلك البيانات. ومع ذلك، لا يُخزَّن أيٌّ من بيانات Integrator تخزينًا دائمًا—يمكن محو قاعدة بياناته وإعادة بنائها من بيانات العملاء.
تُعدّ مجموعة البيانات المُرسَلة مهيّأةً بشكل فردي في كل نسخة OSCAR متصلة بـ Integrator بعينه، باستثناء الحالات التي يجب فيها إرسال قاعدة بيانات المرضى بأكملها إلى خادم Integrator؛ فلا تُرسَل سوى سجلات المرضى التي شوهدت منذ الدفع السابق إلى الخادم. والعملية ليست تمامًا كتحديث الفروق (delta patching)، لكنها قريبة منه.
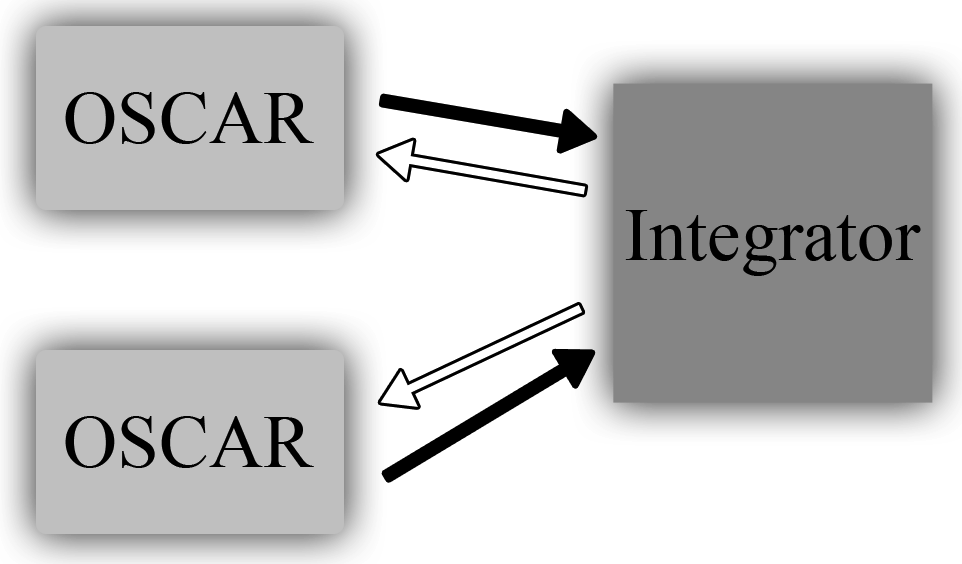 الشكل 16.1: تبادل البيانات بين نسخ OSCAR و Integrator
ولنفصل قليلًا في تفاصيل طريقة عمل Integrator من خلال مثال: عيادة بعيدة معاينة مريضًا من عيادة أخرى. وحين تريد تلك العيادة الوصول إلى سجل المريض، يجب أن تكون العيادتان قد تّصلتا من قبل بخادم Integrator نفسه. ويمكن لموظف الاستقبال أن يبحث في Integrator عن المريض البعيد (بالاسم، وبتاريخ الميلاد أو الجنس اختياريًا) فيجد سجله مخزَّنًا على الخادم. ثم يبدأ في نسخ مجموعة محدودة من المعلومات الديموغرافية للمريض، ثم يتحقّق مع المريض مرتين للتأكّد من موافقته على استرجاع سجله عبر استكمال استمارة موافقة. وبعد إتمامها، سيقدّم خادم Integrator كل ما يعرفه Integrator عن ذلك المريض—الملاحظات والوصفات الطبية والحساسية واللقاحات والمستندات، وهكذا. وتُخزَّن هذه البيانات في ذاكرة التخزين المؤقّت محليًا كي لا يضطر OSCAR المحلي إلى إرسال طلب إلى Integrator في كل مرة يريد فيها رؤية هذه البيانات، غير أن الذاكرة المؤقّتة المحلية تنتهي صلاحيتها كل ساعة.
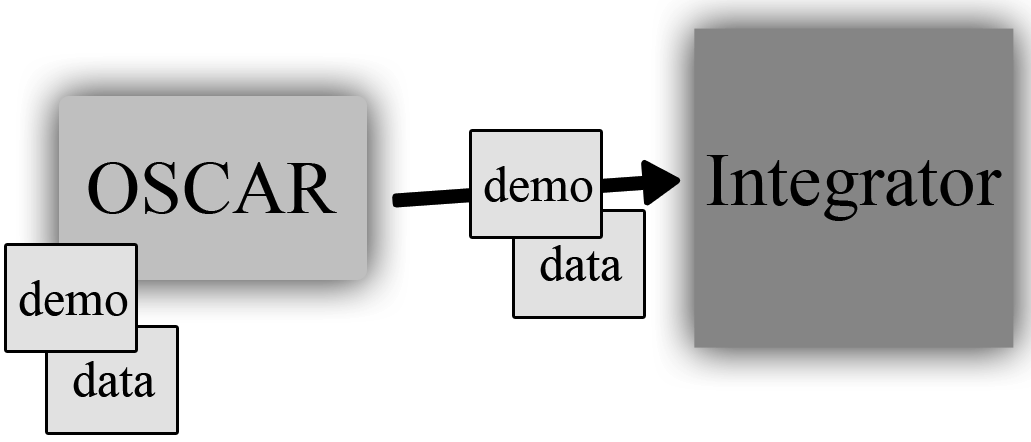 الشكل 16.2: تُرسَل المعلومات الديموغرافية وسائر البيانات المرتبطة بها إلى Integrator أثناء دفع بيانات من العيادة الأصلية. قد لا يكون السجل الموجود على Integrator تمثيلًا للسجل الكامل من العيادة الأصلية، إذ يمكن لـ OSCAR أن يختار عدم إرسال كل بيانات المريض.
بعد التهيئة الأولية لمريض بعيد عبر نسخ بياناته الديموغرافية إلى OSCAR المحلي، يُعدّ ذلك المريض كأي مريض آخر في النظام. وتُوسَم كل البيانات البعيدة المسترجعة من Integrator على هذا النحو (وتُدوَّن العيادة التي جاءت منها)، لكنها لا تُخزَّن إلا مؤقّتًا على OSCAR المحلي. وأي بيانات محلية يُسجَّلها النظام تُسجَّل تمامًا مثل أي بيانات مريض أخرى—تُضاف إلى سجل المريض وتُرسَل إلى Integrator—لكنها لا تُخزَّن بشكل دائم على أي جهاز بعيد.
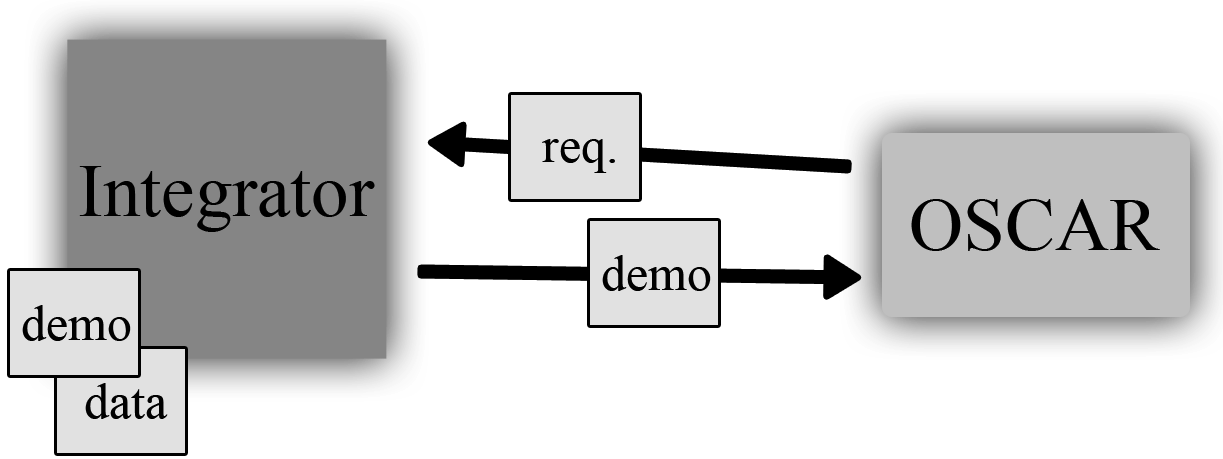 الشكل 16.3: يطلب OSCAR البعيد البيانات من Integrator بطلب سجل مريض بعينه. ويرسل خادم Integrator المعلومات الديموغرافية فقط، وهي مخزَّنة بشكل دائم على OSCAR البعيد.
وهذا له دلالة مهمّة إلى حدٍّ كبير، ولا سيما فيما يتعلق بموافقة المريض وكيفية تدخلها في تصميم Integrator. فلنفترض أن مريضًا يزور طبيبًا بعيدًا ويرضى بأن يتيح له ذلك الطبيب الوصول إلى سجله، لكن بشكل مؤقّت فقط. وبعد زيارته، يستطيع سحب موافقته لتلك العيادة من رؤية سجل ذلك المريض، وفي المرة التالية التي تفتح فيها تلك العيادة ملف المريض لن يجدوا هناك أي بيانات (باستثناء أي بيانات سُجّلت محليًا). وهذا يمنح المريض في نهاية المطاف تحكّمًا مباشرًا في كيفية عرض السجل ومتى، وهو مشابه لأن يدخل إلى عيادة حاملًا نسخة من ملفه الورقي. فيستطيع رؤية الملف أثناء تعامله معك، لكنك تأخذه معك إلى المنزل حين تغادر.
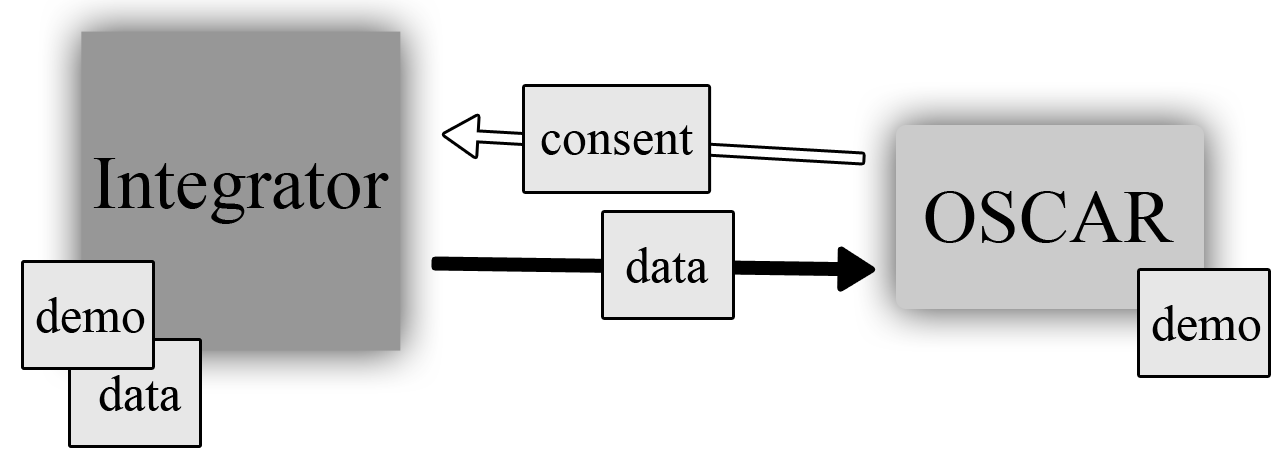 الشكل 16.4: تستطيع عيادة بعيدة رؤية محتوى ملف مريض بطلب البيانات؛ فإذا كانت الموافقة المناسبة موجودة، تُرسَل البيانات. ولا تُخزَّن البيانات بشكل دائم أبدًا على OSCAR البعيد.
ومن القدرات المهمّة جدًا الأخرى قدرة الأطباء على تحديد أنواع البيانات التي يريدون مشاركتها مع العيادات المتصلة الأخرى عبر خادم Integrator لديهم. فقد تختار عيادة مشاركة سجل ديموغرافي كامل أو أجزاء منه فقط، مثل الملاحظات دون المستندات، أو الحساسية دون الوصفات الطبية، وهكذا. وفي نهاية المطاف، الأمر يعود لمجموعة الأطباء الذين أعدّوا خادم Integrator ليقرّروا أنواع البيانات التي يطمئنّون إلى مشاركتها فيما بينهم.
وكما ذكرتُ سابقًا، فإنّ Integrator ليس سوى مستودع تخزين مؤقّت، ولا تُخزَّن أي بيانات فيه بشكل دائم أبدًا. وهذا قرار مهمّ جدًا آخر اتُّخذ أثناء التطوير؛ فهو يتيح للعيادات الانسحاب من مشاركة أي بيانات وكل البيانات عبر Integrator بسهولة كبيرة—بل وإن أمكن مسح قاعدة بيانات Integrator بالكامل. وإذا مُسحت قاعدة البيانات، فلن يلاحظ أي مستخدم لعميل ذلك إطلاقًا لأن البيانات ستُعاد بناؤها بدقة من البيانات الأصلية في جميع العملاء المتصلين. ومن ضمن ما ينتج عن ذلك أنّ مزوّد OSCAR يحتاج إلى الثقة بمزوّد Integrator بأنه مسح قاعدة البيانات حين يقول ذلك—لذا من الأفضل نشر Integrator لدى مجموعة أطباء موجودين أصلًا ضمن منظمة قانونية مثل منظمة صحة عائلية (Family Health Organization) أو فريق صحة عائلية (Family Health Team)؛ وسيُستضاف خادم Integrator في إحدى عيادات هؤلاء الأطباء.
صيغة البيانات
تُبنى مكتبات عميل Integrator عبر wsdl2java، الذي ينشئ مجموعة أصناف تمثّل أنواع البيانات المناسبة التي يتواصل بها خدمة الويب. وهناك أصناف لكل نوع بيانات، وكذلك أصناف تمثّل المفاتيح لكل واحد من أنواع البيانات هذه.
يُخرج وصف كيفية بناء مكتبة عميل Integrator من نطاق هذا الفصل. والمهمّ أن معرفته هي أنّه بعد بناء المكتبة، يجب إدراجها مع بقية ملفات JAR في OSCAR. ويحتوي ملف JAR هذا على كل ما يلزم لإعداد اتصال Integrator والوصول إلى جميع أنواع البيانات التي سيعيدها خادم Integrator إلى OSCAR، مثل CachedDemographic و CachedDemographicNote و CachedProvider، وغير ذلك كثير. وإلى جانب أنواع البيانات المُعادة، هناك أصناف «WS» تُستخدم أصلًا في استرجاع قوائم البيانات من هذا النوع— وأكثرها استخدامًا هو DemographicWs.
قد يكون التعامل مع بيانات Integrator عسيرًا أحيانًا. فلا يملك OSCAR أي شيء مدمج فعليًا للتعامل مع هذا النوع من البيانات، لذا ما يحدث عادةً هو أنه عند استرجاع نوع معيّن من بيانات المريض (مثل ملاحظات ملف المريض) يُطلب من عميل Integrator استرجاع البيانات من الخادم. ثم تُحوَّل تلك البيانات يدويًا إلى صنف محلي يمثّلها (في حالة الملاحظات، يكون CaseManagementNote). وتُضبط علامة منطقية داخل الصنف للدلالة على أن المحتوى من مصدر بعيد، وتُستخدم تلك العلامة لتغيير طريقة عرض البيانات للمستخدم على الشاشة. وفي الطرف المقابل، تتولّى CaisiIntegratorUpdateTask أخذ بيانات OSCAR المحلية، وتحويلها إلى صيغة بيانات Integrator، ثم إرسال تلك البيانات إلى خادم Integrator.
قد لا يكون هذا التصميم بكفاءة أو نظافة ما يمكن أن يكون عليه، لكنه يتيح فعلًا للأجزاء الأقدم من النظام أن تصبح «متوافقة» مع بيانات Integrator دون تعديل يُذكر. وإلى جانب ذلك، فإنّ إبقاء المشاهدة بأبسط صورة ممكنة عبر الإشارة إلى نوع واحد فقط من الأصناف يحسّن وضوح ملف JSP ويسهّل التنقيح عند حدوث خطأ.
16.7. الدروس المستفادة
كما يمكنك أن تتخيّل على الأرجح، لا يخلو OSCAR من نصيبه من المشكلات فيما يتعلق بالتصميم العام. لكنّه يقدّم مجموعة متكاملة من الميزات لن يعثر معظم المستخدمين فيها على أي مشكلات. وفي نهاية المطاف، هذا هو هدف المشروع: تقديم حلٍّ جيد يعمل في معظم المواقف.
لا أستطيع التحدث نيابةً عن مجتمع OSCAR بأكمله، لذا سيكون هذا القسم ذاتيًا إلى حدٍّ كبير ومن منظوري الشخصي. وأنا أرى أنّ هناك بعض الخلاصات المهمّة من النقاش المعماري حول المشروع.
أولًا، من الواضح أنّ سوء التحكّم بالمصدر في الماضي أدّى إلى أن تصبح معمارية النظام فوضوية إلى حدٍّ كبير في أجزاء منه، ولا سيما في المناطق التي تمتزج فيها المتحكمات بالمشاهد. ولم تكن طريقة إدارة المشروع في الماضي تمنع حدوث ذلك، لكنّ العملية تغيّرت منذ ذلك الحين، ونأمل ألّا نضطر إلى التعامل مع مشكلة كهذه مرة أخرى.
ثم إنّ المشروع قديم إلى حدٍّ كبير، لذا من الصعب ترقية المكتبات (أو حتى تغييرها) دون التسبّب في اضطراب كبير في قاعدة الشيفرة. وهذا بالضبط ما حدث. فكثيرًا ما أجد صعوبة في تحديد ما هو ضروري وما هو غير ضروري حين أنظر في مجلد المكتبات. وإلى جانب ذلك، فإنّ المكتبات أحيانًا ما تكسر التوافق العكسي عند خضوعها لترقيات كبيرة (وتغيير أسماء الحزم مخالفة شائعة). وكثيرًا ما تكون هناك عدة مكتبات مُدرَجة مع OSCAR تؤدّي جميعها المهمة نفسها—وهذا يعود إلى سوء التحكّم بالمصدر، إضافةً إلى عدم وجود قائمة أو توثيق يوضّح أي مكتبة يحتاجها أي مكوّن.
إضافةً إلى ذلك، لا يكاد OSCAR يكون مرنًا عند إضافة ميزات جديدة إلى الأنظمة الفرعية القائمة. فمثلًا، إن أردت إضافة مربع جديد إلى E-Chart، فسيلزمك إنشاء صفحة JSP جديدة وservlet جديد، وتخطيط E-Chart (في بضعة مواضع)، وتعديل ملف إعداد التطبيق كي يتمكّن servlet الخاص بك من التحميل.
ثم إنّ نقص التوثيق يجعّل أحيانًا من شبه المستحيل تحديد طريقة عمل جزء من النظام—فقد لا يكون المساهم الأصلي جزءًا من المشروع أصلًا في الوقت الحالي—وكثيرًا ما تكون الأداة الوحيدة التي لديك لتحديد ذلك هي مصحّح الأخطاء (debugger). وبكونه مشروعًا بهذه السن، فإنّ هذا يكلّف المجتمع فرصة إشراك مساهمين جدد. غير أنّه أمر تعمل عليه بصفة جماعية، فالمجتمع يعمل على معالجته.
وأخيرًا، فإنّ OSCAR مستودع للمعلومات الطبية، وأمنه مُضعَّف بسبب إدراج صنف DBHandler (ناقشناه في قسم سابق). وأنا أرى شخصيًا أنّ استعلامات قاعدة البيانات الحرة التي تقبل وسائط لا ينبغي أن تكون مقبولة أبدًا في نظام EMR لأنّ تنفيذ هجمات حقن SQL سهلاً إلى هذا الحد. وإنّ من الجيّد ألّا يُسمح بأي شيفرة جديدة تستخدم هذا الصنف، ينبغي أن تكون إزالة كل مواضع استخدامه أولوية لفريق التطوير.
قد يبدو كل ذلك نقدًا قاسيًا للمشروع. وفي الماضي كانت كل هذه المشكلات كبيرة، وكما قلت، فإنّها تمنع المجتمع من النمو بسبب ارتفاع حاجز الدخول إلى حدٍّ كبير. لكنّ هذا أمر يجري تغيّره، لذا في المستقبل لن تكون هذه المشكلات عائقًا إلى هذا الحدّ.
وإذا أعدنا النظر في تاريخ المشروع (وخاصةً في الإصدارات القليلة الماضية)، يمكننا الخروج بتصميم أفضل لطريقة بناء التطبيق. ولا يزال على النظام توفير مستوى أساسي من الوظائف (تفرضه حكومة أونتاريو شرطًا للشهادة بوصفه EMR)، لذا يجب أن يكون كل ذلك مدمجًا بشكل افتراضي. لكن إذا أُعيد تصميم OSCAR اليوم، فينبغي أن يُصمَّم على نحو معياري حقًّا يتيح التعامل مع الوحدات كإضافة (plugin)؛ فإذا لم تعجبك وحدة E-Form الافتراضية، يمكنك كتابة وحدتك الخاصة (أو حتى وحدة مختلفة تمامًا). وينبغي أن يتمكّن من التحدث إلى مزيد من الأنظمة (أو أن تتمكّن مزيد من الأنظمة من التحدث إليه)، بما في ذلك الأجهزة الطبية التي ترى استخدامها يتزايد في أنحاء القطاع، مثل أجهزة قياس حدة الإبصار. وهذا يعني أيضًا أنه سيكون من السهل تكييف OSCAR مع متطلّبات الحكومات المحلية والوطنية حول العالم في تخزين البيانات الطبية. ولأنّ كل منطقة لديها مجموعة مختلفة من القوانين والمتطلّبات، فإنّ هذا النمط من التصميم سيكون بالغ الأهمية لضمان تطوّر OSCAR نحو قاعدة مستخدمين عالمية.
وأعتقد أيضًا أنّ الأمن ينبغي أن يكون الميزة الأهمّ على الإطلاق. فليس نظام EMR أكثر أمانًا إلا بقدر أضعف مكوّن فيه، لذا ينبغي التركيز على تجريد أكبر قدر ممكن من الوصول إلى البيانات بعيدًا عن التطبيق بحيث يقوم بتخزين البيانات واسترجاعها في بيئة من نوع صندوق رمل (sandbox) عبر واجهة برمجية رئيسية لطبقة الوصول إلى البيانات دُقِّقت من طرف ثالث ووُجد أنها ملائمة لتخزين المعلومات الطبية. ويمكن لأنظمة EMR أخرى أن تختبئ خلف الغموض والشيفرة المملوكة كإجراء أمني (وهو ليس إجراءً أمنيًا في الواقع حقًا)، لكن OSCAR، بكونه مفتوح المصدر، ينبغي أن يقود المسيرة بحماية بيانات أفضل.
وأنا ألتزم إيمانًا راسخًا بمشروع OSCAR. ولدينا مئات المستخدمين الذين نعرفهم (والمئات الكثيرون الذين لا نعرفهم)، ونحصل على ملاحظات قيّمة من الأطباء الذين يتفاعلون مع مشروعنا على أساس يومي. ومن خلال تطوير عمليات وميزات جديدة، نأمل في توسيع قاعدة التثبيت ودعم المستخدمين من مناطق أخرى. ويقصدنا أن نتأكّد ممّا نسلّمه هو ما يحسّن حياة الأطباء الذين يستخدمون OSCAR وكذلك حياة مرضاهم، عبر إنشاء أدوات أفضل للمساعدة في إدارة الرعاية الصحية.