Open MPI
بنية تطبيقات المصادر المفتوحة (المجلد 2) Open MPI
بنية تطبيقات المصادر المفتوحة (المجلد 2) Open MPI
Jeffrey M. Squyres
إن استمتعت بهذه الكتب، فقد تستمتع أيضًا بـSoftware Design by Example in Python وSoftware Design by Example in JavaScript.
15.1. الخلفية
Open MPI GFB+04 هو تطبيق برمجي مفتوح المصدر لمعيار واجهة تمرير الرسائل (Message Passing Interface — MPI). وقبل أن تصبِح بنية Open MPI وتفاصيلها الداخلية مفهومة، لا بدّ من تقديم بعض الخلفية عن معيار MPI.
واجهة تمرير الرسائل (MPI)
يضع معيار MPI ويصونه مجلس MPI، وهو مجموعة مفتوحة تتألف من خبراء الحوسبة المتوازية من القطاعين الصناعي والأكاديمي معًا. ويحدد MPI واجهة برمجية (API) تُستخدم لنوع محدد من الاتصال بين العمليات (IPC) يكون محمولًا وعالي الأداء: وهو تمرير الرسائل (message passing). وبعبارة أدق، تصف وثيقة MPI النقل الموثوق للرسائل المتفرّقة ذات الأنواع المحددة بين عمليات MPI. ورغم أن تعريف «عملية MPI» يخضع للتفسير بحسب المنصة، إلا أنه يقابل عادةً مفهوم العملية في نظام التشغيل (مثل عملية POSIX). وقد قُصد أن يُنفَّذ MPI تحديدًا كطبقة وسيطة (middleware)، أي أن التطبيقات في المستويات الأعلى تستدعي دوال MPI لإتمام تمرير الرسائل.
يحدد MPI واجهة برمجية عالية المستوى، أي أنه يحجب كل وسيلة نقل كامنة تُستخدم فعليًا لتمرير الرسائل بين العمليات. والفكرة أن العملية المرسِلة X تستطيع أن تقول بصورة فعّالة: «خذ مصفوفة من 1,073 قيمة بدقّة مزدوجة وأرسلها إلى العملية Y». فتقول العملية المستلِمة Y مقابلةً: «استقبل مصفوفة من 1,073 قيمة بدقّة مزدوجة من العملية X». وعندئذٍ تقع المعجزة، وتصل مصفوفة الـ1,073 قيمة بدقّة مزدوجة إلى مخزن الانتظار في Y.
لاحظ ما هو غائب عن هذا التبادل: لا وجود لمفهوم اتصال ينشأ، ولا تدفّق بايتات يحتاج إلى تفسير، ولا عناوين شبكية تُتبادل. يحجب MPI ذلك كله، ليس لإخفاء هذا التعقيد عن التطبيق في المستويات الأعلى فحسب، بل أيضًا لجعل التطبيق محمولًا عبر مختلف البيئات ووسائل نقل تمرير الرسائل الكامنة. وتحديدًا، فإن تطبيق MPI صحيح يكون متوافقًا على مستوى الشيفرة المصدرية عبر مجموعة واسعة جدًا من المنصات وأنواع الشبكات.
لا يحدد MPI الاتصال من نقطة إلى نقطة (مثل الإرسال والاستقبال) فحسب، بل يحدد أيضًا أنماط اتصال أخرى، مثل الاتصال الجماعي (collective). والعمليات الجماعية هي تلك التي تشارك فيها عمليات متعددة في إجراء اتصال واحد. فالبث الموثوق (reliable broadcast)، على سبيل المثال، هو أن تكون لدى عملية واحدة رسالة في بداية العملية، وفي نهايتها تكون لدى جميع العمليات في المجموعة الرسالة نفسها. ويحدد MPI أيضًا مفاهيم وأنماط اتصال أخرى لم تتناولها هذه الفقرة. (وحتى وقت كتابة هذا الكتاب، فإن أحدث إصدار من معيار MPI هو MPI-2.2 For09. وقد نُشرت نسخ مسوّدة من معيار MPI-3 القادم، وقد يكتمل في وقت مبكر من أواخر عام 2012.)
استخدامات MPI
هناك تطبيقات كثيرة لمعيار MPI تدعم تشكيلة واسعة من المنصات وأنظمة التشغيل وأنواع الشبكات. بعضها مفتوح المصدر وبعضها مغلق المصدر. وOpen MPI، كما يدل اسمها، إحدى تلك التطبيقات مفتوحة المصدر. وتشمل شبكات نقل MPI المعتادة (على سبيل المثال لا الحصر): بروتوكولات متنوعة فوق Ethernet (مثل TCP وiWARP وUDP وإطارات Ethernet الخام وغيرها)، والذاكرة المشتركة، وInfiniBand.
تُستخدم تطبيقات MPI عادةً في ما يُسمى بيئات «الحوسبة عالية الأداء» (high-performance computing — HPC). ويوفّر MPI آلية الاتصال بين العمليات (IPC) لدوال المحاكاة (simulation)، والخوارزميات الحسابية، وسائر أنواع التطبيقات التي تعتصر «الأعداد الضخمة» (big number crunching). ومجموعات بيانات الإدخال التي تعمل عليها هذه الأكواد تمثّل عادةً قدرًا من العمل الحسابي يفوق طاقة خادم واحد؛ إذ تُوزَّع مهام MPI على عشرات أو مئات أو حتى آلاف الخوادم، وكلها تعمل بانسجام لحل مسألة حسابية واحدة.
بمعنى آخر، فإن التطبيقات التي تستخدم MPI متوازية بطبيعتها وشديدة الإسناد إلى الحوسبة (compute-intensive). وليس من غير المألوف أن تعمل كل أنوية المعالجات في مهمة MPI بنسبة استغلال 100%. وللتوضيح، فإن مهام MPI تعمل عادةً في بيئات مخصّصة تكون فيها عمليات MPI هي التطبيق الوحيد الذي يعمل على الجهاز (إضافةً بالطبع إلى وظائف نظام التشغيل الأساسية وحدها).
وعليه، تركز تطبيقات MPI عادةً على توفير أداء شديد الارتفاع، يُقاس بمقاييس مثل:
- زمن استجابة شديد الانخفاض (extremely low latency) لتمرير الرسائل القصيرة. فمثلًا يمكن إرسال رسالة ذات بايت واحد من عملية Linux على مستوى المستخدم في خادم، عبر مفتاح من InfiniBand، واستقبالها في عملية Linux المستهدفة على مستوى المستخدم في خادم آخر، في أقل من ميكروثانية (microsecond) واحدة بقليل (أي 0.000001 ثانية).
- معدل حقن رسائل شديد الارتفاع في الشبكة للرسائل القصيرة. فبعض المورّدين لديهم تطبيقات MPI (اقترنة بأجهزة محدّدة) تستطيع حقن ما يصل إلى 28 مليون رسالة في الثانية داخل الشبكة.
- تصاعد سريع (كدالة في حجم الرسالة) حتى بلوغ النطاق الترددي الأقصى الذي تدعمه وسيلة النقل الكامنة.
- انخفاض في استهلاك الموارد. فجميع الموارد التي يستخدمها MPI (مثل الذاكرة والتخزين المؤقت (cache) ونطاق تردد الناقل (bus)) لا يمكن للتطبيق استخدامها. ولذلك تحاول تطبيقات MPI الحفاظ على توازن بين انخفاض استهلاك الموارد مع الاستمرار في توفير أداء عالٍ.
مشروع Open MPI
نُشر الإصدار الأول من معيار MPI، وهو MPI-1.0، عام 1994 Mes93. واكتمل MPI-2.0، وهو مجموعة إضافات فوق MPI-1، عام 1996 GGHL+96.
في العقد الأول بعد نشر MPI-1، ظهرت تشكيلة متنوعة من تطبيقات MPI. فقدّم كثير منها مورّدون من أجل شبكاتهم المترابطة الخاصة. وظهرت تطبيقات كثيرة أخرى من مجتمعات البحث والأكاديمية، وكانت هذه التطبيقات عادةً «بمستوى البحث»، أي أن الغرض منها استكشاف مفاهيم الشبكات عالية الأداء المختلفة وتقديم إثباتات للمفهوم (proofs-of-concept) لعملها. غير أن بعضها بلغ من الجودة حدًّا كفى لنيل الشعبية وعدد من المستخدمين.
يمثّل Open MPI اتحاد أربع تطبيقات MPI مفتوحة المصدر من مجتمعات البحث والأكاديمية: LAM/MPI وLA/MPI (Los Alamos MPI) وFT-MPI (Fault-Tolerant MPI). وانضم أعضاء فريق PACX-MPI إلى مجموعة Open MPI بعد إنشائها بوقت قصير.
قرر أعضاء فرق التطوير الأربعة أن يتعاونوا حين أدركنا جميعًا أن باستثناء فروق طفيفة في تحسينات وميزات، فإن قواعد شيفرتنا البرمجية متشابهة إلى حد كبير. فلكلٍّ من القواعد الأربعة نقاط قوته وضعفه، لكنها بصفة عامة تفعل الأمور نفسها تقريبًا. فلماذا نتنافس؟ ولمَ لا نجمع مواردنا، ونعمل معًا، ونصنع تنفيذًا لـMPI أفضل؟
بعد نقاش طويل، اتُّخذ قرار بالتخلي عن قواعد الشيفرة الأربع القائمة، والاحتفاظ بأفضل الأفكار من المشاريع السابقة. وكان هذا القرار قائمًا أساسًا على الافتراضات التالية:
- رغم تشابه كثير من الخوارزميات والتقنيات الكامنة بين القواعد الأربعة، فإن لكل منها بنيات تنفيذ مختلفة جذريًا، وستكون الدمج بينها صعبة للغاية (إن لم يكن مستحيلًا).
- ولكلٍّ من الأربعة أيضًا نقاط قوة (جوهرية) ونقاط ضعف (جوهرية) خاصة به. وتحديدًا، كانت هناك ميزات وقرارات معمارية في كلٍّ من الأربعة جديرة بالاحتفاظ بها. وعلى نحو مماثل، كانت هناك شيفرة رديئة التحسين والتصميم في كلٍّ من الأربعة جديرة بالتخلّي عنها.
- لم يكن أعضاء مجموعات التطوير الأربع قد عملوا معًا مباشرة من قبل. والبدء بقاعدة شيفرة جديدة تمامًا (بدلًا من تطوير إحدى القواعد القائمة) يضع جميع المطورين على قدم المساواة.
وهكذا وُلد Open MPI. وكان أول التزام (commit) في Subversion يوم 22 نوفمبر 2003.
15.2. البنية
لأسباب عديدة (تتعلق في معظمها بالأداء أو بقابلية النقل)، لم يكن هناك سوى خيارين ممكنين كلغة التنفيذ الأساسية: C وC++. وقد استُبعدت C++ في النهاية لأن مُصرِّفات C++ المختلفة تميل إلى ترتيب الهياكل (structs) والأصناف (classes) في الذاكرة وفق خوارزميات تحسين مختلفة، مما يؤدي إلى تمثيلات شبكية مختلفة على السلك (on-the-wire). لذلك اختيرت C كلغة التنفيذ الأساسية، وهو ما أثّر في عدة قرارات في التصميم المعماري.
وعُدنا بُدء Open MPI، كنا نعلم أنه سيكون قاعدة شيفرة كبيرة ومعقّدة:
- في عام 2003، كان الإصدار الحالي من معيار MPI، وهو MPI-2.0، يعرّف أكثر من 300 دالة API.
- كان كل مشروع من المشاريع الأربعة السابقة كبيرًا بذاته. فمثلًا، كان LAM/MPI يضم أكثر من 1,900 ملف شيفرة مصدرية، ما مجموعه أكثر من 300,000 سطر شيفرة (بما في ذلك التعليقات والأسطر الفارغة).
- أردنا أن يدعم Open MPI ميزات وبيئات وشبكات أكثر مما دعمته المشاريع الأربعة السابقة مجتمعةً.
لذلك أمضينا وقتًا طويلًا في تصميم بنية تركز على ثلاثة أمور:
- تجميع الوظائف المتشابهة معًا في طبقات تجريد متمايزة.
- استخدام إضافات قابلة للتحميل في وقت التشغيل (plugins) ومعاملات في وقت التشغيل للاختيار بين تنفيذات متعددة مختلفة للسلوك نفسه.
- عدم السماح للتجريد (abstraction) بأن يعوق الأداء.
بنية طبقات التجريد
يمتلك Open MPI ثلاث طبقات تجريد رئيسية، كما هو مبين في الشكل 15.1:
- طبقة الوصول المفتوحة المحمولة (Open, Portable Access Layer — OPAL): OPAL هي الطبقة السفلى من تجريدات Open MPI. وتركز تجريداتها على العمليات المفردة (بدلًا من المهام المتوازية). وهي تقدّم شيفرة خدمات وشفرة لاصقة (glue code) مثل القوائم المترابطة العامة، ومعالجة النصوص، وضوابط التنقيح، وغيرها من الوظائف العادية—والمفيدة مع ذلك—. كما تقدّم OPAL قابلية النقل الأساسية لـOpen MPI بين أنظمة التشغيل المختلفة، مثل اكتشاف واجهات IP، ومشاركة الذاكرة بين العمليات على الخادم نفسه، وتثبيت المعالج والذاكرة (affinity)، والمؤقتات عالية الدقة، وغيرها.
- بيئة تشغيل Open MPI (Open MPI Run-Time Environment — ORTE) (تُنطق «or-tay»): يجب أن يوفّر تنفيذ MPI، ليس فقط واجهة تمرير الرسائل المطلوبة، بل أيضًا نظام تشغيل مرافقًا لإطلاق المهام المتوازية ومراقبتها وإنهائها. وفي حالة Open MPI، تتألف المهمة المتوازية من عملية واحدة أو أكثر قد تمتد عبر نسخ متعددة من أنظمة التشغيل، وتُربط معًا لتعمل كوحدة واحدة متماسكة. وفي البيئات البسيطة التي تفتقر إلى دعم حوسبة موزّعة أو تكتفي به، تستخدم ORTE الأداتين
rshأوsshلإطلاق العمليات الفردية في المهام المتوازية. أما البيئات الأكثر تقدّمًا والمخصّصة لـHPC فعادةً ما تملك مجدوِلَات (schedulers) ومديري موارد لتوزيع الموارد الحسابية بإنصاف بين عدد كبير من المستخدمين. وتوفّر هذه البيئات عادةً واجهات برمجية متخصّصة لإطلاق العمليات وتنظيمها على خوادم الحوسبة. تدعم ORTE تشكيلة واسعة من هذه البيئات المُدارة، مثل (على سبيل المثال لا الحصر): Torque/PBS Pro وSLURM وOracle Grid Engine وLSF. - Open MPI (OMPI): طبقة MPI هي أعلى طبقات التجريد، وهي الوحيدة المكشوفة للتطبيقات. تُنفَّذ واجهة MPI البرمجية في هذه الطبقة، وكذلك كل دلالات تمرير الرسائل التي يعرّفها معيار MPI. وبما أن قابلية النقل متطلب أساسي، فإن طبقة MPI تدعم تشكيلة واسعة من أنواع الشبكات والبروتوكولات الكامنة. فبعض الشبكات متشابه في خصائصها وتجريداتها الكامنة، وبعضها لا.
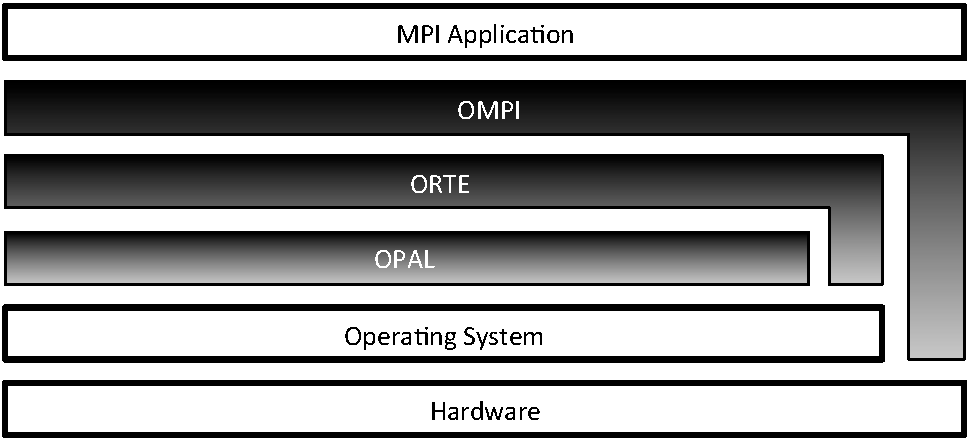 الشكل 15.1: منظور معماري بطبقات التجريد لـOpen MPI يُظهر طبقاته الرئيسية الثلاث: OPAL وORTE وOMPI
رغم أن كل طبقة تجريد مبنية فوق التي تليها، فإن طبقي ORTE وOMPI بإمكانهما، لأسباب تتعلق بالأداء، تجاوز طبقات التجريد الكامنة والتفاعل مباشرة مع نظام التشغيل و/أو العتاد عند الحاجة (كما هو مبين في الشكل 15.1). فمثلًا تستخدم طبقة OMPI أساليب تجاوز نظام التشغيل (OS-bypass) للتواصل مع أنواع معينة من عتاد بطاقات الشبكة (NIC) بغية تحقيق أقصى أداء شبكي.
تُبنى كل طبقة في مكتبة مستقلة قائمة بذاتها. تعتمد مكتبة ORTE على مكتبة OPAL؛ تعتمد مكتبة OMPI على مكتبة ORTE. وقد أثبت فصل الطبقات في مكتبات خاصة بها أنه أداة ممتازة لمنع انتهاكات التجريد. وتحديدًا، سيفشل التطبيق في الربط (link) إذا حاولت إحدى الطبقات على خطأ استخدام رمز (symbol) في طبقة أعلى. وعلى مدى السنوات، حما هذه الآليةُ لفرض التجريد كثيرًا من المطورين من تمويه حدود الطبقات الثلاث دون قصد.
بنية الإضافات
رغم أن الأعضاء الأوائل في تعاون Open MPI تشتركوا في هدف أساسي مماثل (إنتاج تنفيذ محمول عالي الأداء لمعيار MPI)، فإن خلفياتنا التنظيمية وآرائنا وجداول أعمالنا كانت—ولا تزال—متباينة إلى حد بعيد. لذلك أمضينا وقتًا لا بأس به في تصميم بنية تتيح لنا أن نختلف، حتى مع تشركنا في قاعدة شيفرة مشتركة.
كانت المكوّنات (components) القابلة للتحميل في وقت التشغيل خيارًا طبيعيًا (بمعنى آخر: كائنات مشتركة ديناميكية (dynamic shared objects)، أو «DSOs»، أو «إضافات»). تفرض المكوّنات واجهة برمجية مشتركة لكنها تضع قيودًا قليلة على تنفيذ تلك الواجهة. وتحديدًا: يمكن تنفيذ سلوك الواجهة نفسها بطرق متعددة مختلفة. ثم يستطيع المستخدمون أن يختاروا، في وقت التشغيل، أي إضافة (أو إضافات) يستخدمونها. وهذا يتيح حتى لأطراف أخرى تطوير إضافات Open MPI الخاصة بها وتوزيعها بصورة مستقلة خارج حزمة Open MPI الأساسية. والسماح بقابلية التوسّع العشوائية سياسة مُحرِّرة إلى حد كبير، سواء داخل مجموعة مطوّري Open MPI المباشرة أو في مجتمع Open MPI الأوسع.
هذه المرونة في وقت التشغيل عنصر أساسي في فلسفة تصميم Open MPI، وهي مدمجة بعمق في البنية بأكملها. ومن أوضح الأمثلة أن سلسلة Open MPI v1.5 تضم 155 إضافة. ولعدّ أمثلة قليلة فحسب، هناك إضافات لتطبيقات memcpy() المختلفة، وإضافات لكيفية إطلاق العمليات على الخوادم البعيدة، وإضافات لكيفية التواصل عبر مختلف أنواع الشبكات الكامنة.
ومن أبرز فوائد استخدام الإضافات أن مجموعات متعددة من المطورين تظل حرّة في تجريب تنفيذات بديلة دون التأثير في جوهر Open MPI. كانت هذه ميزة جوهرية، ولا سيما في الأيام الأولى لمشروع Open MPI. أحيانًا لم يكن المطورون يعرفون على وجه اليقين الطريقة الصحيحة لتنفيذ شيء ما، وأحيانًا كان يختلفون فحسب. وفي الحالتين، ينفّذ كل طرف حلّه في مكوّن، مما يتيح لبقية مجتمع المطورين المقارنة والتباين بسهولة. ويمكن إجراء مقارنات الشيفرة بغير المكوّنات بالطبع، لكن مفهوم المكوّن يساعد على ضمان أن تعرض جميع التنفيذات الواجهة الخارجية نفسها تمامًا، وبالتالي تقدم الدلالات المطلوبة نفسها تمامًا.
وك نتيجة مباشرة للمرونة التي يوفّرها، يُستخدم مفهوم المكوّنات على نطاق واسع في الطبقات الثلاث جميعًا؛ فكل طبقة تضم أنواعًا كثيرة مختلفة من المكوّنات. ويُحاط كل نوع من المكوّنات بـإطار (framework). ينتمي المكوّن إلى إطار واحد بالضبط، ويدعم كل إطار نوعًا واحدًا فقط من المكوّنات. والشكل 15.2 هو قالب للبنية المعمارية لـOpen MPI؛ إذ يعرض بعض أطر Open MPI وبعض المكوّنات التي تحتوي عليها. (أما بقية أطر Open MPI ومكوّناته فيُرتَّب على نحو مماثل.) ويُشار إلى مجموعة Open MPI من الطبقات والأطر والمكوّنات تلك بالبنية المعيارية للمكوّنات (Modular Component Architecture — MCA).
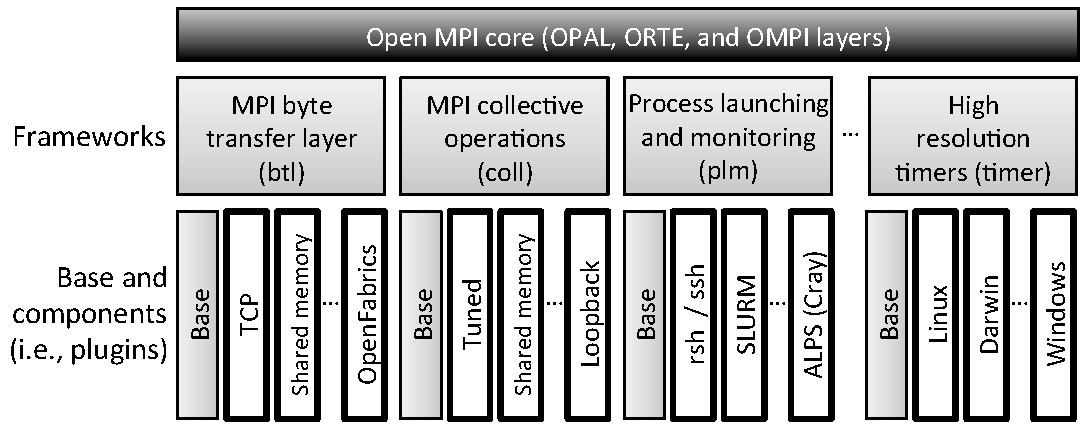 الشكل 15.2: منظور معماري لأطر Open MPI، يعرض مجرد بعض أطر Open MPI ومكوّناتها (أي إضافاتها). يحتوي كل إطار على قاعدة (base) ومكوّن واحد أو أكثر. وهذه البنية مكرَّرة في كل طبقة من الطبقات المبيّنة في الشكل 15.1. والأطر النموذجية المذكورة في هذا الشكل موزّعة على الطبقات الثلاث جميعًا:
btl وcoll في طبقة OMPI، وplm في طبقة ORTE، وtimer في طبقة OPAL.
وأخيرًا، تتمثل ميزة رئيسية أخرى لاستخدام الأطر والمكوّنات في قابلية تركيبها المتأصلة. ومع وجود أكثر من 40 إطارًا في Open MPI v1.5، فإن منح المستخدمين القدرة على مزج ومطابقة إضافات مختلفة من أنواع مختلفة يتيح لهم إنشاء حزمة برمجية مصمّمة فعليًا لأنظمتهم الفردية.
أطر الإضافات
كل إطار مكتتفٍ بذاته تمامًا داخل دليل فرعي خاص به في شجرة شيفرة Open MPI. واسم الدليل الفرعي هو اسم الإطار نفسه؛ فمثلًا، إطار memory موجود في المجلد memory. وتحتوي مجلدات الأطر على العناصر الثلاثة التالية على الأقل:
- تعريف واجهة المكوّن: يوجد ملف ترويسة (header file) باسم
.hفي دليل الإطار الأعلى مستوىً (على سبيل المثال، يحتوي إطار Memory علىmemory/memory.h). ويعرّف ملف الترويسة هذا المعروف الواجهات التي يجب أن يدعمها كل مكوّن في الإطار. ويتضمن هذا الترويسة تعريفات أنواع (typedefs) لمؤشرات الدوال الخاصة بدوال الواجهة، وهياكل (structs) لتغليف (marshaling) هذه المؤشرات، وأي أنواع أو حقول سمات أو ماكروهات أو إقرارات أخرى لازمة. - الشيفرة الأساسية: يحتوي الدليل الفرعي
baseعلى شيفرة اللاصقة التي توفّر الوظائف الأساسية للإطار. فمثلًا، دليل قاعدة إطارmemoryهوmemory/base. وتتكون القاعدة عادةً من أعمال لوجستية مملة كالعثور على المكوّنات وفتحها في وقت التشغيل، ووظائف خدمات مشتركة قد يستخدمها أكثر من مكوّن، إلخ. - المكوّنات: يُفترض أن جميع الأدلة الفرعية الأخرى في دليل الإطار هي مكوّنات. ومثل الإطار تمامًا، فإن أسماء المكوّنات هي نفسها أسماء أدلتها الفرعية (فمثلًا، يحتوي الدليل الفرعي
memory/posixعلى مكوّن POSIX في إطار Memory).
ومثلما يعرّف كل إطار الواجهات التي يجب أن تلتزم بها مكوّناته، فإن الأطر تعرّف أيضًا جوانب تشغيلية أخرى، مثل كيفية تهيئة نفسها (bootstrap)، وكيف تختار المكوّنات التي تستخدمها، وكيف يُنهى عملها. ومن الأمثلة الشائعة على اختلاف الأطر في إعدادها: الأطر «متعددة-المتعددة» (many-of-many) في مقابل الأطر «واحدة-من-متعددة» (one-of-many)، والأطر الساكنة (static) في مقابل الديناميكية.
الأطر متعددة-المتعددة (many-of-many).
توجد أطر يمكن تنفيذ وظائفها بطرق متعددة مختلفة داخل العملية نفسها. فمثلًا، سيحمّل إطار الشبكة من نقطة إلى نقطة في Open MPI إضافات مشغّلات (driver plugins) متعددة لتتيح لعملية واحدة إرسال الرسائل واستقبالها عبر أنواع شبكات متعددة.
تفتح هذه الأطر عادةً جميع المكوّنات التي تستطيع العثور عليها ثم تستعلم كل مكوّن، أي تسأله عمليًا: «هل تريد أن تعمل؟». وتقرّر المكوّنات ما إذا كانت تريد العمل بفحص النظام الذي تعمل عليه. فمثلًا، سينظر مكوّن شبكة من نقطة إلى نقطة ليتأكد من أن نوع الشبكة الذي يدعمه متاح ونشِط في النظام معًا. وإن لم يكن كذلك، فسيرد المكوّن: «لا، لا أريد أن أعمل»، مما يدفع الإطار إلى إغلاق ذلك المكوّن وإلغاء تحميله. وإذا كان نوع الشبكة ذلك متاحًا، فسيرد المكوّن: «نعم، أريد أن أعمل»، مما يدفع الإطار إلى إبقاء المكوّن مفتوحًا لاستخدامه لاحقًا.
الأطر الواحد-من-المتعددة (one-of-many).
تقدّم أطر أخرى وظائف لا معنى لأن يتوفّر لها أكثر من تنفيذ واحد في وقت التشغيل. فمثلًا، يجب أن يتم إنشاء نقطة تفتيش متسقة (consistent checkpoint) لمهمة متوازية—بمعنى أن المهمة تُجمَّد فعليًا ويمكن استئنافها في وقت لاحق بشكل تعسفي—باستخدام نظام نقاط تفتيش خلفي (back-end) واحد لكل عملية في المهمة. والإضافة التي تربط واجهتها بنظام نقاط التفتيش الخلفي المطلوب هي الإضافة الوحيدة لنقاط التفتيش التي يجب تحميلها في كل عملية—أما غيرها فغير ضرورية.
الأطر الديناميكية.
تسمح معظم الأطر بتحميل مكوّناتها في وقت التشغيل عبر DSOs. وهذه هي أكثر الطرق مرونة للعثور على المكوّنات وتحميلها؛ إذ تتيح ميزات مثل تحمّل عدم تحميل مكوّنات بعينها، وتحميل مكوّنات من أطراف أخرى لم تكن ضمن التوزيعة الأساسية لـOpen MPI، إلخ.
الأطر الساكنة.
تحدّ بعض أطر «الواحد-من-المتعدد» بقيود إضافية تفرض اختيار مكوّنها الوحيد وقت الترجمة (compile time) بدلًا من وقت التشغيل. ويسمح الربط الساكن لمكوّنات «الواحد-من-المتعدد» بالاستدعاء المباشر لدوالها الأعضاء (بدلًا من الاستدعاء عبر مؤشر دالة)، وقد يكون ذلك مهمًا في الوظائف شديدة الحساسية للأداء. ومن أمثلتها إطار memcpy الذي يوفّر تطبيقات memcpy() محسّنة لكل منصة.
إلى ذلك، توفّر بعض الأطر وظائف قد يلزم استخدامها قبل اكتمال تهيئة Open MPI. فمثلًا، تتطلب بعض حزم الشبكات نماذج تسجيل ذاكرة معقّدة، وهو ما يستلزم بدوره استبدال routines إدارة الذاكرة الافتراضية في مكتبة C. ولأن إدارة الذاكرة متأصلة في العملية بأكملها، فإن استبدال النظام الافتراضي لا يمكن أن يتم إلا قبل main. لذلك يجب ربط هذه المكوّنات ربطًا ساكنًا داخل عمليات Open MPI حتى تتاح لخطافات ما قبل main، قبل أن تكون MPI قد هُيّئت أصلًا.
مكوّنات الإضافات
تنقسم إضافات Open MPI إلى جزأين: هيكل مكوّن (component struct) وهيكل وحدة (module struct). ويُشار عادةً جماعيًا إلى هيكل المكوّن والدوال التي يشير إليها بـ«المكوّن». وعلى نحو مماثل، يُشار جماعيًا إلى «الوحدة» إلى هيكل الوحدة ودوالها. وهذا التقسيم يشبه إلى حد ما تقسيم أصناف C++ إلى أصناف وكائنات. لا يوجد سوى مكوّن واحد لكل عملية؛ وهو يصف الإضافة إجمالًا بحقلات مشتركة بين جميع المكوّنات (بغضّ النظر عن الإطار). وإذا اختار المكوّن أن يعمل، فيُستخدم لتوليد وحدة أو أكثر، تنفّذ عادةً الجزء الأكبر من الوظائف التي يتطلبها الإطار.
طوال الأقسام التالية القليلة، سنبني البنى اللازمة لمكوّن TCP في إطار BTL (طبقة نقل البايتات). ويقوم إطار BTL بعمليات نقل الرسائل من نقطة إلى نقطة؛ ومكوّن TCP، كما هو متوقّع تمامًا، يستخدم TCP كوسيلة نقل كامنة له في تمرير الرسائل.
هيكل المكوّن.
بغضّ النظر عن الإطار، يحتوي كل مكوّن على هيكل مكوّن معروف جيدًا ومُوزَّع بشكل ساكن ومُهيّأ كذلك. ويجب أن يكون اسم الهيكل وفق القالب mca___component. فمثلًا، هيكل مكوّن مشغّل شبكة TCP في إطار BTL يسمى mca_btl_tcp_component.
استخدام رموز المكوّنات وفق قالب يضمن عدم وقوع تصادم في الأسماء بين المكوّنات، ويتيح في الوقت نفسه لنواة MCA العثور على أي هيكل مكوّن اعتباطي عبر dlsym(2) (أو ما يماثله في كل نظام تشغيل مدعوم).
يحتوي هيكل المكوّن الأساسي على بعض المعلومات اللوجستية، مثل الاسم الرسمي للمكوّن، وإصداره، والتزامه بإصدار الإطار، إلخ. وتُستخدم هذه البيانات لأغراض التنقيح، ولإعداد الجرد، وللفحص في وقت التشغيل من حيث الامتثال والتوافق.
struct mca_base_component_2_0_0_t {
    /* Component struct version number */
    int mca_major_version, mca_minor_version, mca_release_version;

    /* The string name of the framework that this component belongs to,
       and the framework's API version that this component adheres to */
    char mca_type_name[MCA_BASE_MAX_TYPE_NAME_LEN + 1];
    int mca_type_major_version, mca_type_minor_version,
        mca_type_release_version;

    /* This component's name and version number */
    char mca_component_name[MCA_BASE_MAX_COMPONENT_NAME_LEN + 1];
    int mca_component_major_version, mca_component_minor_version,
        mca_component_release_version;

    /* Function pointers */
    mca_base_open_component_1_0_0_fn_t mca_open_component;
    mca_base_close_component_1_0_0_fn_t mca_close_component;
    mca_base_query_component_2_0_0_fn_t mca_query_component;
    mca_base_register_component_params_2_0_0_fn_t
        mca_register_component_params;
};
إن هيكل المكوّن الأساسي هو جوهر مكوّن TCP BTL؛ فهو يحتوي على مؤشرات الدوال التالية:
- الفتح (open). نداء open هو دالة الاستعلام الأولية التي تُستدعى على المكوّن. فهي تتيح للمكوّن أن يهيّئ نفسه، وأن يستكشف النظام الذي يعمل فيه، وأن يقرّر ما إذا كان يريد أن يعمل. وإذا كان المكوّن يستطيع العمل دائمًا، فيمكنه توفير مؤشر دالة
NULLللدالة open. وتقوم دالة open في مكوّن TCP BTL أساسًا بتهيئة بعض بنى البيانات والتأكد من أن المستخدم لم يحدّد معاملات غير صالحة. - الإغلاق (close). عندما يقرّر إطار أن المكوّن لم يعد مطلوبًا، فإنه يستدعي الدالة close لتتيح للمكوّن تحرير أي موارد خصّصها. وتُستدعى دالة close على جميع المكوّنات المتبقية عند إغلاق العمليات. غير أنه يمكن أيضًا استدعاء close على المكوّنات المرفوضة في وقت التشغيل بحيث تُغلق وتُهمَل طوال مدة العملية. وتقوم دالة close في مكوّن TCP BTL بإغلاق مقابس الاستماع (listening sockets) وتحرير الموارد (مثل مخازن الاستقبال).
- الاستعلام (query). هذا النداء دالة معمَّمة من نوع «هل تريد أن تعمل؟». ولا تستخدم جميع الأطر هذا النداء بعينه—فبعضها يحتاج دوال استعلام أكثر تخصّصًا. ولا يستخدم إطار BTL الدالة العامة query (فهو يعرّف دالته الخاصة؛ انظر أدناه)، ولذلك لا يملأ TCP BTL حقلها.
- تسجيل المعاملات. هذه الدالة عادةً هي أول دالة تُستدعى على المكوّن. فهي تتيح للمكوّن تسجيل أي معاملات وقت تشغيل ذات صلة يمكن للمستخدم ضبطها. وتُناقَش معاملات وقت التشغيل بمزيد من التفصيل أدناه. وتُنشئ دالة register في مكوّن TCP BTL تشكيلة متنوعة من معاملات وقت التشغيل التي يمكن للمستخدم ضبطها، مثل معامل يتيح للمستخدم تحديد واجهة أو واجهات IP التي يريد استخدامها.
يمكن أيضًا توسيع بنية المكوّن على أساس كل إطار و/أو كل مكوّن. فعادةً ما تُنشئ الأطر هيكل مكوّن جديدًا يكون فيه هيكل المكوّن الأساسي هو العضو الأول. ويتيح هذا التداخل للأطر أن تضيف سماتها ومؤشرات دوالها الخاصة. فمثلًا، يمكن لإطار يحتاج دالة استعلام أكثر تخصّصًا (مقارنةً بالدالة query المتاحة في المكوّن الأساسي) أن يضيف مؤشر دالة في هيكل المكوّن الخاص به.
ويستخدم إطار btl الخاص بـMPI، الذي يوفّر وظائف المراسلة من نقطة إلى نقطة في MPI، هذه التقنية.
struct mca_btl_base_component_2_0_0_t {
    /* Base component struct */
    mca_base_component_t btl_version;
    /* Base component data block */
    mca_base_component_data_t btl_data;

    /* btl-framework specific query functions */
    mca_btl_base_component_init_fn_t btl_init;
    mca_btl_base_component_progress_fn_t btl_progress;
};
كمثال على دوال الاستعلام في إطار TCP BTL، تقوم دالة btl_init في مكوّن TCP BTL بعدة أمور:
- تنشئ مقبس استماع لكل واجهة IPv4 وIPv6 «نشطة» (up).
- تنشئ وحدة لكل واجهة IP «نشطة».
- تسجّل الزوج
(IP address, port)لكل واجهة IP «نشطة» في مستودع مركزي حتى تعرف عمليات MPI الأخرى كيف تتصل بها.
على نحو مماثل، تستطيع الإضافات أن توسّع هيكل المكوّن الخاص بالإطار بأعضائها الخاصة. وهذا ما يفعله مكوّن tcp في إطار btl؛ فهو يخزّن مؤقتًا (caches) أعضاء بيانات كثيرة في هيكل المكوّن الخاص به.
struct mca_btl_tcp_component_t {
    /* btl framework-specific component struct */
    mca_btl_base_component_2_0_0_t super;

    /* Some of the TCP BTL component's specific data members */
    /* Number of TCP interfaces on this server */
    uint32_t tcp_addr_count;

    /* IPv4 listening socket descriptor */
    int tcp_listen_sd;

    /* ...and many more not shown here */
};
تقنية تداخل الهياكل هذه تُعدّ في الواقع محاكاة بسيطة للوراثة الأحادية في C++: إذ يمكن تحليل (cast) مؤشر إلى نسخة من struct mca_btl_tcp_component_t إلى أيٍّ من الأنواع الثلاثة بحيث يمكن استخدامه من طبقة تجريد لا تفهم الأنواع «المشتقّة» (derived).
ومع ذلك، فإن التحويل بين الأنواع (casting) موضع انتقاد عام في Open MPI لأنه قد يؤدي إلى أخطاء دقيقة للغاية يصعب تعقّبها. وقد استُثنيت تقنية محاكاة C++ هذه لأن سلوكها محدَّد المعالم وهي تساعد في فرض حدود التجريد.
هيكل الوحدة.
تُعرَّف هياكل الوحدات بصورة فردية من كل إطار؛ فبينها قدر ضئيل من القواسم المشتركة. وبحسب الإطار، تولّد المكوّنات نسخة واحدة أو أكثر من هيكل الوحدة للدلالة على رغبتها في الاستخدام.
فمثلًا، في إطار BTL، تقابل الوحدة عادةً جهاز شبكة واحد. فإذا كانت عملية MPI تعمل على خادم Linux لديه ثلاثة أجهزة Ethernet «نشطة»، فإن مكوّن TCP BTL سيولّد ثلاث وحدات TCP BTL؛ واحدة مقابلة لكل جهاز Ethernet في Linux. ثم تتولى كل وحدة بالكامل جميع عمليات الإرسال والاستقبال من وإلى جهاز Ethernet الخاص بها.
الجمع بين كل ذلك.
يعرض الشكل 15.3 تداخل البنى في مكوّن TCP BTL، وكيف يولّد وحدةً لكل واحد من أجهزة Ethernet الثلاثة.
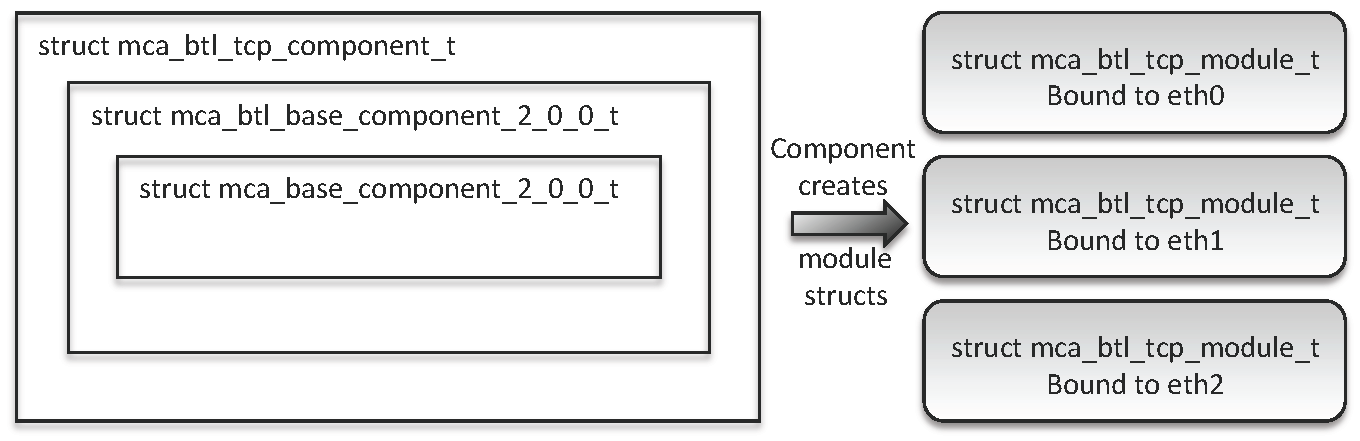 الشكل 15.3: يعرض الجانب الأيسر تداخل البنى في مكوّن TCP BTL. ويعرض الجانب الأيمن كيف يولّد المكوّن هيكل وحدة واحدًا لكل واجهة Ethernet «نشطة».
يتيح تركيب وحدات BTL بهذه الطريقة لمحرك تقدّم MPI (progression engine) في الطبقة العليا أن يتعامل مع جميع أجهزة الشبكة بالتساوي، وأن ينفّذ تجميع القنوات على مستوى المستخدم (user-level channel bonding).
فمثلًا، لنفكّر في إرسال رسالة كبيرة عبر تكوين الأجهزة الثلاثة الموصوف أعلاه. ولنفترض أن كل جهاز من أجهزة Ethernet الثلاثة يمكن استخدامه للوصول إلى المستقبِل المقصود (فتحدد إمكانية الوصول بشبكات TCP وأقنعة الشبكة (netmasks) وبعض القواعد الحسابية المحدَّدة المعالم). في هذه الحالة، سيقسّم المرسِل الرسالة الكبيرة إلى أجزاء متعددة. وسيُسنَد كل جزء—بشكل دوري (round-robin)—إلى واحدة من وحدات TCP BTL (فسيُسنَد إلى كل وحدة نحو ثلث الأجزاء تقريبًا). ثم ترسل كل وحدة أجزاءها عبر جهاز Ethernet المقابل لها.
قد يبدو هذا مخططًا معقّدًا، لكنه فعّال على نحو مدهش. فبتخطيطة (pipelining) عمليات إرسال الرسالة الكبيرة عبر وحدات TCP BTL المتعددة، تستطيع بيئات HPC المعتادة (مثل ما تكون فيه كل جهاز Ethernet على ناقل PCI منفصل) أن تحافظ على سرعات قريبة من أقصى نطاق ترددي عبر أجهزة Ethernet المتعددة.
معاملات وقت التشغيل
يتخذ المطورون قرارات شائعة عند كتابة الشيفرة، مثل:
- هل أستخدم الخوارزمية A أم الخوارزمية B؟
- ما حجم المخزن المؤقت (buffer) الذي ينبغي أن أجزّئه مسبقًا؟
- كم ينبغي أن تكون مدة المهلة (timeout)؟
- عند أي حجم رسالة ينبغي أن أغيّر بروتوكولات الشبكة؟
- …وما إلى ذلك.
يميل المستخدمون إلى افتراض أن المطورين يجيبون عن مثل هذه الأسئلة بطريقة تناسب بصورة عامة معظم أنواع الأنظمة. غير أن مجتمع HPC مليء بمستخدمين خبيرين من العلماء والمهندسين يريدون ضبط أعتّادهم وحزم برمجيةاتهم بشكل جريء لاستخلاص كل دورة حساب ممكنة. ورغم أن هؤلاء المستخدمين لا يريدون عادةً العبث بالشيفرة الفعلية لتنفيذ MPI الخاص بهم، فإنهم يريدون العبث بها عبر اختيار خوارزميات داخلية مختلفة، أو انتقاء أنماط استهلاك موارد مختلفة، أو فرض بروتوكولات شبكة محددة في ظروف مختلفة.
لذلك أُدرج نظام معاملات MCA عند تصميم Open MPI؛ وهو نظام آلية مرنة تتيح للمستخدمين تغيير قيم معاملات Open MPI الداخلية في وقت التشغيل. وتحديدًا، يسجّل المطورون معاملات MCA من نوع السلسلة والأعداد الصحيحة في شيفرة Open MPI بكاملها، مع قيمة افتراضية مصاحبة وسلسلة وصفية تعرّف ما هو المعامل وكيف يُستخدم. والقاعدة العامة أن المطورين، بدلًا من ترميز الثوابت بشكل صريح (hard-coding)، يستخدمون معاملات MCA القابلة للضبط في وقت التشغيل، مما يتيح للمستخدمين الخبيرين ضبط سلوك وقت التشغيل.
يوجد عدد من معاملات MCA في الشيفرة الأساسية للطبقات التجريد الثلاث، لكن الجزء الأكبر من معاملات Open MPI موجود في المكوّنات الفردية. فمثلًا، لدى إضافة TCL BTL معاملًا يحدد ما إذا كان ينبغي استخدام واجهات TCPv4 فقط، أم واجهات TCPv6 فقط، أم كلا النوعين من الواجهات. وبدلًا من ذلك، يمكن ضبط معامل TCP BTL آخر لتحديد أجهزة Ethernet التي ستُستخدم بدقة.
يستطيع المستخدمون اكتشاف المعاملات المتاحة عبر أداة سطر أوامر على مستوى المستخدم (ompi_info). ويمكن ضبط قيم المعاملات بطرق متعددة: على سطر الأوامر، أو عبر متغيرات البيئة، أو عبر سجل Windows، أو في ملفات بنمط INI على مستوى النظام أو المستخدم.
يكمل نظام معاملات MCA فكرة مرونة اختيار الإضافات في وقت التشغيل، وقد أثبت أنه ذو قيمة كبيرة للمستخدمين. ورغم أن مطوّري Open MPI يبذلون جهدًا كبيرًا لاختيار قيم افتراضية معقولة لمجموعة واسعة من المواقف، فإن كل بيئة HPC تختلف عن غيرها. وهناك بيئات لا مفرّ فيها من أن تكون القيم الافتراضية لمعاملات Open MPI غير مناسبة—وربما حتى ضارة بالأداء. ويتيح نظام معاملات MCA للمستخدمين أن يكونوا استباقيين ويضبطوا سلوك Open MPI ليائم بيئتهم. ولا يكتفي هذا الأمر بتخفيف العبء عن مطوّري المشروع في استقبال طلبات التغيير و/أو تقارير الأخطاء، بل يتيح للمستخدمين أيضًا تجربة فضاء المعاملات للعثور على أفضل تكوين لنظامهم المحدد.
15.3. الدروس المستفادة
مع مثل هذا المتنوع من الأعضاء الأساسيين في Open MPI، حتمًا ما تعلّمنا كل واحد منا شيئًا، وما تعلّمناه كمجموعة أشياء كثيرة. وفيما يلي وصف لمجموعة قليلة فقط من هذه الدروس.
الأداء
أداء تمرير الرسائل واستهلاك الموارد هما الملك والملكة في الحوسبة عالية الأداء. وقد صُمّم Open MPI تحديدًا بطريقة تتيح له العمل على أبعد حد ممكن من الأداء العالي: زمن استجابة منخفض للغاية لإرسال الرسائل القصيرة، ومعدلات حقن مرتفعة للغاية للرسائل القصيرة على الشبكات المدعومة، وتصاعد سريع نحو أقصى نطاق ترددي للرسائل الكبيرة، إلخ. والتجريد مفيد (لأسباب كثيرة)، لكنه يجب أن يُصمَّم بعناية كي لا يعوق الأداء. أو بصياغة أخرى: اختر بعناية تجريدات تناسبها مكدّسات نداءات ضحلة وعالية الأداء (بدلًا من مكدّسات نداءات API عميقة وغنية بالميزات).
ومع ذلك، كان علينا أيضًا أن نقبل أنه في بعض الحالات لا بد من طرح التجريد—لا البنية المعمارية—عبر النافذة. ومن أوضح الأمثلة أن لدى Open MPI شيفرة تجميع (assembly) مكتوبة يدويًا لبعض عملياته الأكثر حساسية للأداء، مثل قفل الذاكرة المشتركة والعمليات الذرية.
تجدر الإشارة إلى أن الشكلين 15.1 و15.2 يعرضان منظورين معماريين مختلفين لـOpen MPI. فهما لا يمثّلان مكدّسات النداءات في وقت التشغيل أو تدرّج استدعاءات الأكواد عالية الأداء.
الدرس المستفاد:
إن وجود شيفرة خشنة ومعقّدة سعيًا إلى الأداء (مثل شيفرة التجميع المذكورة آنفًا) أمر مقبول (وإن لم يكن مرغوبًا فيه)، للأسف أحيانًا ما يكون ضروريًا. غير أن قضاء وقت في محاولة اكتشاف كيفية الحصول على تجريدات جيدة تقرّع التعقيد وتخفيه كلما أمكن هو الخيار دائمًا. فأسابيع قليلة من التصميم قد توفر حرفيًا مئات أو آلاف الساعات البرمجية للصيانة على شيفرة متشابكة ودقيقة كعجينة الإسباغتي.
الوقوف على أكتاف العظماء
سعىنا بفاعلية إلى تجنب إعادة اختراع شيفرة في Open MPI كتبها شخص آخر من قبل (حين تكون تلك الشيفرة متوافقة مع ترخيص BSD الخاص بـOpen MPI). وتحديدًا، لا نتحرج إطلاقًا من إعادة استخدام شيفرة الآخرين مباشرةً أو من الربط بواجهاتها.
لا مكان لعقيدة «لم نخترعها هنا» (not invented here) عند محاولة حل مشكلات هندسية شديدة التعقيد؛ فإعادة استخدام شيفرة خارجية كلما أمكن هي القرار اللوجستي الصحيح وحده. وتحرّر إعادة الاستخدام هذه المطورين للتركيز على المشكلات الفريدة الخاصة بـOpen MPI؛ فلا معنى لإعادة حل مشكلة حلّها شخص آخر من قبل.
ومن الأمثلة الجيدة على هذا النوع من إعادة استخدام الشيفرة حزمة GNU Libtool المسماة Libltdl. وLibltdl مكتبة صغيرة توفّر واجهة برمجية محمولة لفتح DSOs والعثور على الرموز فيها. وهي مدعومة في تشكيلة واسعة جدًا من أنظمة التشغيل والبيئات، بما في ذلك Microsoft Windows.
كان بإمكان Open MPI أن يوفّر هذه الوظيفة بنفسه—لكن لماذا؟ إن Libltdl قطعة برمجية ممتازة، تُصان بفاعلية، ومتوافقة مع ترخيص Open MPI، وتوفّر بدقة الوظيفة التي كانت مطلوبة. وبناءً على هذه النقاط، لا يوجد أي كسب واقعي لمطوّري Open MPI في إعادة كتابة هذه الوظيفة.
الدرس المستفاد:
عندما يتوفّر حل مناسب في مكان آخر، فلا تتردد في دمجه وتوقف عن إهدار الوقت في محاولة إعادة اختراعه.
التحسين للحالة الشائعة
كان مبدأ معماري موجِّه آخر هو التحسين للحالة الشائعة. فمثلًا، يُركَّز على تقسيم كثير من العمليات إلى مرحلتين: الإعداد والإجراء المتكرر. والافتراض هنا أن الإعداد قد يكون مكلفًا (بمعنى: بطيئًا). لذا أدِّه مرة واحدة وانتهِ الأمر. وحسّن للحالة الأكثر شيوعًا بكثير: وهي الحالة المتكررة.
فمثلًا، قد تكون malloc() بطيئة، ولا سيما إذا احتاجت الصفحات إلى تخصيص من نظام التشغيل. لذا، بدلًا من تخصيص ما يكفي تمامًا من البايتات لرسالة شبكية واردة واحدة، خصّص مساحة كافية لـحزمة من الرسائل الواردة، وقسّم الناتج إلى مخازن رسائل فردية، وأعدّ قائمة حرة (freelist) لصيانتها. وبهذه الطريقة، قد يكون الطلب الأول لمخزن رسالة بطيئًا، لكن الطلبات اللاحقة ستكون أسرع بكثير لأنها ستكون مجرد عمليات إزالة من رأس قائمة حرة.
الدرس المستفاد:
قسّم العمليات الشائعة إلى مرحلتين (على الأقل): الإعداد والإجراء المتكرر. فالأداء سيكون أفضل، وقد يكون الصيانة أسهل مع الوقت لأن الإجراءات المميزة مفصولة عن بعضها.
متفرقات
هناك دروس مستفادة كثيرة جدًا لا يمكن وصفها بالتفصيل هنا؛ وفيما يلي دروس أخرى قليلة يمكن تلخيصها بإيجاز:
- كان لنا الحظ أن استفدنا من أكثر من 15 عامًا من أبحاث HPC، وأنتجنا تصاميم حملتنا (في الغالب) بنجاح لأكثر من ثماني سنوات. وعندما تبدأ مشروع برمجيات جديدًا، انظر إلى الماضي. واحرص على فهم ما أُنجز بالفعل، ولماذا أُنجز، وما كانت نقاط قوته وضعفه.
- أنقذنا مفهوم المكوّنات—الذي يسمح بتنفيذات متعددة مختلفة للوظيفة نفسها—مرات كثيرة، تقنيًا وسياسيًا على حد سواء. والإضافات مفيدة.
- وعلى نحو مماثل، نضيف الأطر ونزيلها باستمرار حسب الحاجة. فحين يبدأ المطورون في الجدال حول الطريقة «الصحيحة» لتنفيذ ميزة جديدة، أضف إطارًا يقدّم مكوّنات تنفّذ تلك الميزة. أو حين تظهر أفكار أحدث تُبطل أطرًا أقدم، فلا تتردد في حذف مثل هذه البقايا (kruft).
الخاتمة
لو كان علينا أن نعدّد أمور الثلاثة الأكثر أهمية التي تعلّمناها من مشروع Open MPI، فأعتقد أنها ستكون كالتالي:
- لا يوجد مقاس واحد يناسب الجميع (المستخدمين). فإضافات وقت التشغيل ونظام معاملات MCA المرافق يمنحان المستخدمين المرونة اللازمة في عالم البرمجيات المحمولة. ولا يمكن للأنظمة البرمجية المعقّدة أن تتكيف (دائمًا) بطريقة سحرية مع نظام معطى؛ وإتاحة ضوابط على مستوى المستخدم تسمح لإنسان بأن يكتشف—ويتجاوز—الحالات التي يكون فيها سلوك البرمجيات دون الأمثل.
- الاختلافات مفيدة. وتباين آراء المطورين مفيد. تبنَّ تحديات الوضع القائم؛ ولا تستسلم له. فقال طالب جريء يقول «يا هلا، انظر إلى هذا…» قد يقود إلى أساس ميزة جديدة بالكامل أو إلى تطور كبير في المنتج.
- وإن كان خارج نطاق هذا الكتاب، فإن الأشخاص والمجتمع مهمان. إلى حد بعيد.