مُصرِّف غلاسكو لهاسكل
معمارية تطبيقات المصادر المفتوحة (المجلد الثاني)مُصرِّف غلاسكو للغة Haskell
معمارية تطبيقات المصادر المفتوحة (المجلد الثاني) مُصرِّف غلاسكو للغة Haskell
سايمون مارلو وسايمون بيتون-جونز
إذا استمتعت بهذه الكتب، فقد يعجبك أيضًا التصميم البرمجي بالأمثلة في بايثون (Software Design by Example in Python) والتصميم البرمجي بالأمثلة في جافاسكربت (Software Design by Example in JavaScript).
بدأ مُصرِّف غلاسكو للغة هاسكل (Glasgow Haskell Compiler، GHC) بوصفه جزءًا من مشروع بحثي أكاديمي موَّلته الحكومة البريطانية في مطلع تسعينيات القرن الماضي، وفي الأفق عدّة أهداف:
- إتاحة مُصرِّف متين وقابل للنقل للغة هاسكل مجانًا، يولّد شيفرة عالية الأداء؛
- توفير أساس معياري (modular) يستطيع باحثون آخرون توسيعه وتطويره؛
- التعلّم عن كيفية سلوك البرامج الواقعية، حتى نتمكّن من تصميم وبناء مُصرِّفات أفضل.
عمر GHC الآن يتجاوز عشرين عامًا، وقد ظلّ قيد تطوير نشط ومستمر منذ بدايته. وفي الوقت الراهن، يُنزِّل مئات الآلاف من الأشخاص إصدارات GHC، ويضمّ المستودع الإلكتروني لمكتبات هاسكل أكثر من 3,000 حزمة، ويُستخدم GHC لتدريس هاسكل في كثير من مقرّرات البكالوريوس، ويوجد عدد متزايد من حالات الاعتماد على هاسكل في الأغراض التجارية.
على مدى عمره، كان لدى GHC عادةً مطوّران أو ثلاثة نشطون، وإن كان عدد من ساهم ببعض الشيفرة في GHC يبلغ المئات. فرغم أن الغاية النهائية لنا — المطوّرين الرئيسيين لـ GHC — هي إنتاج البحث لا الشيفرة، فإننا نعدّ تطوير GHC شرطًا أساسيًا: إذ تُعاد مخرجات البحث إلى GHC، ليُستخدم بعد ذلك أساسًا لبحثٍ إضافي يبني على هذه الأفكار السابقة. وعلاوةً على ذلك، من المهم ألّا يكون GHC سوى نسخة تجريبية، إذ يمنح ذلك نتائج البحث المنتَجة به مصداقية أكبر. فبينما هو ممتلئ بأفكار بحثية متطوّرة، يوضع جهد كبير في ضمان الاعتماد عليه في الاستخدام الإنتاجي. وقد كان هناك توتّر متكرّر بين هذين الهدفين اللذين يبدو أنهما متناقضان، لكننا في المجمل وجدنا طريقًا مُرضيًا من زاويتَي البحث والاستخدام الإنتاجي.
في هذا الفصل نودّ تقديم نظرة عامة على معمارية GHC، والتركيز على بضع أفكار جوهرية أثبتت نجاحها في GHC (وبعضها لم ينجح). نأمل أن تكسبوا في الصفحات التالية بعض البصيرة في كيفية تمكّننا من إبقاء مشروع برمجيات كبير نشطًا لأكثر من عشرين عامًا دون أن ينهار تحت ثقله، مع فريق تطوير صغير عمومًا.
5.1. ما هي هاسكل؟
هاسكل لغة برمجة وظيفية، يعرّفها مستندٌ يُعرف بـ«تقرير هاسكل» (Haskell Report) وأحدث تنقيحاته هو هاسكل 2010 Mar10. وقد أنشأها عام 1990 عدة أعضاء في مجتمع البحث الأكاديمي المهتمّ باللغات الوظيفية، استجابةً لنقص لغة مشتركة يمكن أن تكون محورًا لأبحاثهم.
تبرز ميزتان في هاسكل بين أوضاع لغات البرمجة:
- إنها خالصة وظيفية. أي أن الدوال لا يمكن أن يكون لها آثار جانبية أو أن تُغيّر البيانات؛ فلمجموعة مدخلات (وسائط) محدّدة، تُعطي الدالةُ النتيجةَ نفسها في كل مرة. فوائد هذا النموذج في التفكير في الشيفرة (وفي كتابتها، في رأينا) واضحة، لكن دمج الإدخال/الإخراج في السياق الخالص الوظيفي أثبت أنه تحدٍّ كبير. لحسن الحظ اكتُشف حلٌّ أنيق على هيئة مُونات (monads)، سمح ليس فقط بدمج الإدخال/الإخراج دمجًا منظّمًا مع الشيفرة الخالصة الوظيفية، بل أدخل تجريدًا جديدًا قويًا أحدث ثورة في البرمجة بهاسكل (وأثر لاحقًا في لغات أخرى أيضًا).
- إنها كسولة (lazy). هذا يشير إلى استراتيجية تقييم اللغة: فمعظم اللغات تستخدم تقييمًا صارمًا (strict) تُقيَّم فيه وسائط الدالة قبل استدعائها، أما في هاسكل فتُمرَّر وسائط الدالة دون تقييم، ولا تُقيَّم إلا عند الحاجة. ولهذا الجانب من هاسكل فوائد أيضًا في التفكير في البرامج، لكنه فوق كل ذلك يعمل حاجزًا يمنع تسرّب السمات غير الوظيفية النقيّة إلى اللغة: فهذه السمات لا يمكن أن تعمل أصلًا مع دلالات الكسل.
هاسكل كذلك قوية الأنواع (strongly-typed)، مع دعم استنتاج الأنواع (type inference) الذي يعني أن تعليقات الأنواع نادرًا ما تكون ضرورية.
على من يريد تاريخًا كاملًا للغة هاسكل أن يقرأ HHPW07.
5.2. البنية عالية المستوى
على أعلى المستويات، يمكن تقسيم GHC إلى ثلاث كتل متمايزة:
- المُصرِّف نفسه. وهو في جوهره برنامج مكتوب بلغة هاسكل مهمّته تحويل شيفرة هاسكل المصدرية إلى شيفرة آلية قابلة للتنفيذ.
- مكتبات الإقلاع (Boot Libraries). يأتي GHC مع مجموعة مكتبات نسمّيها مكتبات الإقلاع، لأنها تمثّل المكتبات التي يعتمد عليها المُصرِّف نفسه. ووجود هذه المكتبات في شجرة المصدر يعني أن GHC يستطيع إقلاع نفسه (bootstrap). وبعض هذه المكتبات مرتبط ارتباطًا وثيقًا جدًا بـ GHC، لأنها تنفّذ وظائف منخفضة المستوى مثل النوع
Intبدلالة أوّلية معرَّفة من المُصرِّف ونظام وقت التشغيل. ومكتبات أخرى أكثر ارتفاعًا ومستقلة عن المُصرِّف، مثل مكتبةData.Map. - نظام وقت التشغيل (Runtime System، RTS). هذه مكتبة كبيرة من شيفرة C تتولّى كل المهام المرتبطة بـتشغيل شيفرة هاسكل المُصرَّفة، بما في ذلك جمع القمامة، وجدولة الخيوط، والتنميط (profiling)، ومعالجة الاستثناءات وغيرها. ويُربط RTS بكل برنامج هاسكل مُصرَّف. ويُمثّل RTS جزءًا كبيرًا من جهد التطوير المبذول في GHC، والقرارات التصميمية المتَّخذة فيه مسؤولة عن بعض نقاط قوّة هاسكل الأساسية، مثل دعمها الكفء للتزامن (concurrency) والتوازي (parallelism). وسنصف RTS بمزيد من التفصيل في القسم 5.5.
وعمليًا، تقابل هذه الأقسام الثلاثة بالضبط ثلاثة أدلة فرعية في شجرة مصدر GHC: compiler وlibraries وrts على الترتيب.
لن نُطيل الوقت هنا في مناقشة مكتبات الإقلاع، فهي لا تهمّ كثيرًا من زاوية المعمارية. وكل القرارات التصميمية الجوهرية متجلّية في المُصرِّف ونظام وقت التشغيل، لذا سنُفرد بقية هذا الفصل لمناقشة هذين المكوّنين.
مقاييس الشيفرة
آخر مرة قِسنا فيها عدد أسطر GHC كانت عام 1992 («The Glasgow Haskell compiler: a technical overview»، ملخص مؤتمر JFIT التقني، 1992)، لذا من المثير للنظر كيف تغيّرت الأمور منذ ذلك الحين. ويعرض الشكل 5.1 تفصيلًا لعدد أسطر الشيفرة في GHC موزّعةً على المكوّنات الرئيسة، يقارن الإحصاءات الحالية بتلك لعام 1992.
| الوحدة النمطية | الأسطر (1992) | الأسطر (2011) | نسبة الزيادة |
|---|---|---|---|
| المُصرِّف | |||
| Main | 997 | 11,150 | 11.2 |
| Parser | 1,055 | 4,098 | 3.9 |
| Renamer | 2,828 | 4,630 | 1.6 |
| فحص الأنواع | 3,352 | 24,097 | 7.2 |
| إزالة السكر النحوي | 1,381 | 7,091 | 5.1 |
| تحويلات Core | 1,631 | 9,480 | 5.8 |
| تحويلات STG | 814 | 840 | 1 |
| Data-Parallel Haskell | — | 3,718 | — |
| توليد الشيفرة | 2913 | 11,003 | 3.8 |
| توليد الشيفرة الأصلية | — | 14,138 | — |
| توليد شيفرة LLVM | — | 2,266 | — |
| GHCi | — | 7,474 | — |
| الصيغة المجرّدة لهاسكل | 2,546 | 3,700 | 1.5 |
| لغة Core | 1,075 | 4,798 | 4.5 |
| لغة STG | 517 | 693 | 1.3 |
| C-- (كان Abstract C) | 1,416 | 7,591 | 5.4 |
| تمثيلات المعرّفات | 1,831 | 3,120 | 1.7 |
| تمثيلات الأنواع | 1,628 | 3,808 | 2.3 |
| تعريفات Prelude | 3,111 | 2,692 | 0.9 |
| الأدوات المساعدة | 1,989 | 7,878 | 3.96 |
| التنميط | 191 | 367 | 1.92 |
| مجموع المُصرِّف | 28,275 | 139,955 | 4.9 |
| نظام وقت التشغيل | |||
| كامل شيفرة C و C-- | 43,865 | 48,450 | 1.10 |
الشكل 5.1: عدد أسطر الشيفرة في GHC، في الماضي والحاضر
وهناك جوانب لافتة في هذه الأرقام:
- رغم نحو عشرين عامًا من التطوير المتواصل، زاد حجم المُصرِّف بمعامل 5 فقط، من نحو 28,000 سطر إلى نحو 140,000 سطر من شيفرة هاسكل. ونحن نُعيد الهيكلة (refactor) بإصرار أثناء إضافة شيفرة جديدة، لنُبقي قاعدة الشيفرة طازجة قدر الإمكان.
- هناك مكوّنات جديدة عدّة، وإن كانت هذه لا تستوعب سوى نحو 28,000 سطر جديد. وكثير من المكوّنات الجديدة تتعلّق بتوليد الشيفرة: مولّدات شيفرة أصلية لمعالجات مختلفة، ومولّد شيفرة LLVM. (وLLVM، «الآلة الافتراضية منخفضة المستوى» سابقًا، مشروع يتضمّن مولّد شيفرة عامًّا له أهداف تخصّ معالجات متعددة مختلفة. ولمزيد من المعلومات انظر http://llvm.org/، وكذلك الفصل عن LLVM في المجلد الأول من معمارية تطبيقات المصادر المفتوحة.) كما أضافت بنية المُفسِّر التفاعلي GHCi أكثر من 7,000 سطر.
- أكبر زيادة في مكوّن مفرد هي فاحص الأنواع، إذ أُضيفت إليه أكثر من 20,000 سطر. وهذا غير مفاجئ بالنظر إلى أن كثيرًا من الأبحاث الحديثة التي استخدمت GHC تعلّقت بامتدادات جديدة لأنظمة الأنواع (مثل الأنواع المعمَّمة المعتمدة على البيانات GADTs PVWW06 وعائلات الأنواع Type Families CKP05).
- أُضيفت كميات كبيرة من الشيفرة إلى مكوّن
Main؛ وذلك جزءًا لأن كان هناك سابقًا سكربت Perl بطول 3,000 سطر اسمه «المُشغِّل» (driver) أُعيدت كتابته بلغة هاسكل ونُقل إلى GHC نفسه، وجزءًا آخر لأن دعم تصريف عدّة وحدات أُضيف. - لم يكبر نظام وقت التشغيل إلا قليلًا: فهو أكبر بنسبة 10% فقط، رغم تراكم كثير من الوظائف الجديدة وتُنقيذه إلى منصات أكثر. وقد أعدنا كتابته بالكامل نحو عام 1997.
- لدى GHC نظام بناء معقّد، يشكّل اليوم نحو 6,000 سطر من شيفرة GNU make. وهو في نسخته الرابعة المعاد كتابتها بالكامل، وأحدثها قبل نحو عامين، وقد قلّص كل تكرار متتالٍ حجم الشيفرة.
المُصرِّف
يمكننا تقسيم المُصرِّف إلى ثلاثة أجزاء:
- مُدير التصريف (compilation manager)، المسؤول عن تصريف عدّة ملفات مصدرية بلغة هاسكل. ومهمة مدير التصريف هي تحديد الترتيب الذي تُصرَّف به الملفات المختلفة، واتخاذ قرار أي الوحدات النمطية لا يلزم إعادة تصريفها لأن أيًّا من تبعياتها لم يتغيّر منذ آخر مرة صُرِّفت فيها.
- مُصرِّف هاسكل (نختصره داخل GHC باسم
Hsc)، الذي يتولّى تصريف ملف مصدر واحد بلغة هاسكل. وكما قد تتخيّل، فإن معظم العمل يجري هنا. ويعتمد ناتجHscعلى الواجهة الخلفية المختارة: تجميع (assembly)، أو شيفرة LLVM، أو شيفرة فرعية (bytecode). - خط الأنابيب (pipeline)، المسؤول عن تركيب أي برامج خارجية لازمة مع
Hscلتصريف ملف مصدر بلغة هاسكل إلى شيفرة كائنات (object code). فمثلًا قد يحتاج ملف مصدر بلغة هاسكل إلى معالجة أولية بالمُعالج المُسبق للغة C قبل تمريره إلىHsc، ويكون ناتجHscعادةً ملف تجميع يجب تمريره إلى المُجمِّع (assembler) لإنشاء ملف كائنات.
المُصرِّف ليس مجرّد ملف تنفيذي يؤدّي هذه الوظائف؛ بل هو في نفسه مكتبة ذات واجهة برمجية (API) واسعة يمكن استخدامها لبناء أدوات أخرى تعمل على الشيفرة المصدرية لهاسكل، مثل بيئات التطوير المتكاملة وأدوات التحليل.
تصريف شيفرة هاسكل
كما في معظم المُصرِّفات، يسير تصريف ملف مصدر بلغة هاسكل في تسلسل من المراحل، حيث يصير ناتج كل مرحلة مدخلًا للمرحلة التالية. ويوضّح الشكل 5.2 البنية العامة للمراحل المختلفة.
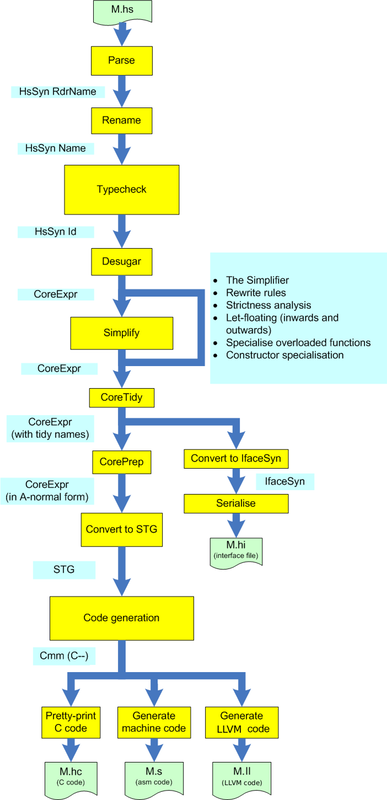 الشكل 5.2: مراحل المُصرِّف
التحليل النحوي
نبدأ بالطريقة التقليدية، أي بالتحليل النحوي، الذي يأخذ كمدخل ملفًا مصدرًا بلغة هاسكل وينتج كناتج الصيغة المجرّدة. في GHC يكون نوع بيانات الصيغة المجرّدة HsSyn مُعاملًا (parameterised) بأنواع المعرّفات التي يحتويها، ومن ثمّ يكون نوع شجرة الصيغة المجرّدة هو HsSyn t حيث t هو نوع معرّفات ما. ويتيح ذلك لنا إضافة المزيد من المعلومات إلى المعرّفات بينما يمرّ البرنامج عبر مراحل المُصرِّف المختلفة، مع إعادة استخدام النوع نفسه من أشجار الصيغة المجرّدة.
ونتاج المحلّل هو شجرة صيغة مجرّدة تكون فيها المعرّفات نصوصًا بسيطة، نسمّيها RdrName. وعليه، تكون الصيغة المجرّدة التي ينتجها المحلّل من النوع HsSyn RdrName.
ويستخدم GHC الأداتين Alex وHappy لتوليد شيفرة التحليل المعجمي وشيفرة التحليل النحوي على التوالي، وهما نظيران للأداتين lex وyacc الخاصتين بلغة C.
ومُحلِّل GHC خالص وظيفي. وفي الواقع، توفّر واجهة مكتبة GHC دالةً خالصة اسمها parser تأخذ String (وغيرها من الأشياء القليلة) وتُعيد إمّا الصيغة المجرّدة المحلّلة وإمّا رسالة خطأ.
إعادة التسمية
إعادة التسمية هي عملية حسم جميع المعرّفات في الشيفرة المصدرية لهاسكل إلى أسماء مؤهَّلة بالكامل (fully qualified)، مع تمييز أي معرّف خارج نطاقه في الوقت نفسه ووضع الأخطاء بما يقتضيه.
في هاسكل يمكن لوحدة نمطية أن تُعيد تصدير معرّف استوردته من وحدة نمطية أخرى. فمثلًا، لنفترض أن الوحدة النمطية A تعرّف دالة اسمها f، وأن الوحدة B تستورد الوحدة A وتُعيد تصدير f. الآن، إذا استوردت وحدة نمطية C الوحدة B، أمكنها أن تشير إلى f بالاسم B.f—مع أن f مُعرَّفة أصلًا في الوحدة A. وهذه صيغة مفيدة من التلاعب بمجالات الأسماء؛ فهي تعني أن المكتبة تستطيع أن تستخدم داخليًا أي بنية وحدات تراها، لكن تُعرِض واجهة برمجية أنيقة ونظيفة عبر بضع وحدات واجهة تعيد تصدير المعرّفات من الوحدات الداخلية.
غير أن المُصرِّف مضطر إلى حلّ كل ذلك، كي يعرف ما يقابله كل اسم في الشيفرة المصدرية. ونُحدث تمييزًا صريحًا بين الكيانات، أي «الأشياء نفسها» (في مثالنا A.f)، والأسماء التي يمكن الإشارة بها إلى تلك الكيانات (مثل B.f). وعند أي نقطة في الشيفرة المصدرية، تكون هناك مجموعة من الكيانات في النطاق، وقد يُعرف كل منها باسم واحد أو بعدة أسماء مختلفة. ومهمة مُعيد التسمية هي استبدال كل اسم في التمثيل الداخلي للشيفرة لدى المُصرِّف بإشارة إلى كيان بعينه. وأحيانًا قد يشير الاسم الواحد إلى عدة كيانات مختلفة؛ وهذا بحدّ ذاته ليس خطأ، لكن إذا استُخدم الاسم فعلًا فإن مُعيد التسمية سيُبلّغ عن خطأ التباس ويرفض البرنامج.
وتأخذ إعادة التسمية الصيغة المجرّدة لهاسكل (HsSyn RdrName) كمدخل، وتنتج أيضًا صيغة مجرّدة كناتج (HsSyn Name). وهنا يكون Name إشارة إلى كيان بعينه.
وحسم الأسماء هو المهمة الرئيسة لمُعيد التسمية، لكنه يؤدّي أيضًا وفرةً من المهام الأخرى: تجميع معادلات دالة في مكان واحد والإبلاغ عن خطأ إذا اختلف عدد وسائطها؛ وإعادة ترتيب التعبيرات ذات الترتيب الوسطي (infix) وفقّ تعلّقية المعاملات (fixity) بها؛ وكشف الإعلانات المكرّرة؛ وتوليد تحذيرات للمعرّفات غير المستعملة، وهكذا.
فحص الأنواع
فحص الأنواع، كما قد يتخيّل المرء، هو عملية التحقّق من أن برنامج هاسكل سليم الأنواع. فإذا اجتاز البرنامج فاحص الأنواع، فإن الضمان أنه لن ينهار عند التشغيل. (لكلمة «الانهيار» هنا تعريف رسمي يشمل الانهيارات الصلبة مثل «خطأ تجزئة» (segmentation fault)، لكنه لا يشمل أمورًا مثل فشل مطابقة الأنماط. ويمكن خرق ضمان عدم الانهيار باستخدام بعض سمات اللغة غير الآمنة، مثل واجهة الدوال الأجنبية.)
ومدخل فاحص الأنواع هو HsSyn Name (شيفرة هاسكل بأسماء مؤهَّلة)، وناتجه هو HsSyn Id. وId هو Name مع معلومات إضافية، أهمّها النوع. وفي الواقع، تكون الصيغة النحوية لهاسكل التي ينتجها فاحص الأنواع مزينةً بالكامل بمعلومات الأنواع: لكل معرّف نوعه ملحق به، وهناك ما يكفي من المعلومات لإعادة بناء نوع أي تعبير فرعي (قد يكون ذلك مفيدًا لبيئة تطوير متكاملة، على سبيل المثال).
وفي الممارسة العملية، قد تتداخل عمليتا فحص الأنواع وإعادة التسمية، لأن ميزة Template Haskell تولّد شيفرة عند وقت التشغيل تحتاج بدورها إلى إعادة تسمية وفحص أنواع.
إزالة السكر النحوي ولغة Core
هاسكل لغة كبيرة إلى حدّ ما، تحتوي على صور نحوية مختلفة كثيرة. وقد رُوعي أن تكون سهلة القراءة والكتابة على الإنسان—فهي تتضمّن مدى واسعًا من البنى النحوية التي تمنح المبرمج مرونة كبيرة في اختيار الأنسب للحالة المعنيّة. غير أن هذه المرونة تعني غالبًا وجود عدّة طرق لكتابة الشيفرة نفسها؛ فمثلًا تعبير if متطابق في المعنى مع تعبير case له فرعان True وFalse، ويمكن ترميز تدوين فهم القوائم (list-comprehension) إلى استدعاءات لـ map وfilter وconcat. وفي الواقع، يعرّف تعريف لغة هاسكل كل هذه البنى عبر ترجمتها إلى بنى أبسط؛ أما البنى التي يمكن التخلّص منها بهذه الطريقة فتُسمّى «سكرًا نحويًا» (syntactic sugar).
ويصبح الأمر أصعب بكثير على المُصرِّف إذا أُزيل كل السكر النحوي، لأن تمريرات التحسين اللاحقة التي تحتاج إلى العمل على برنامج هاسكل تتعامل مع لغة أصغر. هكذا تُزيل عملية إزالة السكر النحوي كل السكر النحوي، مترجمةً الصيغة النحوية الكاملة لهاسكل إلى لغة أصغر كثيرًا نسمّيها Core. وسنتحدث عن Core بالتفصيل لاحقًا.
التحسين
حين يصبح البرنامج في Core، تبدأ عملية التحسين. ومن أعظم نقاط قوة GHC أنها تزيل طبقات التجريد، وكل هذا العمل يجري على مستوى Core. وCore لغة وظيفية ضئيلة، لكنها وسيط شديد المرونة للتعبير عن تحسينات، تبدأ من المستويات الأعلى جدًا كتحليل الصرامة (strictness analysis)، وصولًا إلى المستويات الأدنى جدًا كتخفيض القوة (strength reduction).
وكل تمريرة تحسين تأخذ Core وتنتج Core. والتمريرة الرئيسة هنا تسمّى المُبسِّط (Simplifier)، ومهمتها إجراء مجموعة كبيرة من التحويلات الحافظة على الصحة، بهدف إنتاج برنامج أكثر كفاءة. وبعضها بسيط وبديهي، مثل إزالة الشيفرة الميتة أو تبسيط تعبير case عندما تكون القيمة المفحوصة معروفة، وبعضها أكثر تعقيدًا، مثل دمج الدوال داخليًا وتطبيق قواعد إعادة الكتابة (نناقشها لاحقًا).
وعادةً ما يُشغَّل المُبسِّط بين تمريرات التحسين الأخرى، وعددها نحو ست؛ وأي التمريرات تُنفَّذ فعلًا وبأي ترتيب يعتمد على مستوى التحسين الذي يختاره المستخدم.
توليد الشيفرة
بعد أن يُحسَّن برنامج Core، تبدأ عملية توليد الشيفرة. وبعد تمريرتين إداريتين، تسلك الشيفرة أحد طريقين: إمّا تُحوَّل إلى شيفرة فرعية (bytecode) لتنفيذها بواسطة المُفسِّر التفاعلي، أو تُسلَّم إلى مولّد الشيفرة (code generator) لترجمتها لاحقًا إلى شيفرة آلية.
ويحوّل مولّد الشيفرة أولًا Core إلى لغة تسمّى STG، وهي في الجوهر Core مشحونة بمعلومات إضافية يحتاجها مولّد الشيفرة. ثم تُترجم STG إلى Cmm، وهي لغة أمرية منخفضة المستوى ذات مكدّس صريح. ومن هنا تسلك الشيفرة أحد ثلاثة طرق:
- توليد الشيفرة الأصلية: يحتوي GHC على مولّدات شيفرة أصلية بسيطة لبضع معماريات معالجات. وهذا الطريق سريع، وينتج شيفرة مقبولة في معظم الحالات.
- توليد شيفرة LLVM: تُحوَّل
Cmmإلى شيفرة LLVM وتُسلَّم إلى مُصرِّف LLVM. ويمكن لهذا الطريق أن ينتج شيفرة أفضل بكثير في بعض الحالات، وإن كان يستغرق وقتًا أطول من مولّد الشيفرة الأصلية. - توليد شيفرة C: يستطيع GHC إنتاج شيفرة C عادية. وينتج هذا الطريق شيفرة أبطأ بكثير من الطريقين الآخرين، لكنه قد يكون مفيدًا في تنقيذ GHC إلى منصات جديدة.
5.3. الخيارات التصميمية الأساسية
في هذا القسم نركّز على بضع خيارات تصميمية أثبتت فاعليتها بشكل خاص في GHC.
اللغة الوسيطة
| التعبيرات | |||
|---|---|---|---|
| t,e,u | ::= | x | المتغيّرات |
| K | |||
| k | |||
| λ x:σ.e | |||
| Λ a:η.e | |||
| let x:τ = e in u | |||
| case e of p→u | |||
| e ▷ γ | |||
| ⌊ γ ⌋ | |||
| p | ::= | K c:η x:τ | الأنماط |
الشكل 5.3: صيغة Core
البنية المعتادة لمُصرِّف لغة ذات أنواع ساكنة (statically-typed) هي هذه: يُفحص البرنامج من حيث الأنواع، ثم يُحوَّل إلى لغة وسيطة بلا أنواع (untyped) قبل تحسينه. أما GHC فمختلف: لديه لغة وسيطة ذات أنواع ساكنة. وقد اتضح أن هذا الخيار التصميمي كان له أثر شامل في تصميم GHC وتطويره.
واللغة الوسيطة في GHC تسمّى Core (عند التفكير في التنفيذ) أو System FC (عند التفكير في النظرية). وصيغتها معطاة في الشكل 5.3. والتفاصيل الدقيقة ليست مهمة هنا؛ فالقارئ المهتمّ يستطيع الرجوع إلى SCPD07 لمزيد من التفاصيل. لكن لأغراضنا الحالية، النقاط التالية هي الجوهرية:
- هاسكل لغة مصدر كبيرة جدًا. فنوع البيانات الذي يمثّل شجرة صيغتها يضمّ مئات البانيات. وفي المقابل،
Coreحساب لامدا (lambda calculus) ضئيل ومبني على أسس متينة. فعدد صوره النحوية ضئيل جدًا، ومع ذلك نستطيع ترجمة كل هاسكل إلىCore. - هاسكل لغة مصدر ذات أنواع ضمنية (implicitly-typed). قد يكون في البرنامج تعليقات أنواع قليلة أو لا شيء منها؛ وعوضًا عن ذلك يتولّى خوارزمية استنتاج الأنواع استنتاج نوع كل رابط وكل تعبير فرعي. وهذه الخوارزمية معقّدة، وأحيانًا ما تكون عشوائية بعض الشيء، لتجسّد التنازلات التصميمية التي تتضمّنها كل لغة برمجة حقيقية. وفي المقابل
Coreلغة ذات أنواع صريحة (explicitly-typed). فكل رابط له نوع صريح، وتحتوي الحدود على تجريدات أنواع وتطبيقات أنواع صريحة. وتتمتعCoreبخوارزمية فحص أنواع بسيطة جدًا وسريعة تتحقّق من سلامة أنواع البرنامج. والخوارزمية مستقيمة تمامًا؛ فلا توجد فيها أي تنازلات عشوائية.
وتعمل جميع تمريرات التحليل والتحسين في GHC على Core. وهذا أمر رائع: ولأن Core لغة ضئيلة إلى هذا الحدّ، فإن أي تحسين لا يحتاج إلا إلى معالجة حالات قليلة. فرغم صغر Core فإنها تعبيرية إلى حدٍّ بعيد—فالنظام F، بعد كل شيء، طُوِّر أصلًا بوصفه حسابًا تأسيسيًا للحساب المُنمَّط. وحين تُضاف سمات جديدة إلى لغة المصدر (وهذا يحدث طوال الوقت) تنحصر التغييرات عادةً في الواجهة الأمامية؛ وتبقى Core على حالها، وبالتالي يبقى معظم المُصرِّف على حاله.
لكن لماذا تكون Core مُنمَّطة؟ فبعد كل شيء، إذا قبلت محرّك استنتاج الأنواع البرنامج المصدر، فالأرجح أن يكون ذلك البرنامج سليم الأنواع، وأن تحافظ كل تمريرة تحسين على تلك السلامة. قد تتمتع Core بخوارزمية فحص أنواع سريعة، لكن لماذا تودّ تشغيلها أصلًا؟ وعلاوةً على ذلك، فإن جعل Core مُنمَّطة يحمل تكاليف كبيرة، لأن كل تحويل أو تمريرة تحسين يجب أن تنتج برنامجًا سليم الأنواع، وتوليد كل تعليقات الأنواع تلك غالبًا ما يكون عسيرًا.
ومع ذلك، فإن وجود لغة وسيطة ذات أنواع صريحة كان مكسبًا هائلًا، ولأسباب عدّة:
- تشغيل فاحص أنواع
Core(ونسمّيهLint) هو تدقيق اتّساق قوي جدًا على المُصرِّف نفسه. تخيّل أنك كتبت «تحسينًا» يولّد شيفرة بالخطأ تعامل قيمة صحيحة كأنها دالة وتحاول استدعائها. من المرجّح أن يتسبّب البرنامج في خطأ تجزئة، أو يفشل عند التشغيل بطريقة غريبة. وتتبّع خطأ تجزئة رجوعًا إلى تمريرة التحسين التي أفسدت البرنامج طريق طويل. والآن تخيّل بدلًا من ذلك أننا نشغّلLintبعد كل تمريرة تحسين (ونحن نفعل ذلك إذا استخدمت الراية-dcore-lint): عندها سيُبلّغ عن خطأ محدَّد الموضع مباشرةً بعد التحسين المسبّب له. ما أعظم هذا الرَّمة! بالطبع، سلامة الأنواع ليست هي الصواب: فـLintلن يُبلّغ عن خطأ إذا «حسّنتَ»(x*1)إلى 1 بدلًا من x. لكن إذا اجتاز البرنامجLint، فإنه يضمن التشغيل دون أخطاء تجزئة؛ وعلاوةً على ذلك وجدنا في الممارسة العملية أن كتابة تحسينات عرضية سليمة الأنواع لكن غير سليمة دلاليًا صعبة على نحو مفاجئ. - خوارزمية استنتاج أنواع هاسكل كبيرة جدًا ومعقّدة جدًا: نظرة سريعة إلى الشكل 5.1 تؤكّد أن فاحص الأنواع هو إلى حد بعيد أكبر مكوّن مفرد في GHC. والكبر والتعقيد يعنيان قابلية عالية للخطأ. لكن
Lintيعمل تدقيقًا مستقلًا بنسبة 100% على محرّك استنتاج الأنواع؛ فإذا قبل محرّك استنتاج الأنواع برنامجًا ليس سليم الأنواع في الواقع، فإنLintسيرفضه. ومن ثمّ فإنLintمدقّق قوي لمحرّك استنتاج الأنواع. - وأثبت وجود
Coreأيضًا أنه فحص عقلاني ممتاز (sanity check) للتصميم لغة المصدر. فمستخدمونا يقترحون باستمرار سمات جديدة يودّون وجودها في اللغة. وأحيانًا تكون هذه السمات سكرًا نحويًا واضحًا، أي صياغة جديدة مريحة لأمر يمكنك فعله أصلًا. لكن أحيانًا تكون أعمق، ويصعب تحديد مدى بلوغها. وتمنحناCoreطريقة دقيقة لتقييم هذه السمات. فإذا أمكن ترجمة السمة بسهولة إلىCore، فإن ذلك يطمئننا إلى أنه لا يوجد شيء جديد جوهري: فالسمة الجديدة أشبه بالسكر النحوي. وعلى النقيض، إذا كانت تتطلب توسيعًا لـCore، فإننا نفكّر كثيرًا، كثيرًا، أكثر.
وفي الممارسة العملية كانت Core مستقرة إلى حدٍّ لا يُصدّق: فعلى مدى عشرين عامًا أضفنا بالضبط سمة رئيسة واحدة جديدة إلى Core (وهي الإكراهات (coercions) وتحويلاتها المرتبطة بها). وخلال الفترة نفسها، تطورت لغة المصدر تطورًا هائلًا. ولا نُنسب هذه الاستقرار لأنفسنا، بل إلى أن Core مبنية مباشرةً على أساسيات الرياضيات: برافو جيرار!
فحص أنواع لغة المصدر
أحد قرارات التصميم المميزة هو ما إذا كان ينبغي إجراء فحص الأنواع قبل إزالة السكر النحوي أم بعدها. والمقايضات هي التالية:
- إجراء فحص الأنواع قبل إزالة السكر النحوي يعني أن على فاحص الأنواع التعامل مباشرةً مع الصياغة النحوية الضخمة لهاسكل، إذ يتبيّن له حالات كثيرة يجب مراعاتها. وإذا أزلنا السكر النحوي أولًا إلى
Core(بصيغة غير مُنمَّطة منها)، فقد يُمكن أن يصغر فاحص الأنواع كثيرًا. - وعلى النقيض، فإن فحص الأنواع بعد إزالة السكر النحوي يفرض التزامًا جديدًا وذا أهمية: ألّا تؤثر إزالة السكر في أي البرامج الخاضعة لفحص الأنواع. فإزالة السكر النحوي تعني ضمنًا فقدان مقصود للمعلومات. ومن المرجّح ألّا تكون هناك مشكلة في 95% من الحالات، لكن أي مشكلة هنا ستُجبر تصميم
Coreعلى تقديم تنازل ما للحفاظ على بعض المعلومات الإضافية. - والأخطر من كل ذلك، فحص برنامج بعد إزالة السكر عنه يجعل الإبلاغ عن الأخطاء المتعلقة بنص البرنامج الأصلي أصعب بكثير، لا عن نسخته منزوعة السكر (التي تكون أحيانًا معقّدة).
ومعظم المُصرِّفات يفحص الأنواع بعد إزالة السكر، لكننا في GHC اتخذنا الخيار المعاكس: نفحص الصياغة الأصلية الكاملة لهاسكل، ثم نزيل السكر عن الناتج. ويبدو للوهلة الأولى أن إضافة صيغة نحوية جديدة قد تكون معقّدة، لكننا (متبّعين المدرسة الفرنسية) هيكلنا محرّك استنتاج الأنواع على نحو يجعلها سهلة. وينقسم استنتاج الأنواع إلى جزأين:
- توليد القيود: المرور على شجرة الصياغة المصدرية، وتوليد مجموعة من قيود الأنواع. وهذه الخطوة تتعامل مع الصياغة الكاملة لهاسكل، لكن شيفرتها مستقيمة جدًا، وإضافة حالات جديدة سهلة.
- حلّ القيود: حلّ القيود المجموعة. وهنا تكمن دقّة محرّك استنتاج الأنواع، لكنه مستقلّ عن الصياغة النحوية للغة المصدر، وستكون الحال نفسها لو كانت اللغة أصغر بكثير أو أكبر بكثير.
وعمومًا، تبيّن أن خيار التصميم القائم على الفحص قبل إزالة السكر كان مكسبًا كبيرًا. نعم، إنه يضيف أسطرًا إلى فاحص الأنواع، لكنها أسطر بسيطة. وهو يتجنّب منح دورين متعارضين لنوع البيانات نفسه، ويجعل محرّك استنتاج الأنواع أقل تعقيدًا وأسهل تعديلًا. وعلاوةً على ذلك، فإن رسائل أخطاء الأنواع في GHC جيدة إلى حدّ ما.
لا جدول رموز
لدى المُصرِّفات عادةً بنية بيانات واحدة أو أكثر تُعرف بـجدول الرموز (symbol table)، وهي ربطات من الرموز (مثل المتغيّرات) إلى معلومات عن المتغيّر، مثل نوعه أو الموضع الذي عُرِّف فيه في الشيفرة المصدرية.
وفي GHC نستخدم جداول الرموز باعتدال تامّ؛ أساسًا في مُعيد التسمية وفاحص الأنواع. وإلى أقصى حد ممكن، نلجأ إلى استراتيجية بديلة: المتغيّر هو بنية بيانات تحتوي كل المعلومات عن نفسه. وفي الواقع، يمكن بلوغ كميات كبيرة من المعلومات عبر اجتياز بنية بيانات المتغيّر: فمن المتغيّر نرى نوعه، وهو يحتوي بانيات الأنواع، وهي تحتوي بانياتها، وهي بدورها تحتوي أنواعًا، وهكذا. فمثلًا، إليك بعض أنواع بيانات GHC (مختصرًا ومبسّطًا إلى حدّ كبير):
  data Id      = MkId Name Type
  data Type    = TyConApp TyCon [Type]
               | ....
  data TyCon   = AlgTyCon Name [DataCon]
               | ...
  data DataCon = MkDataCon Name Type ...
ويحتوي Id على Type الخاص به. وقد يكون Type تطبيقًا لباني نوع على بعض الوسائط (مثل Maybe Int)، وعندها يحتوي على TyCon. ويمكن أن يكون TyCon نوع بيانات جبريًا (algebraic data type)، وعندها يشمل قائمة ببانياته. ويحتوي كل DataCon على Type الخاص به، وهو بطبيعة الحال يذكر TyCon. وهكذا. البنية كلها مترابطة بدرجة عالية. بل إنها دورية؛ فمثلًا قد يحتوي TyCon على DataCon يحتوي على Type يحتوي على TyCon نفسه الذي بدأنا منه.
ولهذا النهج بعض المزايا والعيوب:
- والاستفسارات العديدة التي كانت تتطلّب بحثًا في جدول رموز تُختزل إلى مجرد وصول إلى حقل، وهذا ممتاز لكفاءة التنفيذ ووضوح الشيفرة.
- ولا حاجة إلى حمل جداول رموز إضافية، فشجرة الصيغة المجرّدة تحتوي بالفعل على كل المعلومات.
- وتكاليف المساحة أفضل: فكل نُسخ المتغيّر نفسه تشترك في بنية البيانات نفسها، ولا حاجة إلى مساحة للجدول.
- والصعوبات الوحيدة تنشأ حين نحتاج إلى تغيير أي من المعلومات المرتبطة بمتغيّر. وهنا تكمن ميزة جدول الرموز: يكفي أن نغيّر المُدخل في جدول الرموز. أما في GHC فيلزمنا اجتياز شجرة الصيغة المجرّدة واستبدال كل نُسخ المتغيّر القديم بالجديد؛ وإن المُبسِّط يفعل هذا بانتظام، لأنه يحتاج إلى تحديث معلومات معيّنة متعلّقة بالتحسين لكل متغيّر.
ومن الصعب معرفة ما إذا كان استخدام جداول الرموز سيكون أفضل أم أسوأ إجمالًا، لأن هذا الجانب من التصميم جوهري إلى حدّ أنه يكاد يستحيل تغييره. ومع ذلك، فإن تجنّب جداول الرموز خيار طبيعي في السياق الخالص الوظيفي، لذا يبدو مرجّحًا أن يكون هذا النهج خيارًا جيدًا لهاسكل.
التحسين ما بين الوحدات النمطية
تشجّع اللغات الوظيفية المبرمج على كتابة تعريفات صغيرة. فمثلًا، إليك تعريف && من المكتبة القياسية:
(&&) :: Bool -> Bool -> Bool
True && True = True
_    && _    = False
وإذا كان كل استخدام لمثل هذه الدالة يستلزم فعلًا استدعاء دالة، لكانت الكفاءة يرثى لها. وأحد الحلول هو جعل المُصرِّف يتعامل مع دوال بعينها بصورة خاصة؛ وآخر هو استخدام مُعالج أولي يستبدل «الاستدعاء» بالشيفرة المدمجة المرغوبة. وكل هذه الحلول غير مُرضية من وجهٍ ما، ولا سيما أن حلًا آخر بديهي تمامًا: دمج الدالة داخليًا فحسب. ويعني «دمج دالة داخليًا» استبدال الاستدعاء بنسخة من جسم الدالة، مع إضفاء ملاءمة مناسبة على وسائطها.
وفي GHC تبنّينا هذا النهج بصورة منهجية PM02. فلا شيء تقريبًا مبنيّ داخل المُصرِّف. وبدلًا من ذلك نُعرّف أكبر قدر ممكن في المكتبات، ونستخدم الدمج الداخلي العنيف لإلغاء الأحمال الزائدة. وهذا يعني أن المبرمجين يمكنهم تعريف مكتباتهم الخاصة التي ستُدمج داخليًا وتُحسَّن كما تُدمج المكتبات المرفقة مع GHC.
وإحدى النتائج لذلك أن على GHC أن يكون قادرًا على الدمج الداخلي عبر الوحدات النمطية، بل وعبر الحِزَم أيضًا. والفكرة بسيطة:
- عند تصريف وحدة نمطية بلغة هاسكل اسمها
Lib.hs، يُنتج GHC شيفرة كائنات فيLib.oوملف «واجهة» فيLib.hi. ويحتوي ملف الواجهة على معلومات عن كل الدوال التي تصدّرهاLib، بما في ذلك أنواعها و، للدوال الصغيرة بما يكفي، تعريفاتها. - وعند تصريف وحدة نمطية اسمها
Client.hsتستوردLib، يقرأ GHC ملف الواجهةLib.hi. فإذا استدعتClientدالةLib.fالمُعرَّفة فيLib، استطاع GHC استخدام المعلومات فيLib.hiلدمجLib.fداخليًا.
وافتراضيًا، لن يكشف GHC تعريف دالة في ملف الواجهة إلا إذا كانت الدالة «صغيرة» (وهناك رايات تتحكّم في عتبة الحجم هذه). لكننا ندعم أيضًا تعليمة INLINE، لتوجيه GHC إلى دمج التعريف داخليًا بصورة عنيفة عند مواضع الاستدعاء، بغضّ النظر عن الحجم، وإليك الصيغة:
foo :: Int -> Int
{-# INLINE foo #-}
foo x = <some big expression>
والدمج الداخلي عبر الوحدات النمطية جوهري تمامًا لتعريف مكتبات فائقة الكفاءة، لكنه يأتي بثمن. فإذا رقّى مؤلف مكتبته، فلا يكفي أن تُعيد ربط Client.o بـ Lib.o الجديدة، لأن Client.o يحتوي على مقاطع مدمجة من Lib.hs القديمة، وقد لا تكون متوافقة مع الجديدة على الإطلاق. وعبارة أخرى للقول إن الـ ABI (Application Binary Interface) لـ Lib.o قد تغيّرت بطريقة تستلزم إعادة تصريف عملائها.
والطريق الوحيد لتوليد شيفرة ذات ABI ثابت يمكن التنبؤ به هو تعطيل التحسين عبر الوحدات النمطية، وهذا عادةً ثمن مرتفع جدًا ندفعه مقابل توافق ABI. والمستخدمون الذين يعملون مع GHC يكونون عادةً لديهم الشيفرة المصدرية لكامل حزمة أدواتهم متاحة، لذا فإن إعادة التصريف ليست مشكلة في الأحوال المعتادة (وكما سنصف لاحقًا، فإن نظام الحِزَم مصمَّم حول هذا النمط من العمل). غير أن هناك حالات لا تكون فيها إعادة التصريف عملية، مثل توزيع إصلاحات الأخطاء على مكتبات ضمن نظام تشغيل يُوزَّع في صورة ثنائية. ونأمل في المستقبل أن يتيسّر إيجاد حل وسط يسمح بالاحتفاظ بتوافق ABI مع السماح في الوقت نفسه بإجراء بعض التحسين عبر الوحدات النمطية.
5.4. القابلية للتمديد
كثيرًا ما يقضي مشروع حيته أو يموت بحسب مدى قابليته للتمديد. فالقطعة البرمجية الأحادية (monolithic) غير القابلة للتمديد عليها أن تفعل كل شيء وأن تفعله على الوجه الصحيح، في حين يمكن أن تكون القطعة القابلة للتمديد أساسًا مفيدًا حتى إن لم تكن تقدّم كل الوظائف المطلوبة فورًا من العلبة.
ومشاريع المصادر المفتوحة قابلة للتمديد بالتعريف، إذ يستطيع أي شخص أخذ الشيفرة وإضافة مزاياه الخاصة. لكن تعديل الشيفرة المصدرية الأصلية لمشروع يشرف عليه شخص آخر لا يندرج فقط ضمن النهج عالي التكلفة، بل لا يناسب أيضًا مشاركة امتدادك مع الآخرين. لذا تميل المشاريع الناجحة إلى تقديم أشكال من قابلية التمديد لا تتضمن تعديل الشيفرة الأساسية، وGHC ليس استثناءً في ذلك.
قواعد إعادة الكتابة التي يعرّفها المستخدم
جوهر GHC هو تسلسل طويل من تمريرات التحسين، تنفّذ كل منها تحويلًا ما حافظًا على الدلالات من Core إلى Core. لكن مؤلف المكتبة يعرّف دوال تملك تحويلات خاصة بها غير تافهة ومختصة بمجالها، وهي تحويلات لا يمكن لـ GHC توقّعها إطلاقًا. ولذلك يسمح GHC لمؤلفي المكتبات بتعريف قواعد إعادة كتابة (rewrite rules) تُستخدم لإعادة كتابة البرنامج أثناء التحسين PTH01. وبهذه الطريقة يستطيع المبرمجون، بصورة فعلية، توسيع GHC بتحسينات مختصرة بمجالاتهم.
ومن الأمثلة قاعدة foldr/build، وتُعبَّر هكذا:
{-# RULES "fold/build"
    forall k z (g::forall b. (a->b->b) -> b -> b) .
       foldr k z (build g) = g k z
 #-}
القاعدة كلها تعليمة توجيه (pragma) تبدأ بـ {-# RULES. وتقول القاعدة إنه متى رأى GHC التعبير (foldr k z (build g)) فينبغي أن يعيد كتابته إلى (g k z). وهذا التحويل حافظ للدلالات، لكن إثباته يحتاج إلى ورقة بحثية GLP93، فلا سبب تقريبًا لأن يؤديه GHC من تلقاء نفسه. ومع بضع القواعد الأخرى وبعض تعليمات INLINE، يتمكّن GHC من دمج دوال تحويل القوائم معًا في وحدة واحدة. فمثلًا، تُدمج الحلقتان في (map f (map g xs)) في حلقة واحدة.
ورغم أن قواعد إعادة الكتابة بسيطة وسهلة الاستخدام، إلا أنها أثبتت أنها آلية تمديد قوية جدًا. فعندمّا أدخلنا هذه الميزة إلى GHC قبل عشر سنوات، توقعنا أنها ستكون مرفقًا مفيدًا من حين لآخر. لكن في الممارسة العملية تبيّن أنها مفيدة في مكتبات بالغة العدد، التي تعتمد كفاءتها غالبًا اعتمادًا حاسمًا على قواعد إعادة الكتابة. فمثلًا، تحتوي مكتبة base الخاصة بـ GHC على أكثر من 100 قاعدة، بينما تستخدم مكتبة vector الرائجة عشرات منها.
إضافات المُصرِّف
إحدى الطرق التي يمكن بها أن يوفّر مُصرِّف قابليةً للتمديد هي السماح للمبرمجين بكتابة تمريرة تُدرَج مباشرةً في خط أنابيب المُصرِّف. وكثيرًا ما تسمّى هذه التمريرات «الإضافات» (plugins). ويدعم GHC الإضافات بالطريقة التالية:
- يكتب المبرمج تمريرة من
CoreإلىCore، بوصفها دالة هاسكل عادية في وحدة نمطية، ولنقلP.hs، ثم يصرّفها إلى شيفرة كائنات. - وعند تصريف وحدة نمطية ما، يستخدم المبرمج الراية
-plugin Pفي سطر الأوامر. (أو بدلًا من ذلك يمكنه وضع الراية في تعليمة توجيه في بداية الوحدة النمطية.) - يبحث GHC عن
P.o، ويربطها ديناميكيًا داخل ملف GHC التنفيذي الجاري، ثم يستدعيها عند النقطة المناسبة في خط الأنابيب.
لكن ما «النقطة المناسبة في خط الأنابيب»؟ لا يعرف GHC ذلك، ولذلك يترك للإضافة أن تتّخذ هذا القرار. ونتيجةً لذلك ولأمور أخرى، تكون واجهة الـ API التي يجب أن تقدّمها الإضافة أعقد قليلًا من دالة واحدة من Core إلى Core—لكن ليس إلى هذا الحد.
وتحتاج الإضافات أحيانًا إلى بيانات مساعدة خاصة بها، أو تُنتجها. فمثلًا، قد تُجري إضافة ما تحليلًا على دوال الوحدة النمطية الجاري تصريفها (M.hs مثلًا)، وقد ترغب في وضع تلك المعلومات في ملف الواجهة M.hi، لتتمكّن الإضافة من الوصول إليها عند تصريف وحدات تستورد M. ويوفّر GHC آلية تعليقات توضيحية (annotations) لدعم ذلك.
والإضافات والتعليقات التوضيحية حديثة نسبيًا بالنسبة إلى GHC. فعتبة الدخول إليها أعلى من عتبة قواعد إعادة الكتابة، لأن الإضافة تتلاعب ببنى بيانات GHC الداخلية، لكنها بالطبع تستطيع أن تفعل الكثير. ويبقى أن نرى مدى انتشار استخدامها.
GHC بوصفه مكتبة: واجهة GHC البرمجية
كان أحد أهداف GHC الأصلية أن يكون أساسًا معياريًا (modular) يستطيع غيرنا البناء عليه. أردنا أن تكون شيفرة GHC شفافة وموثَّقة قدر الإمكان، لتُستخدم أساسًا لمشاريع بحثية من جانب آخرين؛ وتخيّلنا أن الناس سيرغبون في إجراء تعديلاتهم الخاصة على GHC لإضافة سمات أو تحسينات تجريبية جديدة. وقد ظهرت بالفعل بعض الأمثلة على ذلك: فهناك نسخة من GHC بواجهة أمامية Lisp، وهناك نسخة من GHC تولّد شيفرة Java، طُوّرت كلتاهما بصورة منفصلة تمامًا من أشخاص كان بينهم اتصال قليل أو لا اتصال بفريق GHC.
غير أن إنتاج نسخ معدَّلة من GHC لا يمثّل سوى مجموعة صغيرة من طرائق إعادة استخدام شيفرة GHC. ومع نمو رواج لغة هاسكل، تزايدت الحاجة إلى أدوات وبنية تحتية تفهم الشيفرة المصدرية لهاسكل، ويحتوي GHC بالطبع على كثير من الوظائف اللازمة لبناء هذه الأدوات: محلّل لهاسكل، وصيغة مجرّدة، وفاحص أنواع، وغيرها.
وفي هذا السياق، أجرينا تغييرًا بسيطًا على GHC: بدلًا من بناء GHC بوصفه برنامجًا أحاديًا، نبنيه بوصفه مكتبة، تُربط بعدها بوحدة نمطية صغيرة اسمها Main لإنتاج ملف GHC التنفيذي نفسه، لكن تُشحن أيضًا في صورة مكتبة يستدعيها المستخدمون من برامجهم الخاصة. وفي الوقت نفسه بنينا واجهة برمجية (API) لعرض وظائف GHC للعملاء. وتوفّر هذه الواجهة ما يكفي من الوظائف لتنفيذ مُصرِّف GHC الدفعي وبيئة GHCi التفاعلية، لكنها تتيح أيضًا الوصول إلى تمريرات منفردة مثل المحلّل وفاحص الأنواع، وتسمح بفحص بنى البيانات التي تنتجها هذه التمريرات. وقد أنتج هذا التغيير مجموعة واسعة من الأدوات المبنية باستخدام واجهة GHC البرمجية، ومنها:
- أداة توثيق، Haddock، تقرأ الشيفرة المصدرية لهاسكل وتنتج توثيقًا بصيغة HTML.
- إصدارات جديدة من الواجهة الأمامية لـ GHCi مع سمات إضافية؛ مثل ghci-haskeline الذي أُدمج لاحقًا في GHC.
- بيئات تطوير متكاملة توفّر تنقّلًا متقدمًا في الشيفرة المصدرية لهاسكل؛ مثل Leksah.
- hint، وهي واجهة برمجية أبسط للتقييم الفوري (on-the-fly) للشيفرة المصدرية لهاسكل.
نظام الحِزَم
كان نظام الحِزَم عاملًا جوهريًا في نمو استخدام لغة هاسكل في السنوات الأخيرة. وغايته الرئيسة تمكين مبرمجي هاسكل من تبادل الشيفرة فيما بينهم، ومن ثمّ فهو جانب مهمّ من جوانب قابلية التمديد: إذ يوسّع نظام الحِزَم قاعدة الشيفرة المشتركة إلى ما يتجاوز GHC نفسه.
ويتجسّد نظام الحِزَم في مجموعة من البنى التحتية التي تجعل تبادل الشيفرة سهلًا. وبفضل نظام الحِزَم كعامل ميسِّر، بنى المجتمع قاعدة كبيرة من الشيفرة المشتركة؛ فبدلًا من الاعتماد على مكتبات من مصدر واحد، يستمدّ مبرمجو هاسكل مكتباتهم من إنتاج المجتمع بأسره. وقد نجح هذا النموذج جيدًا في لغات أخرى؛ مثل CPAN في Perl، وإن كان هاسكل، بوصفه لغة مُصرَّفة في المقام الأول لا مُفسَّرة، يطرح مجموعة مختلفة نوعًا ما من التحديات.
وبالأساس، يتيح نظام الحِزَم للمستخدم إدارة مكتبات الشيفرة المكتوبة بلغة هاسكل من قبل أشخاص آخرين، واستخدامها في برامجه ومكتباته الخاصة. وتثبيت مكتبة هاسكل لا يتجاوز أمرًا واحدًا، مثل:
$ cabal install zlib
ينزّل هذا الأمر شيفرة حزمة zlib من http://hackage.haskell.org، ويصرّفها باستخدام GHC، ويثبّت الشيفرة المُصرَّفة في مكان ما على نظامك (مثلًا في دليل المنزل على نظام Unix)، ويسجّل التثبيت لدى GHC. وعلاوةً على ذلك، إذا كانت zlib تعتمد على أي حِزَم أخرى لم تُثبَّت بعد، فسيجري تنزيلها وتصريفها وتثبيتها تلقائيًا قبل تصريف zlib نفسها. وهذه طريقة سلسة للغاية للعمل مع مكتبات الشيفرة المكتوبة بلغة هاسكل والمشاركة من قبل الآخرين.
ويتألف نظام الحِزَم من أربعة مكوّنات، ليس الأول منها إلا جزءًا صارمًا من مشروع GHC:
- أدوات لإدارة قاعدة بيانات الحِزَم (package database)، وهي في جوهرها مستودع لمعلومات عن الحِزَم المثبَّتة على نظامك. ويقرأ GHC قاعدة بيانات الحِزَم عند بدء تشغيله، كي يعرف ما هي الحِزَم المتاحة وأين يجدها.
- مكتبة اسمها
Cabal(Common Architecture for Building Applications and Libraries)، توفّر وظائف بناء الحِزَم الفردية وتثبيتها وتسجيلها. - موقع على http://hackage.haskell.org يستضيف حِزَم كتبها المستخدمون ورفعوها. ويبني الموقع تلقائيًا توثيقًا للحِزَم يمكن تصفّحه عبر الإنترنت. وعند كتابة هذا الفصل، يستضيف Hackage أكثر من 3,000 حزمة تشمل وظائف من بينها مكتبات قواعد بيانات، وأطر عمل ويب، ومجموعات أدوات واجهات رسومية، وبنى بيانات، وشبكيات.
- الأداة
cabalالتي تربط موقع Hackage بمكتبةCabal: فهي تنزّل الحِزَم من Hackage، وتحلّ التبعيات، وتبني الحِزَم ويثبّتها بالترتيب الصحيح. ويمكن كذلك رفع حِزَم جديدة إلى Hackage باستخدامcabalمن سطر الأوامر.
وقد طُوِّرت هذه المكوّنات على مدى عدّة سنوات من قِبل أعضاء مجتمع هاسكل وفريق GHC، وهي معًا تشكّل نظامًا ينسجم تمامًا مع نموذج تطوير المصادر المفتوحة. فلا توجد عوائق أمام تبادل الشيفرة أو استخدام شيفرة تبادلها الآخرون (ما دمت تحترم التراخيص ذات الصلة، بالطبع). ويمكنك استخدام حزمة كتبها شخص آخر حرفيًا خلال ثوانٍ من العثور عليها على Hackage.
ولقد نجح Hackage إلى حدّ كبير بحيث أصبحت المشكلات المتبقية لديه اليوم مشكلات حجم (scale): فالمستخدمون يجدون صعوبة في الاختيار من بين أطر عمل قواعد البيانات الأربعة المختلفة، مثلًا. والتطويرات الجارية تهدف إلى حلّ هذه المشكلات بطرق تستثمر المجتمع. فمثلًا، السماح للمستخدمين بالتعليق على الحِزَم والتصويت عليها سيجعل العثور على أفضل الحِزَم وأكثرها رواجًا أسهل، وجمع بيانات عن نجاح عمليات البناء أو فشلها من المستخدمين وإبلاغهم بتلك النتائج سيساعدهم على تجنّب الحِزَم التي لا تُصان أو التي بها مشكلات.
5.5. نظام وقت التشغيل
نظام وقت التشغيل مكتبة من شيفرة C في معظمها، تُربط بكل برنامج هاسكل. وهي توفّر البنية التحتية اللازمة لتشغيل شيفرة هاسكل المُصرَّفة، بما في ذلك المكوّنات الرئيسة التالية:
- إدارة الذاكرة، بما في ذلك مُجمِّع قمامة متوازٍ ومتعدّد الأجيال؛
- إدارة الخيوط وجدولتها؛
- العمليات الأولية (primitive operations) التي يوفّرها GHC؛
- مُفسِّر شيفرة فرعية (bytecode) ورابط ديناميكي من أجل GHCi.
ينقسم بقية هذا القسم إلى قسمين: أولًا نركّز على جانبين من جوانب تصميم RTS نعدّهما ناجحين وأساسيين في جعله يعمل على هذا النحو الجيّد، وثانيًا نتحدث عن ممارسات البرمجة والبنية التحتية التي بنيناها داخل RTS للتعامل مع ما يُعدّ بيئةً برمجية معادية إلى حدّ كبير.
القرارات التصميمية الأساسية
في هذا القسم نصف قرارين من قرارات التصميم في RTS نعدّهما ناجحين إلى حدّ خاص.
طبقة الكتل
بُني مُجمِّع القمامة فوق طبقة كتل (block layer) تدير الذاكرة بوحدات من الكتل، حيث الكتلة مضاعف لحجم 4 كيلوبايت. وللطبقة واجهة برمجية بسيطة جدًا:
typedef struct bdescr_ {
    void *               start;
    struct bdescr_ *     link;
    struct generation_ * gen;   // generation
    // .. various other fields
} bdescr;

bdescr * allocGroup (int n);
void     freeGroup  (bdescr *p);
bdescr * Bdescr     (void *p);  // a macro
هذه هي الواجهة الوحيدة التي يستخدمها مُجمِّع القمامة لتخصيص الذاكرة وتحريرها. فتُخصَّص كتل الذاكرة عبر allocGroup وتُحرَّر عبر freeGroup. ولكل كتلة بنية بيانات صغيرة مرتبطة بها تُسمّى واصف الكتلة (bdescr). وتُعيد العملية Bdescr(p) واصف الكتلة المرتبط بعنوان اعتباطي p؛ وهي في جوهرها مجرد حساب للعنوان بالاعتماد على قيمة p، وتُصرَّف إلى حفنة من تعليمات الحساب ومعالجة البتّات.
ويمكن ربط الكتل معًا في سلاسل باستخدام حقل link في bdescr، وهنا تكمن القوة الحقيقية للتقنية. فمُجمِّع القمامة يحتاج إلى إدارة عدّة مناطق ذاكرة متمايزة مثل الأجيال، وقد تحتاج كل منطقة من هذه المناطق إلى النمو أو الانكماش مع الوقت. وبتمثيل مناطق الذاكرة بوصفها قوائم مرتبطة من الكتل، يتحرّر مُجمِّع القمامة من صعوبات احتواء مناطق ذاكرة متعددة قابلة لتغيير الحجم داخل مساحة عناوين مسطّحة.
وتستخدم تنفيذات طبقة الكتل تقنيات معروفة جيدًا من واجهة malloc()/free() الخاصة بلغة C؛ فهي تحتفظ بقوائم من الكتل الحرّة بأحجام مختلفة، وتدمج المناطق الحرّة معًا. وقد صُمِّمت العمليتان freeGroup() وallocGroup() بعناية لتكونا O(1).
ومن المزايا الرئيسة لهذا التصميم أنه يحتاج إلى قدر ضئيل جدًا من الدعم من نظام التشغيل، لذا فهو ممتاز لقابلية النقل. تحتاج طبقة الكتل إلى تخصيص ذاكرة بوحدات 1 ميغابايت، محاذاة على حدّ 1 ميغابايت. ولا يوفّر أيٌّ من أنظمة التشغيل الشائعة هذه الوظيفة مباشرةً، لكنها قابلة للتنفيذ دون صعوبة كبيرة بالاعتماد على ما توفّره فعلًا. والعائد هو أن GHC لا يعتمد على تفاصيل تخطيط مساحة العناوين الذي يستخدمه نظام التشغيل، وأنه يتعايش بسلام مع مستخدمي مساحة العناوين الآخرين، مثل المكتبات المشتركة وخيوط نظام التشغيل.
وهناك ثمن تعقيد صغير مُقدَّم لطبقة الكتل، يتمثّل في إدارة سلاسل الكتل بدلًا من الذاكرة المتصلة. غير أننا وجدنا أن هذا الثمن يُسدَّد أكثر منه مرة في المرونة وقابلية النقل؛ فمثلًا، مكّنت طبقة الكتل تنفيذ خوارزمية بالغة البساطة لمُجمِّع القمامة المتوازي MHJP08.
الخيوط خفيفة الوزن والتوازي
نعدّ التزامن (concurrency) تجريدًا برمجيًا بالغ الأهمية، ولا سيما عند بناء تطبيقات مثل خوادم الويب التي تحتاج إلى التفاعل مع أعداد كبيرة من الجهات الخارجية في الوقت نفسه. فإذا كان التزامن تجريدًا مهمًّا، فينبغي ألّا يكون باهظ التكلفة إلى حدّ يضطر المبرمجين إلى تجنّبه، أو إلى بناء بنية تحتية معقّدة لاستهلاك تكلفته (مثل مجمّعات الخيوط). ونعتقد أن التزامن ينبغي أن يعمل كما ينبغي، وأن يكون رخيصًا بما يكفي كي لا تشغل ببالك عند إنشاء خيوط للمهام الصغيرة.
وتوفّر كل أنظمة التشغيل خيوط تعمل على أكمل وجه؛ والمشكلة أنها باهظة التكلفة إلى حدّ كبير. فأنظمة التشغيل النموذجية تعاني في الغالب من صعوبة التعامل مع آلاف الخيوط، في حين نريد أن نُدير الخيوط بالمئات الآلاف.
والخيوط الخضراء (green threads)، وتُعرف أيضًا بالخيوط خفيفة الوزن أو خيوط مساحة المستخدم، تقنية معروفة جيدًا لتجنّب الحمل الزائد لخيوط نظام التشغيل. والفكرة أن تُدار الخيوط من البرنامج نفسه، أو من مكتبة (في حالتنا RTS)، بدلًا من نظام التشغيل. وإدارة الخيوط في مساحة المستخدم ينبغي أن تكون أقل كلفة، لأنها تتطلّب اعتراضات (traps) أقل لدخول نظام التشغيل.
وفي RTS الخاص بـ GHC نستفيد من هذه الفكرة إلى أقصى حدّ. فلا يقع تبديل السياق إلا عندما يكون الخيط عند نقطة آمنة (safe point)، حيث لا يلزم حفظ قدر ضئيل جدًا من الحالة الإضافية. ولأننا نستخدم مُجمِّع قمامة دقيقًا (accurate GC)، يمكن نقل مكدّس الخيط وتوسيعه أو تصغيره عند الحاجة. وقارن ذلك بخيوط نظام التشغيل، حيث يجب على كل تبديل سياق أن يحفظ حالة المعالج كاملة، وحيث تكون المكدّسات غير قابلة للنقل، فينبغي حجز جزء كبير من مساحة العناوين مسبقًا لكل خيط.
ويجوز أن تكون الخيوط الخضراء أكثر كفاءة إلى حد بعيد من خيوط نظام التشغيل، فلماذا يودّ أحد استخدام خيوط نظام التشغيل؟ الأمر يعود إلى ثلاث مشكلات رئيسة:
- الحجب والاستدعاءات الأجنبية. ينبغي أن يتمكّن الخيط من إجراء استدعاء إلى واجهة برمجية لنظام التشغيل أو إلى مكتبة أجنبية تحجب، دون أن تحجب جميع الخيوط الأخرى في النظام.
- التوازي. ينبغي أن تعمل الخيوط تلقائيًا على التوازي إذا كانت في النظام أنوية معالجات متعددة.
- بعض المكتبات الخارجية (مثل OpenGL وبعض مكتبات واجهات المستخدم الرسومية) لها واجهات برمجية يجب استدعاؤها من خيط نظام التشغيل نفسه في كل مرة، لأنها تستخدم حالة خاصة بالخيط.
ويبيّن أن ترتيب كل هذه الأمور مع الخيوط الخضراء صعب. ومع ذلك، ثابرنا على الخيوط الخضراء في GHC ووجدنا حلولًا للثلاثة جميعها:
- عندما يُجري خيط هاسكل استدعاءً أجنبيًا، يتولّى خيط آخر من خيوط نظام التشغيل تنفيذ بقية خيوط هاسكل MPT04. وتُحفظ مجموعة صغيرة من خيوط نظام التشغيل لهذا الغرض، وتُنشأ خيوط جديدة عند الحاجة.
- تجدول جدولةُ GHC عددًا كبيرًا من خيوط هاسكل خفيفة الوزن على حفنة من خيوط نظام التشغيل ثقيلة الوزن؛ فهي تنفّذ نموذج خيوط M:N شفافًا. وعادةً ما يُختار N مساويًا لعدد أنوية المعالجات في الآلة، ما يسمح بوقوع توازٍ حقيقي، من دون أن يتطلّب كل خيط هاسكل خفيف الوزن خيط نظام تشغيل كامل من أجله. ولنفّذ شيفرة هاسكل، لا بد من أن يحمل خيط نظام التشغيل قدرة (Capability): وهي بنية بيانات تحتفظ بالموارد اللازمة لتنفيذ شيفرة هاسكل، مثل الحوض (nursery) وهو الذاكرة التي تُنشأ فيها الكائنات الجديدة. ولا يمكن أن يحمل أكثر من خيط نظام تشغيل واحد القدرة نفسها في الوقت نفسه. (وقد سمّيناها أيضًا «سياق تنفيذ هاسكل»، لكن الشيفرة تستخدم حاليًا مصطلح Capability.)
- ونوفّر واجهة برمجية لإنشاء خيط مربوط (bound thread): وهو خيط هاسكل مرتبط بخيط نظام تشغيل محدّد، بحيث تكون كل الاستدعاءات الأجنبية التي يُجريها هذا الخيط هاسكل مضمونةً أن تجري عبر ذلك الخيط نفسه.
وإذن في الغالبية العظمى من الحالات، تتصرّف خيوط هاسكل تمامًا كخيوط نظام التشغيل: تستطيع إجراء استدعاءات نظام تشغيل حاجبة دون التأثير في الخيوط الأخرى، وتعمل بالتوازي على آلة متعددة الأنوية. لكنها أكثر كفاءة بدرجات من حيث الوقت والمساحة معًا.
ومع ذلك، فإن التنفيذ ينزلق إلى مشكلة واحدة يصطدم بها المستخدمون أحيانًا، ولا سيما عند تشغيل اختبارات الأداء (benchmarks). فقد ذكرنا أعلاه أن الخيوط خفيفة الوزن تشتقّ بعض كفاءتها من أنها لا تبدّل السياق إلا عند «النقاط الآمنة»، أي المواضع التي يسمّيها المُصرِّف آمنة، حيث تكون الحالة الداخلية للآلة الافتراضية (مكدّس، كومة، سجلات، إلخ) في حالة مرتّبة ويمكن أن يجري جمع القمامة. وفي GHC، تكون النقطة الآمنة كلما خُصِّصت ذاكرة، وهو أمر في كل برامج هاسكل تقريبًا يحدث بانتظام كافٍ بحيث لا ينفّذ البرنامج أكثر من بضعة عشرات من التعليمات دون بلوغ نقطة آمنة. غير أنه من الممكن في الشيفرة شديدة التحسين أن توجد حلقات تعمل عدّة تكرارات دون تخصيص ذاكرة. ويحدث هذا غالبًا في اختبارات الأداء (مثل دوال المضروب والمتتالية الفيبوناتشي). وهو يحدث أقل في الشيفرة الواقعية، وإن كان يقع أحيانًا. وغياب النقاط الآمنة يمنع الجدولة من العمل، وقد يكون لهذا آثار ضارة. ومن الممكن حل هذه المشكلة، لكن ليس دون التأثير في أداء تلك الحلقات، وغالبًا ما يهتمّ الناس بتوفير كل دورة في حلقاتهم الداخلية. وقد يكون هذا ببساطة تنازلًا علينا القبول به.
5.6. تطوير GHC
GHC مشروع واحد ذو عمر يمتد عشرين عامًا، ولا يزال في خضم الابتكار والتطوير. وقد كانت بنيتنا التحتية وأدواتنا، في معظمها، تقليدية. فمثلًا، نستخدم متتبّعًا للأخطاء (Trac)، وموسوعة معرفية (أيضًا Trac)، وGit للتحكّم في المراجعات. (وقد تطوّرت آلية التحكّم في المراجعات هذه من التتبّع اليدوي البحت، ثم CVS، ثم Darcs، قبل أن تنتقل أخيرًا إلى Git عام 2010.) وهناك بضع نقاط قد لا تكون شائعة، فنعرضها هنا.
التعليقات والملاحظات
من أشدّ الصعوبات في مشروع كبير طويل الأمد إبقاء التوثيق الفني محدَّثًا. ليس لدينا حلّ سحري، لكننا نقدّم آلية منخفضة التقنية أثبتت فاعليتنا بشكل لافت، وهي Notes.
وعند كتابة الشيفرة، كثيرًا ما تمرّ بالمبرمج الدقيق لحظة يقول فيها ذهنيًا شيئًا مثل: «هذا النوع من البيانات له ثبات مهمّ». وهي أمام خيارين، كلاهما غير مُرضٍ. تستطيع أن تُضيف الثبات كتعليق، لكن ذلك قد يجعل تعريف نوع البيانات طويلًا لدرجة يصعب معها تمييز بانياته. أو تستطيع أن توثّق الثابت في موضع آخر، على أن تحتمل خطر أن يصبح قديمًا. فخلال عشرين عامًا، كل شيء يصبح قديمًا!
وبهذا الدافع طوّرنا الاصطلاح التالي البسيط جدًا:
فتعليقات أي حجم ذي معنى لا تُمزج مع الشيفرة، بل تُفرد وحدها بعنوان بالصيغة القياسية، هكذا:
  Note [Equality-constrained types]
  ~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~
  The type   forall ab. (a ~ [b]) => blah
  is encoded like this:

     ForAllTy (a:*) $ ForAllTy (b:*) $
     FunTy (TyConApp (~) [a, [b]]) $
     blah
وفي الموضع الذي يكون فيه التعليق ذا صلة، نضيف تعليقًا قصيرًا يُحيل إلى الملاحظة:
 data Type
   = FunTy Type Type -- See Note [Equality-constrained types]

   | ...
يُبرز التعليق وجود أمر مثير للاهتمام، ويقدّم إحالة دقيقة إلى التعليق الذي يشرحه. ويبدو الأمر تافهًا، لكن هذه الدقة أفضل بكثير من عادتنا السابقة في القول «انظر التعليق أعلاه»، لأن أيّ التعليقات التي في الأعلى كان مقصودًا لم يكن واضحًا في غالبية الأحيان، وبعد بضع سنوات لم يكن التعليق في الأعلى أصلًا (كان في الأسفل، أو اختفى تمامًا).
وليس فقط من الممكن الانتقال من الشيفرة التي تُشير إلى Note إلى Note نفسها، بل العكس ممكن أيضًا، وهو غالبًا مفيد. وعلاوةً على ذلك، قد تُحال إلى Note نفسها من مواضع متعدّدة في الشيفرة.
وهذه التقنية البسيطة، القائمة على ASCII وحده، ودون أي دعم آلي، غيّرت حياتنا: لدى GHC نحو 800 Note، والعدد ينمو يومًا بعد يوم.
كيف نواصل إعادة الهيكلة
- لا بديل عن هندسة البرمجيات الجيّدة. فالتقسيم إلى وحدات (modularity) يُثمر دائمًا: فتصغير الواجهات البرمجية (APIs) بين المكوّنات إلى أدنى حدّ يجعل المكوّنات المنفردة أكثر مرونة لأنها تترابط فيما بينها بدرجة أقلّ. فمثلًا، صغر نوع بيانات
Core{}في GHC يقلّل الترابط بين تمريرات Core-to-Core، إلى حدّ أنها شبه مستقلة تمامًا ويمكن تشغيلها بأي ترتيب. - التطوير بلغة ذات أنواع قوية يجعل إعادة الهيكلة نسيمًا. فكلما احتجنا إلى تغيير نوع بيانات، أو تغيير عدد وسائط دالة أو نوعها، أبلغنا المُصرِّف فورًا بالمواضع الأخرى في الشيفرة التي تحتاج إلى إصلاح. فمجرد وجود ضمان قاطع بأن فئة كبيرة من الأخطاء قد استُبعدت على نحو ثابت يوفّر وقتًا هائلًا، ولا سيما عند إعادة الهيكلة. ومن المخيف تخيّل كم من حالات الاختبار المكتوبة يدويًا كان علينا تقديمها لتغطّي المستوى نفسه الذي توفّره نظام الأنواع.
- عند البرمجة بلغة خالصة وظيفية، يصعب إدخال اعتماديات عرضية عبر الحالة. فإذا قرّرت فجأة أنك تحتاج إلى الوصول إلى جزء من الحالة في أعماق خوارزمية ما، فإنك في لغة أمرية قد تغري بأن تجعل الحالة مرئية عالميًا بدلًا من تمريرها صراحةً إلى الموضع الذي يحتاجها. ويؤدي هذا في النهاية إلى تشابك من الاعتماديات الخفية، وإلى شيفرة هشّة (brittle code): شيفرة تنكسر بسهولة عند التعديل. والبرمجة الخالصة الوظيفية تفرض عليك جعل كل الاعتماديات صريحة، وهو ما يفرض ضغطًا سالبًا نوعًا ما على إضافة اعتماديات جديدة، وقلة الاعتماديات تعني معيارية أكبر. ومن المؤكد أن إضافة اعتمادية جديدة ضرورة تفرض عليك النقاء أن تكتب شيفرة أطول للتعبير عن تلك الاعتمادية، لكن في رأينا هذا ثمن يستحق الدفع مقابل صحة قاعدة الشيفرة على المدى الطويل. ومن الفوائد الإضافية أن الشيفرة الخالصة الوظيفية آمنة مع الخيوط بحكم بنيتها، وتنحو بطبعها إلى أن تكون أسهل في التوازي.
الجريمة لا تُجدي
إذا رجعنا إلى التغييرات التي اضطررنا إلى إجراءها في GHC مع نموه، يبرز درس شائع: كون الشيفرة أقلّ من خالصة وظيفية، سواء لأغراض الكفاءة أو الراحة، يميل إلى نتائج سلبية في الأجل الطويل. ولدينا مثالان رائعان على ذلك:
-
يستخدم GHC بضع بنى بيانات تعتمد داخليًا على التغيّر (mutation). أحدها النوع
FastStringالذي يستخدم جدول تجزئة عامًّا واحدًا؛ والآخر ذاكرة تخزين مؤقت عامةNameCacheتضمن إسناد رقم فريد لكل الأسماء الخارجية. وعندما حاولنا موازاة GHC (أي جعل GHC يصرّف عدّة وحدات نمطية بالتوازي على معالج متعدد الأنوية)، كانت بنى البيانات هذه القائمة على التغيّر هي العقبات الوحيدة. ولو لم نلجأ إلى التغيّر في هذه المواضع، لكان موازنة GHC أمرًا تافهًا تقريبًا. وفي الواقع، رغم أننا بنينا نسخة نموذجية متوازية من GHC، فإن GHC لا يحتوي حاليًا على دعم للتصريف المتوازي، لكن هذا يعود في معظمه إلى أننا لم نستثمر بعد الجهد اللازم لجعل بنى البيانات القابلة للتغيّر آمنة مع الخيوط. -
يتصرّف GHC إلى حدٍّ كبير وفق رايات سطر الأوامر. وهذه الرايات ثابتة بالتعريف طوال عملية تشغيل معيّنة لـ GHC، لذا في الإصدارات المبكرة من GHC جعلنا قيم هذه الرايات متاحة كثوابت عليا. فمثلًا، كانت هناك قيمة عليا
opt_GlasgowExtsمن النوعBool، تتحكّم في ما إذا كان ينبغي تفعيل امتدادات لغة معيّنة من عدمها. والثوابت العليا ملائمة إلى حدّ بعيد، لأن قيمها لا يلزم تمريرها صراحةً كوسائط إلى كل الشيفرة التي تحتاج إلى الوصول إليها. وبالطبع هذه الخيارات ليست ثوابت بالمعنى الحرفي، لأنها تتغيّر من تشغيل لآخر، وتعريفopt_GlasgowExtsيستلزم استدعاءunsafePerformIOلأنه يُخفي أثرًا جانبيًا. ومع ذلك، تُعتبر هذه الحيلة عادةً «آمنة بما يكفي» لأن القيمة ثابتة في أي تشغيل بعينه؛ فهي لا تُبطل تحسينات المُصرِّف مثلًا. غير أن GHC استُخدم لاحقًا بوصفه مُصرِّفًا من وحدة نمطية واحدة إلى مُصرِّف متعدد الوحدات النمطية. وعند هذه النقطة انكسرت حيلة استخدام الثوابت العليا للرايات، لأن الرايات قد تكون لها قيم مختلفة عند تصريف الوحدات النمطية المختلفة. لذا اضطررنا إلى إعادة هيكلة كميات كبيرة من الشيفرة لتمرير الرايات صراحةً. ولعلّك قد تجادل بأن معالجة الرايات بوصفها حالة (state) من الأساس، كما هو طبيعي في لغة أمرية، كانت ستجنّب المشكلة. والقول صحيح إلى حدٍّ ما، وإن كانت الشيفرة الخالصة الوظيفية تمتلك فوائد أخرى لا تُحصى، وأبرزها أن تمثيل الرايات ببنية بيانات غير قابلة للتغيير يعني أن الشيفرة الناتجة آمنة مع الخيوط أصلًا وستعمل بالتوازي دون تعديل.
تطوير RTS
يُقدّم نظام وقت التشغيل في GHC تباينًا حادًّا مع المُصرِّف في جوانب كثيرة. وهناك الفرق البديهي أن نظام وقت التشغيل مكتوب بلغة C لا بلغة هاسكل، لكن هناك أيضًا اعتبارات خاصة بـ RTS وحده تفضي إلى فلسفة تصميم مختلفة:
- يقضي كل برنامج هاسكل وقتًا طويلًا في تنفيذ شيفرة داخل RTS: 20--30% هو المعتاد، لكن سمات برامج هاسكل تتغيّر كثيرًا لذا فإن أرقامًا أكبر أو أصغر من هذا المدى شائعة أيضًا. وكل دورة نوفّرها بتحسين RTS تتضاعف مرارًا، لذا من المفيد بذل وقت وجهد كبيرين لوفرتها.
- نظام وقت التشغيل مربوط ساكنًا داخل كل برنامج هاسكل (أي ما لم يُستخدم الربط الديناميكي)، لذا هناك حافز لإبقائه صغيرًا.
- الأخطاء في نظام وقت التشغيل غالبًا ما تكون غامضة على المستخدم (مثل «خطأ تجزئة») ويصعب التحايل عليها. فمثلًا، أخطاء مُجمِّع القمامة لا ترتبط عادةً باستخدام سمة لغة بعينها، بل تنشأ عندما تبرز مجموعة معقّدة من العوامل أثناء التشغيل. وعلاوةً على ذلك، تميل أخطاء هذا النوع إلى أن تكون غير حتمية (لا تحدث إلا في بعض عمليات التشغيل)، وشديدة الحساسية (تغييرات ضئيلة في البرنامج تجعل الخطأ يختفي). وأخطاء النسخة متعددة الخيوط من نظام وقت التشغيل تطرح تحدّيات أكبر. لذا يستحق الأمر أن نذهب إلى أبعد حد لمنع هذه الأخطاء، وأن نبني أيضًا بنية تحتية تسهّل تحديدها. وأعراض خطأ في RTS غالبًا ما لا يمكن تمييزها عن نوعَي فشل آخرين: فشل عتادي في الأجهزة، وهو أكثر شيوعًا مما نظنّ، وسوء استخدام سمات هاسكل غير الآمنة مثل FFI (واجهة الدوال الأجنبية). وأول خطوة في تشخيص انهيار وقت التشغيل هي استبعاد هذين السببين الآخرين.
- RTS شيفرة منخفضة المستوى تعمل على عدة معماريات وأنظمة تشغيل مختلفة، وتُنقَل بانتظام إلى منصات جديدة. وقابلية النقل مهمة.
وكل دورة وكل بايت مهمّان، لكن الصواب أهمّ من ذلك. وعلاوةً على ذلك، المهام التي يؤدّيها نظام وقت التشغيل معقّدة بطبيعتها، لذا فإن الصواب صعب أصلًا. وأدى الجمع بين هذين الأمرين إلى بعض التقنيات الدفاعية المميزة، التي نصفها في الأقسام التالية.
التعامل مع التعقيد
يُعدّ RTS بيئة برمجية معقّدة ومعادية. وفي المقابل للمُصرِّف، يكاد RTS يخلو من أمان الأنواع. بل إن أمان الأنواع فيه أقلّ مما في معظم برامج C الأخرى، لأنه يدير بنى بيانات أنواعها تعيش على مستوى هاسكل لا على مستوى C. فمثلًا، لا يعرف RTS أن الكائن الذي يشير إليه ذيل خلية قائمة مترابطة (cons cell) هو إمّا [] وإمّا خلية مترابطة أخرى: فهذه المعلومة ببساطة غير موجودة على مستوى C. وعلاوةً على ذلك، فإن عملية تصريف شيفرة هاسكل تمحو الأنواع، فحتى لو أخبرنا RTS بأن ذيل الخلية المترابطة قائمة، لظلّ بلا أي معلومات عن المؤشّر في رأس الخلية. لذا تضطر شيفرة RTS إلى إجراء كثير من تحويلات أنواع مؤشّرات C، فتحصل على مساعدة ضئيلة جدًا من مُصرِّف C فيما يخصّ أمان الأنواع.
وإذن أول سلاح لنا في هذه المعركة هو تجنّب وضع الشيفرة في RTS. كلما أمكن، نضع الحد الأدنى من الوظائف في RTS ونكتب الباقي في مكتبة هاسكل. ونادرًا ما أثبت هذا الفشل؛ فشيفرة هاسكل أكثر متانةً وإيجازًا بكثير من C، والأداء مقبول عادةً تمامًا. وتحديد أين تُرسم الخط ليس علمًا دقيقًا، وإن كان واضحًا إلى حدّ معقول في حالات كثيرة. فمثلًا، بينما قد يكون من الممكن نظريًا تنفيذ مُجمِّع القمامة بلغة هاسكل، إلا أنه بالغ الصعوبة عمليًا لأن هاسكل لا تسمح للمبرمج بالسيطرة الدقيقة على تخصيص الذاكرة، لذا فإن النزول إلى C لهذا النوع من المهام منخفضة المستوى أمر منطقي عمليًا.
وهناك وظائف كثيرة لا يمكن تنفيذها (بسهولة) بلغة هاسكل، وكتابة الشيفرة داخل RTS أمر غير ممتع. وفي القسم التالي نركّز على جانب واحد من جوانب إدارة التعقيد والصواب داخل RTS: صيانة الثوابت.
الثوابت، والتحقّق منها
RTS مليء بالثوابت. وكثير منها بديهي وسهل التحقّق: فمثلًا، إذا كان المؤشّر إلى رأس طابور NULL، فينبغي أن يكون المؤشّر إلى ذيله NULL أيضًا. وشيفرة RTS مزيّنة بالتأكيدات (assertions) للتحقّق من هذه الأمور. والتأكيدات هي أداتنا المفضّلة للعثور على الأخطاء قبل أن تظهر؛ وفي الواقع، حين يُضاف ثابت جديد، نضيف التأكيد غالبًا قبل كتابة الشيفرة التي تنفّذ الثابت.
وبعض الثوابت في نظام وقت التشغيل أصعب بكثير في تحقيقها وفي التحقّق منها. وأحد هذه الثوابت الذي ينتشر في RTS أكثر من غيره هو التالي: لا توجد في الكومة مؤشّرات معلّقة (dangling pointers).
والمؤشّرات المعلّقة يسهل إدخالها، وهناك مواضع كثيرة في المُصرِّف وفي RTS نفسها يمكن أن تنتهك هذا الثابت.
فقد يولّد مولّد الشيفرة شيفرة تنشئ كائنات كومة غير صالحة؛ وقد ينسى مُجمِّع القمامة تحديث مؤشّرات كائن ما عند مسح الكومة.
وتتبّع أخطاء من هذا النوع يمكن أن يستهلك وقتًا بالغ الطول (وإن كان تتبّع الأخطاء من الأنشطة المفضّلة لدى أحد المؤلفين!).
والسبب في ذلك أن البرنامج، حين ينهار في النهاية، يكون قد تقدّم التنفيذ مسافة بعيدة عن الموضع الذي أُدخل فيه المؤشّر المعلّق أصلًا.
وتتوفّر أدوات تنقيض جيّدة، لكنها لا تجيد تشغيل البرنامج بالمقلوب. (غير أن إصدارات حديثة من GDB ومن مُنقِّح Visual Studio من Microsoft توفّر قدرًا من دعم التنفيذ بالمقلوب.)
والمبدأ العام هو: إذا كان برنامج ما سينهار، فينبغي أن ينهار في أقرب وقت، وأصوت صوت ممكن، وبأقصى تكرار ممكن.
(وهذا الاقتباس وارد في أدلة أسلوب البرمجة في GHC، وقد كتبه أصلًا Alastair Reid الذي عمل على نسخة مبكرة من RTS.)
والمشكلة أن ثبات «عدم وجود مؤشّرات معلّقة» ليس أمرًا يمكن التحقّق منه بتأكيد يتم في زمن ثابت؛ إذ يجب على التأكيد الذي يفحصه أن يمرّ على الكومة كلها! ومن البديهي أننا لا نستطيع تشغيل هذا التأكيد بعد كل تخصيص في الكومة، ولا في كل مرة يمسح فيها مُجمِّع القمامة كائنًا (بل إن ذلك لا يكفي أيضًا، إذ لا تظهر المؤشّرات المعلّقة إلا في نهاية دورة جمع القمامة، حين تُحرَّر الذاكرة).
لذلك فإن نسخة RTS المخصّصة للتنقيح لها نمطٌ اختياري نسمّيه فحص السلامة (sanity checking). ويتيح هذا الفحص تشغيل تأكيدات من كل الأنواع المكلفة، وقد يجعل البرنامج يعمل أبطأ بضعف.
وتحديدًا، يشغّل فحص السلامة مسحًا كاملًا للكومة للتحقّق من عدم وجود مؤشّرات معلّقة (فضلًا عن أمور أخرى)، قبل كل دورة جمع قمامة وبعدها.
وأول خطوة عند التحقيق في انهيار وقت التشغيل هي تشغيل البرنامج مع تفعيل فحص السلامة؛ وأحيانًا يكشف ذلك خرق الثوابط قبل أن ينهار البرنامج فعليًا بوقت طويل.
5.7. الخاتمة
استهلك GHC نسبة كبيرة من حياة المؤلفين خلال العشرين عامًا الماضية، ونحن فخورون إلى حدّ ما بما بلغه.
وهو ليس التنفيذ الوحيد للغة هاسكل، لكنه التنفيذ الوحيد الذي يستخدمه باستمرار مئات الآلاف من الأشخاص لإنجاز عمل حقيقي. ويستمرّ مندهشينا حين نكتشف هاسكل مستخدَمة في أماكن غير مألوفة؛ ومن الأمثلة الحديثة استخدامها للتحكّم في أنظمة شاحنة نفايات.
ولكثير من الناس، هاسكل وGHC مترادفان: ولم يكن هذا هو المقصود قط، بل إن وجود تنفيذ واحد فقط للغة قياسية أمر ضارّ في جوانب كثيرة؛ غير أن الواقع أن صيانة تنفيذ جيّد للغة برمجة عمل كبير.
ونأمل أن تجعل جهودنا في GHC، أي دعم المعيار والموازنة بوضوح بين كل امتداد لغوي مستقل، من الممكن ظهور تطبيقات أكثر واندماجها مع نظام الحِزَم وبنية تحتية أخرى.
والمنافسة خير للجميع!
ونحن ممتنون لشركة Microsoft على وجه الخصوص، لأنهم أتاحوا لنا الفرصة لتطوير GHC كجزء من أبحاثنا وتوزيعه بوصفه برمجيات مفتوحة المصدر.