بنية الويب القابلة للتوسّع والأنظمة الموزّعة
بنية تطبيقات المصادر المفتوحة (المجلد 2) هندسة الويب القابلة للتوسع والأنظمة الموزعة
بنية تطبيقات المصادر المفتوحة (المجلد 2) هندسة الويب القابلة للتوسع والأنظمة الموزعة
Kate Matsudaira
إن استمتعت بهذه الكتب، فقد تستمتع أيضًا بـتصميم البرمجيات بالأمثلة في Python وتصميم البرمجيات بالأمثلة في JavaScript.
صارت البرمجيات مفتوحة المصدر (open source software) لبنةً أساسية في بعض أكبر المواقع على الإنترنت. ومع نمو تلك المواقع، ظهرت الممارسات المثلى والمبادئ الموجِّهة لهندستها. يسعى هذا الفصل إلى تغطية بعض المسائل الجوهرية التي يجب مراعاتها عند تصميم المواقع الكبيرة، فضلًا عن بعض الوحدات الإنشائية المستخدمة لتحقيق هذه الأهداف.
يركّز هذا الفصل في معظمه على أنظمة الويب، وإن كانت بعض المواد تنطبق أيضًا على أنظمة موزّعة (distributed systems) أخرى.
1.1. مبادئ تصميم أنظمة الويب الموزعة
ما الذي يعنيه تمامًا بناء موقع أو تطبيق ويب قابل للتوسع وتشغيله؟ على المستوى البدائي، لا شيء سوى وصل المستخدمين بموارد بعيدة عبر الإنترنت—والجانب الذي يجعله قابلًا للتوسع هو أن الموارد، أو الوصول إلى تلك الموارد، موزّعة على عدة خوادم.
كما هو الحال في معظم أمور الحياة، فإن تخصيص وقت للتخطيط المسبق عند بناء خدمة ويب قد يفيد على المدى البعيد؛ وفهم بعض الاعتبارات والمفاضلات (trade-offs) الكامنة وراء المواقع الكبيرة قد يقود إلى قرارات أذكى عند إنشاء مواقع أصغر حجمًا. وفيما يلي بعض المبادئ الجوهرية التي تؤثر في تصميم أنظمة الويب واسعة النطاق:
- التوفر (availability): زمن إتاحة الموقع (uptime) جوهري تمامًا لسمعة كثير من الشركات ووظيفتها. فبالنسبة إلى بعض مواقع التجزئة الإلكترونية الأكبر، قد يؤدي التوقف حتى لدقائق قليلة إلى خسارة آلاف أو ملايين الدولارات من الإيرادات، ولذلك فإن تصميم أنظمة هذه المواقع لتكون متاحة باستمرار ومقاومة للأعطال شرط أساسي على المستويين التجاري والتقني معًا. ويتطلب التوفر العالي في الأنظمة الموزّعة مراعاة متأنّية لتكرار (redundancy) المكوّنات الجوهرية، وسرعة التعافي عند حدوث أعطال جزئية في النظام، والتدهور الرشيق (graceful degradation) عند وقوع المشكلات.
- الأداء (performance): صار أداء الموقع اعتبارًا مهمًا لمعظم المواقع. فسرعة الموقع تؤثر في الاستخدام ورضا المستخدمين، وكذلك في ترتيب نتائج محركات البحث، وهو عامل يرتبط مباشرةً بالإيرادات وبمعدل الاحتفاظ بالمستخدمين. وعليه فإن بناء نظام مضبوط من أجل استجابات سريعة وزمن استجابة منخفض (low latency) هو أمر جوهري.
- الموثوقية (reliability): يحتاج النظام إلى أن يكون موثوقًا، بحيث يعيد أي طلب للبيانات البيانات نفسها على نحو ثابت. وإذا تغيّرت البيانات أو حُدِّثت، فإن الطلب ذاته ينبغي أن يعيد البيانات الجديدة. ويحتاج المستخدمون إلى معرفة أن ما يُكتب في النظام أو يُخزَّن فيه سيبقى قائمًا ويمكن الاعتماد على وجوده للاسترجاع لاحقًا.
- قابلية التوسع (scalability): في أي نظام موزّع كبير، ليس الحجم سوى أحد أوجُه المقياس الذي يجب مراعاته. ولا يقلّ أهميةً عنه الجهد اللازم لزيادة السعة بما يفي بتحمّل أحمال أكبر، وهو ما يُشار إليه عادةً بقابلية توسّع النظام. وقد تشير قابلية التوسع إلى معاملات مختلفة كثيرة في النظام: كم من حركة المرور الإضافية يستطيع تحمّلها، وكم سهلًا إضافة سعة تخزين إضافية، بل وحتى كم من المعاملات الإضافية يمكن معالجتها.
- قابلية الإدارة (manageability): تصميم نظام يسهل تشغيله اعتبارٌ مهم آخر. فقابلية إدارة النظام تعادل قابلية تشغيله وتوثيقه: الصيانة والتحديثات. ومن المسائل التي ينبغي مراعاتها في قابلية الإدارة: سهولة تشخيص المشكلات وفهمها عند وقوعها، وسهولة إجراء التحديثات أو التعديلات، ومدى بساطة تشغيل النظام. (بمعنى: هل يعمل النظام بصورة اعتيادية من دون أعطال أو استثناءات؟)
- التكلفة (cost): التكلفة عامل مهم. ويجوز أن تشمل بوضوح تكاليف الأجهزة والبرمجيات، ومن المهم كذلك مراعاة الجوانب الأخرى اللازمة لنشر النظام وصيانته. ينبغي جميعًا مراعاة الوقت الذي يستغرقه المطورون لبناء النظام، والجهد التشغيلي اللازم لتشغيله، بل حتى حجم التدريب المطلوب. والتكلفة هي التكلفة الإجمالية للملكية (total cost of ownership).
كل مبدأ من هذه المبادئ يوفر الأساس للقرارات في تصميم بنية ويب موزّعة. غير أنها قد تتعارض فيما بينها، بحيث يأتي تحقيق هدف على حساب هدف آخر. ومثال بسيط: إن اخترت معالجة السعة بمجرد إضافة المزيد من الخوادم (قابلية التوسع)، فقد يكون ذلك بثمن قابلية الإدارة (ف عليك تشغيل خادم إضافي) والتكلفة (سعر الخوادم).
وعند تصميم أي نوع من تطبيقات الويب، من المهم مراعاة هذه المبادئ الجوهرية، حتى لو كان ذلك لمجرد الإقرار بأن التصميم قد يضحّي بواحد أو أكثر منها.
1.2. الأساسيات
فيما يتعلق ببنية الأنظمة، هناك أمور قليلة يجب مراعاتها: ما القطع المناسبة، وكيف تتلعائم هذه القطع معًا، وما هي المفاضلات الصحيحة. وعمومًا، فإن الاستثمار في التوسّع قبل أن تلزم الحاجة إليه ليس مقترحًا تجاريًا ذكيًا؛ غير أن بعض التفكير المسبق في التصميم قد يوفّر وقتًا وموارد لا بأس به في المستقبل.
يركّز هذا القسم على بعض العوامل الجوهرية التي تحكم كل تطبيقات الويب الكبيرة تقريبًا: الخدمات، والتكرار، والتقسيمات، والتعامل مع الأعطال. وتنطوي كل واحدة من هذه العوامل على خيارات وتضحيات، ولا سيما في سياق المبادئ المبيّنة في القسم السابق. ولشرح هذه العوامل بالتفصيل، من الأفضل البدء بمثال.
مثال: تطبيق لاستضافة الصور
ربما تكون قد نشرت صورة على الإنترنت في وقت ما. أما المواقع الكبيرة التي تستضيف صورًا كثيرة وتوزّعها، فيلزم بناء بنية فعّالة من حيث التكلفة، ومتاحة بدرجة عالية، ومنخفضة الزمن للاستجابة (استرجاع سريع).
تخيّل نظامًا يستطيع فيه المستخدمون رفع صورهم إلى خادم مركزي، وتُطلب هذه الصور عبر رابط ويب أو واجهة برمجية للتطبيق (API)، تمامًا كما في Flickr أو Picasa. وللتبسيط، لنفترض أن لهذا التطبيق جزأين رئيسيين: القدرة على رفع (كتابة) صورة إلى الخادم، والقدرة على الاستعلام عن صورة. ورغم أننا نريد بالطبع أن يكون الرفع فعّالًا، فإن ما يهمنا أكثر هو سرعة التسليم البالغة عند طلب شخص ما لصورة (فقد تُطلب الصور مثلًا لصفحة ويب أو لتطبيق آخر). وهذه الوظيفة تشبه كثيرًا ما يمكن أن يقدّمه خادم ويب أو خادم طرفية (edge server) في شبكة تسليم المحتوى (Content Delivery Network, CDN) — وهو خادم تستخدمه الشبكة لتخزين المحتوى في مواقع كثيرة، فيصبح المحتوى أقرب جغرافيًا أو فيزيائيًا إلى المستخدمين، مما ينتج عنه أداء أسرع.
ومن جوانب النظام المهمة الأخرى:
- لا يوجد حدّ لعدد الصور التي ستُخزَّن، لذا ينبغي مراعاة قابلية توسّع التخزين من حيث عدد الصور.
- يلزم زمن استجابة منخفض لتنزيل الصور ولطلباتها.
- إذا رفع مستخدم صورة، فينبغي أن تكون الصورة موجودة دائمًا (موثوقية بيانات الصور).
- ينبغي أن يكون النظام سهل الصيانة (قابلية الإدارة).
- ولأن استضافة الصور لا تحتمل هوامش ربح مرتفعة، يحتاج النظام إلى أن يكون فعّالًا من حيث التكلفة
الشكل 1.1 هو مخطط مبسّط للوظائف.
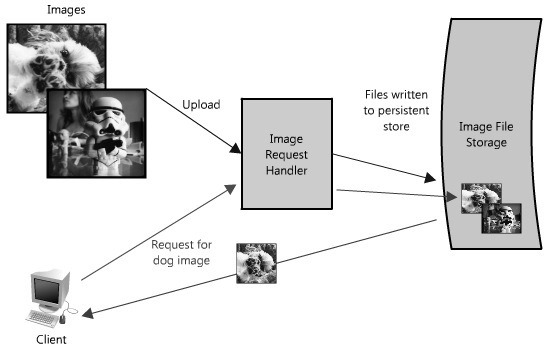 الشكل 1.1: مخطط بنية مبسّط لتطبيق استضافة الصور
في هذا المثال لاستضافة الصور، يجب أن يبدو النظام سريعًا، وأن تُخزَّن بياناته بموثوقية، وأن تكون كل هذه الصفات قابلة للتوسّع بدرجة عالية. ولو بنيت نسخة صغيرة من هذا التطبيق لكان ذلك تافهًا ويمكن استضافته بسهولة على خادم واحد؛ غير أن ذلك لن يكون مثيرًا للاهتمام في هذا الفصل. لنفترض أننا نريد بناء شيء يمكن أن ينمو حتى حجم Flickr.
الخدمات
عند التفكير في تصميم نظام قابل للتوسّع، يفيد فصل الوظائف عن بعضها والنظر في كل جزء من النظام بوصفه خدمة مستقلة ذات واجهة محدَّدة بوضوح. عمليًا، تُوصف الأنظمة المصمَّمة على هذا النحو بأنها ذات بنية موجَّهة للخدمات (Service-Oriented Architecture, SOA). وفي هذا النوع من الأنظمة، لكل خدمة سياقها الوظيفي المتمايز الخاص، ويتم أي تفاعل مع أي شيء خارج ذلك السياق عبر واجهة مجرّدة، وهي عادةً واجهة البرمجة العامة (API) الخاصة بخدمة أخرى.
تفكيك النظام إلى مجموعة من الخدمات المتكاملة يفصل تشغيل هذه القطع بعضها عن بعض. ويساعد هذا التجريد على ترسيخ علاقات واضحة بين الخدمة وبيئتها الأساسية ومستهلكي تلك الخدمة. وإنشاء هذه الحدود الواضحة يساعد في عزل المشكلات، كما يتيح لكل قطعة أن تتوسّع باستقلال تام عن غيرها. وهذا النوع من التصميم الموجه بالخدمات للأنظمة يشبه إلى حد كبير التصميم الموجه بالكائنات في البرمجة.
في مثالنا، تُعالَج كل طلبات رفع الصور واسترجاعها على الخادم نفسه؛ غير أن النظام يحتاج إلى التوسّع، ومن المنطقي فصل هذين الأمرين إلى خدمتين خاصتين بهما.
لنُسقط بُعد الزمن إلى الأمام، ونفترض أن الخدمة محل استخدام كثيف؛ فمثل هذا السيناريو يجعل من السهل أن ترى كيف ستؤثر الكتابات الأطول في الزمن الذي يستغرقه قراءة الصور (إذ إن الوظيفيتين ستتنافسان على موارد مشتركة). ووقفًا للبنية، قد يكون هذا الأثر بالغ الأهمية. وحتى لو كانت سرعة الرفع مساوية لسرعة التنزيل (وهذا ليس حال معظم شبكات IP، إذ صُمِّم معظمها لنسبة لا تقل عن 3:1 بين سرعة التنزيل وسرعة الرفع)، فإن ملفات القراءة تُقرأ عادةً من الذاكرة المؤقتة (cache)، بينما يلزم في النهاية أن تصل الكتابات إلى القرص (وربما كُتبت عدة مرات في حالات الاتساق في النهاية (eventually consistent)). وحتى لو كان كل شيء في الذاكرة أو يُقرأ من أقراص (مثل أقراص SSD)، فسيبقى كل ما تكتبه قاعدة البيانات أبطأ دائمًا من عملية القراءة. (Pole Position، أداة مفتوحة المصدر لاختبار أداء قواعد البيانات، http://polepos.org/ ونتائجها http://polepos.sourceforge.net/results/PolePositionClientServer.pdf).).
مشكلة محتملة أخرى في هذا التصميم أن خادم الويب مثل Apache أو lighttpd يميل إلى أن يكون له حدّ أعلى لعدد الاتصالات المتزامنة التي يمكنه صيانتها (القيم الافتراضية في حدود 500، لكنها قد تكون أعلى بكثير)، وعند كثافة الحركة المرورية تستهلك الكتابات جميع هذه الاتصالات سريعًا. ولأن القراءات يمكن أن تكون غير متزامنة، أو أن تستفيد من تحسينات أداء أخرى مثل ضغط gzip أو ترميز النقل المجزّأ (chunked transfer encoding)، يستطيع خادم الويب أن يخدم القراءات أسرع ويتنقّل بين العملاء بسرعة، فيخدم عددًا أكبر بكثير من الطلبات في الثانية مقارنة بعدد الاتصالات الأقصى (فمع Apache وعدد أقصاه 500 اتصال، ليس من غير المألوف خدمة بضعة آلاف من طلبات القراءة في الثانية). أما الكتابات، من ناحية أخرى، فتميل إلى إبقاء اتصال مفتوح طوال مدة الرفع، لذا فإن رفع ملف بحجم 1 ميغابايت قد يستغرق أكثر من ثانية واحدة على معظم شبكات المنزل، ومن ثمّ لا يستطيع خادم الويب التعامل إلا مع 500 من هذه الكتابات المتزامنة.
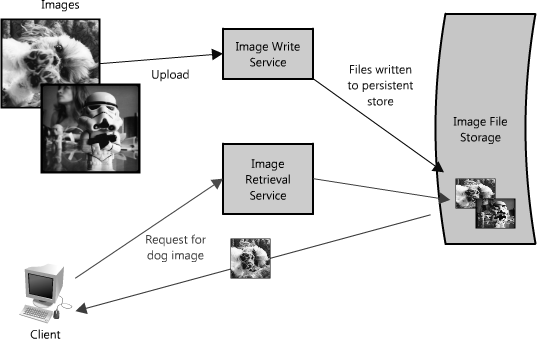 الشكل 1.2: فصل القراءات عن الكتابات
التخطيط المسبق لهذا النوع من الاختناقات يقدّم حجة قوية لفصل قراءات الصور وكتاباتها في خدمتين خاصتين بهما، كما هو مبين في الشكل 1.2. ويتيح لنا ذلك توسّعيهما كلٌّ على حدة (إذ يُرجَّح أننا سنقرأ دائمًا أكثر مما نكتب)، كما يساعد أيضًا في توضيح ما يجري عند كل نقطة. وأخيرًا، فإن هذا يفصل الاعتبارات المستقبلية، مما يجعل تشخيص مشكلة مثل بطء القراءات وتوسيع نطاقها أسهل.
تتمثّل ميزة هذا النهج في قدرتنا على معالجة المشكلات كلٍّ بمعزل عن غيرها—فلا نضطر إلى القلق بشأن كتابة الصور الجديدة واسترجاعها ضمن السياق نفسه. ولا تزال كلتا الخدمتين تستفيدان من مجموعة الصور العامة (corpus)، غير أنهما حريتان في تحسين أدائهما الخاص بطرق تناسب طبيعة كل خدمة (مثلًا، وضع الطلبات في طوابير، أو تخزين الصور الشائعة في الذاكرة المؤقتة—وسنتناول هذا بمزيد من التفصيل أدناه). ومن منظور الصيانة والتكلفة، تتوسّع كل خدمة باستقلالها كلما احتاجت إلى ذلك، وهذا ممتاز، إذ لو جُمعت الخدمتان واختلطتا لأمكن لأحدهما أن يؤثر سهوًا في أداء الأخرى كما في السيناريو الذي ناقشناه أعلاه.
بالطبع، يمكن أن يعمل المثال أعلاه جيدًا حين يكون لديك طرفا نهاية مختلفان (وهذا في الحقيقة قريب جدًا من تطبيقات عدة مزوّدين للتخزين السحابي ومن شبكات تسليم المحتوى). غير أن هناك طرقًا كثيرة لمعالجة هذا النوع من الاختناقات، ولكل منها مفاضلات مختلفة.
على سبيل المثال، يعالج Flickr مشكلة القراءة/الكتابة هذه بتوزيع المستخدمين على شظايا (shards) مختلفة بحيث لا تتجاوز كل شظية عددًا محددًا من المستخدمين، وكلّما زاد عدد المستخدمين أُضيفت شظايا أكثر إلى العنقود (انظر العرض التقديمي عن توسّع Flickr، http://mysqldba.blogspot.com/2008/04/mysql-uc-2007-presentation-file.html). وفي المثال الأول يكون توسيع البنية العتادية اعتمادًا على الاستخدام الفعلي (عدد عمليات القراءة والكتابة في النظام كله) أسهل، في حين يتوسّع Flickr وفق قاعدة مستخدميه (لكنه يفرض افتراضًا بتساوي الاستخدام بين المستخدمين، فتترك مساحة لزيادة السعة). وفي الحالة الأولى يُسقط أي انقطاع أو خلل في إحدى الخدمات وظيفة النظام كله (فلا يستطيع أحد مثلًا كتابة الملفات)، في حين أن انقطاعًا في إحدى شظايا Flickr لن يؤثر إلا في هؤلاء المستخدمين. وفي المثال الأول يكون إجراء العمليات على مجموعة البيانات كلها أسهل—مثلًا، تحديث خدمة الكتابة لتضمين بيانات وصفية جديدة أو البحث في بيانات الصور الوصفية كلها—في حين أن بنية Flickr تتطلب تحديث كل شظية أو البحث فيها (أو إنشاء خدمة بحث تجمع تلك البيانات الوصفية—وهو ما يفعلونه فعلًا).
وفيما يتعلق بهذه الأنظمة لا توجد إجابة واحدة صحيحة، غير أن المفيد هو العودة إلى المبادئ في بداية هذا الفصل، وتحديد احتياجات النظام (قراءات كثيرة أم كتابات أم كلاهما، مستوى التزامن، الاستعلامات على مجموعة البيانات، النطاقات، الترتيبات، إلخ)، وقياس البدائل المختلفة (benchmark)، وفهم كيف يفشل النظام، ووجود خطة متينة لما يحدث عند وقوع الخلل.
التكرار
للتعامل مع الأعطال بأسلوب رشيق، يجب أن تتمتع بنية الويب بتكرار (redundancy) في خدماتها وبياناتها. فمثلًا، إن كانت هناك نسخة واحدة فقط من ملف مخزَّنة على خادم واحد، فإن فقدان ذلك الخادم يعني فقدان ذلك الملف. نادرًا ما يكون فقدان البيانات أمرًا جيدًا، ومن الطرق الشائعة للتعامل معه إنشاء نسخ متعددة، أي نسخ متكرّرة (redundant).
وينطبق المبدأ نفسه على الخدمات. فإذا كانت هناك وظيفة أساسية لتطبيق ما، فإن ضمان تشغيل نسخ أو إصدارات متعددة منها في الوقت نفسه يقي من تعطّل عقدة واحدة (single point of failure).
إنشاء التكرار في نظام ما يزيل نقاط التعطّل المفردة ويوفّر نسخة احتياطية أو وظيفة بديلة عند الحاجة إليها في الأزمات. فمثلًا، إذا كانت هناك نسختان من الخدمة نفسها تعملان في بيئة الإنتاج، وتعطّلت إحداهما أو تدهورت، فيمكن للنظام أن ينتقل احتياطيًا (failover) إلى النسخة السليمة. وقد يكون هذا الانتقال تلقائيًا أو يتطلب تدخلًا يدويًا.
ومن الأجزاء الجوهرية لتكرار الخدمات إنشاء بنية «لا شيء مشترك» (shared-nothing architecture). ومع هذه البنية، تستطيع كل عقدة العمل باستقلال تام عن غيرها، ولا يوجد «دماغ» مركزي يدير الحالة أو ينسّق الأنشطة للعقد الأخرى. وهذا يفيد كثيرًا في قابلية التوسع، إذ يمكن إضافة عقد جديدة دون شروط أو معرفة خاصة. غير أن الأهم من ذلك أنه لا توجد نقطة تعطّل وحيدة في هذه الأنظمة، فهي لذلك أكثر مقاومة بدرجة كبيرة للأعطال.
فمثلًا، في تطبيق خادم الصور لدينا، ستُنسَخ كل الصور تكرارًا على قطعة عتاد أخرى في مكان ما (والأفضل أن يكون في موقع جغرافي مختلف تحسبًا لكارثة مثل زلزال أو حريق في مركز البيانات)، وستكون خدمات الوصول إلى الصور مكرَّرة، وستكون كلها قادرة على خدمة الطلبات. (انظر الشكل 1.3.) (وموازنات الحمل وسيلة ممتازة لإتاحة ذلك، وسنتحدث عنها أكثر أدناه).
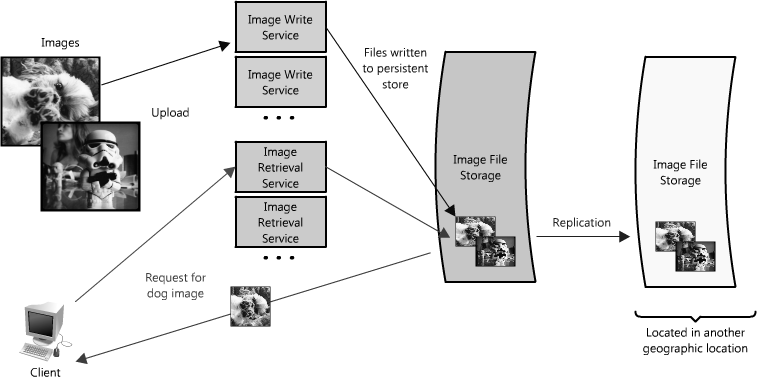 الشكل 1.3: تطبيق استضافة الصور مع التكرار
التقسيمات
قد تكون هناك مجموعات بيانات ضخمة جدًا يتعذّر استيعابها على خادم واحد. وقد تحتاج العملية أيضًا إلى موارد حاسوبية أكثر مما ينبغي، فتخفض الأداء وتضطر إلى إضافة سعة. وفي كلتا الحالتين أمامك خياران: التوسّع الرأسي أو التوسّع الأفقي.
يعني التوسّع الرأسي إضافة المزيد من الموارد إلى خادم منفرد. فبالنسبة إلى مجموعة بيانات ضخمة جدًا، قد يعني ذلك إضافة أقراص صلبة أكثر (أو أكبر) حتى يتسع خادم واحد لمجموعة البيانات كاملة. وفي حالة العملية الحسابية، قد يعني هذا نقل الحساب إلى خادم أكبر بمعالج (CPU) أسرع أو ذاكرة أكبر. وفي كل حالة، يتحقق التوسّع الرأسي بجعل المورد المنفرد قادرًا على تحمّل المزيد بمفرده.
أما التوسّع الأفقي فيعني إضافة المزيد من العقد. وفي حالة مجموعة البيانات الضخمة، قد يعني ذلك خادمًا ثانيًا يخزّن أجزاء من مجموعة البيانات، وفي حالة الموارد الحسابية يعني تقسيم العملية أو الحمل على عقد إضافية. وللاستفادة الكاملة من التوسّع الأفقي، ينبغي إدراجه مبدأً أصيلًا في تصميم بنية النظام، وإلا فسيكون تعديل النظام وفصل السياق لجعل هذا ممكنًا أمرًا عسيرًا إلى حد كبير.
وفيما يتعلق بالتوسّع الأفقي، من أكثر التقنيات شيوعًا تقسيم خدماتك إلى تقسيمات (partitions) أو شظايا (shards). ويمكن توزيع هذه التقسيمات بحيث تكون كل مجموعة وظيفية منطقية منفصلة؛ وقد يتم ذلك وفق الحدود الجغرافية أو وفق معيار آخر مثل المستخدمين غير المدفوعين مقابل المدفوعين. وتتمثل مزايا هذه المخططات في أنها تزوّد الخدمة أو مخزن البيانات بسعة إضافية.
في مثال خادم الصور لدينا، من الممكن استبدال خادم الملفات المنفرد المستخدم لتخزين الصور بعدة خوادم ملفات، يحوي كل منها مجموعته الفريدة من الصور. (انظر الشكل 1.4.) تسمح هذه البنية بأن يمتلئ كل خادم ملفات بالصور، مع إضافة خوادم أخرى كلما امتلأت الأقراص. وسيتطلب التصميم مخطط تسمية يربط اسم الصورة بالخادم الذي يحتويها. ويمكن تكوين اسم الصورة من مخطط تجزئة متسقة (consistent hashing) موزَّع على الخوادم. أو، كبديل، يمكن إسناد كل صورة معرّفًا تسلسليًا متزايدًا، بحيث لا يحتاج عميل ما، عندما يطلب صورة، إلى أكثر من الاحتفاظ في خدمة استرجاع الصور بنطاقات المعرّفات الموزَّعة على كل خادم (كالفهرس).
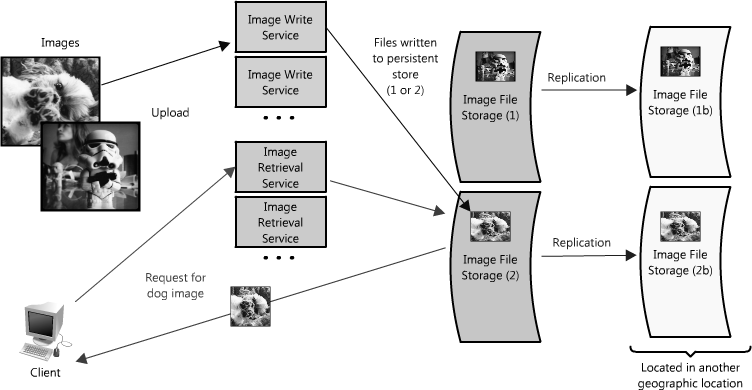 الشكل 1.4: تطبيق استضافة الصور مع التكرار والتقسيم
وبالطبع هناك تحديات في توزيع البيانات أو الوظائف على عدة خوادم. إحدى المسائل الجوهرية هي موضعية البيانات (data locality)؛ ففي الأنظمة الموزّعة، كلما اقتربت البيانات من العملية أو نقطة الحساب، كان أداء النظام أفضل. ومن ثمّ قد يمثّل توزيع البيانات على عدة خوادم مشكلة محتملة، إذ إن كلما احتاج إليها قد لا تكون محلية، مما يضطر الخوادم إلى جلب المعلومات المطلوبة عبر الشبكة بكلفة مرتفعة.
وتأتي مسألة محتملة أخرى في صورة عدم الاتساق (inconsistency). فحين تقرأ خدمات مختلفة من مورد مشترك (قد يكون خدمة أخرى أو مخزن بيانات)، تنشأ احتمال لظهور حالات سباق (race conditions)—حيث يُفترض أن تكون بعض البيانات قد حُدِّثت بينما تحدث القراءة قبل التحديث، وعندئذٍ تكون البيانات غير متسقة. فمثلًا، في سيناريو استضافة الصور، قد تحدث حالة سباق إذا أرسل عميل واحد طلبًا لتحديث صورة الكلب بعنوان جديد، فتتغير من "Dog" إلى "Gizmo"، وفي الوقت نفسه كان عميل آخر يقرأ الصورة. وفي هذه الحالة ليس واضحًا أيّ العنوانين، "Dog" أم "Gizmo"، سيصل إلى العميل الثاني.
ولا شكّ أن لتقسيم البيانات عقبات معينة، غير أن التقسيم يسمح بتقسيم كل مشكلة — بحسب البيانات أو الحمل أو أنماط الاستخدام وما إليها — إلى أجزاء قابلة للتدبير. وقد يساعد ذلك على قابلية التوسع وعلى قابلية الإدارة، لكنه ليس خاليًا من المخاطر. وهناك طرق كثيرة لتخفيف المخاطر والتعامل مع الأعطال؛ غير أنه، ومن أجل الاحتصار لم يرد ذكرها في هذا الفصل. وإن كنت مهتمًا بقراءة المزيد، فيمكن مراجعة مقالة المدونة التي تتناول تحمّل الأعطال والمراقبة.
1.3. لبنات الوصول السريع إلى البيانات القابل للتوسع
بعد أن تطرّقنا إلى بعض الاعتبارات الجوهرية في تصميم الأنظمة الموزّعة، لنتحدث الآن عن الجزء الصعب: توسّع الوصول إلى البيانات.
معظم تطبيقات الويب البسيطة، مثل تطبيقات مجموعة LAMP، تبدو شيئًا كهذا الشكل 1.5.
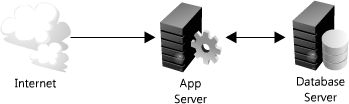 الشكل 1.5: تطبيقات ويب بسيطة
ومع نموها، هناك تحديان رئيسيان: توسّع الوصول إلى خادم التطبيق وإلى قاعدة البيانات. وفي تصميم تطبيق عالي قابلية للتوسع، يُقلَّص خادم التطبيق (أو الويب) عادةً، وكثيرًا ما يجسّد بنية «لا شيء مشترك». ويجعل هذا طبقة خادم التطبيق في النظام قابلة للتوسّع أفقيًا. ونتيجةً لهذا التصميم، تُدفع الأعمال الثقيلة إلى أسفل المكدّس (stack) لتستقر في خادم قاعدة البيانات والخدمات المساندة؛ وفي هذه الطبقة تحديدًا تظهر تحديات التوسّع والأداء الحقيقية.
وكرّس بقية هذا الفصل لبعض الاستراتيجيات والطرق الأكثر شيوعًا في جعل هذه الأنواع من الخدمات سريعة وقابلة للتوسّع عبر توفير وصول سريع إلى البيانات.
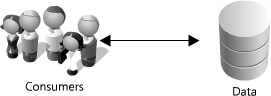 الشكل 1.6: تطبيق ويب مبسَّط أكثر من اللازم
يمكن تبسيط معظم الأنظمة أكثر من اللازم ليصير الشكل 1.6. وهذه نقطة انطلاق ممتازة. فإذا كانت لديك كميات كبيرة من البيانات وتريد الوصول إليها بسرعة وسهولة، مثل الاحتفاظ بمخزون من الحلوى في الدرج العلوي لمكتبك. ورغم أن العبارة السابقة مفرطة في التبسيط، فإنها تلمّح إلى مشكلتين صعبتين: قابلية توسّع التخزين والوصول السريع إلى البيانات.
ولأغراض هذا القسم، لنفترض أن لديك عشرات التيرابايتات (TB) من البيانات وتريد السماح للمستخدمين بالوصول إلى أجزاء صغيرة منها بشكل عشوائي. (انظر الشكل 1.7.) وهذا يشبه تحديد موقع ملف صورة في مكان ما على خادم الملفات في مثال تطبيق الصور.
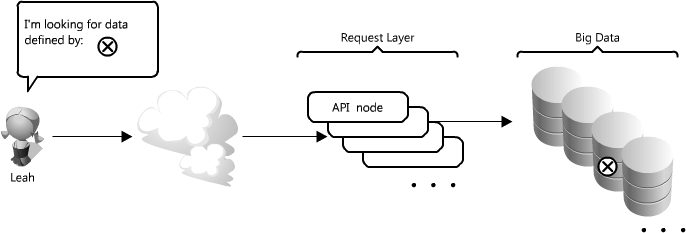 الشكل 1.7: الوصول إلى بيانات محددة
وهذا تحدٍّ بصيغته الخاصة، إذ قد يكون تحميل عشرات التيرابايتات من البيانات إلى الذاكرة مكلفًا للغاية؛ وهذا ينعكس مباشرةً على إدخال/إخراج الأقراص (disk IO). فالقراءة من القرص أبطأ بكثير من القراءة من الذاكرة—فالوصول إلى الذاكرة سريع كChuck Norris، في حين أن الوصول إلى القرص أبطأ من الطابور في إدارة المركبات (DMV). وهذا الفارق في السرعة يتراكم فعلًا مع مجموعات البيانات الكبيرة؛ فبالأرقام، يمكن أن يكون الوصول إلى الذاكرة أسرع بمقدار 6 مرات فقط للقراءات التسلسلية، أو أسرع 100,000 مرة للقراءات العشوائية، مقارنةً بالقراءة من القرص (انظر "The Pathologies of Big Data"، http://queue.acm.org/detail.cfm?id=1563874). كما أن مع وجود معرّفات فريدة، فإن حل مشكلة معرفة أين تجد تلك القطيعة الصغيرة من البيانات قد يكون مهمة شاقة. فهو أشبه بمحاولة جلب آخر حلوى Jolly Rancher من مخزون الحلوى دون النظر.
ولحسن الحظ، هناك خيارات كثيرة يمكنك استخدامها لجعل الأمر أسهل؛ وأهم أربعة منها هي الذواكر المؤقتة (caches) والوكلاء (proxies) والفهارس (indexes) وموازنات الحمل (load balancers). وبقية هذا القسم تناقش كيف يمكن لكل واحد من هذه المفاهيم أن يُستخدم لجعل الوصول إلى البيانات أسرع بكثير.
الذواكر المؤقتة
تستفيد الذواكر المؤقتة من مبدأ موضعية المراجع (locality of reference): البيانات التي طُلبت مؤخرًا يُرجَّح أن تُطلب مجددًا. وتُستخدم في كل طبقة تقريبًا من حوسبة: العتاد وأنظمة التشغيل ومتصفحات الويب وتطبيقات الويب وما وراءها. والذاكرة المؤقتة أشبه بالذاكرة قصيرة المدى: لها مساحة محدودة، لكنها عادةً أسرع من مصدر البيانات الأصلي وتحتوي على العناصر التي جرى الوصول إليها مؤخرًا. ويمكن أن توجد الذواكر المؤقتة على جميع المستويات في البنية، غير أنها كثيرًا ما توجد في المستوى الأقرب إلى الواجهة الأمامية (front end)، حيث تُنفَّذ لإرجاع البيانات بسرعة دون إرهاق المستويات التي تليها.
كيف يمكن استخدام ذاكرة مؤقتة لتسريع الوصول إلى بياناتك في مثال واجهة البرمجة لدينا؟ في هذه الحالة، هناك موضعان يمكنك إدراج ذاكرة مؤقتة عندهما. أحدهما إدراج ذاكرة مؤقتة على عقدة طبقة الطلبات (request layer)، كما في الشكل 1.8.
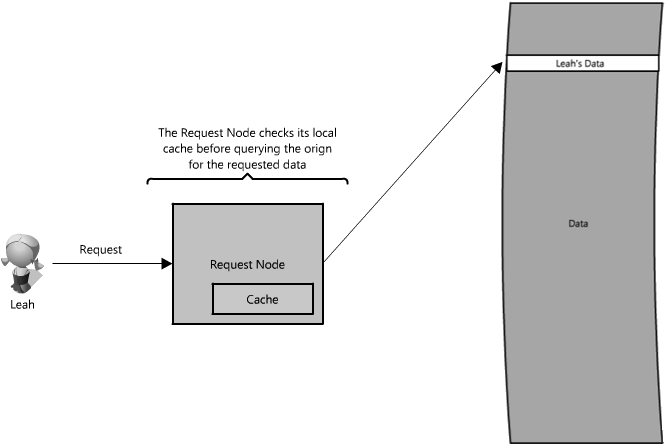 الشكل 1.8: إدراج ذاكرة مؤقتة على عقدة طبقة الطلبات
يتيح وضع ذاكرة مؤقتة مباشرةً على عقدة طبقة الطلبات التخزين المحلي لبيانات الاستجابة. فكلما جرى تقديم طلب إلى الخدمة، تُرجع العقدة بسرعة البيانات المخزَّنة محليًا إن وُجدت. وإذا لم تكن في الذاكرة المؤقتة، تستعلم عقدة الطلب عن البيانات من القرص. ويمكن أيضًا أن تكون الذاكرة المؤقتة على عقدة من طبقة الطلبات موجودة في الذاكرة (وهي سريعة جدًا) وعلى القرص المحلي للعقدة في الوقت نفسه (وهو أسرع من الذهاب إلى تخزين الشبكة).
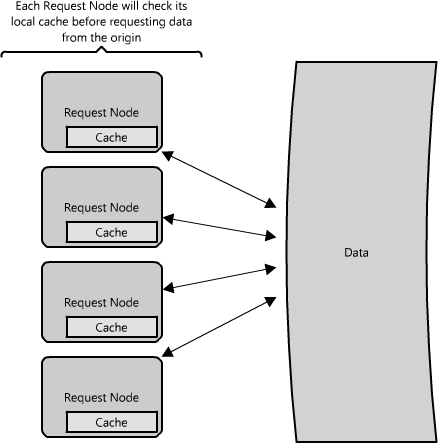 الشكل 1.9: ذواكر مؤقتة متعددة
وماذا يحدث عندما توسّع هذا إلى عدة عقد؟ كما ترى في الشكل 1.9، إذا وُسِّعت طبقة الطلبات لتضم عدة عقد، من الممكن تمامًا أن تستضيف كل عقدة ذاكرتها المؤقتة الخاصة. غير أن موازن الحمل لديك، إن كان يوزّع الطلبات عشوائيًا على العقد، فسيذهب الطلب نفسه إلى عقد مختلفة، مما يزيد من حالات الإخفاق في الذاكرة المؤقتة (cache misses). وهناك خياران للتغلب على هذه العقبة: الذواكر المؤقتة العامة والذواكر المؤقتة الموزّعة.
الذاكرة المؤقتة العامة
الذاكرة المؤقتة العامة (global cache) هي ما تبدو عليه تمامًا: تستخدم جميع العقد مساحة ذاكرة مؤقتة واحدة مشتركة. ويتطلب ذلك إضافة خادم، أو مخزن ملفات من نوع ما، أسرع من مخزنك الأصلي ويمكن الوصول إليه من جميع عقد طبقة الطلبات. وتستعلم كل عقدة من عقد الطلبات الذاكرة المؤقتة بالطريقة نفسها التي تستعلم بها ذاكرة مؤقتة محلية. وقد تصبح هذه المخططات التخزينية المؤقتة معقدة بعض الشيء، إذ من السهل جدًا إغراق ذاكرة مؤقتة واحدة مع ازدياد عدد العملاء والطلبات، لكنها فعّالة جدًا في بعض البنى (ولا سيما التي تعتمد عتادًا متخصصًا يجعل هذه الذاكرة العامة سريعة جدًا، أو التي تملك مجموعة بيانات ثابتة يلزم تخزينها مؤقتًا).
وهناك صورتان شائعتان للذواكر المؤقتة العامة تظهران في المخططات. ففي الشكل 1.10، حين لا يُعثر على استجابة مخزَّنة مؤقتًا، تتولى الذاكرة المؤقتة نفسها مسؤولية جلب قطعة البيانات المفقودة من المخزن الأساسي. وفي الشكل 1.11 يكون عبء جلب أي بيانات لا تُعثر عليها في الذاكرة المؤقتة على عاتق عقد الطلبات.
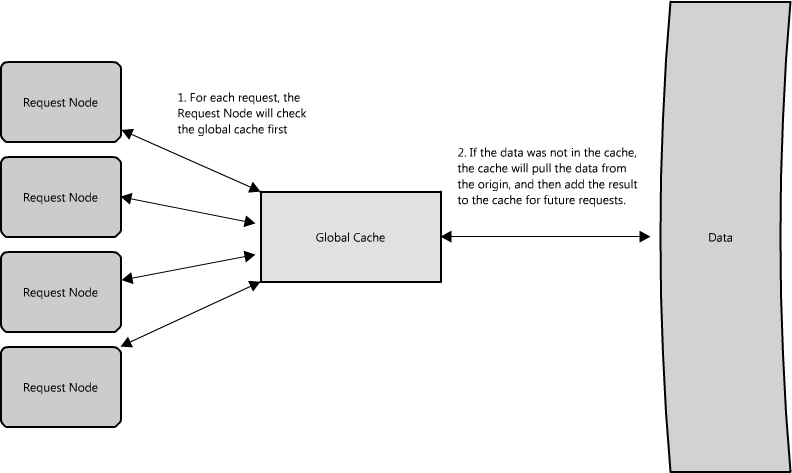 الشكل 1.10: ذاكرة مؤقتة عامة تكون الذاكرة المؤقتة فيها مسؤولة عن الجلب
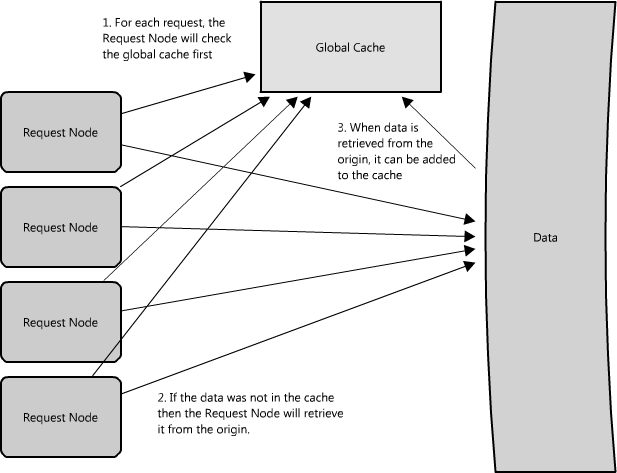 الشكل 1.11: ذاكرة مؤقتة عامة تكون عقد الطلبات فيها مسؤولة عن الجلب
يميل معظم التطبيقات التي تستفيد من الذواكر المؤقتة العامة إلى استخدام النوع الأول، حيث تدير الذاكرة المؤقتة نفسها الإخلاء (eviction) وجلب البيانات لمنع تدفّق الطلبات من العملاء على البيانات نفسها. غير أن هناك بعض الحالات التي يكون فيها التنفيذ الثاني أنسب. فمثلًا، إذا كانت الذاكرة المؤقتة مستخدمة لملفات كبيرة جدًا، فإن نسبة الإصابة في الذاكرة المؤقتة (cache hit percentage) المنخفضة كانت ستؤدي إلى إغراق مخزن الذاكرة المؤقتة بحالات الإخفاق؛ وفي هذا الموقف يفيد أن تكون نسبة كبيرة من مجموعة البيانات الكلية (أو مجموعة البيانات الساخنة) موجودة في الذاكرة المؤقتة. ومثال آخر بنية تكون فيها الملفات المخزَّنة في الذاكرة المؤقتة ثابتة ولا ينبغي إخلاؤها. (قد يكون ذلك بسبب متطلبات التطبيق المتعلقة بزمن استجابة تلك البيانات—فقد تحتاج بعض قطع البيانات إلى سرعة عالية جدًا مع مجموعات بيانات كبيرة—وحيث يفهم منطق التطبيق استراتيجية الإخلاء أو النقاط الساخنة أفضل من الذاكرة المؤقتة).
الذاكرة المؤقتة الموزّعة
في الذاكرة المؤقتة الموزّعة (الشكل 1.12)، تمتلك كل عقدة من عقدها جزءًا من البيانات المخزَّنة مؤقتًا، فإذا كانت الثلاجة ذاكرة مؤقتة لمتجر البقالة، فإن الذاكرة المؤقتة الموزّعة أشبه بوضع طعامك في عدة أماكن—ثلاجتك وخزائنك وصندوق وجبتك—وهي أماكن مريحة لاسترجاع الوجبات الخفيفة دون الذهاب إلى المتجر. وقسمة الذاكرة المؤقتة تتم عادةً باستخدام دالة تجزئة متسقة (consistent hashing)، بحيث إذا كانت عقدة طلبات تبحث عن قطعة بيانات بعينها، أمكنها أن تعرف بسرعة أين تبحث داخل الذاكرة المؤقتة الموزّعة لتحدد ما إذا كانت تلك البيانات متاحة. وفي هذه الحالة، تمتلك كل عقدة جزءًا صغيرًا من الذاكرة المؤقتة، ثم ترسل طلبًا إلى عقدة أخرى للحصول على البيانات قبل الذهاب إلى المصدر. ومن ثمّ فإن إحدى مزايا الذاكرة المؤقتة الموزّعة هي زيادة المساحة المتاحة للتخزين المؤقت بمجرد إضافة عقد إلى مجموعة الطلبات.
ومن عيوب التخزين المؤقت الموزّع معالجة العقدة المفقودة. وتتفادى بعض الذواكر المؤقتة الموزّعة ذلك بالاحتفاظ بنسخ متعددة من البيانات على عقد مختلفة؛ غير أنك تستطيع أن تتخيّل بسرعة كيف يمكن أن تتعقد هذه المنطقيات، ولا سيما عند إضافة عقد إلى طبقة الطلبات أو إزالتها منها. ومع ذلك، حتى لو اختفت عقدة وفقد جزء من الذاكرة المؤقتة، فستجلب الطلبات ببساطة من المصدر—فالأمر ليس بالضرورة كارثيًا.
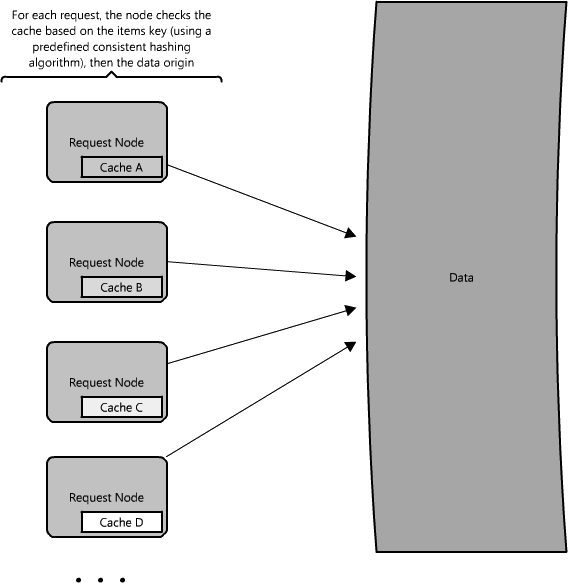 الشكل 1.12: ذاكرة مؤقتة موزّعة
الميزة الكبرى للذواكر المؤقتة أنها تجعل الأمور أسرع بكثير عادةً (بالطبع إذا نُفِّذت على نحو صحيح!). أما المنهجية التي تختارها فتتيح لك فحسب جعلها أسرع لعدد أكبر من الطلبات. غير أن كل هذا التخزين المؤقت له ثمن: تكلفة صيانة مساحة تخزين إضافية، وهي غالبًا ذاكرة باهظة الثمن؛ فليس هناك شيء مجاني. والذواكر المؤقتة رائعة في جعل الأمور أسرع بوجه عام، فضلًا عن أنها توفّر وظائف النظام في ظروف الحمل العالي حيث يغيب ذلك، فتحدث تدهورات كاملة في الخدمة.
ومن أمثلة الذواكر المؤقتة المفتوحة المصدر الشائعة Memcached (http://memcached.org/) (والتي يمكن أن تعمل بوصفها ذاكرة مؤقتة محلية وموزّعة في آن واحد)؛ غير أن هناك خيارات أخرى كثيرة (ومنها خيارات خاصة بلغات أو أطر بعينها).
يُستخدم Memcached في كثير من المواقع الكبيرة، وبرغم أنه قد يكون بالغ القوة، فهو مجرد مخزن مفاتيح وقيم في الذاكرة (in-memory key value store)، مضبوط على تخزين بيانات اعتباطية وإجراء عمليات بحث سريعة (O(1)).
يستخدم Facebook عدة أنواع مختلفة من التخزين المؤقت لتحقيق أداء موقعه (انظر "Facebook caching and performance"). وهم يستخدمون التخزين المؤقت عبر $GLOBALS وAPC على مستوى اللغة (وهو متاح في PHP بثمن استدعاء دالة) ويساعد ذلك في جعل الاستدعاءات الوسيطة ونتائجها أسرع بكثير. (معظم اللغات تملك هذه الأنواع من المكتبات لتحسين أداء صفحات الويب، وينبغي استخدامها دائمًا تقريبًا.) ثم يستخدم Facebook ذاكرة مؤقتة عامة موزّعة على خوادم كثيرة (انظر "Scaling memcached at Facebook"). وبذلك يمكن لاستدعاء واحد يصل إلى الذاكرة المؤقتة أن يُصدر طلبات كثيرة بالتوازي للحصول على بيانات مخزَّنة على خوادم Memcached مختلفة. ويتيح لهم هذا تحقيق أداء ومعدل تدفق أعلى بكثير لبيانات ملف المستخدم، وأن يكون لديهم مكان مركزي واحد لتحديث البيانات (وهذا مهم، لأن إبطال الذاكرة المؤقتة والحفاظ على الاتساق يصبحان تحديين حقيقيين عند تشغيل آلاف الخوادم).
والآن لنتحدث عما يجب فعله حين لا تكون البيانات في الذاكرة المؤقتة…
الوكلاء
على المستوى الأساسي، خادم الوكيل (proxy) هو قطعة وسيطة من العتاد أو البرمجيات تستقبل الطلبات من العملاء وتحوّلها إلى خوادم المصدر في الخلفية. وتُستخدم الوكلاء عادةً لتصفية الطلبات أو تسجيلها، وأحيانًا لتحويل الطلبات (بإضافة الترويسات أو إزالتها، أو بتشفيرها وفك تشفيرها، أو بضغطها).
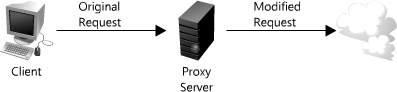 الشكل 1.13: خادم وكيل
وتفيد الوكلاء إلى حد بعيد أيضًا عند تنسيق الطلبات القادمة من عدة خوادم، إذ تتيح فرصًا لتحسين حركة الطلبات من منظور شامل للنظام. ومن طرائق استخدام الوكيل لتسريع الوصول إلى البيانات أن تُدمج الطلبات ذاتها (أو المتشابهة) في طلب واحد، ثم تُرجَع النتيجة الواحدة إلى العملاء الطالبين. وتُعرف هذه الطريقة بإعادة التوجيه المدموجة (collapsed forwarding).
تخيّل أن هناك طلبًا للبيانات نفسها (ولنسمّها littleB) عبر عدة عقد، وأن تلك البيانات ليست في الذاكرة المؤقتة. فإذا وُجّه هذا الطلب عبر الوكيل، أمكن دمج كل تلك الطلبات في طلب واحد، مما يعني أننا لن نضطر إلى قراءة littleB من القرص إلا مرة واحدة. (انظر الشكل 1.14.) وهناك تكلفة ما مرتبطة بهذا التصميم، إذ قد يكون لكل طلب زمن استجابة أعلى قليلًا، وقد تتأخر بعض الطلبات قليلًا حتى تُجمَع مع طلبات مشابهة. لكنه سيحسّن الأداء في ظروف الحمل العالي، ولا سيما حين تُطلب البيانات نفسها مرارًا وتكرارًا. وهذا يشبه الذاكرة المؤقتة، لكن بدلًا من تخزين البيانات أو المستند كما تفعل الذاكرة المؤقتة، فإنها تحسّن الطلبات أو الاستدعاءات الخاصة بتلك المستندات وتعمل كوكيل نيابةً عن أولئك العملاء.
في وكيل الشبكة المحلية (LAN) مثلًا، لا تحتاج العملاء إلى عناوين IP خاصة بها للاتصال بالإنترنت، وستدمج الشبكة المحلية الاستدعاءات الواردة من العملاء والمطابقة للمحتوى نفسه. غير أن الالتباس هنا سهل الوقوع، فالوكلاء كثيرون أيضًا ذواكر مؤقتة (لأنها مكان منطقي جدًا لوضع ذاكرة مؤقتة)، غير أن كل الذواكر المؤقتة لا تعمل كوكلاء.
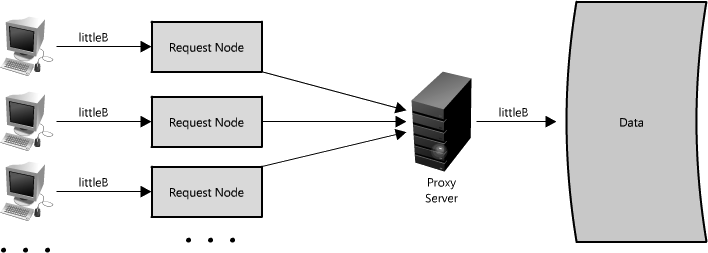 الشكل 1.14: استخدام خادم وكيل لدمج الطلبات
ومن طرائق أخرى رائعة لاستخدام الوكيل ألا نقتصر على دمج الطلبات الخاصة بالبيانات نفسها، بل أن ندمج أيضًا الطلبات الخاصة ببيانات متقاربة مكانيًا في المخزن المصدر (أي المتتابعة على القرص). ويمرّ تطبيق هذه الاستراتيجية إلى أقصى حد ممكن من موضعية البيانات في الطلبات، مما قد يؤدي إلى انخفاض زمن استجابة الطلبات. فمثلًا، لنفترض أن عدة عقد تطلب أجزاء من B: أي partB1 و partB2 وما إلى ذلك. يمكننا تهيئة وكيلنا بحيث يتعرّف على التقارب المكاني للطلبات الفردية، فيدمجها في طلب واحد ولا يُرجع سوى bigB، مما يقلّل إلى حد كبير القراءات من مصدر البيانات. (انظر الشكل 1.15.) وقد يصنع هذا فرقًا كبيرًا حقًا في زمن الطلب حين تصل عشوائيًا إلى عشرات التيرابايتات من البيانات! وتفيد الوكلاء خصوصًا في ظروف الحمل العالي، أو حين تكون ذاكرتك المؤقتة محدودة، لأنها تستطيع أن تجميع عدة طلبات في طلب واحد بصورة أساسية.
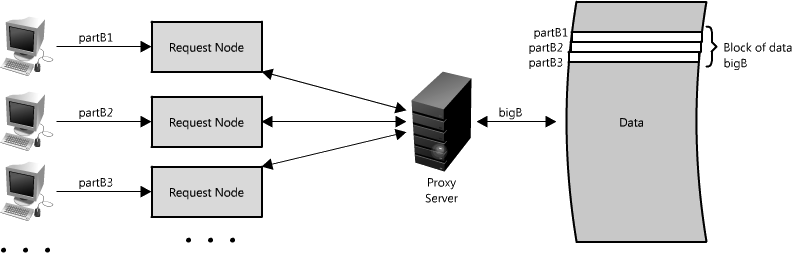 الشكل 1.15: استخدام وكيل لدمج الطلبات الخاصة ببيانات متقاربة مكانيًا
ومن الجدير بالذكر أنه يمكنك استخدام الوكلاء والذواكر المؤقتة معًا، غير أنه من الأفضل عمومًا أن تضع الذاكرة المؤقتة أمام الوكيل، للسبب نفسه الذي يُفضَّل فيه أن ينطلق العدّاؤون الأسرع في البداية في سباق ماراثون مزدحم. والسبب في ذلك أن الذاكرة المؤقتة تقدّم البيانات من الذاكرة، فهي سريعة جدًا، ولا تمانع عدة طلبات لنفس النتيجة. أما لو وُضعت الذاكرة المؤقتة على الجهة الأخرى من خادم الوكيل، لأضفى ذلك زمن استجابة إضافيًا مع كل طلب قبل بلوغها، وقد يعيق الأداء.
إن كنت تنوي إضافة وكيل إلى أنظمتك، فهناك خيارات كثيرة يجب مراعاتها؛ وقد اجتاز كل من Squid وVarnish الاختبارات العملية ويُستخدمان على نطاق واسع في كثير من مواقع الويب الإنتاجية. وتقدّم حلول الوكلاء هذه تحسينات كثيرة للاستفادة القصوى من الاتصال بين العميل والخادم. ويمكن لتثبيت أحدهما كوكيل عكسي (reverse proxy) (وهو مشروح في قسم موازنات الحمل أدناه) على طبقة خادم الويب أن يحسّن أداء خادم الويب إلى حد كبير، إذ يقلّل حجم العمل اللازم لمعالجة طلبات العملاء الواردة.
الفهارس
إن استخدام فهرس للوصول إلى بياناتك بسرعة استراتيجية معروفة جيدًا لتحسين أداء الوصول إلى البيانات؛ وهي ربما الأوسع شهرة حين يتعلق الأمر بقواعد البيانات. ويقابل الفهرس زيادة الحمل الزائد على التخزين وبطء عمليات الكتابة (إذ عليك أن تكتب البيانات وأن تحدّث الفهرس معًا) في مقابل قراءات أسرع.
وكما في مخزن البيانات العلائقي التقليدي، يمكنك تطبيق هذا المفهوم أيضًا على مجموعات البيانات الأكبر. وتتمثل حيلة الفهارس في ضرورة أن تُعنى بعناية بكيفية وصول المستخدمين إلى بياناتك. وفي حالة مجموعات البيانات التي تبلغ عشرات التيرابايتات في حجمها، لكن أحجام حمولتها صغيرة جدًا (مثل 1 كيلوبايت)، تكون الفهارس ضرورة لتحسين الوصول إلى البيانات. فالبحث عن حمولة صغيرة داخل مجموعة بيانات كبيرة جدًا قد يكون تحديًا حقيقيًا، إذ يستحيل عليك أن تكرّر على تلك الكمية الهائلة من البيانات في أي وقت معقول. كما أن من المرجح جدًا أن تكون مجموعة البيانات الكبيرة هذه موزّعة على عدة أجهزة فعلية (أو كثيرة!)—وهذا يعني أنك تحتاج إلى طريقة للعثور على الموقع الفيزيائي الصحيح للبيانات المطلوبة. والفهارس هي أفضل وسيلة لذلك.
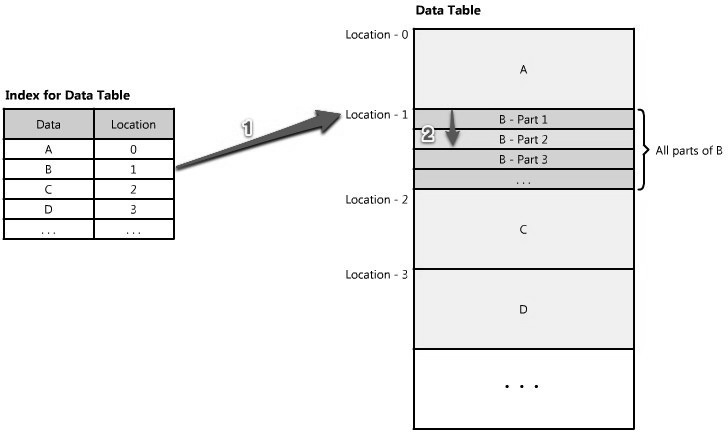 الشكل 1.16: الفهارس
يمكن استخدام الفهرس كأنه جدول محتويات يوجّهك إلى الموضع الذي توجد فيه بياناتك. فمثلًا، لنفترض أنك تبحث عن قطعة بيانات، وهي الجزء الثاني من B—فكيف ستعرف أين تجدها؟ فإذا كان لديك فهرس مرتَّب حسب نوع البيانات—لنقل البيانات A وB وC—فهو يخبرك بموقع البيانات B عند المصدر. ثم ما عليك سوى الانتقال إلى ذلك الموضع وقراءة الجزء الذي تريده من B. (انظر الشكل 1.16.)
وكثيرًا ما تُخزَّن هذه الفهارس في الذاكرة، أو في موضع قريب جدًا من طلب العميل الوارد. وتُستخدم قواعد بيانات Berkeley (BDB) وبنى البيانات الشجرية على نطاق واسع لتخزين البيانات في قوائم مرتّبة، وهو أمر مثالي للوصول بواسطة فهرس.
وكثيرًا ما توجد طبقات كثيرة من الفهارس تعمل كخريطة تنقلك من موضع إلى آخر، وهكذا، حتى تصل إلى قطعة البيانات المحددة التي تريدها. (انظر الشكل 1.17.)
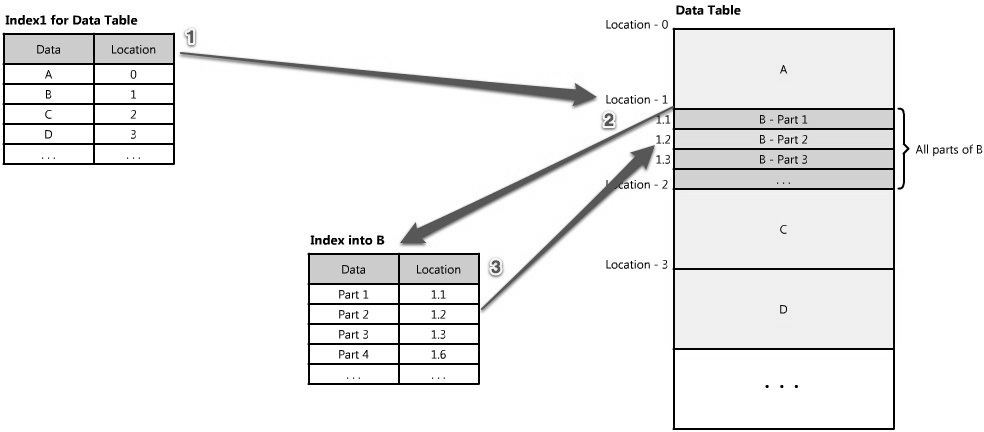 الشكل 1.17: طبقات كثيرة من الفهارس
ويمكن أيضًا استخدام الفهارس لإنشاء وجهات نظر مختلفة متعددة للبيانات نفسها. فبالنسبة إلى مجموعات البيانات الكبيرة، وهذه طريقة ممتازة لتعريف مرشّحات وفرز مختلفة دون الحاجة إلى إنشاء نسخ إضافية كثيرة من البيانات.
فمثلًا، تخيّل أن نظام استضافة الصور السابق يستضيف في الواقع صورًا لصفحات كتب، وأن الخدمة تسمح باستعلامات العميل في النصوص داخل تلك الصور، فتبحث في كامل محتوى الكتب عن موضوع ما، بالطريقة نفسها التي تتيح بها محركات البحث البحث في محتوى HTML. وفي هذه الحالة، تستهلك صور الكتب تلك خوادم كثيرة جدًا لتخزين الملفات، والعثور على صفحة واحدة لعرضها على المستخدم قد يكون أمرًا يتطلب بعض العمل. أولًا، يجب أن تكون الفهارس المعكوسة للاستعلام عن كلمات ومجموعات كلمات عشوائية سهلة الوصول؛ ثم هناك تحدّي الانتقال إلى الصفحة المحددة والموضع بداخل ذلك الكتاب، واسترجاع الصورة الصحيحة للنتائج. وعليه، فإن الفهرس المعكوس (inverted index) سيُسقِط على موضع (مثل الكتاب B)، ثم قد يحتوي B على فهرس يضم كل الكلمات والمواضع وعدد مرات ورودها في كل جزء.
وقد يبدو الفهرس المعكوس، الذي يمكن أن يمثل Index1 في المخطط أعلاه، شيئًا كالتالي—فكل كلمة أو مجموعة كلمات توفّر فهرسًا للكتب التي تحتويها.
| الكلمة (الكلمات) | الكتاب (الكتب) |
|---|---|
| يكون رائعًا | الكتاب B، الكتاب C، الكتاب D |
| دائمًا | الكتاب C، الكتاب F |
| يصدّق | الكتاب B |
وسيبدو الفهرس الوسيط مشابهًا لهذا، لكنه سيحتوي على كلمات الكتاب B وموضعه ومعلوماته وحدها. وتتيح هذه البنية للفهارس المتداخلة أن يشغل كل منها مساحة أقل مما لو كان لا بد من تخزين كل تلك المعلومات في فهرس معكوس واحد كبير.
وهذا هو مفتاح الأمر في الأنظمة واسعة النطاق، إذ إن هذه الفهارس قد تصبح كبيرة بدرجة كبيرة ومكلفة في التخزين حتى بعد ضغطها. فلو افترضنا في هذا النظام أن لدينا كثيرًا من كتب العالم—100,000,000 (انظر مقالة Inside Google Books)—وأن كل كتاب يبلغ طوله 10 صفحات فقط (لتبسيط الحساب)، بمعدل 250 كلمة في الصفحة، فإن ذلك يعني وجود 250 مليار كلمة. ولو افترضنا أن المعدل 5 أحرف لكل كلمة، وأن كل حرف يشغل 8 بتات (أي بايت واحد، وإن كان بعض الأحرف يشغل بايتين)، أي 5 بايتات لكل كلمة، فإن فهرسًا يحتوي على كل كلمة مرة واحدة فقط يتجاوز حجمه تيرابايت واحدًا من التخزين. ومن ثمّ يمكنك أن ترى أن إنشاء فهارس تحوي الكثير من المعلومات الأخرى، مثل مجموعات الكلمات ومواضع البيانات وعدد مرات الورود، يضيف بسرعة كبيرة.
وإنشاء هذه الفهارس الوسيطة وتمثيل البيانات في أقسام أصغر يجعل مشاكل البيانات الضخمة قابلة للتدبير. فالبيانات يمكن أن تنتشر على خوادم كثيرة مع بقاء الوصول إليها سريعًا. والفهارس حجر الأساس في استرجاع المعلومات، وهي أساس محركات البحث الحديثة اليوم. وبالطبع، فإن هذا القسم لم يلمس سوى السطح، فهناك قدر كبير من البحث الجاري حول كيفية جعل الفهارس أصغر وأسرع وأكثر احتواءً للمعلومات (مثل صلاحية الصلة)، وكيف تُحدَّث بسلاسة. (وهناك تحديات تتعلق بقابلية الإدارة في حالات السباق، وفي العدد الهائل من التحديثات المطلوبة لإضافة بيانات جديدة أو تغيير بيانات موجودة، ولا سيما حين تكون صلاحية الصلة أو حساب النتائج (scoring) جزءًا من المعادلة).
والقدرة على العثور على بياناتك بسرعة وسهولة أمر مهم؛ فالفهارس أداة فعّالة وبسيطة لتحقيق ذلك.
موازنات الحمل
وأخيرًا، فإن قطعة جوهرية أخرى في أي نظام موزّع هي موازن الحمل (load balancer). فموازنات الحمل جزء رئيسي من أي بنية، لأن دورها هو توزيع الحمل على مجموعة من العقد المسؤولة عن خدمة الطلبات. ويتيح ذلك لعدة عقد أن تخدم الوظيفة نفسها بشفافية داخل النظام. (انظر الشكل 1.18.) والغرض الرئيسي منها هو التعامل مع عدد كبير من الاتصالات المتزامنة وتوجيه تلك الاتصالات إلى إحدى عقد الطلبات، مما يسمح للنظام بالتوسّع لخدمة طلبات أكثر عبر إضافة العقد فحسب.
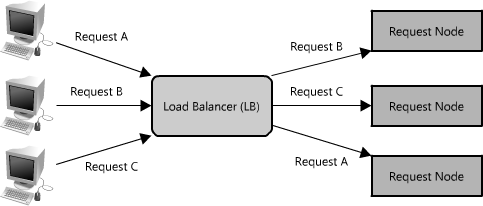 الشكل 1.18: موازن الحمل
وهناك خوارزميات مختلفة كثيرة يمكن استخدامها لخدمة الطلبات، منها اختيار عقدة عشوائية، أو التدوير بالتناوب (round robin)، أو حتى اختيار العقدة وفق معايير معينة مثل نسبة استخدام الذاكرة أو المعالج. ويمكن تنفيذ موازنات الحمل بوصفها برمجيات أو أجهزة مخصّصة. ومن موازنات الحمل البرمجية المفتوحة المصدر التي لقيت قبولًا واسعًا HAProxy).
وفي النظام الموزّع، توجد موازنات الحمل عادةً في المقدمة القصوى من النظام، بحيث يتم توجيه كل الطلبات الواردة وفقًا لذلك. وفي نظام موزّع معقّد، ليس من غير المألوف أن يوجَّه الطلب إلى عدة موازنات حمل كما هو مبين في الشكل 1.19.
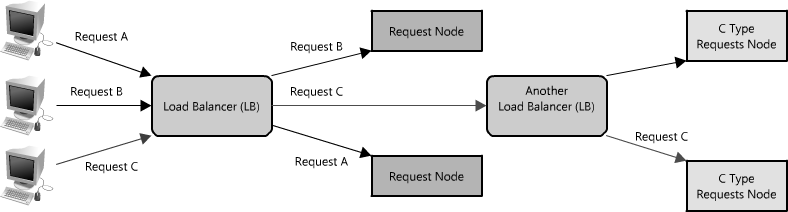 الشكل 1.19: موازنات حمل متعددة
وكما في حالة الوكلاء، يمكن لبعض موازنات الحمل أيضًا أن توجّه الطلب بصورة مختلفة بحسب نوعه. (ومن الناحية التقنية تُعرف هذه أيضًا بالوكلاء العكسيين.)
ومن تحديات موازنات الحمل إدارة البيانات الخاصة بجلسة كل مستخدم. ففي موقع تجارة إلكترونية، حين يكون لديك عميل واحد فقط، يكون من السهل جدًا السماح للمستخدمين بوضع الأشياء في سلة التسوق وحفظ محتوياتها بين الزيارات (وهذا مهم، لأن احتمال أن تشتري المنتج سيكون أعلى بكثير إن كان ما زال في سلة المستخدم عند عودته). غير أن المستخدم إن كان يوجَّه إلى عقدة ما في جلسة، ثم إلى عقدة أخرى في زيارته التالية، فقد تنشأ حالات عدم اتساق، إذ قد تفتقر العقدة الجديدة إلى محتويات سلة ذلك المستخدم. (ألا يغضبك أن تضع عبوة من ست زجاجات من Mountain Dew في سلتك ثم تعود فتجدها فارغة؟)
ومن طرق التفاف ذلك جعل الجلسات لاصقة (sticky) بحيث يُوجَّه المستخدم دائمًا إلى العقدة نفسها، لكن عندئذٍ يصعب جدًا الاستفادة من بعض مزايا الموثوقية مثل التحويل الاحتياطي التلقائي. وفي هذه الحالة، ستحتوي سلة التسوق الخاصة بالمستخدم على محتوياتها دائمًا، لكن إذا تعذّر الوصول إلى عقدته اللاصقة، فسيلزم حالة خاصة ولن يكون افتراض وجود المحتويات قائمًا بعد ذلك (مع الأمل ألّا يكون هذا الافتراض مبنيًا داخل التطبيق). وبالطبع، يمكن حل هذه المشكلة باستراتيجيات وأدوات أخرى في هذا الفصل، مثل الخدمات، وأخرى كثيرة لا يتناولها هذا الفصل (مثل ذاكرات المتصفح وملفات تعريف الارتباط (cookies) وإعادة كتابة عناوين URL). وإذا كان في نظامك عدد قليل من العقد، فقد تكون أنظمة مثل DNS بالتناوب (round robin DNS) أكثر منطقية، لأن موازنات الحمل قد تكون باهظة الثمن وتضيف طبقة تعقيد غير لازمة. وبالطبع، في الأنظمة الأكبر توجد شتى أنواع خوارزميات الجدولة وموازنة الحمل المختلفة، بما فيها خوارزميات بسيطة مثل الاختيار العشوائي أو التناوب، وآليات أكثر نضجًا تأخذ في الحسبان أمورًا مثل نسبة الاستخدام والسعة. وتتيح كل هذه الخوارزميات توزيع حركة المرور والطلبات، كما يمكن أن تقدّم أدوات موثوقية مفيدة مثل التحويل الاحتياطي التلقائي، أو الإزالة التلقائية لعقدة معطوبة (مثلًا حين تصبح غير مستجيبة). غير أن هذه المزايا المتقدمة قد تجعل تشخيص المشكلات مرهقًا. فمثلًا، في ظروف الحمل العالي، ستزيل موازنات الحمل العقد التي قد تكون بطيئة أو ينتهي الوقت المحدد لها (بسبب كثرة الطلبات)، لكن هذا لا يزيد إلا من وطأة المشكلة على العقد الأخرى.
وفي هذه الحالات، فإن المراقبة المكثفة مهمة، لأن حركة المرور ومعدل التدفق الكلي للنظام قد تبوان متراجعتين (إذ إن العقد تخدم طلبات أقل) بينما العقد على الأفراد تصل إلى حدها الأقصى. وموازنات الحمل وسيلة سهلة تتيح لك توسيع سعة النظام، وهي، مثل التقنيات الأخرى في هذا الفصل، تلعب دورًا جوهريًا في بنية الأنظمة الموزّعة. كما تقدّم موازنات الحمل الوظيفة الجوهرية المتمثلة في القدرة على اختبار سلامة العقدة، بحيث إن كانت غير مستجيبة أو محمّلة فوق طاقتها، أمكن إزالتها من المجموعة التي تتولى الطلبات، مستغلةً بذلك تكرار العقد المختلفة في نظامك.
الطوابير
لقد غطّينا حتى الآن طرقًا كثيرة لقراءة البيانات بسرعة، لكن جزءًا مهمًا آخر من توسّع طبقة البيانات هو الإدارة الفعّالة للكتابات. وعندما تكون الأنظمة بسيطة، مع أحمال معالجة دنيا وقواعد بيانات صغيرة، تكون الكتابات سريعة على نحو يمكن التنبؤ به؛ غير أن الكتابات في الأنظمة الأكثر تعقيدًا قد تستغرق وقتًا يكاد يكون غير محدد. فمثلًا، قد يتعيّن كتابة البيانات في عدة مواضع على خوادم أو فهارس مختلفة، أو قد يكون النظام ببساطة تحت حمل مرتفع. وفي الحالات التي قد تستغرق فيها الكتابات، أو أي مهمة أخرى على الإطلاق، وقتًا طويلًا، فإن تحقيق الأداء والتوفر يستلزم بناء عدم تزامن (asynchrony) في النظام؛ ومن الطرق الشائعة ذلك استخدام الطوابير (queues).
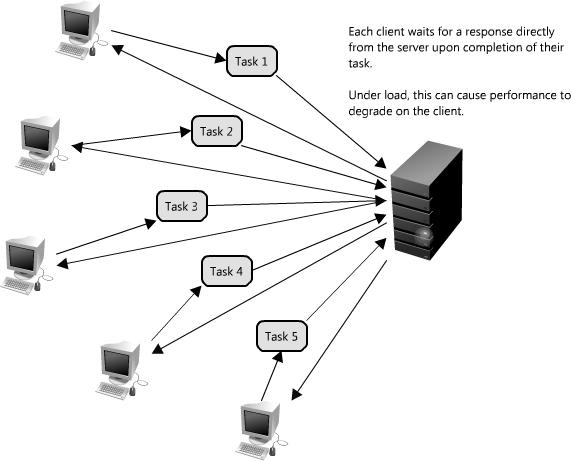 الشكل 1.20: طلب متزامن
تخيّل نظامًا يطلب فيه كل عميل مهمة تُنفَّذ عن بُعد. يرسل كل واحد من هؤلاء العملاء طلبه إلى الخادم، حيث يُنجز الخادم المهام بأسرع ما يمكن ثم يعيد النتائج إلى عملائه المعنيين. وفي الأنظمة الصغيرة التي يستطيع فيها خادم واحد (أو خدمة منطقية) خدمة العملاء الواردين بالسرعة نفسها التي يصلون بها، فلا بد أن تعمل هذه الحالة على نحو تام. غير أن عندما يتلقى الخادم طلبات أكثر مما يستطيع استيعابه، يُضطر كل عميل إلى انتظار اكتمال طلبات العملاء الآخرين قبل أن تتولّد استجابة. وهذا مثال على طلب متزامن، وهو معروض في الشكل 1.20.
ويمكن أن يخفض هذا النوع من السلوك المتزامن أداء العميل بشدة؛ إذ يُضطر العميل إلى الانتظار، ولا يؤدي أي عمل فعلي، حتى يمكن الإجابة عن طلبه. ولا تحل إضافة خوادم إضافية للتعامل مع حمل النظام المشكلة بدورها؛ فحتى مع وجود موازنة حمل فعّالة، يصعب ضمان التوزيع المتساوي والمنصف للعمل اللازم لتعظيم أداء العملاء. بل الأمر أشد: إن كان الخادم الذي يعالج الطلبات غير متاح أو تعطّل، فسيتعطّل العملاء الذين في الأعلاه أيضًا. وحل هذه المشكلة بفعالية يستلزم التجريد بين طلب العميل والعمل الفعلي الذي يُنفَّذ لخدمته.
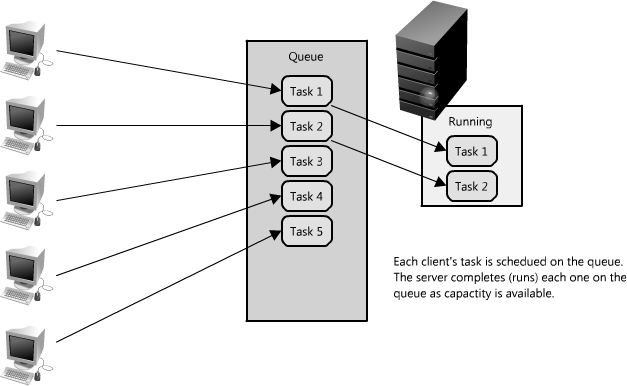 الشكل 1.21: استخدام الطوابير لإدارة الطلبات
والآن إلى الطوابير. الطابور بسيط تمامًا كما يبدو: تصل مهمة، فتُضاف إلى الطابور، ثم يلتقط العاملون المهمة التالية متى توفّرت لديهم القدرة على معالجتها. (انظر الشكل 1.21.) ويمكن أن تمثل هذه المهام عمليات كتابة بسيطة في قاعدة بيانات، أو شيئًا معقدًا كإنشاء صورة مصغّرة لمعاينة مستند. وحين يرسل العميل طلبات المهام إلى طابور، لا يُضطر إلى انتظار النتائج بعد الآن؛ بل لا يحتاج سوى إشعار بأن الطلب قد استُقبل على نحو سليم. ويمكن أن يعمل هذا الإشعار لاحقًا مرجعًا للنتائج حين يحتاج إليها العميل.
تتيح الطوابير للعملاء العمل بطريقة غير متزامنة، فتقدّم تجريدًا استراتيجيًا لطلب العميل واستجابته. ومن الجهة الأخرى، لا يوجد في النظام المتزامن أي تمييز بين الطلب والرد، ولا يمكن بالتالي إدارتهما بصورة منفصلة. وفي النظام غير المتزامن، يطلب العميل مهمة، فتستجيب الخدمة برسالة تؤكّد استلام المهمة، ثم يستطيع العميل أن يفحص حالة المهمة دوريًا، ولا يطلب النتيجة إلا بعد اكتمالها. وأثناء انتظار العميل اكتمال طلب غير متزامن، يكون حرًا في تنفيذ أعمال أخرى، بل وإرسال طلبات غير متزامنة إلى خدمات أخرى. والأخير مثال على كيفية الاستفادة من الطوابير والرسائل في الأنظمة الموزّعة.
كما توفّر الطوابير بعض الحماية من انقطاع الخدمات وتعطّلها. فمثلًا، من السهل جدًا إنشاء طابور شديد المتانة يعيد محاولة طلبات الخدمة التي فشلت بسبب أعطال خادم عابرة. ومن الأفضل استخدام طابور لفرض ضمانات جودة الخدمة (quality-of-service) بدلًا من تعريض العملاء مباشرةً لانقطاعات الخدمة المتقطعة، التي تتطلب معالجة أخطاء معقّدة وغير متسقة غالبًا في جانب العميل.
والطوابير أساسية في إدارة الاتصال الموزّع بين مختلف أجزاء أي نظام موزّع واسع النطاق، وهناك طرق كثيرة لتنفيذها. فثمة طوابير مفتوحة المصدر كثيرة مثل RabbitMQ وActiveMQ وBeanstalkD، لكن بعضها يستخدم أيضًا خدمات مثل Zookeeper، بل وحتى مخازن بيانات مثل Redis.
1.4. الخاتمة
إن تصميم أنظمة فعّالة ذات وصول سريع إلى كميات كبيرة من البيانات أمر ممتع، وهناك أدوات عظيمة تتيح جميع أنواع التطبيقات الجديدة. وقد غطّى هذا الفصل أمثلة قليلة فلم يلمس سوى السطح، غير أن هناك الكثير غيرها—وستستمر الابتكارات في هذا المجال بلا توقف.