منظومة NoSQL
معمارية تطبيقات المصادر المفتوحة (المجلد الأول)منظومة NoSQL
معمارية تطبيقات المصادر المفتوحة (المجلد الأول) منظومة NoSQL
Adam Marcus
إذا استمتعت بهذه الكتب، فقد يعجبك أيضًا التصميم البرمجي بالأمثلة في Python والتصميم البرمجي بالأمثلة في JavaScript.
على خلاف معظم مشاريع هذا الكتاب الأخرى، لا تُعدّ NoSQL أداةً، بل منظومةً (ecosystem) مكوّنةً من عدة أدواتٍ متكاملة ومتنافسة. والأدوات التي تحمل العلامة التجارية NoSQL توفّر بديلًا عن أنظمة قواعد البيانات العلائقية المبنية على SQL لتخزين البيانات. ولفهم NoSQL لا بدّ من فهم فضاء الأدوات المتاحة، ومعرفة كيف يستكشف تصميم كلّ أداةٍ منه إمكانات تخزين البيانات.
إذا كنت تفكّر في استخدام نظام تخزين من أنظمة NoSQL، فينبغي أوّلًا أن تفهم اتساع الخيارات التي تمتدّ إليها أنظمة NoSQL. فأنظمة NoSQL تتخلّص من كثيرٍ من وسائل الراحة التقليدية في أنظمة قواعد البيانات العلائقية، فتصبح العمليات التي كانت مُغلَّفة عادةً خلف حدّ النظام الخاص بقاعدة البيانات مُسنَدةً إلى مصمّمي التطبيقات. وهذا يستلزم منك أن تتولّى قبّعة مهندس الأنظمة (systems architect)، وهو ما يتطلّب فهمًا أعمق لكيفية بناء هذه الأنظمة.
13.1. ما الذي في الاسم؟
في تحديد فضاء NoSQL، لنبدأ أوّلًا بمحاولةٍ في تعريف الاسم. فإذا أُخذ الاسم على حرفه، فإنّ نظام NoSQL يقدّم للمستخدم واجهة استعلام ليست SQL. غير أنّ مجتمع NoSQL يتّخذ عمومًا رؤيةً أوسع، إذ يذهب إلى أنّ أنظمة NoSQL توفّر بدائل لقواعد البيانات العلائقية التقليدية، وتتيح للمطوّرين تصميم مشاريعٍ تستخدم واجهة SQL لا تقتصر عليها (Not Only). وفي بعض الحالات، قد تستبدل قاعدة بيانات علائقيةً ببديلٍ من NoSQL، وفي غيرها ستتبع نهجًا يجمع ويُنسّق بين الخيارات لمختلف المشكلات التي تصادفك أثناء تطوير التطبيق.
وقبل الغوص في عالم NoSQL، لنستعرض الحالات التي تناسب فيها SQL والنموذج العلائقي احتياجاتك، والحالات الأخرى التي قد يكون فيها نظام NoSQL أنسب.
13.1.1. SQL والنموذج العلائقي
SQL لغةٌ تعريفية (declarative language) لاستعلام البيانات. أمّا اللغة التعريفية فهي التي يحدّد فيها المبرمج ما يريد للنظام أن يفعله، بدلًا من أن يعرّف إجرائيًا كيف ينبغي للنظام أن يفعله. ومن أمثلتها: ابحث عن سجلّ الموظف رقم 39، أو استخرج من سجلّه الكامل اسم الموظف ورقم هاتفه فقط، أو صفِّ سجلّات الموظفين لتقتصر على العاملين في المحاسبة، أو عُدّ الموظفين في كلّ قسم، أو ادمج بيانات جدول الموظفين مع جدول المديرين.
وبتقدير أوّلي، تتيح لك SQL طرح هذه الأسئلة دون التفكير في كيفية توزيع البيانات على القرص، أو في الفهارس (indices) التي ستستخدم للوصول إليها، أو في الخوارزميات التي ستعالج بها. ومن المكوّنات المعمارية الجوهرية في معظم قواعد البيانات العلائقية مُحسِّن الاستعلامات (query optimizer)، الذي يقرّر أيّ استراتيجيات الاستعلام المتكافئة منطقيًا — وعددها كثير — ينبغي تنفيذها لتسريع الاستجابة إلى الاستعلام. وغالبًا ما يكون هذا المحسّن أفضل من متوسّط مستخدم قاعدة البيانات، لكنّه أحيانًا لا تتوفّر له من المعلومات ما يكفي، أو يكون نموذجه للنظام أبسط ممّا ينبغي، فلا يولّد أكثر عمليات التنفيذ كفاءةً.
وتتبع قواعد البيانات العلائقية، وهي أكثر قواعد البيانات شيوعًا في التطبيق العملي، نموذج البيانات العلائقي. وفي هذا النموذج، تُخزَّن الكيانات الحقيقية المختلفة في جداولٍ مختلفة. فمثلًا، يمكن تخزين جميع الموظفين في جدول Employees، وجميع الأقسام في جدول Departments. ولكلّ صفٍّ في الجدول خصائصُ متنوّعة مخزّنةٌ في أعمدة. فمثلًا، قد يكون للموظف معرّف موظف، وراتب، وتاريخ ميلاد، والاسم الأول واسم العائلة. وتُخزَّن كلّ هذه الخصائص في عمودٍ من أعمدة جدول Employees.
ويرافق النموذجُ العلائقي لغةَ SQL مسايرةً تامّة. فاستعلامات SQL البسيطة، مثل عوامل التصفية (filters)، تسترجع جميع السجلات التي يطابق فيها أحد الحقول شرطًا ما (مثل employeeid = 3 أو salary > $20000). أمّا البنيات الأكثر تعقيدًا فتُجبر قاعدة البيانات على عملٍ إضافي، مثل دمج بياناتٍ من عدّة جداول (مثل: ما اسم القسم الذي يعمل فيه الموظف رقم 3؟). كما يمكن أن تؤدّي البنيات المعقّدة الأخرى، مثل الدوال التجميعية (aggregates) (مثل: ما متوسّط رواتب موظفيّ؟)، إلى مسحٍ كامل للجدول (full-table scan).
ويعرّف النموذجُ للبيانات العلائقية كياناتٍ شديدةَ الانتظام ذات علاقاتٍ صارمة بينها. واستعلام هذا النموذج بـ SQL يتيح اجتيازاتٍ معقّدة للبيانات دون تطويرٍ مخصَّص كبير. غير أنّ تعقيد هذه النمذجة والاستعلام له حدوده:
- التعقيد يؤدّي إلى عدم قابلية التنبّؤ. فتعابيرُ SQL تجعل من الصعب استنتاج تكلفة كلّ استعلام، وبالتالي تكلفة حمل عملٍ (workload) بعينه. وبينما قد تُعقّد لغات الاستعلام البسيطة منطق التطبيق، فإنّها تيسّر تجهيز أنظمة تخزين البيانات، التي لا تستجيب إلّا لطلباتٍ بسيطة.
- هناك طرقٌ عديدة لنمذجة المشكلة. فالنموذج العلائقي صارم: المخطّط (schema) المخصّص لكلّ جدول يحدّد البيانات الواردة في كلّ صف. وإذا كنّا نخزّن بياناتٍ أقلّ انتظامًا، أو صفوفًا تتباين أكثر فيما تخزّانه من أعمدة، فقد يكون النموذج العلائقي مقيّدًا بلا داعٍ. وعلى نحوٍ مماثل، قد لا يجد مطوّرو التطبيقات النموذجَ العلائقي مثاليًا لنمذجة كلّ أنواع البيانات. فمثلًا، يُكتب كثيرٌ من منطق التطبيقات بلغاتٍ كائنية التوجّه (object-oriented)، ويتضمّن مفاهيمَ عالية المستوى مثل القوائم والطوابير والمجموعات، وبعض المبرمجين يودّون لو صوّرتها طبقةُ الثبات (persistence layer) عندهم.
- إذا نمت البيانات فجاوزت سعة خادم واحد، فلا بدّ من تقسيم جداول قاعدة البيانات على عدّة أجهزة. ولكي نتجنّب أن تعبر عملياتُ JOIN الشبكةَ للحصول على بياناتٍ موجودة في جداولٍ مختلفة، سنضطرّ إلى إزالة التطبيع (denormalization). وإزالة التطبيع تخزّن كلّ البيانات من الجداول المختلفة التي قد ترغب في الاطّلاع عليها دفعةً واحدة في موضعٍ واحد. وهذا يجعل قاعدتنا تبدو كنظام تخزين قائم على البحث بالمفاتيح، فيجدر بنا أن نسأل: وما نماذج البيانات الأخرى التي قد تناسب بياناتنا أفضل؟
وليس من الحكمة عادةً التخلّي عشوائيًا من سنواتٍ من الاعتبارات التصميمية. فإذا كنت تفكّر في تخزين بياناتك في قاعدة بيانات، فضع في اعتبارك SQL والنموذجَ العلائقي، فهما مدعومان بعقودٍ من البحث والتطوير، ويوفّران قدراتٍ غنية على النمذجة، ويقدّمان ضماناتٍ سهلة الفهم بشأن العمليات المعقّدة. أمّا NoSQL فهي خيارٌ جيّد عندما تكون أمام مشكلةٌ محدّدة، مثل كمياتٍ كبيرة من البيانات، أو حمل عملٍ هائل، أو قرارٍ صعب في نمذجة البيانات لا يكون SQL وقواعد البيانات العلائقية قد ضُبطت لأجله.
13.1.2. مصادر إلهام NoSQL
تستمدّ حركة NoSQL كثيرًا من إلهامها من أوراقٍ بحثية من مجتمع البحث. فبينما تقوم أوراقٌ كثيرة بجوهر قرارات التصميم في أنظمة NoSQL، تبرز ورقتان بعينهما بصورةٍ خاصة.
يقدّم BigTable من Google CDG+06 نموذج بياناتٍ مثيرًا للاهتمام، يتيح التخزينَ المرتَّب للبيانات التاريخية متعددة الأعمدة. وتُوزَّع البيانات على عدّة خوادم باستخدام مخطّطٍ هرمي للتقسيم قائم على المديات، وتُحدَّث البيانات باتساقٍ صارم (وهو مفهومٌ سنعرّفه لاحقًا في القسم 13.5).
ويستخدم Dynamo من Amazon DHJ+07 مخزنَ بياناتٍ موزّعًا موجَّهًا بالمفاتيح وبتصميمٍ مختلف. فنموذج بيانات Dynamo أبسط، إذ يربط المفاتيح بكتل بياناتٍ خاصّة بالتطبيق. أمّا نموذج التقسيم فيه فأكثر مرونةً في مواجهة الأعطال، لكنّه يحقّق ذلك عبر نهجٍ ألين في اتساق البيانات يُدعى الاتساق النهائي (eventual consistency).
سنتناول كلّ هذه المفاهيم بمزيدٍ من التفصيل، لكنّ من المهمّ أن تفهم أنّ كثيرًا منها يمكن الجمع بينها والمزج. فبعض أنظمة NoSQL مثل HBase[1] يلتزم عن قرب بتصميم BigTable. ونظام NoSQL آخر اسمه Voldemort[2] يكرّر كثيرًا من مزايا Dynamo. أمّا مشاريع NoSQL أخرى مثل Cassandra[3] فقد أخذت بعض المزايا من BigTable (نموذج بياناته) وبعضها من Dynamo (مخطّطات تقسيمها واتّساقها).
13.1.3. الخصائص والاعتبارات
تتخلّى أنظمة NoSQL عن المعيار الضخم (heavyweight) الخاص بـ SQL، بل تقدّم حلولًا أبسط وإن كانت متفرّقة لهندسة حلول التخزين. وقد بُنيت هذه الأنظمة على قناعةٍ بأنّ تبسيط طريقة عمل قاعدة البيانات على البيانات يتيح للمهندس التنبّؤَ بشكلٍ أفضل بالأداء للاستعلامات. وفي كثيرٍ من أنظمة NoSQL تُترك منطقيّات الاستعلام المعقّدة إلى التطبيق، ممّا ينتج عنه مخزنُ بياناتٍ ذي أداء استعلامٍ أكثر قابليةً للتنبّؤ بسبب انعدام تنوّع الاستعلامات
وتنحاز أنظمة NoSQL بعيدًا أكثر من مجرّد الاستعلامات التعريفية على البيانات العلائقية. فدلالات المعاملات (transactional semantics)، والاتساق (consistency)، والديمومة (durability) هي ضماناتٍ تطالب بها المؤسسات، كالبنوك، من قواعد البيانات. وتوفّر المعاملات (transactions) ضمانةً «كلّ شيء أو لا شيء» عند ضمّ عدة عملياتٍ يحتمل أن تكون معقّدة في عمليةٍ واحدة، مثل خصم مبلغٍ من حسابٍ وإضافته إلى حسابٍ آخر. ويضمن الاتساق (consistency) أنّ حين تُحدَّث قيمةٌ ما، سترى الاستعلاماتُ اللاحقةُ القيمةَ المحدَّثة. وتضمن الديمومة (durability) أنّه بمجرّد تحديث قيمةٍ ما، ستُكتب إلى تخزينٍ مستقرّ (مثل القرص الصلب) ويمكن استرجاعها إذا تعطّلت قاعدة البيانات.
تخفّف أنظمة NoSQL بعض هذه الضمانات، وهو قرارٌ قد يوفّر، لكثيرٍ من التطبيقات غير البنكية، سلوكًا مقبولًا ومتوقّعًا مقابل أداءٍ محسَّن. وغالبًا ما تجعل هذه التخفيفات، مقترنةً بتغييرات نموذج البيانات ولغة الاستعلام، من الأيسر تقسيمُ قاعدة البيانات بأمانٍ على عدّة أجهزة عندما تنمو البيانات فوق قدرة آلةٍ واحدة.
ولا تزال أنظمة NoSQL في بداياتها إلى حدٍّ بعيد. والقراراتُ المعمارية التي بُنيت عليها الأنظمة الموصوفة في هذا الفصل شهادةٌ على متطلبات المستخدمين المختلفين. وأصعب تحدٍّ في تلخيص السمات المعمارية لعدّة مشاريعٍ مفتوحة المصدر هو أنّ كلّ مشروعٍ منها هدفٌ متحرك. فاحرص على ألّا تكون تفاصيل الأنظمة الفردية ثابتة. وحين تختار بين أنظمة NoSQL، يمكنك أن تستعين بهذا الفصل لتوجيه تفكيرك، لكن ليس لاختيار منتجك ميزةً ميزة.
وفيما تفكّر في أنظمة NoSQL، إليك خارطة طريقٍ للاعتبارات:
- نموذج البيانات والاستعلام: هل تُمثَّل بياناتك صفوفًا، أم كائنات، أم بنى بيانات، أم مستندات؟ وهل يمكنك أن تطلب من قاعدة البيانات حساب الدوال التجميعية فوق سجلّاتٍ متعدّدة؟
- الديمومة: حين تغيّر قيمةً ما، هل تُكتب فورًا إلى التخزين المستقرّ؟ وهل تُخزَّن على عدّة أجهزةٍ احتياطًا في حال تعطّل أحدها؟
- قابلية التوسّع: هل تتّسع بياناتك على خادمٍ واحد؟ وهل تتطلّب كميات القراءة والكتابة عدّة أقراص للتعامل مع حمل العمل؟
- التقسيم: هل تحتاج البيانات، لأسباب قابلية التوسّع أو التوافرية أو الديمومة، أن تقيم على عدّة خوادم؟ وكيف تعرف أيّ سجلٍّ يقع على أيّ خادم؟
- الاتساق: إذا كنت قد قطّعت سجلّاتك وكرّرتها على عدّة خوادم، فكيف تتناغم الخوادم عند تغيّر سجلٍّ ما؟
- دلالات المعاملات: حين تنفّذ سلسلةً من العمليات، تسمح لك بعض قواعد البيانات بلفّها في معاملةٍ واحدة، وهو ما يوفّر مجموعةً جزئية من ضمانات ACID (الذرّية، والاتساق، والعزل، والديمومة) على تلك المعاملة وعلى غيرها الجاري تنفيذها. وهل يتطلّب منطق عملك هذه الضمانات، التي تأتي غالبًا على حساب الأداء؟
- الأداء على خادم واحد: إن أردت تخزين البيانات بأمانٍ على القرص، فما بنى البيانات على القرص الأكثر ملاءمةً لأحمال العمل كثيفة القراءة أو كثيفة الكتابة؟ وهل الكتابة إلى القرص هي عنق زجاجك؟
- أحمال العمل التحليلية: سنركّز كثيرًا على أحمال العمل كثيفة البحث، من النوع الذي تحتاجه لتشغيل تطبيق ويب سريع الاستجابة موجَّه للمستخدم. وفي كثيرٍ من الحالات، ستحتاج إلى بناء تقاريرٍ بحجم مجموعة البيانات، تجميع فيها إحصاءاتٍ عبر مستخدمين متعدّدين مثلًا. وهل يتطلّب استخدامك وأدواتك من هذه الوظائف؟
وسنمرّ على جميع هذه الاعتبارات، لكنّ الثلاثة الأخيرة، رغم أهميتها المتساوية، تحظّى بأقلّ قدرٍ من الاهتمام في هذا الفصل.
13.2. نماذج البيانات والاستعلام في NoSQL
يحدّد نموذج البيانات (data model) لقاعدة البيانات كيفية تنظيم البيانات منطقيًا. أمّا نموذج الاستعلام (query model) فيحدّد كيفية استرجاع البيانات وتحديثها. ونماذج البيانات الشائعة هي النموذج العلائقي، ونموذج التخزين الموجَّه بالمفاتيح، أو نماذج بيانية متنوّعة. ومن لغات الاستعلام التي قد تكون سمعت بها: SQL، والبحث بالمفاتيح، وMapReduce. وتجمع أنظمة NoSQL نماذجَ بياناتٍ واستعلامٍ مختلفة، ممّا ينتج عنه اعتباراتٌ معمارية متنوّعة.
13.2.1. نماذج بيانات NoSQL المعتمدة على المفاتيح
غالبًا ما تتخلّى أنظمة NoSQL من النموذج العلائقي ومن التعبيرية الكاملة لـ SQL، بتقييد عمليات البحث ضمن مجموعة البيانات بحقلٍ واحد. فمثلًا، حتى لو كان للموظف خصائصٌ كثيرة، قد لا تتمكّن إلّا من استرجاع الموظف بمعرّفه. ونتيجةً لذلك، تكون معظم الاستعلامات في أنظمة NoSQL قائمةً على البحث بالمفتاح. يختار المبرمج مفتاحًا يميّز كلّ عنصر بيانات، ولا يستطيع — في الغالب — استرجاع العناصر إلّا بإجراء بحثٍ عن مفاتيحها في قاعدة البيانات.
وفي الأنظمة القائمة على البحث بالمفتاح، قد تتطلّب عملياتُ الدمج المعقّدة أو استرجاعُ البيانات نفسها عبر مفتاحين متعدّدين استعمالاتٍ إبداعية لأسماء المفاتيح. فمبرمجٌ يريد البحث عن موظفٍ بمعرّفه، والبحث عن جميع موظفي قسمٍ ما، قد ينشئ نوعَين من المفاتيح. فمثلًا، يشير المفتاح employee:30 إلى سجلّ موظفٍ بمعرّف 30، وقد يحتوي employee_departments:20 على قائمة جميع الموظفين في القسم 20. ودائمًا ما تُدفع عمليةُ الدمج إلى داخل منطق التطبيق: فاسترجاع الموظفين في القسم 20 يتمّ أوّلًا بجلب قائمة معرّفات الموظفين من المفتاح employee_departments:20، ثمّ المرور في حلقةٍ على عمليات بحثٍ بالمفتاح لكلّ employee:ID في قائمة الموظفين.
ونموذجُ البحث بالمفتاح مفيدٌ لأنّه يعني أنّ لقاعدة البيانات نمط استعلامٍ متّسق—فالحمل العمل بأكمله يتألّف من عمليات بحثٍ بالمفاتيح أداؤها متقاربٌ نسبيًا وقابلٌ للتنبّؤ. كما أنّ تنقيط التطبيق للعثور على أبطأ أجزائه يصبح أسهل، لأنّ جميع العمليات المعقّدة تقيم في شيفرة التطبيق. وفي المقابل، صار منطق نموذج البيانات ومنطق العمل مترابطين بصورةٍ أقرب، وهو ما يُربك التجريد.
ولنُلمح سريعًا إلى البيانات المرتبطة بكلّ مفتاح. فأنظمة NoSQL المتنوّعة تقدّم حلولًا متنوّعةً في هذا المجال.
مخازن المفتاح والقيمة
أبسطُ أشكال مخازن NoSQL هو مخزنُ مفتاح-قيمة (key-value store). فكلّ مفتاحٍ يُربط بقيمةٍ تحتوي بياناتٍ اعتباطية. ولا يعرف مخزن NoSQL شيئًا عن محتوى حمولته (payload)، بل يسلّم البيانات إلى التطبيق ببساطة. وفي مثال قاعدة بيانات الموظفين لدينا، يمكن ربط المفتاح employee:30 بكتلة بياناتٍ (blob) تحتوي JSON، أو صيغةٍ ثنائيةٍ مثل Protocol Buffers[4]، أو Thrift[5]، أو Avro[6]، من أجل تغليف معلومات الموظف رقم 30.
وإذا استعمل المطوّر صيغًا منظّمة لتخزين بياناتٍ معقّدة خلف مفتاح، فعليه أن يتعامل مع البيانات في فضاء التطبيق: فمخزن بيانات المفتاح-القيمة لا يقدّم عمومًا أيّ آليات للاستعلام عن المفاتيح استنادًا إلى خاصيةٍ من خصائص قيمها. وتتفوّق مخازن المفتاح-القيمة ببساطة نموذج استعلامها، الذي يتكوّن عادةً من بدائل set وget وdelete، لكنها تفقد القدرة على إضافة قدرات تصفيةٍ بسيطة داخل قاعدة البيانات بسبب غموض قيمها. أمّا Voldemort، المستندة إلى Dynamo من Amazon، فتوفّر مخزنَ مفتاح-قيمةٍ موزّعًا. وتوفّر BDB[7] مكتبةَ ثباتٍ (persistence library) ذات واجهة مفتاح-قيمة.
مخازن المفاتيح وبنى البيانات
تعتمد مخازنُ المفاتيح وبنى البيانات، التي اشتهرت بها Redis[8]، على إسناد نوعٍ لكلّ قيمة. وفي Redis، الأنواع المتاحة التي يمكن أن تأخذها قيمةٌ ما هي: عددٌ صحيح، ونصٌّ، وقائمة، ومجموعة، ومجموعةٌ مرتّبة. وإلى جانب set/get/delete، تضيف الأوامرُ الخاصة بكلّ نوع، مثل الزيادة/الإنقاص للأعداد الصحيحة، أو الدفع/الإخراج للقوائم، وظائفَ إلى نموذج الاستعلام دون أن تؤثّر جذريًّا في الخصائص الأدائية للطلبات. وبتقديمه وظائفٍ بسيطةٍ خاصّة بكلّ نوع مع تجنّب العمليات التي تتعدّد المفاتيح، مثل التجميع وعمليات الدمج، فإنّ Redis يحقّق توازنًا بين الوظائف والأداء.
مخازن المفاتيح والمستندات
تُربط مخازنُ المفاتيح والمستندات، مثل CouchDB[9]، وMongoDB[10]، وRiak[11]، مفتاحًا بمستندٍ يحتوي معلوماتٍ منظّمة. وتخزّن هذه الأنظمة المستندات بصيغة JSON أو بصيغةٍ تشبهها. وهي تخزّن القوائم والقواميس، ويمكن تضمين أحدها داخل الآخر على نحوٍ متكرر.
وتفصل MongoDB فضاءَ المفاتيح (keyspace) إلى مجموعات (collections)، بحيث لا تتصادم مفاتيح الموظفين والأقسام مثلًا. أمّا CouchDB وRiak فيتركان تتبّعَ الأنواع للمطوّر. وحرّيةُ مخازن المستندات وتعقيدُها سيف ذو حدّين: فمطوّرو التطبيقات يتمتّعون بحرّيةٍ واسعة في نمذجة مستنداتهم، لكنّ منطق الاستعلام القائم على التطبيق قد يصبح معقّدًا إلى حدٍّ بعيد.
مخازن عائلات أعمدة BigTable
تستند HBase وCassandra في نموذجهما للبيانات إلى النموذج المستخدَم في BigTable من Google. وفي هذا النموذج، يميّز مفتاحٌ صفًّا، يحتوي على بياناتٍ مخزّنة في عائلة أعمدة واحدة (Column Family) أو أكثر (CFs). وداخل CF واحد، يمكن أن يحتوي كلّ صفٍّ على أعمدةٍ متعدّدة. والقيم داخل كلّ عمودٍ مختومةٌ بطوابع زمنية، بحيث يمكن أن تتعايش عدّة إصدارات لارتباط صف-عمود داخل CF واحد.
ومن الناحية المفاهيمية، يمكن التفكير في عائلات الأعمدة بوصفها تخزّن مفاتيح معقّدةً من الشكل (معرّف الصف، CF، العمود، الطابع الزمني)، وهي مفاتيحٌ ترتبط بقيمٍ مرتّبةٍ وفق مفاتيحها. ويؤدّي هذا التصميم إلى قرارات نمذجة بياناتٍ تدفع كثيرًا من الوظائف إلى فضاء المفاتيح. وهو جيّدٌ خصوصًا في نمذجة البيانات التاريخية ذات الطوابع الزمنية. ويدعم النموذجُ بطبيعته وضعَ الأعمدة المتفرّق (sparse) من الناحية البنيوية، إذ لا تحتاج معرّفاتُ الصفوف التي تفتقر إلى أعمدةٍ بعينها إلى قيمة NULL صريحة لتلك الأعمدة. وفي المقابل، يجب على الأعمدة التي تملك قيم NULL قليلةً أو معدومة أن تخزّن معرّف العمود مع كلّ صفٍّ، وهو ما يؤدّي إلى استهلاكٍ أكبر للمساحة.
ويختلف نموذج بيانات كلّ مشروع عن نموذج BigTable الأصلي في طرائقَ متعدّدة، لكنّ تعديلات Cassandra هي الأكثر لفتًا. إذ تقدّم Cassandra مفهوم العمود الفائق (supercolumn) داخل كلّ CF، مما يسمح بمستوىً إضافيٍّ من الربط والنمذجة والفهرسة. كما أنّها تتخلّى من مفهوم مجموعات الموضعية (locality groups)، التي يمكنها أن تخزّن عدّة عائلات أعمدة معًا فعليًّا لأسبابٍ تتعلّق بالأداء.
13.2.2. التخزين البياني
إحدى فئات مخازن NoSQL هي مخازنُ البيانيات (graph stores). فالبيانات ليست جميعها على قدم المساواة، ولا النماذجُ العلائقية ولا النماذجُ الموجَّهة بالمفاتيح لتخزين البيانات واستعلامها هي الأفضل لجميع البيانات. والبيانياتُ (graphs) بنيةُ بياناتٍ أساسية في علوم الحاسوب، وأنظمةٌ مثل HyperGraphDB[12] وNeo4J[13] نظامان شهيران من أنظمة تخزين NoSQL لتخزين البيانات ذات البنية البيانية. وتختلف مخازنُ البيانيات عن المخازن التي ناقشناها حتى الآن في كلّ تقريب: نماذج البيانات، وأنماط اجتياز البيانات والاستعلام عنها، والتوزيع المادي للبيانات على القرص، والتوزيع على عدّة أجهزة، والدلالات المعاملية للاستعلامات. ولا يتّسع المجال لمنح هذه الفروق البالغة حقّها من العناية، لكن ينبغي أن تكون على عِلم بأنّ بعض فئات البيانات قد يكون تخزينُها واستعلامُها علىهيئة بياني أنسب.
13.2.3. الاستعلامات المعقّدة
هناك استثناءاتٌ ملفّة للبحث بالمفتاح وحده في أنظمة NoSQL. فـ MongoDB يتيح لك فهرسة بياناتك استنادًا إلى أيّ عددٍ من الخصائص، ويملك لغةً عالية المستوى نسبيًّا لتحديد البيانات التي تريد استرجاعها. أمّا الأنظمة المعتمدة على BigTable فتدعم الماسحات (scanners) لتكرار المرور على عائلة أعمدة، ولاختيار عناصر بعينها عبر عامل تصفيةٍ على عمود. ويتيح لك CouchDB إنشاءَ عروضٍ مختلفة للبيانات، وتشغيلِ مهام MapReduce عبر جدولك لتسهيل عمليات البحث والتحديث الأكثر تعقيدًا. ولمعظم هذه الأنظمة روابطُ ربطٍ (bindings) إلى Hadoop أو إلى إطار MapReduce آخر لتنفيذ استعلاماتٍ تحليلية بحجم مجموعة البيانات.
13.2.4. المعاملات
تميل أنظمة NoSQL عمومًا إلى إعطاء الأولوية للأداء على حساب دلالات المعاملات. أمّا أنظمة SQL الأخرى فتسمح بوضع أيّ مجموعة عبارات—من استرجاعٍ بسيط لصفٍّ عبر مفتاحٍ أساسي، إلى دمجٍ معقّد بين عدّة جداول ثمّ يُحسب متوسّطه عبر حقولٍ متعدّدة—داخل معاملةٍ واحدة.
وتوفّر قواعد بيانات SQL هذه ضمانات ACID بين المعاملات. فتنفيذ عدّة عملياتٍ في معاملةٍ واحدة ذرّي (وهو حرف A في ACID)، ما يعني أن تُنفَّذ جميع العمليات أو لا يُنفَّذ شيء. ويضمن الاتساق (حرف C) أن تترك المعاملةُ قاعدة البيانات في حالةٍ متّسقةٍ غير تالفة. ويضمن العزل (حرف I) أنّ إذا لمست معاملتان السجلَّ نفسه، فلن تتداخلا فوق بعضهما. أمّا الديمومة (حرف D، وتُشرح بتفصيلٍ مطوّل في القسم التالي) فتضمن أنّه بمجرّد اعتماد المعاملة (commit)، فإنّها تُخزَّن في مكانٍ آمن.
والمعاملاتُ المتوافقة مع ACID تُبقي المطوّرين في حالٍ عقليةٍ سليمة، إذ تجعل من السهل استنتاج حالة بياناتك. تخيّل معاملاتٍ متعدّدة، كلٌّ منها يتألّف من خطواتٍ متعدّدة (مثلًا: تحقّق أوّلًا من رصيد حسابٍ بنكي، ثمّ اطرح $60، ثمّ حدّث القيمة). وغالبًا ما تكون قواعد البيانات المتوافقة مع ACID محدودةً في قدرتها على تشابك هذه الخطوات مع إبقاء النتيجة صحيحة عبر جميع المعاملات. ويؤدّي هذا السعي نحو الصحّة إلى خصائص أداءٍ غير متوقّعة في كثيرٍ من الأحيان، إذ قد تجعل معاملةٌ بطيئة معاملةً أخرى كانت سريعة الانتظار في الطابور.
وتختار معظم أنظمة NoSQL الأداءَ على حساب ضمانات ACID الكاملة، لكنها توفّر ضماناتٍ على مستوى المفتاح: فالعملياتُ على المفتاح نفسه ستُسلسَل (serialize)، ممّا يتجنّب التلف الكبير في أزواج المفتاح والقيمة. ولكثيرٍ من التطبيقات، لن يسبّب هذا القرارُ مشكلاتِ صحّةٍ تُذكر، وسيتيح تنفيذَ العمليات السريعة بانتظامٍ أكبر. غير أنّه يترك قدرًا أكبر من الاعتبارات المتعلّقة بتصميم التطبيق وصحّته في عهدة المطوّر.
وRedis هو الاستثناءُ الملفّ لاتجاهٍ لا معاملات فيه. فهو على خادمٍ واحد يوفّر الأمر MULTI لدمج عدّة عملياتٍ ذرّيًا ومتسّقة، والأمر WATCH للسماح بالعزل. وتوفّر أنظمةٌ أخرى وظائفّ اختبار-وضبط (test-and-set) ذات مستوىٍ أدنى، وهي تقدّم بعض ضمانات العزل.
13.2.5. التخزين بلا مخطّط
من الخاصّيات العابرة لأغلبية أنظمة NoSQL غيابُ فرض المخطّط (schema) داخل قاعدة البيانات. فحتى في مخازن المستندات وفي المخازن الموجَّهة بعائلات الأعمدة، لا يُشترط أن تكون الخصائص عبر الكيانات المتشابهة متطابقة. ولهذا الأمر فائدتان: دعم متطلّبات بياناتٍ أقلّ انتظامًا، وحاجتها إلى نفقة أداءٍ أقلّ عند تعديل المخطّطات أثناء التشغيل. ويترك هذا القرارُ مسؤوليةً أكبر لمطوّر التطبيق، الذي عليه الآن أن يبرمج على نحوٍ أكثر دفاعًا. فمثلًا: هل غيابُ خاصية lastname في سجلّ موظفٍ خطأٌ ينبغي تصحيحه، أم تحديثُ مخطّطٍ يجري حاليًا انتشارُه في النظام؟ وتجعل إصداريةُ البيانات والمخطّطات (data and schema versioning) أمرًا شائعًا في شيفرةٍ على مستوى التطبيق بعد بضع دوراتٍ من العمل على مشروعٍ يعتمد على أنظمة NoSQL ذات مخطّطٍ غير مُحكم (sloppy-schema).
13.3. ديمومة البيانات
من المفترض مثاليًّا أن تُحفظ جميع تعديلات البيانات على نظام تخزينٍ فورًا وبأمانٍ وتُكرَّر في مواضعَ متعدّكة تفاديًا لفقدان البيانات. غير أنّ ضمان سلامة البيانات يتنازع مع الأداء، وأنظمة NoSQL متنوّعة تقدّم ضماناتٍ مختلفة لـديمومة البيانات (data durability) من أجل تحسين الأداء. فسيناريوهات الأعطال متنوّعةٌ وعديدة، ولا تحميك كلّ أنظمة NoSQL من هذه المشكلات.
سيناريوُ عطلٍ بسيطٍ وشائع هو إعادة تشغيل خادمٍ أو انقطاع التيار الكهربائي. ويتضمّن ضمانُ ديمومة البيانات في هذه الحالة نقلَ البيانات من الذاكرة إلى قرصٍ صلب، وهو تخزينٌ لا يحتاج إلى طاقةٍ كهربائية. أمّا أعطال الأقراص الصلبة فتُعالَج بنسخ البيانات إلى أجهزةٍ ثانوية، سواء كانت أقراصًا صلبة أخرى في الآلة نفسها (المرايا عبر RAID أي RAID mirroring)، أو أجهزةٍ أخرى على الشبكة. غير أنّ مركز بياناتٍ ما قد لا ينجو من حدثٍ يُسبّب فشلًا مترابطًا (إعصارًا مثلًا)، وبعض المؤسسات تذهب بعيدًا إلى حدّ نسخ البيانات إلى النسخة الاحتياطية في مراكز بياناتٍ يفصل بينها عرضُ إعصار. والكتابةُ إلى الأقراص الصلبة ونسخُ البيانات إلى عدّة خوادم أو مراكز بياناتٍ مكلف، لذا تُقايض أنظمة NoSQL المتنوّرة ضمانات الديمومة مقابل الأداء.
13.3.1. الديمومة على خادم واحد
أبسطُ أشكال الديمومة هو الديمومة على خادمٍ واحد (single-server durability)، وهي التي تضمن أن أيّ تعديلٍ على البيانات سينجو من إعادة تشغيل الخادم أو من انقطاع التيار الكهربائي. وهذا يعني عادةً كتابة البيانات المتغيّرة إلى القرص، وهو ما يشكّل عنق زجاجة في حمل عملك غالبًا. فحتى لو أمرت نظام التشغيل بكتابة البيانات إلى ملفٍّ على القرص، فقد يحتجز نظامُ التشغيل عمليةَ الكتابة مؤقتًا، فيؤجّل التعديل على القرص كي يجمّع عدّة عمليات كتابةٍ في عمليةٍ واحدة. ولا يحاول نظامُ التشغيل وبذل أقصى جهدٍ لضمان كتابة التحديثات المخزَّنة مؤقتًا إلى القرص إلّا حين يُصدر استدعاءُ النظام fsync.
ويمكن للأقراص الصلبة النموذجية أن تُنجز 100-200 وصولٍ عشوائي (بحث) في الثانية، وهي محدودة بـ 30-100 ميغابايت/ثانية من الكتابات التسلسلية. ويمكن أن تكون الذاكرة أسرعَ بمقدار رتبةٍ كاملة (orders of magnitude) في الحالتين معًا. ويقضي ضمانُ ديمومةٍ فعّالة على خادمٍ واحد بتقييد عدد الكتابات العشوائية التي يتكبّدها نظامك، وزيادة عدد الكتابات التسلسلية لكلّ قرصٍ صلب. وفي الحالة المثلى، تريد لنظامٍ ما أن يقلّل عدد الكتابات بين استدعاءات fsync، وأن يزيد إلى أقصى حدّ نسبة تلك الكتابات التي تتسلسل، وكل ذلك دون أن تُخبر المستخدم قطّ بأنّ بياناته كُتبت بنجاح إلى القرص قبل أن تُمرَّر تلك الكتابة عبر fsync. وسنغطّي بعض التقنيات لتحسين أداء ضمانات الديمومة على خادمٍ واحد.
التحكّم في معدّل استدعاء fsync
Memcached[14] مثالٌ على نظامٍ لا يوفّر أيّ ديمومةٍ على القرص مقابل عملياتٍ داخل الذاكرة فائقة السرعة. فعند إعادة تشغيل الخادم، تختفي البيانات الموجودة عليه: وهذا يجعله ذاكرةَ تخزينٍ مؤقّتٍ ممتازة، ومخزنَ بياناتٍ دائمًا سيّئًا.
ويقدّم Redis للمطوّرين عدّة خياراتٍ حول متى تُستدعى fsync. فيمكن للمطوّر أن يُجبر النظام على استدعاء fsync بعد كلّ تحديث، وهو الخيار البطيء الآمن. ولتحقيق أداء أفضل، يمكن لـ Redis أن ينفّذ fsync لعمليات الكتابة كلّ N ثانية. وفي أسوأ الحالات، ستفقد قيمة آخر N ثانية من العمليات، وقد يكون ذلك مقبولًا في بعض الاستخدامات. وأخيرًا، في حالات الاستخدام التي لا تهمّ فيها الديمومة (كصيانة إحصاءاتٍ تجريبية، أو استخدام Redis كذاكرةٍ تخزينٍ مؤقّت)، يمكن للمطوّر إيقاف استدعاءات fsync تمامًا: فسيؤدي نظامُ التشغيل في النهاية تفريغَ البيانات إلى القرص، لكن من دون ضماناتٍ بشأن موعد حدوث ذلك.
زيادة الكتابات التسلسلية عبر السجلّ
تساعد عدّة بنى بياناتٍ، مثل أشجار B+ (B+Trees)، أنظمة NoSQL على استرجاع البيانات من القرص بسرعة. وتؤدّي التحديثات على تلك البنى إلى تحديثاتٍ في مواضعَ عشوائية من ملفات تلك البنى، وهو ما ينتج عنه عدّة كتاباتٍ عشوائية لكلّ تحديث إذا نفّذت fsync بعد كلّ تحديث. وللتقليل من الكتابات العشوائية، تُلحق أنظمةٌ مثل Cassandra وHBase وRedis وRiak عملياتِ التحديث إلى ملفٍّ يُكتب تسلسليًّا ويُدعى السجلّ (log). وفيما تُنفَّذ fsync على البنى الأخرى المستعملة في النظام دوريًّا فقط، فإنّ السجلّ تُنفَّذ عليه fsync بشكلٍ متكرّر. وبمعاملة السجلّ بوصفه الحالة المرجعية الموثوقة لقاعدة البيانات بعد تعطُّرها، تستطيع محرّكات التخزين هذه تحويل التحديثات العشوائية إلى تحديثاتٍ تسلسلية.
وبينما تُنفّذ أنظمة NoSQL مثل MongoDB الكتابات في موضعها داخل بنى البيانات الخاصة بها، فإنّ غيرها يأخذ فكرة السجلّ أبعدَ من ذلك. فـ Cassandra وHBase تستخدمان تقنيةً مستعارةً من BigTable، تقضي بمزج سجلّاتها وبنى البحث فيها في شجرة دمجٍ قائمةٍ على السجلّ (log-structured merge tree) واحدة. وتوفّر Riak وظيفةً مشابهةً عبر جدول تجزئةٍ قائمٍ على السجلّ (log-structured hash table). أمّا CouchDB فقد عدّلت شجرة B+ التقليدية بحيث تُلحَق جميع التغييرات في بنية البيانات بالبنية نفسها على التخزين الفيزيائي. وتؤدّي هذه التقنيات إلى رفع إنتاجية الكتابة، لكنها تتطلّب ضغطًا دوريًا للسجلّ كي لا ينمو بلا حدّ.
زيادة الإنتاجية عبر تجميع الكتابات
تجمع Cassandra عدّة تحديثاتٍ متزامنةٍ ضمن نافذةٍ زمنية قصيرة في استدعاء fsync واحد. وهذا التصميم، المسمّى الالتزام الجماعي (group commit)، يؤدّي إلى ارتفاع الكمون (latency) لكلّ تحديث، إذ يضطر المستخدمون إلى انتظار عدة تحديثاتٍ متزامنةٍ كي يتمّ الإقرار بتحديثهم. ويأتي ارتفاع الكمون مقابل زيادةٍ في الإنتاجية، إذ يمكن أن تتمّ عدة إضافاتٍ إلى السجلّ باستدعاء fsync واحد. وحتى تاريخ كتابة هذا النص، يُثبَت كلّ تحديثٍ في HBase في التخزين الأساسي الذي يوفّره نظام الملفات الموزّع لـ Hadoop (HDFS)[15]، وقد شهد مؤخرًا ترقيعاتٍ تدعم الإلحاق مع احترام fsync والالتزام الجماعي.
13.3.2. الديمومة عبر عدّة خوادم
ولأنّ الأقراص الصلبة والآلات كثيرًا ما تتعطّل بصورةٍ لا يمكن إصلاحها، وجوبُ نسخ البيانات المهمّة عبر الآلات. وتوفّر كثيرٌ من أنظمة NoSQL ديمومةً للبيانات عبر عدّة خوادم (multi-server durability).
يتّبع Redis نهجًا تقليديًا رئيسيًّا-تابعًا (master-slave) في تكرار البيانات. فتُبلَّغ جميع العمليات التي تُنفَّذ ضدّ الخادم الرئيسي إلى الآلات التابعة بأسلوبٍ يشبه السجلّ، وهي تكرّر تلك العمليات على عتادها الخاص. وإذا تعطّل الخادم الرئيسي، فيمكن لتابعٍ أن يتولّى الخدمة ويقدّم البيانات من حالة سجلّ العمليات الذي تلقّاه من الرئيسي. وقد يؤدّي هذا التكوين إلى فقدانٍ في بعض البيانات، إذ لا يؤكّد الخادم الرئيسي أنّ تابعه قد ثبّت العملية في سجلّه قبل الإقرار بها للمستخدم. أمّا CouchDB فتُسهّل شكلًا مشابهًا من التكرار الاتجاهي (directional replication)، حيث يمكن ضبط الخوادم لتكرّر التغييرات في المستندات إلى مخازنَ أخرى.
تقدّم MongoDB مفهوم مجموعات التكرارات (replica sets)، حيث يكون عددٌ من الخوادم مسؤولًا عن تخزين كلّ مستند. وتمنح MongoDB المطوّرين خيار ضمان وصول جميع التكرارات إلى التحديثات، أو المتابعة دون التأكّد من امتلاك التكرارات لأحدث البيانات. وتدعم كثيرٌ من أنظمة تخزين NoSQL الموزّعة الأخرى التكرارَ متعدّد الخوادم للبيانات. أمّا HBase، المبنيّة فوق HDFS، فتحصل على ديمومةٍ متعدّدة الخوادم عبر HDFS. فتُكرَّر جميع عمليات الكتابة إلى عقدتين من عقد HDFS أو أكثر قبل إعادة التحكّم إلى المستخدم، ممّا يضمن الديمومة عبر عدّة خوادم.
وتدعم Riak وCassandra وVoldemort أشكالًا أكثر قابليةً للضبط من التكرار. وبفروقٍ دقيقة، تسمح الأنظمةُ الثلاثة للمستخدم بتحديد N، وهو عدد الآلات التي ينبغي أن يكون لديهنّ في نهاية المطاف نسخةٌ من البيانات، وW<N، وهو عدد الآلات التي ينبغي أن تؤكّد كتابة البيانات قبل إعادة التحكّم إلى المستخدم.
ولمعالجة الحالات التي يخرج فيها مركز بياناتٍ كاملٌ عن الخدمة، يلزم التكرارُ متعدّد الخوادم عبر مراكز البيانات. ولكلٍّ من Cassandra وHBase وVoldemort إعداداتُ واعيةٍ بالرفوف (rack-aware)، تحدّد الرفّ أو مركز البيانات الذي تقع فيه الآلات المختلفة. وبوجهٍ عام، فإنّ حبس طلب المستخدم حتى يؤكّد خادمٌ بعيدٌ تحديثًا يسبّب كمونًا شديدًا. لذا تُبَثّ التحديثات دون تأكيدٍ عند تنفيذها عبر شبكات المساحة الواسعة نحو مراكز البيانات الاحتياطية.
13.4. التوسّع من أجل الأداء
بعد أن تحدّثنا للتوّ عن التعامل مع الأعطال، فلنتخيّل موقفًا أكثر إشراقًا: النجاح! فإذا بلغ نظامك الذي تبنيه النجاحَ، فإنّ مخزن بياناتك سيكون أحد المكوّنات التي تشعر بالضغط تحت الحمل. والحلّ الرخيص والسريع لهذه المشكلات هو أن توسّع سعة (scale up) عتادك القائم: تستثمر في مزيدٍ من الذاكرة العشوائية والأقراص للتعامل مع حمل العمل على آلةٍ واحدة. ومع نجاحٍ أكبر، سيصبح صبّ الأموال في عتادٍ باهظ الثمن أمرًا غير عملي. وفي هذه اللحظة، سيصبح عليك أن تكرّر البيانات وتوزّع الطلبات على عدّة آلات لتوزيع الحمل. ويُدعى هذا النهج التوسّع الأفقي (scale out)، ويُقاس بـقابلية التوسّع الأفقية (horizontal scalability) لنظامك.
الهدف المثالي لقابلية التوسّع الأفقية هو قابلية التوسّع الخطية (linear scalability)، وفيها تُضاعِف مضاعفةُ عدد الآلات في نظام تخزينك سعةَ الاستعلام في النظام. ومفتاحُ هذه القابلية يكمن في كيفية توزيع البيانات على الآلات. أمّا التجزئة (sharding) فهي فعلُ تقسيم حمل القراءة والكتابة عبر عدّة آلاتٍ لتوسيع نظام تخزينك أفقيًّا. والتجزئة أساسيّةٌ في تصميم أنظمةَ كثيرة، ومنها Cassandra وHBase وVoldemort وRiak، ثمّ حديثًا MongoDB وRedis. وبعض المشاريع مثل CouchDB تركّز على الأداء على خادمٍ واحد ولا تقدّم حلًّا داخليًّا في النظام للتجزئة، لكنّ مشاريعٍ ثانوية توفّر منسّقين (coordinators) لتقسيم حمل العمل على عدّة تثبيتاتٍ مستقلّةٍ موزّعةٍ على عدّة آلات.
ولنغطّ بعض المصطلحات المتبادلة التي قد تصادفك. سنستعمل مصطلحَي التجزئة (sharding) والتقسيم (partitioning) بالتبادل. أمّا مصطلح الآلة أو الخادم أو العقدة فيشير إلى حاسوبٍ فيزيائيٍّ يخزّن جزءًا من البيانات المقسَّمة. وأخيرًا، تشير العنقود (cluster) أو الحلقة (ring) إلى مجموعة الآلات التي تشترك في نظام التخزين الخاص بك.
تعني التجزئةُ أنّ لا آلةَ واحدةً مضطرة إلى تحمل حمل الكتابة على مجموعة البيانات كاملة، لكنّه كذلك لا يمكن لأيّ آلةٍ واحدة أن تجيب عن الاستعلامات المتعلقة بمجموعة البيانات بأكملها. ومعظم أنظمة NoSQL موجَّهةٌ بالمفاتيح في نمذجيها للبيانات والاستعلام، وقليلةٌ من الاستعلامات تمسّ مجموعة البيانات بأكملها على أيّ حال. وبما أنّ طريقة الوصول الأوّلي إلى البيانات في هذه الأنظمة قائمةٌ على المفاتيح، فإنّ التجزئة تكون بدورها قائمةً على المفاتيح: فبعض دالةٍ للمفتاح تحدّد الآلة التي يُخزَّن عندها زوجُ المفتاح والقيمة. وسنغطّي طريقتين لتعيين ربط المفتاح بالآلة: التقسيمُ بالتجزئة (hash partitioning)، والتقسيمُ حسب المدى (range partitioning).
13.4.1. لا تُجزِّع بياناتك قبل أن تضطرّ
تضيف التجزئةُ تعقيدًا إلى النظام، وينبغي متى أمكن تجنّبها. ولنستعرض طريقتين للتوسّع من دون تجزئة: نسخ القراءة والتخزين المؤقّت.
نسخ القراءة
ترى كثيرٌ من أنظمة التخزين طلباتِ قراءةٍ أكثر من طلبات الكتابة. والحلّ البسيط في هذه الحالات هو إنشاءُ نسخٍ من البيانات على عدّة آلات. وتظلّ جميع طلبات الكتابة متّجهةً إلى عقدةٍ رئيسية. أمّا طلبات القراءة فتتّجه إلى آلاتٍ تكرّر البيانات، وكثيرًا ما تكون قديمةً قليلًا بالنسبة إلى البيانات على العقدة الرئيسية للكتابة.
وإن كنتَ تُكرّر بياناتك أصلًا لأغراض الديمومة متعدّدة الخوادم في تكوينٍ رئيسي-تابع، كما هو شائع في Redis أو CouchDB أو MongoDB، فيمكن للنسخ التابعة للقراءة أن تُخفّف بعض الحمل عن العقدة الرئيسية للكتابة. فبعض الاستعلامات، مثل الملخّصات التجميعية لمجموعة بياناتك، التي قد تكون باهظة الثمن وغالبًا ما لا تتطلّب حداثةً في الثانية، يمكن تنفيذها على النسخ التابعة. وبوجهٍ عام، كلّما كانت متطلّباتك في حداثة المحتوى أقلّ صرامةً، ازداد اعتمادك على النسخ التابعة لتحسين أداء استعلامات القراءة فقط.
التخزين المؤقّت
غالبًا ما ينجح التخزينُ المؤقّت (caching) للمحتوى الأكثر رواجًا في نظامك على نحوٍ مدهش. فـ Memcached يخصّص كتلَ ذاكرةٍ على عدّة خوادم لتخزين بياناتك مؤقتًا. وتستفيد عملاءُ Memcached من عدة حيلٍ في قابلية التوسّع الأفقي لتوزيع الحمل على تثبيتات Memcached الموزّعة على خوادمٍ مختلفة. ولإضافة ذاكرةٍ إلى بركة التخزين المؤقّت، يكفي إضافةُ مضيف Memcached آخر.
ولأنّ Memcached مصمَّمٌ من أجل التخزين المؤقّت، فلا يملك التعقيدَ المعماري الذي تملكه الحلولُ الدائمة لتوسيع أحمال العمل. وقبل أن تفكّر في حلولٍ أعقد، اسأل نفسك: هل يمكن للتخزين المؤقّت أن يحلّ مشاكلك في قابلية التوسّع؟ والتخزينُ المؤقّت ليس ضمادةً مؤقتةً فحسب: ففي Facebook توجد تثبيتات Memcached بمجموع عشرات التيرابايتات من الذاكرة!
وتتيح لك نسخُ القراءة والتخزينُ المؤقّت توسيعَ أحمال العمل كثيفة القراءة. غير أنّك حين تبدأ في زيادة معدّل الكتابات والتحديثات لبياناتك، فستزيد أيضًا الحمل على الخادم الرئيسي الذي يحتوي جميع بياناتك المحدَّثة. وفي بقيّة هذا القسم، سنغطّي تقنياتٍ لتجزئة حمل الكتابة عبر عدّة خوادم.
13.4.2. التجزئة عبر المنسّقين
يركّز مشروع CouchDB على تجربة الخادم الواحد. ومشروعان، هما Lounge وBigCouch، ييسّران تجزئة أحمال عمل CouchDB عبر وكيلٍ خارجي، يعمل كواجهةٍ أماميةٍ لنسخ CouchDB المستقلّة. وفي هذا التصميم، لا تكون التثبيتات المستقلّة على عِلمٍ ببعضها. ويوزّع المنسّق الطلبات على نسخ CouchDB الفردية استنادًا إلى مفتاح المستند المطلوب.
وقد بَنَت Twitter مفهومي التجزئة والتكرار في إطارٍ تنسيقيٍّ اسمُه Gizzard[16]. يأخذ Gizzard مخازن بياناتٍ مستقلّةً من أيّ نوع—إذ يمكنك بناء أغلفةٍ (wrappers) لأنظمة تخزين SQL أو NoSQL—ويرتّبها في أشجارٍ من أيّ عمقٍ لتقسيم المفاتيح حسب مدى المفاتيح. ومن أجل تحمّل الأعطال، يمكن ضبط Gizzard ليكرّر البيانات إلى عدّة آلاتٍ فيزيائية لنفس مدى المفاتيح.
13.4.3. حلقات التجزئة المتّسقة
توزّع دوالّ التجزئة (hash functions) الجيدة مجموعةَ مفاتيحٍ بطريقةٍ متّسمة. وهذا يجعلها أداةً قويّةً لتوزيع أزواج المفتاح والقيمة على عدّة خوادم. والأدبيّة العلمية حول تقنيةٍ تُدعى التجزئة المتّسقة (consistent hashing) واسعة، وكانت أولى تطبيقاتها على مخازن البيانات في أنظمةٍ تُدعى جداولُ التجزئة الموزّعة (distributed hash tables، أو DHTs). وقد تبنّت أنظمة NoSQL المبنيّة على مبادئ Dynamo من Amazon تقنية التوزيع هذه، وهي تظهر في Cassandra وVoldemort وRiak.
حلقات التجزئة بالأمثلة
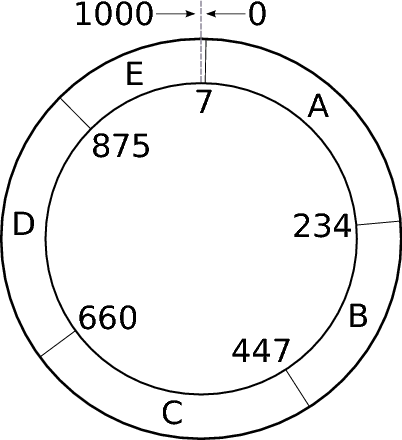
الشكل 13.1: حلقة جدول تجزئة موزّع
تعمل حلقاتُ التجزئة المتّسقة على النحو التالي. لنفترض لدينا دالةُ تجزئة H تربط المفاتيح بقيمَ أعدادٍ صحيحةٍ كبيرةٍ موزّعةٍ بانتظام. يمكننا تشكيل حلقةِ أعدادٍ في المدى [1, L] تلتفّ حول نفسها بهذه القيم، عبر أخذ H(key) mod L من أجل عددٍ صحيح L كبيرٍ نسبيًّا. وسيُنتج هذا ربطًا لكلّ مفتاحٍ ضمن المدى [1,L]. أمّا حلقةُ التجزئة المتّسقة للخوادم فتُشكَّل بأخذ المعرّف الفريد لكلّ خادم (ولعنوانه IP مثلًا)، وتطبيق H عليه. ويمكنك استكشاف طريقة عمل هذه الآلية بالنظر إلى حلقة التجزئة المشكلة من خمسة خوادم (A-E) في الشكل 13.1.
وهناك اخترنا L = 1000. لنفترض أنّ H(A) mod L = 7، وH(B) mod L = 234، وH(C) mod L = 447، وH(D) mod L = 660، وH(E) mod L = 875. أصبحنا الآن قادرين على تحديد الخادم الذي ينبغي أن يعيش فيه أيّ مفتاح. ونفعل ذلك بربط كلّ المفاتيح بخادمٍ بمعرفة ما إذا كان يقع في المدى بين ذلك الخادم والتالي له في الحلقة. فمثلًا، الخادم A مسؤول عن المفاتيح التي تقع قيمةُ تجزئتها في المدى [7,233]، والخادم E مسؤول عن المفاتيح الواقعة في المدى [875, 6] (وهذا المدى يلتفّ حول نفسه عند 1000). فإذا كان H('employee30') mod L = 899، فسيخزّنه الخادم E، وإذا كان H('employee31') mod L = 234، فسيخزَّن على الخادم B.
تكرار البيانات
يُتحقّق التكرارُ لأغراض الديمومة متعدّدة الخوادم بتمرير المفاتيح والقيم الواقعة في مدى خادمٍ ما إلى الخوادم التي تليه في الحلقة. فمثلًا، مع معامل تكرارٍ قدرُه 3، تُخزَّن المفاتيح المرتبطة بالمدى [7,233] على الخوادم A وB وC. ولو تعطّل A لتولّى جيرانُه B وC حملَ عمله. وفي بعض التصاميم، يتولّى E التكرار ويأخذ على عاتقه حملَ عمل A مؤقتًا، لأنّ مداه يتمدّد ليضمّ مدى A.
تحقيق توزيع أفضل
على الرّغم من أنّ التجزئةَ فعّالةٌ إحصائيًّا في التوزيع المنتظم لفضاء المفاتيح، فإنّها عادةً ما تتطلّب عددًا كبيرًا من الخوادم قبل أن توزّع بالتساوي. وللأسف، فإنّنا غالبًا ما نبدأ بعددٍ صغيرٍ من الخوادم التي لا تفصلها دالةُ التجزئة تفصيلًا مثاليًّا. ففي مثالنا، مدى مفاتيح الخادم A طوله 227، في حين يبلغ مدى الخادم E 132. ويؤدّي ذلك إلى حملٍ غير متوازنٍ على الخوادم المختلفة. كما يجعل من الصعب على الخوادم أن تتولّى بعضها عن بعض عند تعطّلها، إذ يتولّى الجار فجأةً التحكّمَ في مدى الخادم المتعطّل بأكمله.
ولحلّ مشكلة المدَيات الكبيرة غير المتساوية، تنشئ عدّةٌ من جداول التجزئة الموزّعة، ومنها Riak، عدّة virtual' عقدٍ افتراضية لكلّ آلةٍ فيزيائية. فمثلًا، مع 4 عقدٍ افتراضية، سيعمل الخادم Aبوصفه الخوادمA_1 وA_2 وA_3 وA_4`. وتجزئةُ كلّ عقدةٍ افتراضية إلى قيمةٍ مختلفةٍ تمنحها فرصةً أكبر لإدارة المفاتيح الموزَّعة على أجزاءٍ مختلفة من فضاء المفاتيح. ويتّبع Voldemort نهجًا مشابهًا، إذ يُضبط عددُ الأقسام يدويًا ويكون عادةً أكبرَ من عدد الخوادم، ممّا ينتج عن ذلك تلقّي كلّ خادمٍ لعددٍ من الأقسام الأصغر حجمًا.
ولا تُسند Cassandra أقسامًا صغيرةً متعدّدة إلى كلّ خادم، وهو ما يؤدّي أحيانًا إلى توزيعاتٍ غير متساوية لمديات المفاتيح. ولموازنة الحمل، تملك Cassandra عمليةً غير متزامنة تعدّل موضعَ الخوادم في الحلقة بحسب حملها التاريخي.
13.4.4. التقسيم حسب المدى
في نهج التقسيم حسب المدى للتجزئة، تحتفظ بعض الآلات في نظامك ببياناتٍ وصفيةٍ تبيّن أيّ الخوادم تحتوي أيّ مدَياتٍ من المفاتيح. ويُستشار لهذه البيانات الوصفية لتوجيه عمليات البحث بالمفتاح والمدى إلى الخوادم المناسبة. وكما في نهج حلقة التجزئة المتّسقة، يقسّم هذا التقسيمُ حسب المدى فضاءَ المفاتيح إلى مدَيات، يدير كلّ مدىٍ منها آلةٌ واحدةٌ مع إمكانية تكراره على غيرها. وعلى خلاف نهج التجزئة المتّسقة، فإنّ مفتاحين متجاورين في ترتيب المفاتيح من المرجّح أن يبدوا في القسم نفسه. وهذا يقلّص حجم بيانات التوجيه الوصفية، إذ تُضغط المدَيات الكبيرة إلى علامتَي [البداية، النهاية].
وبإضافة تسجيلٍ نشِطٍ لربط المدى بالخادم (range-to-server)، يتيح نهجُ التقسيم حسب المدى تحكّمًا أدقّ في تفريغ الحمل (load-shedding) عن الخوادم شديدةِ التحمّل. فإذا رأى مدى مفاتيحٍ معيّن حركةً أعلى من غيره، يمكن لمدير الحمل (load manager) أن يقلّل من حجم النطاق على ذلك الخادم، أو يقلّل عدد الأجزاء (shards) التي يخدمها. وتأتي هذه الحرية الإضافية في الإدارة النشطة للحمل على حساب مكوّناتٍ معماريةٍ إضافيةٍ تراقب الأجزاء وتوجّهها.
الطريقة التي اتّبعها BigTable
تصف ورقة BigTable من Google تقنيةً هرميةً للتقسيم حسب المدى لتجزئة البيانات إلى ألواح (tablets). ويخزّن اللوح مدىً من مفاتيح الصفوف وقيمَها داخل عائلة أعمدة. ويحتفظ بجميع السجلّات وبنى البيانات اللازمة للإجابة عن الاستعلامات الخاصة بالمفاتيح في مداه المُسند إليه. وتخدم خوادمُ الألواح عدّة ألواحٍ بحسب الحمل الذي يتعرّض له كلّ لوح.
يُحتفظ بحجم كلّ لوحٍ في المدى 100-200 ميغابايت. ومع تغيّر أحجام الألواح، يمكن أن يُدمج لوحان صغيران لهما مدَياتٌ متجاورة، أو أن يُقسَّم لوحٌ كبيرٌ إلى اثنين. ويحلّل خادمٌ رئيسي (master) حجمَ اللوح وحمولَه وتوافرَ خوادم الألواح. ويضبط الخادمُ الرئيسي أيّ خادم ألواحٍ يخدم أيّ ألواحٍ في كلّ لحظة.
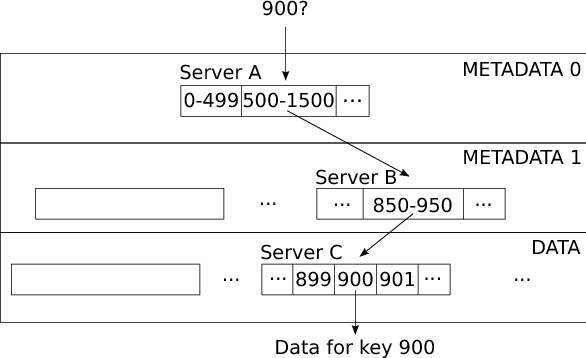
الشكل 13.2: التقسيم حسب المدى المعتمد على BigTable
يحتفظ الخادمُ الرئيسي بإسناد الألواح في جدولٍ للبيانات الوصفية. ولأنّ هذه البيانات الوصفية يمكن أن تكبر، فإنّ جدول البيانات الوصفية نفسه مجزَّعٌ إلى ألواحٍ تربط مدَيات المفاتيح بالألواح وبخوادم الألواح المسؤولة عن تلك المدَيات. ويؤدّي هذا إلى تسلسلٍ هرميٍّ من ثلاث طبقاتٍ يتبعه العميل للعثور على مفتاحٍ على خادم الألواح الذي يستضيفه، كما هو مبيَّن في الشكل 13.2.
ولننظر إلى مثال. عميلٌ يبحث عن المفتاح 900 سيُرسل الاستعلام إلى الخادم A، الذي يخزّن لوح البيانات الوصفية من المستوى 0. ويحدّد هذا اللوحُ لوحَ البيانات الوصفية من المستوى 1 على الخادم 6 الذي يحتوي مدَيات المفاتيح 500-1500. فيرسل العميلُ طلبًا إلى الخادم B بهذا المفتاح، فيردّ بأنّ اللوح الذي يحتوي المفاتيح 850-950 موجودٌ في لوحٍ على الخادم C. وأخيرًا، يرسل العميلُ طلبَ المفتاح إلى الخادم C، فيحصل على بيانات الصفّ لاستعلامه. وقد تكون ألواحُ البيانات الوصفية في المستويين 0 و1 مخزَّنةً في ذاكرة العميل المؤقتة، ما يتجنّب تحميل خوادم ألواحها حمولةً زائدةً بسبب الاستعلامات المتكرّرة. وتشرح ورقة BigTable أنّ هذا التسلسل الهرمي ثلاثي الطبقات يمكنه استيعاب 261 بايتٍ من التخزين باستخدام ألواحٍ حجمها 128 ميغابايت.
معالجة الأعطال
الخادمُ الرئيسي هو نقطةُ فشلٍ وحيدة في تصميم BigTable، لكنّه يمكن أن يتوقّف مؤقتًا دون التأثير في الطلبات الموجَّهة إلى خوادم الألواح. وإذا تعطّل خادمُ ألواحٍ أثناء خدمته لطلبات الألواح، فإنّ الخادمَ الرئيسي هو المسؤول عن التعرّف على ذلك وإعادة إسناد ألواحه، بينما تفشل الطلبات مؤقتًا.
ولكي يتعرّف على أعطال الآلات ويعالجها، تصف ورقة BigTable استخدامَ Chubby، وهو نظامُ أقفالٍ موزّع لإدارة عضوية الخوادم وحيويتها (liveness). وZooKeeper[17] هي الشيفرة المفتوحة المصدر لتنفيذ Chubby، وتستخدمه عدّة مشاريعٍ قائمةٌ على Hadoop لإدارة خوادم الإدارة الثانوية وإعادة إسناد خوادم الألواح.
مشاريع NoSQL المعتمدة على التقسيم حسب المدى
تتبنّى HBase نهج BigTable الهرميَّ في التقسيم حسب المدى. وتُخزَّن بياناتُ الألواح الأساسية في نظام الملفات الموزّع الخاص بـ Hadoop (HDFS). ويتولّى HDFS تكرارَ البيانات واتساقَها بين التكرارات، تاركًا لخوادم الألواح معالجةَ الطلبات وتحديثَ بنى التخزين وبدءَ تقسيم الألواح وضغطها.
وتتعامل MongoDB مع التقسيم حسب المدى بطريقةٍ مشابهة لتلك التي يتبعها BigTable. فتخزّن عقدُ تهيئةٍ عددًا وتُدير جداول التوجيه (routing tables) التي تحدّد أيّ عقدة تخزينٍ مسؤولة عن أيّ مدىٍ من المفاتيح. وتبقى عقدُ التهيئة هذه متزامنةً عبر بروتوكولٍ يُدعى الالتزام ثنائي الطور (two-phase commit)، وتعمل كنموذجٍ هجين بين خادم BigTable الرئيسي (الذي يحدّد المدَيات) وChubby (الذي يدير التهيئة بتوافرية عالية). أمّا عملياتُ التوجيه المنفصلة، وهي عديمةُ الحالة (stateless)، فتتتبّع أحدث تكوينِ توجيهٍ وتوجّه طلبات المفاتيح إلى عقد التخزين المناسبة. أمّا عقدُ التخزين فيُنظَّم في مجموعات تكرارات (replica sets) للتعامل مع التكرار.
وتوفّر Cassandra مُقسِّمًا (partitioner) يحافظ على الترتيب إذا رغبت في السماح بمساحاتٍ سريعةٍ للمدَيات فوق بياناتك. ولا تزال عقدُ Cassandra مرتَّبةً في حلقةٍ باستخدام التجزئة المتّسقة، لكنّه بدلًا من تجزئة زوج المفتاح والقيمة على الحلقة لتحديد الخادم الذي ينبغي إسنادها إليه، يُربط المفتاح ببساطةٍ بالخادم الذي يسيطر على المدى الذي يقع فيه المفتاح طبيعيًّا. فمثلًا، يُربط المفتاحان 20 و21 معًا بالخادم A في حلقتنا المتّسقة للتجزئة في الشكل 13.1، بدلًا من تجزئتهما وتوزيعهما عشوائيًّا في الحلقة.
ويستخدم إطار Gizzard من Twitter، الذي يدير البيانات المقسَّمة والمكرَّرة عبر عدّة واجهاتٍ خلفية، التقسيمَ حسب المدى لتجزئة البيانات. وتشكّل خوادمُ التوجيه تسلسلاتٍ هرميةً من أيّ عمق، تُسند مدَيات المفاتيح إلى الخوادم التي تقع تحتها في التسلسل. وهذه الخوادم إما أن تخزّن بيانات المفاتيح في مداها المُسند، أو توجّه الطلبَ إلى طبقةٍ أخرى من خوادم التوجيه. ويُتحقّق التكرار في هذا النموذج بإرسال التحديثات إلى عدّة آلاتٍ خلف نطاق مفاتيحٍ معيّن. وتدير عقدُ التوجيه في Gizzard عملياتِ الكتابة الفاشلة على نحوٍ مختلفٍ عن أنظمة NoSQL الأخرى. إذ يطلب Gizzard من مصمّمي النظام أن يجعلوا جميع التحديثات آمنةَ التكرار (idempotent)، أي أنّها يمكن تشغيلها مرّتين. وعندما تعطّل عقدةُ تخزين، تُخزّن عقد التوجيه التحديثات وتعيد إرسالها إلى العقدة مرارًا حتى يُؤكَّد التحديث.
13.4.5. أيّ مخطّط تقسيم ينبغي استخدامه
بالنظر إلى نهجَي التقسيم بالتجزئة (hash-based) وبالمدى (range-based)، أيّهما أفضل؟ يعتمد ذلك. فالتقسيمُ حسب المدى هو الخيار الواضح حين تُجري مساحاتٍ للمدَيات على مفاتيح بياناتك كثيرًا. فأنت وأنت تقرأ القيم بترتيب المفتاح، لن تقفز إلى عقدٍ عشوائيةٍ في الشبكة، وهو ما كان سيحمّلك كمونًا شبكيًّا ثقيلًا. لكن إن كنت لا تحتاج إلى مساحاتٍ للمدَيات، فأيّ مخطّط تجزئةٍ ينبغي أن تستعمل؟
ويمنح التقسيمُ بالتجزئة توزيعًا معقولًا للبيانات عبر العقد، ويمكن تقليل الانحراف العشوائيّ عبر العقد الافتراضية. أمّا التوجيه في مخطّط التقسيم بالتجزئة فيبسيط: فغالبًا ما يمكن للعملاء تنفيذ دالة التجزئة بأنفسهم للعثور على الخادم المناسب. ومع مخطّطات إعادة موازنةٍ أعقد، يصبح العثور على العقدة المناسبة لمفتاحٍ أصعب.
ويتطلّب التقسيمُ حسب المدى كلفةً مقدّمةً لصيانة عقد التوجيه وعقد التهيئة، وهي قد تتعرّض لحمولةٍ ثقيلةٍ وتصبح نقاطَ فشلٍ مركزيةً في غياب مخطّطات تحمّل أعطالٍ ذات تعقيدٍ نسبي. لكنّ التنفيذ الجيّد للتقسيم حسب المدى يتيح موازنةَ الحمل للبيانات في دفعاتٍ صغيرةٍ قابلةٍ لإعادة الإسناد في أوقات الحمل العالي. وإذا تعطّل خادم، يمكن توزيعُ مدَياته المُسنَدة على عدّة خوادم، بدلًا من تحميل جيران ذلك الخادم المباشرين أثناء التوقّف.
13.5. الاتساق
بعد أن تحدّثنا عن مزايا تكرار البيانات على عدّة آلاتٍ من أجل الديمومة وتوزيع الحمل، حان الوقت أن نكشف لك سرًّا: الإبقاءُ على نسخ بياناتك على عدّة آلاتٍ متّسقةٍ فيما بينها أمرٌ صعب. في التطبيق العملي، ستتعطّل النسخ وتخرج عن التزامن، وستتعطّل النسخ ولن تعود أبدًا، وستقسّم الشبكة مجموعتين من النسخ، وستتأخّر الرسائل بين الآلات أو تضيع. وهناك نهجان رئيسيان لاتساق البيانات في منظومة NoSQL. الأول هو الاتساق القوي (strong consistency)، حيث تبقى جميع النسخ متزامنة. والثاني هو الاتساق النهائي (eventual consistency)، حيث يُسمح للنسخ بأن تخرج عن التزامن، ثمّ تلحق بعضها ببعض في نهاية المطاف. ولنبدأ أوّلًا في تفسير لماذا يُعدّ الخيارُ الثاني اعتبارًا مناسبًا، بفهم خاصّيةٍ أساسية في الحوسبة الموزّعة. وبعد ذلك سننتقل إلى تفاصيل كلّ نهج.
13.5.1. مقدارٌ عن CAP
لماذا نفكّر في أيّ شيء يقلّ عن ضمانات الاتساق القوي فوق بياناتنا؟ فالسبب كلّه يعود إلى خاصّيةٍ في الأنظمة الموزّعة التي تُصمَّم لمعدّات الشبكات الحديثة. وقد اقترح Eric Brewer هذه الفكرة أوّلًا بوصفها نظرية CAP، ثمّ أثبتها لاحقًا Gilbert وLynch GL02. وتعرض النظريةُ أوّلًا ثلاث خصائصٍ للأنظمة الموزّعة تشكّل الاختصار CAP:
- الاتساق: هل تتّفق جميع نسخ جزءٍ من البيانات منطقيًّا دائمًا على النسخة نفسها من تلك البيانات في اللحظة التي تقرأها فيها؟ (مفهوم الاتساق هذا يختلف عن حرف C في ACID.)
- التوافرية: هل تستجيب النسخُ لطلبات القراءة والكتابة بغضّ النظر عن عدد النسخ التي يتعذّر الوصول إليها؟
- تحمّل التقسيم: هل يستطيع النظام مواصلةَ العمل حتى لو فقدت بعض النسخ مؤقتًا القدرةَ على الاتصال ببعضها عبر الشبكة؟
ثمّ تتابع النظرية تقول إنّ نظام تخزينٍ يعمل على عدّة حواسيب لا يمكنه سوى تحقيق اثنتين من هذه الخصائص على حساب الثالثة. كما أننا نضطرّ إلى تنفيذ أنظمةٍ متحمّلةٍ للتقسيم. وعلى عتاد الشبكات الحالي وبروتوكولات المراسلة الحالية، يمكن أن تُفقد الرزم، وأن تتعطّل المبدّلات، ولا توجد وسيلة لمعرفة ما إذا كانت الشبكة معطّلةً أم أنّ الخادم الذي تحاول إرسال رسالةٍ إليه غير متاح. وينبغي أن تكون جميع أنظمة NoSQL متحمّلةً للتقسيم. ويبقى الاختيار بين الاتساق والتوافرية. ولا يمكن لأيّ نظام NoSQL أن يقدّم الاثنين في الوقت نفسه.
والاختيارُ الاتساق يعني أنّ بياناتك المكرّرة لن تخرج عن التزامن عبر النسخ. وإحدى الطرق السهلة لتحقيق الاتساق هي اشتراط أن تؤكّد جميعُ النسخ عمليات التحديث. فإذا تعطّلت نسخةٌ ولم تتمكّن من تأكيد تحديثات البيانات عليها، فإنّك تُخفّض التوافرية على مفاتيحها. وهذا يعني أنّه إلى أن تتعافى جميع النسخ وتستجيب، لا يستطيع المستخدم الحصول على إقرارٍ ناجحٍ بعملية التحديث التي أجراها. وهكذا فإنّ اختيار الاتساق هو اختيارٌ للتخلّي عن التوافرية على مدار الساعة لكلّ عنصر بيانات.
والاختيارُ التوافرية يعني أنّه حين يصدر المستخدمُ عمليةً، ينبغي أن تعمل النسخُ على البيانات التي لديها، بغضّ النظر عن حالة النسخ الأخرى. وقد يؤدّي ذلك إلى تباعد اتساق البيانات عبر النسخ، إذ لم تكن مطلوبةً لتأكيد جميع التحديثات، وقد لا تكون بعضُ النسخ قد دوّنت جميع التحديثات.
وتفضي نتائجُ نظرية CAP إلى نهجي الاتساق القوي والاتساق النهائي في بناء مخازن بيانات NoSQL. وهناك نهجٌ أخرى، مثل نهج الاتساق المرن (relaxed consistency) والتوافرية المرنة (relaxed availability) المقدَّم في نظام PNUTS CRS+08 من Yahoo!. ولم يتبنَّ أيٌّ من أنظمة NoSQL مفتوحة المصدر التي نتحدّث عنها هذه التقنية حتى الآن، لذا لن نتعمّق فيها أكثر.
13.5.2. الاتساق القوي
تضمن الأنظمةُ التي تعزّز الاتساق القوي أن نسخ عنصر بياناتٍ ما ستتمكّن دائمًا من بلوغ إجماعٍ على قيمة مفتاح. وقد تكون بعضُ النسخ خارج التزامن فيما بينها، لكنّه حين يطلب المستخدمُ قيمة employee30:salary، تملك الآلاتُ طريقةً تتفق باتّساقٍ على القيمة التي يراها المستخدم. وأفضلُ طريقةٍ لشرح كيفية عمل ذلك هي بالأرقام.
لنقل إنّنا نكرّر مفتاحًا على N آلات. وتخدم إحدى الآلات — ربّما إحدى آلات N — دورَ المنسّق (coordinator) لكلّ طلبٍ من المستخدم. ويحرص المنسّق على أنّ عددًا معيّنًا من آلات N يكون قد استقبل كلّ طلبٍ وأكّده. وعندما تقع كتابةٌ أو تحديثٌ على مفتاح، لا يؤكّد المنسّق للمستخدم أنّ الكتابة قد تمّت إلّا عندما تؤكّد W نسخةً منها أنّها استلمت التحديث. وحين يريد المستخدمُ قراءة قيمة مفتاحٍ ما، يستجيب المنسّق حين تستجيب R منها على الأقلّ بالقيمة نفسها. ونقول إنّ النظام يجسّد اتساقًا قويًّا إذا كان R+W>N.
ولنُعطِ هذه الفكرةَ أرقامًا، فلنفترض إنّنا نكرّر كلّ مفتاحٍ على N=3 آلات (نسميها A وB وC). ولنفترض أنّ المفتاح employee30:salary مضبوطٌ أوّلًا على القيمة $20,000، لكننا نريد أن نمنح employee30 زيادةً إلى $30,000. ولنفرض أن يؤكّد ما لا يقلّ عن W=2 من A أو B أو C كلّ طلب كتابةٍ لمفتاح. وحين تؤكّد A وB طلبَ الكتابة الخاص بـ (employee30:salary, $30,000)، يُعلم المنسّق المستخدمَ بأنّ employee30:salary حُدِّث بأمان. ولنفترض أنّ الآلة C لم تستلم قطّ طلبَ الكتابة الخاص بـ employee30:salary، فما زالت تحمل القيمة $20,000. وحين يتلقّى منسّقٌ طلبَ قراءةٍ للمفتاح employee30:salary، فسيُرسل هذا الطلب إلى الآلات الثلاث جميعًا:
- إذا ضبطنا
R=1، وأجابت الآلةCأوّلًا بقيمة $20,000، فلن يكون موظفنا سعيدًا كثيرًا. - لكن إذا ضبطنا
R=2، فسيرى المنسّق القيمةَ منC، ثمّ ينتظر استجابةً ثانيةً منAأوB، وهي تتنازع مع قيمةCالقديمة، ثمّ يتلقّى في النهاية استجابةً من الآلة الثالثة، تؤكّد أنّ $30,000 هي رأيُ الأغلبية.
إذن، ولتحقيق الاتساق القوي في هذه الحالة، نحتاج إلى ضبط R=2} بحيث R+W3}.
وماذا يحدث حين لا تستجيب W نسخةً لطلب كتابة، أو لا تستجيب R نسخةٍ لطلب قراءةٍ باستجابةٍ متّسقة؟ فيمكن للمنسّق أن ينتهي إلى المهلة (timeout) ويرسل للمستخدم خطأً، أو أن ينتظر حتى تزول الحالة من تلقاء نفسها. وعلى أيّ حال، يُعدّ النظام غير متاحٍ لهذا الطلب لمدّةٍ ما على الأقلّ.
ويؤثّر اختيارك لـR وW في عدد الآلات التي يمكن أن تتصرّف على نحوٍ غريبٍ قبل أن يصبح نظامك غير متاحٍ لإجراءاتٍ مختلفة على مفتاح. فإذا أجبرت جميعَ نسخك على تأكيد الكتابات، مثلًا، فإنّ W=N، وتتعلّق عملياتُ الكتابة أو تفشل عند أيّ عطلٍ في نسخة. والاختيارُ الشائع هو R + W = N + 1، وهو الحدّ الأدنى المطلوب للاتساق القوي مع السماح بخلافٍ مؤقّتٍ بين النسخ. وكثيرٌ من أنظمة الاتساق القوي تختار W=N وR=1، إذ لا تضطرّ عندئذٍ إلى مراعاة عُقدٍ تخرج عن التزامن.
وتستند HBase في تخزينها المكرّر إلى HDFS، وهي طبقةُ تخزينٍ موزّعة. ويوفّر HDFS ضمانات اتساقٍ قوي. ففي HDFS لا يمكن أن تنجح الكتابةُ إلّا بعد تكرارها إلى جميع النسخ N (وعادةً 2 أو 3)، ومن ثمّ W = N. وتُلبّى القراءةَ بنسخةٍ واحدة، ومن ثمّ R = 1. ولتجنّب إرهاق أحمال العمل الكثيفة الكتابة، تُنقل البيانات من المستخدم إلى النسخ بصورةٍ غير متزامنةٍ ومتوازية. وبعد أن تؤكّد جميعُ النسخ استلامَها نسخًا من البيانات، تُنفَّذ الخطوةُ الأخيرة من تبديل البيانات الجديدة داخل النظام ذرّيًّا وباتّساقٍ عبر جميع النسخ.
13.5.3. الاتساق النهائي
تتيح الأنظمةُ المعتمدة على Dynamo، ومنها Voldemort وCassandra وRiak، للمستخدم تحديد N وR وW حسب حاجته، حتى لو كان R + W <= N. وهذا يعني أنّ المستخدم يستطيع تحقيق الاتساق القوي أو الاتساق النهائي. وحين يختار المستخدمُ الاتساق النهائي، وحتى حين يختار المبرمجُ الاتساق القوي لكنّ W أقلّ من N، تمرّ فتراتٌ قد لا تتفق فيها النسخ. ولتوفير الاتساق النهائي بين النسخ، تستعين هذه الأنظمةُ بأدواتَ متنوّعةٍ لإدراك النسخ المتخلّفة حتى تلحق بالركب. لنبدأ أوّلًا بكيفية تحديد هذه الأنظمة أنّ البياناتَ قد خرجت عن التزامن، ثمّ نناقش كيف تزامن النسخُ بينها، وأخيرًا نقدّم بضع طرائق مستوحاةٍ من Dynamo لتسريع عمليّة المزامنة.
إصدارات القيم والتعارضات
ولأنّ نسختين قد ترى نسختين مختلفتين من قيمة مفتاحٍ ما، فإنّ إدارة إصدارات البيانات (data versioning) وكشفَ التعارضات أمران مهمّان. وتستخدم الأنظمةُ المعتمدة على Dynamo نوعًا من الإصدارات يُدعى الساعات المتجهية (vector clocks). والساعةُ المتجهية متّجهٌ يُسند إلى كلّ مفتاحٍ ويحتوي عدّادًا لكلّ نسخة. فمثلًا، إذا كانت الخوادمُ A وB وC هي النسخَ الثلاث لمفتاحٍ ما، فإنّ الساعةَ المتجهية ستحتوي ثلاثةَ مداخل، وهي (N_A, N_B, N_C)، تُهيَّأ إلى (0,0,0).
وفي كلّ مرّةٍ تعدّل فيها نسخةٌ مفتاحًا، فإنّها يزيد عدّادها في المتّجه. فإذا عدّلت B مفتاحًا كانت نسختُه السابقة (39, 1, 5)، فإنّها ستغيّر الساعةَ المتجهية إلى (39, 2, 5). وحين تتلقّى نسخةٌ أخرى، ولنفترض C، تحديثًا من B عن بيانات ذلك المفتاح، فستقارن الساعةَ المتجهية القادمة من B بساعتها هي. ما دامت عدّاداتُ ساعتها المتجهية كلها أقلّ من العدّادات الواردة من B، فإنّ نسختَها قديمةٌ ويمكنها أن تستبدل نسختَها الخاصة بنسخة B. أمّا إذا كانت لساعتَي B وC عدّاداتٌ بعضها أكبرُ من بعضهما في الساعةين، مثل (39, 2, 5) و(39, 1, 6)، فإنّ الخوادمَ تتعرّف على أنّها استلمت تحديثاتٍ مختلفة، يحتمل ألّا يكون في إمكانها التوفيق بينها، وتُحدّد تعارضًا.
حلّ التعارضات
يختلف حلّ التعارضات عبر الأنظمة المختلفة. فتترك ورقةُ Dynamo حلَّ التعارضات إلى التطبيق الذي يستخدم نظام التخزين. فإصداران من عربة تسوّقٍ يمكن دمجهما في إصدارٍ واحدٍ دون فقدٍ كبيرٍ للبيانات، لكنّ إصدارين من مستندٍ يُحرَّر بالتعاون قد يحتاجان إلى مُراجعٍ بشريٍّ لحلّ التعارض. ويتبع Voldemort هذا النموذج، فيُعيد عدّةَ نسخٍ من المفتاح إلى تطبيق العميل الطالب عند حدوث تعارض.
وتستخدم Cassandra، التي تخزّن طابعًا زمنيًّا على كلّ مفتاح، أحدثَ إصدارٍ مؤرَّخٍ من المفتاح حين يقع إصداران في تعارض. وهذا يُغني عن رحلةٍ ذهابًا وإيابًا إلى العميل ويُبسّط الواجهة البرمجية. ويجعل هذا التصميمُ من الصعب التعاملَ مع الحالات التي يمكن فيها دمجُّ البيانات المتعارضة بذكاء، كما في مثال عربة التسوّق لدينا، أو عند تنفيذ عدّاداتٍ موزّعة. ويسمح Riak بكلا النهجين اللذين يقدّمهما Voldemort وCassandra. أمّا CouchDB فيوفّر نهجًا هجينًا: فهو يحدّد التعارضَ ويسمح للمستخدم بالاستعلام عن المفاتيح المتعارضة لإصلاحها يدويًا، لكنّه يختار إصدارًا حتميًّا لإعادته إلى المستخدمين إلى أن تُصلَح التعارضات.
إصلاح القراءة (Read Repair)
إذا أعادت R نسخةَ بياناتٍ غير متعارضةٍ إلى منسّق، فيمكن للمنسّق أن يعيد البيانات غير المتعارضة بأمانٍ إلى التطبيق. وقد يلاحظ المنسّق مع ذلك أنّ بعضَ النسخ خارج التزامن. وتقترح ورقةُ Dynamo تقنيةً تُدعى إصلاح القراءة (read repair) للتعامل مع هذه الحالات، وتنفّذها Cassandra وRiak وVoldemort. فحين يحدّد المنسّق تعارضًا أثناء القراءة، حتى لو كانت قيمةٌ متّسقةٌ قد أُعيدت إلى المستخدم، يبدأ المنسّقُ بروتوكولاتِ حلّ التعارض بين النسخ المتعارضة. وهذا يُصلح التعارضات بشكلٍ استباقيٍّ بكلفةٍ إضافيةٍ ضئيلة. فقد أرسلت النسخُ نسخَها من البيانات إلى المنسّق سلفًا، ويؤدّي حلُّ التعارضات الأسرع إلى تباعدٍ أقلّ في النظام.
التسليم بالإرشاد (Hinted Handoff)
تستعمل كلٌّ من Cassandra وRiak وVoldemort تقنيةً تُدعى التسليم بالإرشاد (hinted handoff) لتحسين أداء الكتابة في الحالات التي تصبح فيها عقدةٌ ما غير متاحةٍ مؤقتًا. فإذا لم تستجب إحدى نسخ مفتاحٍ ما لطلب كتابة، فتُنتقَر عقدةٌ أخرى لتتولّى مؤقتًا حملَ الكتابة الخاصّ بها. وتُحفظ كتاباتُ العقدة غير المتاحة على نحوٍ منفصل، وحين تلاحظ عقدةُ النسخ الاحتياطية عودةَ العقدة غير المتاحة، فإنّها تمرّر جميع الكتابات إلى النسخة التي صار متاحةً حديثًا. وتستخدم ورقةُ Dynamo نهج «النصاب المتساهل» (sloppy quorum)، وتسمح بأن تُحتسب الكتاباتُ المنفَّذة عبر التسليم بالإرشاد ضمن إقرارات الكتابة المطلوبة التي عددها W. أمّا Cassandra وVoldemort فلا تحسبان التسليمَ بالإرشاد ضمن W، وتفشلان أيّ كتابةٍ لا تحظى بتأكيداتٍ بعدد W من النسخ المُسنَدة إليها أصلًا. ولا يزال التسليم بالإرشاد مفيدًا في هذه الأنظمة، إذ يسرّع تعافيَ العقدة حين تعود.
مضادّ الانتروبيا (Anti-Entropy)
حين تبقى نسخةٌ معطّلةً لمدّةٍ طويلة، أو حين تتعطّل الآلةُ التي تحفظ عمليات التسليم بالإرشاد الخاصة بنسخةٍ غير متاحة أيضًا، لا بدّ للنسخ أن تزامن بعضها ببعض. وفي هذه الحالة، تنفّذ Cassandra وRiak عمليةً مستوحاةٍ من Dynamo تُدعى مضادّ الانتروبيا (anti-entropy). وفي مضادّ الانتروبيا، تتبادل النسخُ أشجارَ Merkle (Merkle Trees) لتحديد أجزاءٍ من مدَيات مفاتيحها المكرّرة التي خرجت عن التزامن. وشجرةُ Merkle هي تحقّقٌ تجزئيٌّ هرمي: فإذا لم تكن التجزئةُ فوق فضاء المفاتيح بأكمله متطابقةً بين نسختين، فإنّهما تتبادلان تجزئات أجزاءٍ أصغر فأصغر من فضاء المفاتيح المكرّر حتى تُحدَّد المفاتيحُ الخارجة عن التزامن. ويقلّل هذا النهجُ من نقل البيانات غير الضروريّ بين النسخ التي تحتوي بياناتٍ متشابهةً في معظمها.
الإشاعة (Gossip)
وأخيرًا، مع اتّساع الأنظمة الموزّعة، يصعب تتبّع حالة كلّ عقدةٍ في النظام. وتستعمل الأنظمةُ الثلاثة المعتمدة على Dynamo تقنيةً قديمةً من تقاليد المدارس الثانوية تُعرف بـالإشاعة (gossip) لتتبّع العقد الأخرى. فدوريًا (كلّ ثانيةٍ أو نحوها)، تختار عقدةٌ ما عقدةً عشوائيةً سبق أن تواصلت معها لتتبادل معارفَ عن حالة العقد الأخرى في النظام. ومن خلال هذا التبادل، تتعلّم العقدُ أيّ العقد الأخرى معطّلة، وتعرف إلى أين توجّه العملاء طلبًا للبحث عن مفتاح.
13.6. كلمة أخيرة
لا تزال منظومة NoSQL في بداياتها، وكثيرٌ من الأنظمة التي ناقشناها ستغيّر معماريّاتها وتصاميمها وواجهاتها. والمهمّ في هذا الفصل ليس ما تفعله كلُّ أنظمة NoSQL حاليًّا، بل قراراتُ التصميم التي أدّت إلى مجموعةٍ من المزايا تشكّل هذه الأنظمة. وتترك NoSQL قدرًا كبيرًا من عمل التصميم في عهدة مصمّم التطبيق. وفهمُ المكوّنات المعمارية لهذه الأنظمة لن يساعدك فحسب على بناء التجميع NoSQL الكبير التالي، بل سيمكّنك كذلك من استخدام الإصدارات الحالية بمسؤولية.
13.7. شكر وتقدير
أنا ممتنٌ لـJackie Carter وMihir Kedia وللمراجعين المجهولين على تعليقاتهم واقتراحاتهم لتحسين الفصل. ولن يكن هذا الفصل ممكنًا أيضًا لولا سنواتٍ من العمل المتفرّس الذي أدّاه مجتمع NoSQL. وواصلوا البناء!
الحواشي
http://hbase.apache.org/http://project-voldemort.com/http://cassandra.apache.org/http://code.google.com/p/protobuf/http://thrift.apache.org/http://avro.apache.org/http://www.oracle.com/technetwork/database/berkeleydb/overview/index.htmlhttp://redis.io/http://couchdb.apache.org/http://www.mongodb.org/http://www.basho.com/products_riak_overview.phphttp://www.hypergraphdb.org/indexhttp://neo4j.org/http://memcached.org/http://hadoop.apache.org/hdfs/http://github.com/twitter/gizzardhttp://hadoop.apache.org/zookeeper/
http://hbase.apache.org/↩︎http://project-voldemort.com/↩︎http://cassandra.apache.org/↩︎http://code.google.com/p/protobuf/↩︎http://thrift.apache.org/↩︎http://avro.apache.org/↩︎http://www.oracle.com/technetwork/database/berkeleydb/overview/index.html↩︎http://redis.io/↩︎http://couchdb.apache.org/↩︎http://www.mongodb.org/↩︎http://www.basho.com/products_riak_overview.php↩︎http://www.hypergraphdb.org/index↩︎http://neo4j.org/↩︎http://memcached.org/↩︎http://hadoop.apache.org/hdfs/↩︎http://github.com/twitter/gizzard↩︎http://hadoop.apache.org/zookeeper/↩︎