LLVM
معمارية تطبيقات المصادر المفتوحة (المجلد الأول)LLVM
معمارية تطبيقات المصادر المفتوحة (المجلد الأول) LLVM
Chris Lattner
إذا استمتعت بهذه الكتب، فقد يعجبك أيضًا التصميم البرمجي بالأمثلة في Python والتصميم البرمجي بالأمثلة في JavaScript.
يتناول هذا الفصل بعض قرارات التصميم التي شكّلت LLVM[1]، وهو مشروع ممبِّر (umbrella project) يستضيف ويطوّر مجموعة متلاحمة من مكوّنات سلسلة أدوات منخفضة المستوى (مثل المجمِّعات، والمترجَمات، ومنقِّحات الأخطاء، إلخ)، وهي مصمَّمة لتتوافق مع الأدوات القائمة المستخدَمة عادةً في أنظمة Unix. كان اسم "LLVM" في الأصل اختصارًا (acronym)، لكنه لم يعد سوى علامة تجارية للمشروع المبِّر. ورغم أنّ LLVM يوفّر بعض القدرات الفريدة، وأنه معروف ببعض أدواته الرائعة (مثل مترجَم Clang[2]، وهو مترجَم للغة C/C++/Objective-C يقدّم عددًا من المزايا على مترجَم GCC)، فإنّ أهمّ ما يميّز LLVM عن المترجَمات الأخرى هو بنيته الداخلية.
منذ بدايته في ديسمبر من عام 2000، صُمِّم LLVM بوصفه مجموعة من المكتبات القابلة لإعادة الاستخدام ذات واجهات محدَّدة المعالم LA04. وفي ذلك الوقت، كانت تطبيقات لغات البرمجة مفتوحة المصدر تُصمَّم بوصفها أدوات ذات غرض خاص، وكانت تملك عادةً ملفات تنفيذية أحادية الكتلة. فمثلًا، كان من الصعب جدًّا إعادة استخدام المحلِّل اللغوي (parser) الخاص بمترجَم ساكن (static compiler) مثل GCC لإجراء تحليل ساكن (static analysis) أو إعادة هيكلة (refactoring). وحرصت لغات السكربت غالبًا على توفير وسيلة لتضمين وقت تشغيلها (runtime) ومفسِّرها (interpreter) داخل تطبيقات أكبر، غير أنّ هذا الوقت التشغيلي كان كتلة شيفرة واحدة متجانسة تُدرَج أو تُستبعَد بالكامل. ولم تكن هناك أي وسيلة لإعادة استخدام أجزاء منه، كما كان التقاسم بين مشاريع تطبيقات اللغات ضئيلًا إلى حدٍّ بعيد.
وإلى جانب تركيب المترجَم نفسه، كانت المجتمعات المحيطة بتطبيقات اللغات الشائعة متباينة إلى حدٍّ كبير: فالتطبيق المعيّن كان يقدّم إمّا مترجَمًا ساكنًا تقليديًا مثل GCC وFree Pascal وFreeBASIC، وإمّا مترجَمًا وقت التشغيل على هيئة مفسِّر (interpreter) أو مترجَم في وقت التشغيل (Just-In-Time، أو JIT). وكان من النادر جدًّا أن ترى تطبيق لغة يدعم الاثنين معًا، وحينما كانا كذلك، فكان التقاسم في الشيفرة عادةً ضئيلًا إلى حدٍّ كبير.
وخلال السنوات العشر الماضية، غيّر LLVM هذا المشهد بصورة جوهرية. إذ يُستخدم LLVM الآن بوصفه بنية تحتية مشتركة لتنفيذ مجموعة واسعة من اللغات المجمَّعة ساكنًا والمجمَّعة وقت التشغيل (مثل عائلة اللغات التي يدعمها GCC، وJava، و.NET، وPython، وRuby، وScheme، وHaskell، وD، فضلًا عن أعداد لا تُحصى من اللغات الأقلّ شهرة). كما حلّ محلّ مجموعة واسعة من المترجَمات ذات الغرض الخاص، مثل محرك التخصيص وقت التشغيل في منظومة OpenGL من Apple، ومكتبة معالجة الصور في منتج After Effects من Adobe. وأخيرًا، استُخدم LLVM أيضًا لإنشاء مجموعة واسعة من المنتجات الجديدة، ولعلّ أشهرها لغة البرمجة وبيئة تشغيل المعالجات الرسوميات OpenCL.
11.1. مقدّمة سريعة إلى التصميم الكلاسيكي للمترجَمات
التصميم الأكثر شيوعًا للمترجَم الساكن التقليدي (مثل معظم مترجَمات C) هو تصميم المراحل الثلاث، ومكوّناته الرئيسة هي الواجهة الأمامية (front end) والمُحسِّن (optimizer) والواجهة الخلفية (back end) (الشكل 11.1). تتحلّل الواجهة الأمامية الشيفرة المصدرية، وتتحقّق من وجود أخطاء فيها، وتبني شجرة تجريد (Abstract Syntax Tree، أو AST) خاصة باللغة لتمثيل الشيفرة المُدخَلة. ثم يُحوَّل الـ AST اختياريًا إلى تمثيل جديد لأغراض التحسين، وتُنفَّذ المُحسِّن والواجهة الخلفية على الشيفرة.
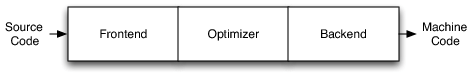
الشكل 11.1: المكوّنات الثلاثة الرئيسة لمترجَم من ثلاث مراحل
المسؤولية عن المُحسِّن هي إجراء مجموعة واسعة من التحويلات التي تهدف إلى تحسين زمن تنفيذ الشيفرة، مثل إلغاء الحسابات المكرَّرة، وهو مستقل عن اللغة والهدف إلى حدٍّ كبير. ثم تربط الواجهة الخلفية (المعروفة أيضًا باسم مولِّد الشيفرة، code generator) الشيفرة بمجموعة تعليمات الهدف. وإلى جانب إنتاج شيفرة صحيحة، فهي مسؤولة عن توليد شيفرة جيّدة تستفيد من السمات غير المعتادة للمعمارية المدعومة. ومن الأجزاء الشائعة في الواجهة الخلفية للمترجَم: اختيار التعليمات (instruction selection)، وتخصيص السجلات (register allocation)، وجدولة التعليمات (instruction scheduling).
وينطبق هذا النموذج على المفسِّرات ومترجَمات JIT على قدم المساواة. كما أنّ آلة Java الافتراضية (Java Virtual Machine، أو JVM) هي أيضًا تطبيق لهذا النموذج، وهي تستخدم شيفرة بايت جافا (Java bytecode) كواجهة بين الواجهة الأمامية والمُحسِّن.
11.1.1. نتائج هذا التصميم
أهمّ مكسب لهذا التصميم الكلاسيكي يتحقّق حين يقرّر مترجَم دعم عدّة لغات مصدرية أو معماريات هدف. فإذا استخدم المترجَم تمثيلًا مشتركًا للشيفرة في مُحسِّنه، أمكن حينئذٍ كتابة واجهة أمامية لأي لغة يمكن أن تُترجَم إليه، وكتابة واجهة خلفية لأي هدف يمكن أن يُترجَم منه، كما يبيّن الشكل 11.2.
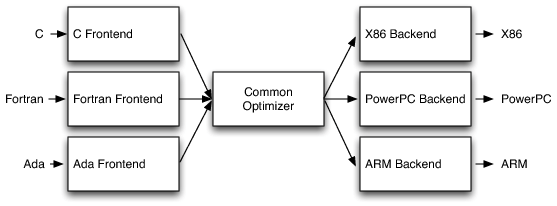
الشكل 11.2: إمكانية إعادة التوجيه إلى أهداف مختلفة
وبهذا التصميم، فإنّ نقل المترجَم لدعم لغة مصدرية جديدة (مثل Algol أو BASIC) يتطلّب تنفيذ واجهة أمامية جديدة، بينما يمكن إعادة استخدام المُحسِّن والواجهة الخلفية القائمين. ولو لم تكن هذه الأجزاء مفصولة، لكان تنفيذ لغة مصدرية جديدة يستلزم البدء من الصفر، فدعم N هدفًا وM لغة مصدرية سيحتاج إلى N*M مترجَمًا.
ومن مزايا تصميم المراحل الثلاث الأخرى (الناتجة مباشرةً عن إمكانية إعادة التوجيه) أنّ المترجَم يخدم مجموعة أوسع من المبرمجين ممّا لو كان يدعم لغة مصدرية واحدة وهدفًا واحدًا فقط. أمّا بالنسبة إلى مشروع مفتوح المصدر، فيعني ذلك وجود مجتمع أكبر من المساهمين المحتملين يمكن الاستعانة بهم، ما يؤدّي بطبيعة الحال إلى مزيد من الإضافات والتحسينات على المترجَم. ولهذا السبب تميل المترجَمات مفتوحة المصدر التي تخدم مجتمعات كثيرة (مثل GCC) إلى توليد شيفرة آليّة محسَّنة بشكل أفضل من المترجَمات أكثر تخصُّصًا مثل FreePASCAL. أمّا المترجَمات المملوكة فلا ينطبق عليها ذلك، إذ ترتبط جودتها مباشرةً بميزانية المشروع. فمثلًا، يُعرف مترجَم Intel ICC على نطاق واسع بجودة الشيفرة التي يولّدها، رغم أنّه يخدم جماهير ضيّقة.
أمّا المكسب الرئيس الأخير لتصميم المراحل الثلاث، فهو أنّ المهارات المطلوبة لتنفيذ واجهة أمامية تختلف عن تلك المطلوبة للمُحسِّن والواجهة الخلفية. وفصل هذه الأجزاء يجعل من الأسهل على «شخص متخصّص في الواجهة الأمامية» (front-end person) أن يُطوّر حصّته من المترجَم ويصونها. وهذه مسألة اجتماعية لا تقنية، لكنّها مهمّة إلى حدٍّ بعيد في الممارسة العملية، ولا سيّما في المشاريع مفتوحة المصدر التي ترغب في أقصى قدر ممكن من تقليص عتبة المساهمة.
11.2. تطبيقات اللغات القائمة
رغم أنّ مزايا تصميم المراحل الثلاث مقنعة وموثَّقة جيّدًا في مراجع المترجَمات، فإنّه نادرًا ما يتحقّق بالكامل في الممارسة العملية. فإذا نظرت في تطبيقات اللغات مفتوحة المصدر (عند بدء مشروع LLVM)، لكنت ستجد أنّ تطبيقات Perl وPython وRuby وJava لا تتشارك أي شيفرة. فضلًا عن ذلك، فإنّ مشاريع مثل Glasgow Haskell Compiler (GHC) وFreeBASIC قابلة لإعادة التوجيه إلى معالجات مركزية (CPU) مختلفة عدّة، غير أنّ تطبيقاتها شديدة التخصّص في اللغة المصدرية الوحيدة التي تدعمها. كما أنّ هناك مجموعة واسعة من تقنيات المترجَمات ذات الغرض الخاص منتشرة لتنفيذ مترجَمات JIT لمعالجة الصور، والتعبيرات النمطية (regular expressions)، وبراءات بطاقات الرسوميات، والمجالات الفرعية الأخرى التي تتطلّب عملًا مكثّفًا على المعالج المركزي.
ومع ذلك، هناك ثلاث قصص نجاح رئيسية لهذا النموذج، أولىها الآلتان الافتراضيتان لـ Java و.NET. توفّر هذه الأنظمة مترجَم JIT، ودعمًا وقت التشغيل، وتنسيق بايت مُحكَم التعريف إلى حدٍّ كبير. وهذا يعني أنّ أي لغة يمكن أن تُترجَم إلى تنسيق البايت (وهناك العشرات منها[3]) تستطيع الاستفادة من الجهد المبذول في المُحسِّن وفي JIT وكذلك في وقت التشغيل. أمّا المقابل فهو أنّ هذه التطبيقات توفّر مرونة ضئيلة في اختيار بيئة التشغيل: فكلاهما يفرض فعليًا التجميع وقت التشغيل (JIT)، وجمع القمامة (garbage collection)، واستخدام نموذج كائنات بعينه إلى حدٍّ كبير. ويؤدي ذلك إلى أداء دون الأمثل عند ترجمة اللغات التي لا تطابق هذا النموذج عن قرب، مثل C (مثلًا مع مشروع LLJVM).
وأمّا قصة النجاح الثانية، فهي على الأرجح أسوأ الحظّ، لكنّها أيضًا أكثر طرائق إعادة استخدام تقنيات المترجَمات شيوعًا: ترجمة الشيفرة المُدخَلة إلى شيفرة C (أو لغة أخرى) وتمريرها عبر مترجَمات C القائمة. يتيح ذلك إعادة استخدام المُحسِّن ومولِّد الشيفرة، ويمنح مرونة جيدة وتحكّمًا في بيئة التشغيل، وهو سهل جدًّا على منفّذي الواجهات الأمامية من حيث الفهم والتنفيذ والصيانة. لكنّ الشيء، لسوء الحظّ، يمنع التنفيذ الكفؤ لمعالجة الاستثناءات (exception handling)، ويوفّر تجربة تنقيح سيّئة، ويُبطِّئ الترجمة، وقد يشكّل مشكلة في اللغات التي تتطلّب استدعاءات ذيل مضمونة (tail calls) أو سمات أخرى لا تدعمها C.
أمّا التطبيق الناجح الأخير لهذا النموذج فهو GCC[4]. يدعم GCC واجهات أمامية وخلفية كثيرة، ولديه مجتمع نشط وواسع من المساهمين. ولـ GCC تاريخ طويل بوصفه مترجَمًا للغة C يدعم أهدافًا متعدّدة، مع دعم متسرِّب (hacky) لعدد قليل من اللغات الأخرى مضافًا إليه. ومع مرور السنين، يتطوّر مجتمع GCC ببطء نحو تصميم أنظف. واعتبارًا من GCC 4.4، فله تمثيل جديد للمُحسِّن (يعرف باسم "GIMPLE Tuples") يكون أقرب إلى الانفصال عن تمثيل الواجهة الأمامية ممّا كان عليه في السابق. كما أنّ واجهتيه الأماميتين للغة Fortran وAda تستخدمان AST نظيفًا.
ورغم نجاحها الشديد، تخضع هذه المقاربات الثلاث لحدود صارمة فيما يمكن استخدامها لأجله، لأنها مصمَّمة بوصفها تطبيقات أحادية الكتلة. فعلى سبيل المثال، من غير الواقعية تضمين GCC داخل تطبيقات أخرى، أو استخدامه مترجَمًا وقت التشغيل/JIT، أو استخراج أجزاء منه وإعادة استخدامها من غير جلب معظم المترجَم. ومن أرادوا استخدام واجهة GCC الأمامية للغة C++ في توليد التوثيق، وفهرسة الشيفرة، وإعادة الهيكلة، وأدوات التحليل الساكن، اضطُرّوا إلى استعمال GCC بوصفه تطبيقًا أحادي الكتلة يُخرج معلومات مهمّة بصيغة XML، أو إلى كتابة إضافات (plugins) تحقن شيفرة غريبة في عملية GCC.
وهناك أسباب متعدّدة تمنع إعادة استخدام أجزاء GCC بوصفها مكتبات، منها الاستخدام الغزير للمتغيّرات العامّة، والثوابت (invariants) ضعيفة الإلزام، وبنى البيانات سيّئة التصميم، وقاعدة شيفرة شديدة الاتّساع، واستخدام توجيهات (macros) تمنع تصريف قاعدة الشيفرة بما يخدم أكثر من زوج واجهة أمامية/هدف واحد في الوقت نفسه. لكنّ أصعب المشكلات قابلةً للإصلاح هي مشكلات البنية المعمارية الجوهرية الناقمة عن تصميمه المبكّر وعمره الطويل. وتحديدًا، يعاني GCC من مشكلات في الطبقات (layering) وتسرّب التجريدات (leaky abstractions): فالواجهة الخلفية تجوب أشجار التجريد (AST) الخاصة بالواجهة الأمامية لتوليد معلومات التنقيح، وتولّد الواجهات الأمامية بنى بيانات الخاصة بالواجهة الخلفية، ويعتمد المترجَم بأكمله على بنى بيانات عامّة تُنشئها واجهة سطر الأوامر.
11.3. تمثيل الشيفرة في LLVM: التمثيل الوسيط (LLVM IR)
بعد أن أفردنا الخلفية التاريخية والسياق، فلنتعمّق في LLVM: أهمّ جانب في تصميمه هو التمثيل الوسيط لـ LLVM (LLVM Intermediate Representation، أو IR)، وهو الشكل الذي يستخدمه لتمثيل الشيفرة داخل المترجَم. صُمِّم LLVM IR لاستيعاب التحليلات والتحويلات متوسطة المستوى الموجودة في قسم المُحسِّن من المترجَم. وقد صُمِّم بعناية لتحقيق أهداف محدّدة كثيرة، منها دعم تحسينات وقت التشغيل الخفيفة، والتحسينات عبر الدوال/بين الإجراءات (interprocedural)، وتحليل البرنامج كاملًا (whole program analysis)، وتحويلات إعادة هيكلة جريئة، وغيرها. لكنّ أهمّ ما فيه هو أنّه معرَّف بذاته بوصفه لغة من الدرجة الأولى ذات دلالات محدَّدة المعالم. ولجعل ذلك ملموسًا، إليك مثالًا بسيطًا لملف .ll:
define i32 @add1(i32 %a, i32 %b) {
entry:
  %tmp1 = add i32 %a, %b
  ret i32 %tmp1
}

define i32 @add2(i32 %a, i32 %b) {
entry:
  %tmp1 = icmp eq i32 %a, 0
  br i1 %tmp1, label %done, label %recurse

recurse:
  %tmp2 = sub i32 %a, 1
  %tmp3 = add i32 %b, 1
  %tmp4 = call i32 @add2(i32 %tmp2, i32 %tmp3)
  ret i32 %tmp4

done:
  ret i32 %b
}
يقابل التمثيل الوسيط لـ LLVM الشيفرة C التالية، التي توفّر طريقتين مختلفتين لجمع الأعداد الصحيحة:
unsigned add1(unsigned a, unsigned b) {
  return a+b;
}

// Perhaps not the most efficient way to add two numbers.
unsigned add2(unsigned a, unsigned b) {
  if (a == 0) return b;
  return add2(a-1, b+1);
}
وكما ترى من هذا المثال، فإنّ التمثيل الوسيط لـ LLVM هو مجموعة تعليمات افتراضية منخفضة المستوى شبيهة بـ RISC. ومثل مجموعة تعليمات RISC الحقيقيّة، يدعم تسلسلات خطّية من تعليمات بسيطة مثل الجمع والطرح والمقارنة والتفريع (branch). وهذه التعليمات بصيغة العناوين الثلاثة (three address form)، أي أنّها تأخذ عددًا من المدخلات وتُنتج نتيجة في سجل مختلف.[5] يدعم التمثيل الوسيط لـ LLVM التسميات (labels)، ويبدو عمومًا بوصفه شكلًا غريبًا من لغة التجميع.
وبخلاف معظم مجموعات تعليمات RISC، فإنّ LLVM مُصنَّف الأنواع بشدّة (strongly typed) بنظام أنواع بسيط (مثل: i32 عدد صحيح بطول 32 بت، وi32** مؤشّر إلى مؤشّر إلى عدد صحيح بطول 32 بت)، كما تُجرَّد بعض تفاصيل الآلة. فمثلًا، تُجرَّد اصطلاحية الاستدعاء (calling convention) عبر تعليمتَي call وret ووسائط صريحة. أمّا الاختلاف الجوهري الآخر عن شيفرة الآلة فهو أنّ التمثيل الوسيط لـ LLVM لا يستخدم مجموعة ثابتة من السجلات المسمّاة، بل يستخدم مجموعة لا نهائية من القيم المؤقتة (temporaries) تُسمّى بمحرف %.
وإلى جانب كونه منفَّذًا بوصفه لغة، فإنّ التمثيل الوسيط لـ LLVM معرَّف فعليًا بثلاثة أشكال متجانسة (isomorphic): التنسيق النصّي أعلاه، وبنية بيانات داخل الذاكرة تفحصها تحسينات نفسها وتعدّلها، وتنسيق «بتكود» (bitcode) ثنائي فعّال وكثيف يُخزَّن على القرص. كما يوفّر مشروع LLVM أدوات لتحويل تنسيق القرص من النص إلى الشكل الثنائي: فـ llvm-as يجمّع ملف .ll النصّي في ملف .bc يحوي مادة البتكود، وllvm-dis يحوّل ملف .bc إلى ملف .ll.
والتمثيل الوسيط في المترجَم مثير للاهتمام لأنّه قد يكون «عالَمًا مثاليًا» لمُحسِّن المترجَم: فبخلاف الواجهة الأمامية والواجهة الخلفية للمترجَم، لا يقيّده المُحسِّن لا لغة مصدرية بعينها ولا آلة هدف بعينها. ومن الجهة الأخرى، عليه أن يخدم كليهما على خير وجه: يجب أن يُصمَّم ليكون سهل التوليد بالنسبة إلى الواجهة الأمامية، وأن يكون تعبيريًا بما يكفي للسماح بتنفيذ تحسينات مهمّة على الأهداف الحقيقيّة.
11.3.1. كتابة تحسين في التمثيل الوسيط لـ LLVM
ولإعطاء فكرة عن كيفية عمل التحسينات، من المفيد استعراض بعض الأمثلة. فهناك أنواع كثيرة جدًّا ومتنوّعة من تحسينات المترجَمات، لذا يصعب تقديم وصفة جاهزة لحل أي مسألة. ومع ذلك، تتبع معظم التحسينات بنية بسيطة من ثلاثة أجزاء:
- ابحث عن نمط قابل للتحويل.
- تحقّق من أنّ التحويل آمن/صحيح في الحالة المُطابِقة.
- نفّذ التحويل مع تحديث الشيفرة.
أمّا أبسط التحسينات فهو المطابقة على الأنماط في المتطابقات الحسابية (identities)، مثل: لأي عدد صحيح X، فإنّ X-X يساوي 0، وX-0 يساوي X، و(X*2)-X يساوي X. والسؤال الأول هو كيف تبدو هذه في التمثيل الوسيط لـ LLVM. وإليك بعض الأمثلة:
⋮    ⋮    ⋮
%example1 = sub i32 %a, %a
⋮    ⋮    ⋮
%example2 = sub i32 %b, 0
⋮    ⋮    ⋮
%tmp = mul i32 %c, 2
%example3 = sub i32 %tmp, %c
⋮    ⋮    ⋮
ولأنواع تحويلات «peephole» (نظرة الكوة) هذه، يوفّر LLVM واجهةً لتبسيط التعليمات تُستخدم كأدوات مساعدة من قِبل تحويلات أخرى أعلى مستوى. وتقع هذه التحويلات بعينها في الدالة SimplifySubInst وتبدو هكذا:
// X - 0 -> X
if (match(Op1, m_Zero()))
return Op0;
// X - X -> 0
if (Op0 == Op1)
return Constant::getNullValue(Op0->getType());
// (X*2) - X -> X
if (match(Op0, m_Mul(m_Specific(Op1), m_ConstantInt<2>())))
return Op1;
…
return 0; // Nothing matched, return null to indicate no transformation.
في هذه الشيفرة، يرتبط Op0 وOp1 بالمعاملين الأيسر والأيمن لتعليمية طرح أعداد صحيحة (ولنلفت الانتباه إلى أنّ هذه المتطابقات لا تنطبق بالضرورة على الأعداد العشرية العائمة وفق معيار IEEE!). LLVM منفَّذ بلغة C++، وهي ليست معروفة بقدرتها على المطابقة على الأنماط (مقارنةً باللغات الوظيفية مثل Objective Caml)، لكنها توفّر نظام قوالب عامًّا جدًّا يتيح لنا تنفيذ شيء مماثل. وتتيح لنا الدالة match والدوالّ التي تبدأ بـ m_ تنفيذ عمليات مطابقة تعريفيّة على الأنماط لشيفرة التمثيل الوسيط لـ LLVM. فمثلًا، لا تنطبق المسند (predicate) m_Specific إلّا إذا كان الطرف الأيسر من عملية الضرب هو نفسه Op1.
وتُطابَق هذه الحالات الثلاث جميعها على الأنماط، وتعيد الدالة البديلَ إن أمكن، أو مؤشّرًا فارغًا (null) إن لم يكن أي بديل ممكنًا. والمستدعي لهذه الدالة (SimplifyInstruction) هو موزِّع (dispatcher) يُجري switch على رمز تشغيل التعليمة (opcode)، فيوزِّع التنفيذ إلى دوالّ المساعدة الخاصّة بكل opcode. وتُستدعى من تحسينات متعدّدة. ويبدو مشغِّل بسيط (driver) على النحو التالي:
for (BasicBlock::iterator I = BB->begin(), E = BB->end(); I != E; ++I)
  if (Value *V = SimplifyInstruction(I))
    I->replaceAllUsesWith(V);
تكتفي هذه الشيفرة بالمرور (loop) على كل تعليمة في الكتلة، للتحقّق ممّا إذا كان أيّ منها قابلًا للتبسيط. وإن كان الأمر كذلك (لأنّ SimplifyInstruction يُعيد قيمة غير فارغة)، فإنّها تستخدم الدالة replaceAllUsesWith لتحديث كل ما في الشيفرة يستخدم العملية القابلة للتبسيط بالصيغة الأبسط.
11.4. تطبيق LLVM لتصميم المراحل الثلاث
في المترجَم المبني على LLVM، تكون الواجهة الأمامية مسؤولة عن تحليل الشيفرة المُدخَلة والتحقّق منها وتشخيص أخطائها، ثم ترجمة الشيفرة المحلَّلة إلى التمثيل الوسيط لـ LLVM (عادةً، لكن ليس دائمًا، عبر بناء AST ثم تحويل الـ AST إلى التمثيل الوسيط). ثم يُمرَّر هذا التمثيل اختياريًا عبر سلسلة من مراحل التحليل والتحسين التي تحسّن الشيفرة، ثم يُرسَل إلى مولِّد شيفرة لإنتاج شيفرة آليّة أصليّة (native)، كما يبيّن الشكل 11.3. وهذا تطبيق مباشر جدًّا لتصميم المراحل الثلاث، لكنّ هذا الوصف المبسّط يُخفي بعض القوة والمرونة اللتين تستمدّهما بنية LLVM من التمثيل الوسيط.
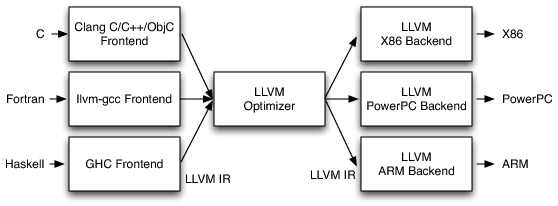
الشكل 11.3: تطبيق LLVM لتصميم المراحل الثلاث
11.4.1. التمثيل الوسيط لـ LLVM هو تمثيل كامل للشيفرة
وتحديدًا، فإنّ التمثيل الوسيط لـ LLVM محدَّد المعالم بدقّة، وهو أيضًا الواجهة الوحيدة إلى المُحسِّن. وهذه الخاصية تعني أنّ كل ما تحتاج إلى معرفته لكتابة واجهة أمامية لـ LLVM هو ما هو التمثيل الوسيط، وكيف يعمل، وما هي الثوابت (invariants) التي يتوقّعها. وبما أنّ للتمثيل الوسيط لـ LLVM شكلًا نصّيًّا من الدرجة الأولى، فإنّ بناء واجهة أمامية تُخرِج التمثيل الوسيط كنصّ، ثم تستخدم أنابيب Unix (pipes) لتمريره عبر سلسلة التحسينات ومولِّد الشيفرة من اختيارك، هو أمر ممكن ومنطقي في آن واحد.
قد يبدو هذا مدهشًا، لكنّه في الواقع خاصية جديدة نوعًا ما بالنسبة إلى LLVM، وهي أحد الأسباب الرئيسة لنجاحه في مجموعة واسعة من التطبيقات المختلفة. حتى مترجَم GCC واسع النجاح والمُصمَّم معماريًّا إلى حدٍّ معقول لا يملك هذه الخاصية: فتمثيل GIMPLE متوسطة المستوى ليس تمثيلًا مكتفيًا بذاته. وكما في مثال بسيط، حين يقوم مولِّد شيفرة GCC بإخراج معلومات تنقيح DWARF، فإنّه يعود إلى الوراء ليجوب الشكل الشجري (tree) على مستوى الشيفرة المصدرية. ويستخدم GIMPLE نفسه تمثيل «ثنائيات» (tuple) للعمليات في الشيفرة، لكنّه (على الأقلّ اعتبارًا من GCC 4.5) ما زال يمثّل المعاملات كإحالات إلى الشكل الشجري على مستوى الشيفرة المصدرية.
وتنبع نتائج ذلك أنّ على مَن يكتبون الواجهات الأمامية أن يعرفوا بنى بيانات أشجار GCC وأن يولّدوها، فضلًا عن GIMPLE، لكتابة واجهة أمامية لـ GCC. والواجهة الخلفية لـ GCC لديها مشكلات مماثلة، لذا عليها أيضًا أن تعرف قطعًا وأجزاء من طريقة عمل الواجهة الخلفية التي تعمل بـ RTL. وأخيرًا، لا يملك GCC وسيلة لتفريغ «كل ما يمثّل شيفرتي»، ولا وسيلة لقراءة GIMPLE وكتابته (والبنى البيانات المرتبطة التي تشكّل تمثيل الشيفرة) بشكل نصّي. والنتيجة أنّ التجريب مع GCC صعب نسبيًّا، ولذلك فإنّ له عددًا أقلّ من الواجهات الأمامية.
11.4.2. LLVM مجموعة من المكتبات
وبعد تصميم التمثيل الوسيط لـ LLVM، فإنّ الجانب الأهمّ التالي في LLVM هو أنّه مصمَّم بوصفه مجموعة من المكتبات، لا بوصفه مترجَم سطر أوامر أحادي الكتلة مثل GCC، ولا آلة افتراضية معتمة (opaque) مثل JVM أو الآلتين الافتراضيتين لـ .NET. إنّ LLVM بنية تحتية، ومجموعة من تقنيات المترجَمات المفيدة التي يمكن توظيفها في مسائل بعينها (مثل بناء مترجَم C، أو مُحسِّن في خط أنابيب مؤثّرات بصرية). ورغم أنّ هذا من أقوى مزاياه، فهو أيضًا إحدى نقاط التصميم الأكثر سوء فهمًا.
ولننظر إلى تصميم المُحسِّن كمثال: فهو يقرأ التمثيل الوسيط لـ LLVM، ويلتقطه ثم يفكّره قليلًا، ثم يُخرِج تمثيلًا وسيطًا يُرجى أن يُنفَّذ أسرع. وفي LLVM (كما في كثير من المترجَمات الأخرى)، يكون المُحسِّن منظَّمًا على هيئة خط أنابيب من مراحل تحسين متمايزة، تُنفَّذ كلٌّ منها على المُدخَل وتحصل على فرصة لفعل شيء ما. ومن الأمثلة الشائعة للمراحل: الدالة الداخلية (inliner) التي تستبدل جسم دالة بمواضع استدعائها، وإعادة ترابط التعابير (expression reassociation)، وحركة الشيفرة غير المتغيّرة في الحلقات (loop invariant code motion)، وغيرها. وبحسب مستوى التحسين، تُنفَّذ مراحل مختلفة: فمثلًا عند -O0 (بلا تحسين) لا ينفّذ مترجَم Clang أي مرحلة، وعند -O3 ينفّذ سلسلة من 67 مرحلة في مُحسِّنه (اعتبارًا من LLVM 2.8).
تُكتب كل مرحلة من مراحل LLVM بوصفها صنف C++ يشتقّ (بشكل غير مباشر) من الصنف Pass. ومعظم المراحل تُكتب في ملف .cpp واحد، ويُعرَّف صنفها المشتقّ من Pass في نطاق مجهول (anonymous namespace)، وهو ما يجعله خاصًّا تمامًا بالملف المُعرِّف له. ولكي تكون المرحلة مفيدة، يتعيّن على الشيفرة خارج الملف الحصول عليها، لذا تُصدَّر من الملف دالة واحدة (لإنشاء المرحلة). وإليك مثالًا مبسَّطًا قليلًا على مرحلة لجعل الأمر ملموسًا.[6]
namespace {
  class Hello : public FunctionPass {
  public:
    // Print out the names of functions in the LLVM IR being optimized.
    virtual bool runOnFunction(Function &F) {
      cerr << "Hello: " << F.getName() << "\n";
      return false;
    }
  };
}

FunctionPass *createHelloPass() { return new Hello(); }
وكما ذُكر، يوفّر مُحسِّن LLVM عشرات المراحل المختلفة، كلٌّ منها مكتوب بأسلوب مشابه. وتُصرَّف هذه المراحل في ملف .o واحد أو أكثر، ثم تُدمج في سلسلة من مكتبات الأرشفة (ملفات .a في أنظمة Unix). وتوفّر هذه المكتبات مختلف قدرات التحليل والتحويل، وتكون المراحل مفكّكة الارتباط إلى أقصى حد ممكن: يُتوقَّع منها أن تقف على مقاها، أو أن تعلن صراحةً تبعياتها على المراحل الأخرى إن كانت تعتمد على تحليل ما آخر لأداء عملها. وحين تُعطى سلسلة من المراحل لتنفيذها، يستخدم مدير المراحل (PassManager) في LLVM معلومات التبعيات الصريحة لتلبية هذه التبعيات وتحسين تنفيذ المراحل.
المكتبات والقدرات المجرّدة أمور عظيمة، لكنّها في الواقع لا تحلّ المسائل. ويظهر الجزء المثير للاهتمام حين يريد أحدهم بناء أداة جديدة تستطيع الاستفادة من تقنيات المترجَمات، ربما مترجَم JIT للغة معالجة صور. ولدى منفّذ مترجَم JIT هذا مجموعة من القيود في ذهنه: فمثلًا، قد تكون لغة معالجة الصور شديدة الحساسية لزمن الترجمة (compile-time latency)، ولديها بعض السمات اللغوية الأيضية (idiomatic) المهمّ التخلّص منها لأسباب متعلّقة بالأداء.
ويتيح التصميم المبني على المكتبات في مُحسِّن LLVM لمنفّذنا أن يختار كلٌّ من ترتيب تنفيذ المراحل والمراحل التي تناسب مجال معالجة الصور: فإذا كان كل شيء معرَّفًا في دالة واحدة كبيرة، فلا معنى لتضيع الوقت في التضمين (inlining). وإذا كانت المؤشّرات قليلة، فلا داعي للعبث بتحليل الأسماء المستعارة (alias analysis) وتحسين الذاكرة. لكنّ LLVM، وعلى رغم أفضل جهودنا، لا يحلّ سحريًا كل مشكلات التحسين! ولأنّ نظام المراحل مُقسَّم إلى وحدات، ولا يعرف مدير المراحل (PassManager) نفسه شيئًا عن داخليات المراحل، فإنّ المنفّذ حرّ في تنفيذ مراحله الخاصّة باللغة لتغطية قصور مُحسِّن LLVM أو للاستفادة من فرص تحسين واضحة خاصّة باللغة. ويبيّن الشكل 11.4 مثالًا بسيطًا لنظام معالجة الصور XYZ الافتراضي لدينا:
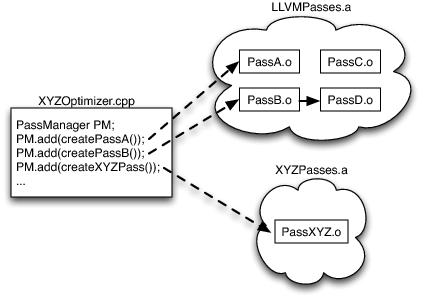
الشكل 11.4: نظام XYZ افتراضي يستخدم LLVM
وبعد أن تُختار مجموعة التحسينات (وتُتخذ قرارات مماثلة بالنسبة إلى مولِّد الشيفرة)، يُبنى مترجَم معالجة الصور في ملف تنفيذي أو مكتبة ديناميكية. وبما أنّ المرجع الوحيد لمراحل تحسين LLVM هو دالة create البسيطة المعرَّفة في كل ملف .o، وبما أنّ المُحسِّنات تعيش في مكتبات أرشفة بامتداد .a، فإنّ مراحل التحسين المُستخدَمة فعلًا فقط هي ما يُربط في التطبيق النهائي، لا مُحسِّن LLVM بأكمله. وفي مثالنا أعلاه، بما أنّ هناك إحالة إلى PassA وPassB، فسيُربط الاثنان. وبما أنّ PassB يستخدم PassD لإجراء تحليل ما، فإنّ PassD سيُربط أيضًا. لكنّ PassC (وعشرات التحسينات الأخرى) غير مُستخدَمة، فلا تُربط شيفرته في تطبيق معالجة الصور.
وهنا بالضبط تظهر قوة التصميم المبني على مكتبات LLVM. ويتيح هذا النهج التصميمي المباشر لـ LLVM تقديم كمية هائلة من القدرات، بعضُها قد لا يكون مفيدًا إلّا لجماهير محدّدة، من غير معاقبة عملاء المكتبات الذين يريدون فحسب القيام بأشياء بسيطة. وعلى النقيض، فالمُحسِّنات التقليدية للمترجَمات مبنيّة بوصفها كتلة من الشيفرة مترابطة بإحكام تام، وهي أصعب كثيرًا في التجزئة (subsetting)، وفي تفكيك المنطق، وفي الإلمام بها. أمّا مع LLVM فيمكنك فهم مُحسِّنات منفردة دون معرفة كيفية ترابط النظام كلّه.
وتصميم LLVM المبني على المكتبات هو أيضًا سبب سوء فهم كثير من الناس لماهيّة LLVM: فمكتبات LLVM تمتلك قدرات كثيرة، لكنّها لا تفعل شيئًا بحدّ ذاتها. بل الأمر متروك لمصمّم عميل المكتبات (مثل مترجَم Clang للغة C) كي يقرّر كيف يضع القطع إلى أفضل استخدام. وهذا التقسيم الطبقي الدقيق، والتحليل إلى عوامل (factoring)، والتركيز على سهولة التجزئة هو أيضًا سبب قدرة مُحسِّن LLVM على الاستخدام في مجموعة واسعة جدًّا من التطبيقات المختلفة وفي سياقات مختلفة. كما أنّ وجود قدرات التجميع وقت التشغيل (JIT) في LLVM لا يعني أنّ كل عميل يستخدمها.
11.5. تصميم مولِّد شيفرة LLVM القابل لإعادة التوجيه
ومسؤولية مولِّد شيفرة LLVM هي تحويل التمثيل الوسيط إلى شيفرة آليّة خاصّة بالهدف. ومن جهة، مهمّة مولِّد الشيفرة هي إنتاج أفضل شيفرة آليّة ممكنة لأي هدف معطى. وفي الحالة المثلى، ينبغي أن يكون كل مولِّد شيفرة شيفرة مخصَّصة كليًّا للهدف، لكن ومن جهة أخرى، يحتاج مولِّدات الشيفرة لكل هدف إلى حلّ مسائل شديدة التشابه. فمثلًا، يحتاج كل هدف إلى إسناد القيم إلى السجلات، ورغم اختلاف ملفات السجلات بين الأهداف، فينبغي أن تتشارك الخوارزميات المستخدمة حيثما أمكن.
ومثله في ذلك نهج المُحسِّن، يقسّم مولِّد شيفرة LLVM مسألة توليد الشيفرة إلى مراحل مستقلّة—اختيار التعليمات، وتخصيص السجلات، والجدولة، وتحسين تخطيط الشيفرة، وإخراج التجميع (assembly)—ويوفّر عشرات المراحل المدمجة (builtin) التي تُنفَّذ افتراضيًا. ثم يُتاح لمؤلّف الهدف أن يختار من بين المراحل الافتراضية، أو يتجاوز الافتراضيات، أو ينفّذ مراحل مخصَّصة كليًّا خاصّة بالهدف حسب الحاجة. فمثلًا، تستخدم الواجهة الخلفية لـ x86 مجدولًا يخفّض ضغط السجلات لأنّ عدد سجلاتها قليل جدًّا، في حين تستخدم الواجهة الخلفية لـ PowerPC مجدولًا يحسّن زمن الاستجابة (latency) لأنّ لديها سجلات كثيرة. وتستخدم الواجهة الخلفية لـ x86 مرحلة مخصَّصة للتعامل مع مكدّس الأعداد العشرية العائمة x87، وتستخدم الواجهة الخلفية لـ ARM مرحلة مخصَّصة لوضع جزر بِركة الثوابت (constant pool islands) داخل الدوال عند الحاجة. وتتيح هذه المرونة لمؤلّفي الأهداف إنتاج شيفرة ممتازة من غير الحاجة إلى كتابة مولِّد شيفرة كامل من الصفر لهدفهم.
11.5.1. ملفات وصف أهداف LLVM
يسمح نهج «المزج والمطابقة» (mix and match) لمؤلّفي الأهداف بأن يختاروا ما يناسب معماريّتهم، ويتيح قدرًا كبيرًا من إعادة استخدام الشيفرة عبر الأهداف المختلفة. وهذا يطرح تحديًا آخر: إذ يحتاج كل مكوّن مشترك إلى القدرة على استنتاج الخصائص الخاصّة بالهدف بطريقة عامّة. فمثلًا، يحتاج مخصّص السجلات المشترك إلى معرفة ملف السجلات الخاص بكل هدف، والقيود الموجودة بين التعليمات ومعاملاتها السجلية. وحلّ LLVM في ذلك هو أن يقدّم كل هدف وصفًا له في لغة تعريفية خاصّة بالمجال (domain-specific)، وهي مجموعة من ملفات .td تعالجها الأداة tblgen. ويبيّن الشكل 11.5 عملية البناء (المبسّطة) لهدف x86.
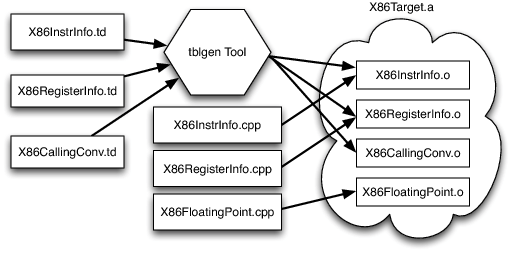
الشكل 11.5: تعريف مبسّط لهدف x86
وتتيح الأنظمة الفرعية المختلفة التي تدعمها ملفات .td لمؤلّفي الأهداف بناء الأجزاء المختلفة لأهدافهم. فمثلًا، تعرّف الواجهة الخلفية لـ x86 صنف سجلات يضمّ كل سجلاتها ذات 32 بت باسم "GR32" (وفي ملفات .td، تكون التعريفات الخاصّة بالأهداف بأحرف كبيرة كلّها) على النحو التالي:
def GR32 : RegisterClass<[i32], 32,
[EAX, ECX, EDX, ESI, EDI, EBX, EBP, ESP,
R8D, R9D, R10D, R11D, R14D, R15D, R12D, R13D]> { … }
يقول هذا التعريف إنّ السجلات في هذا الصنف تستطيع حمل قيم أعداد صحيحة بطول 32 بت ("i32")، وتفضَّل أن تكون محاذية على حدود 32 بت، ولديها الستّة عشر سجلًا المحدَّدة (المعرَّفة في مواضع أخرى من ملفات .td)، ولديها مزيد من المعلومات لتحديد ترتيب التخصيص المفضَّل وأمور أخرى. وبناءً على هذا التعريف، يمكن للتعليمات بعينها أن تشير إليه باستخدامه معاملًا. فمثلًا، تُعرَّف تعليمة «تكملة سجل بطول 32 بت» على النحو التالي:
let Constraints = "$src = $dst" in
def NOT32r : I<0xF7, MRM2r,
               (outs GR32:$dst), (ins GR32:$src),
               "not{l}\t$dst",
               [(set GR32:$dst, (not GR32:$src))]>;
يقول هذا التعريف إنّ NOT32r هي تعليمة (فهي تستخدم صنف I من tblgen)، ويحدّد معلومات الترميز (0xF7, MRM2r)، ويحدّد أنّها تُعرِّف سجل «مخرَج» بطول 32 بت اسمها $dst ولديها سجل «مُدخَل» بطول 32 بت اسمها $src (وصنف السجلات GR32 المعرَّف أعلاه يحدّد السجلات الصالحة للمعامل)، ويحدّد صيغة التجميع للتعليمة (باستخدام صيغة {} للتعامل مع صياغتي AT&T وIntel)، ويحدّد أثر التعليمة، ويقدّم في السطر الأخير النمط الذي ينبغي أن تطابقه. ويخبر القيد «let» في السطر الأول مخصّص السجلات بأنّ سجل المُدخَل وسجل المخرَج يجب أن يُخصَّص لهما السجل الفيزيائي نفسه.
إنّ هذا التعريف وصف شديد الكثافة للتعليمة، ويمكن لشيفرة LLVM المشتركة أن تفعل الكثير بالمعلومات المشتقّة منه (بواسطة الأداة tblgen). وهذا التعريف الواحد يكفي ليقوم اختيار التعليمات بتشكيل هذه التعليمة عبر مطابقة الأنماط على شيفرة IR المُدخَلة للمترجَم. وهو أيضًا يحدّد لمخصّص السجلات كيف يتعامل معها، ويكفي لترميز التعليمة وفكّ ترميزها إلى بايتات شيفرة آليّة، ويكفي لتحليل التعليمة وطباعتها بشكل نصّي. وتتيح هذه القدرات لهدف x86 دعم توليد مُجمِّع x86 مستقل (بديل مباشر drop-in للمجمِّع GNU المعروف بـ "gas") ومفكّكات ترميز من وصف الهدف، فضلًا عن التعامل مع ترميز التعليمة لأغراض JIT.
وإلى جانب توفير وظائف مفيدة، فإنّ توليد قطع معلومات متعدّدة من «الحقيقة» ذاتها مفيد لأسباب أخرى أيضًا. فهذا النهج يجعل من شبه المستحيل أن يختلف المُجمِّع عن مفكّك الترميز، سواء في صيغة التجميع أو في الترميز الثنائي. كما يجعل وصف الهدف سهل الاختبار إلى حدٍّ كبير: إذ يمكن اختبار ترميزات التعليمات بوحدات الاختبار (unit tests) من غير الحاجة إلى إشراك مولِّد الشيفرة بأكمله.
ولرغم أنّنا نسعى إلى نقل أكبر قدر ممكن من معلومات الهدف إلى ملفات .td بشكل تصريحي أنيق، فإنّنا لا نملك كل شيء بعد. وبدلًا من ذلك، نُلزم مؤلّفي الأهداف بكتابة بعض شيفرة C++ لدوالّ مساعِد متنوّعة، وبتنفيذ أي مراحل خاصّة بالهدف قد يحتاجونها (مثل X86FloatingPoint.cpp، الذي يتعامل مع مكدّس الأعداد العشرية العائمة x87). ومع نموّ LLVM واكتسابه أهدافًا جديدة، يصبح من المهمّ أكثر فأكثر زيادة مقدار الهدف الذي يمكن التعبير عنه في ملف .td، ونواصل زيادة تعبيرية ملفات .td للتعامل مع ذلك. ومن الفوائد العظيمة أنّ كتابة الأهداف في LLVM تصير أسهل وأيسر مع مرور الوقت.
11.6. قدرات مثيرة يوفّرها التصميم النمطي
وإلى جانب كونه تصميمًا أنيقًا في عمومه، توفّر النمطية (modularity) لعملاء مكتبات LLVM عدّة قدرات مثيرة. وتنبع هذه القدرات من أنّ LLVM يوفّر الوظائف، لكنّه يترك للعميل أن يقرّر معظم السياسات المتعلّقة بكيفية استخدامها.
11.6.1. اختيار متى وأين تُنفَّذ كل مرحلة
وكما ذُكر سابقًا، يمكن تسلسل (serialization) التمثيل الوسيط لـ LLVM وإلغاؤه بكفاءة من وإلى تنسيق ثنائي معروف باسم بتكود LLVM (LLVM bitcode). وبما أنّ التمثيل الوسيط مكتفي بذاته، وأنّ التسلسل عملية بلا فقدان، يمكننا إنجاز جزء من الترجمة، وحفظ تقدّمنا على القرص، ثم متابعة العمل في وقت لاحق. وتوفّر هذه الخاصية عددًا من القدرات المثيرة، منها دعم التحسين وقت الربط (link-time) ووقت التثبيت (install-time)، وكلاهما يؤخّر توليد الشيفرة عن «زمن الترجمة».
ويعالج التحسين وقت الربط (Link-Time Optimization، أو LTO) المشكلة التي يكون فيها المترجَم التقليدي لا يرى سوى وحدة ترجمة واحدة (مثل ملف .c بجميع ترويسته) في كل مرّة، ولذلك لا يستطيع إجراء تحسينات (مثل التضمين) عبر حدود الملفات. وتدعم المترجَمات المبنية على LLVM مثل Clang ذلك عبر خيار سطر الأوامر -flto أو -O4. ويأمر هذا الخيار المترجَم بإخراج بتكود LLVM في ملف .o بدلًا من كتابة ملف كائن أصلي (native object file)، ويؤخّر توليد الشيفرة إلى زمن الربط، كما يبيّن الشكل 11.6.
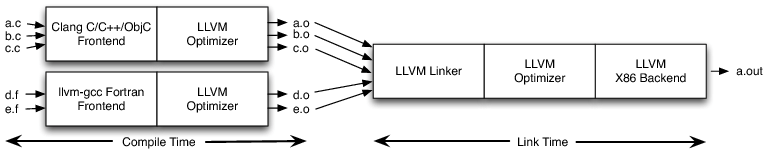
الشكل 11.6: التحسين وقت الربط
تختلف التفاصيل بحسب نظام التشغيل الذي تعمل عليه، لكنّ المهمّ هو أن يكتشف الرابط (linker) أنّ لديه بتكود LLVM في ملفات .o بدلًا من ملفات الكائنات الأصلية. وحين يرى ذلك، يقرأ جميع ملفات البتكود إلى الذاكرة، ويربطها ببعضها، ثم يشغّل مُحسِّن LLVM على الكتلة المجمّعة. وبما أنّ المُحسِّن يستطيع الآن أن يرى نطاقًا أكبر بكثير من الشيفرة، فإنه يستطيع التضمين، ونشر الثوابت (propagate constants)، وإزالة الشيفرة الميّتة (dead code elimination) بجهد أكبر، وغيرها عبر حدود الملفات. ورغم أنّ كثيرًا من المترجَمات الحديثة تدعم LTO، فإنّ معظمها (مثل GCC وOpen64 ومترجَم Intel وغيرها) يفعل ذلك عبر عملية تسلسل مكلفة وبطيئة. أمّا في LLVM فإنّ LTO ينبثق طبيعيًّا من تصميم النظام، ويعمل عبر مختلف اللغات المصدرية (بخلاف كثير من المترجَمات الأخرى) لأنّ التمثيل الوسيط (IR) محايد فعلًا تجاه اللغة المصدرية.
أمّا التحسين وقت التثبيت (install-time optimization) فهو فكرة تأخير توليد الشيفرة أكثر من ذلك، إلى زمن التثبيت كلّه، كما يبيّن الشكل 11.7. وزمن التثبيت وقت مثير جدًّا للاهتمام (في الحالات التي يُشحن فيها البرنامج في صندوق، أو يُنزَّل، أو يُرفع إلى جهاز محمول، إلخ)، لأنّ هذا هو الوقت الذي تكتشف فيه تفاصيل الجهاز الذي تستهدفه. فعائلة x86 مثلًا تضمّ مجموعة واسعة جدًّا من الشرائح والخصائص. وبتأجيل اختيار التعليمات والجدولة وسوانب أخرى من جوانب توليد الشيفرة، يمكنك اختيار أفضل الإجابات لعتاد الجهاز المحدّد الذي سينتهي التطبيق بالعمل عليه.
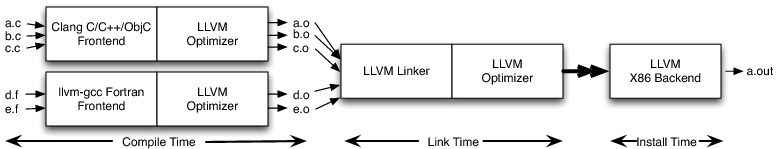
الشكل 11.7: التحسين وقت التثبيت
11.6.2. اختبار المُحسِّن بوحدات
المترجَمات معقّدة جدًّا، والجودة مهمّة، لذا فالاختبار جوهري. فمثلًا، بعد إصلاح خلل تسبّب في انهيار في مُحسِّن، ينبغي إضافة اختبار انحدار (regression test) للتأكّد من ألّا يتكرّر. والنهج التقليدي لاختبار ذلك هو كتابة ملف .c (مثلًا) يُمرَّر عبر المترجَم، مع وجود بنية اختبار (test harness) تتحقّق من أنّ المترجَم لا ينهار. وهذا هو النهج الذي تستخدمه مجموعة اختبارات GCC مثلًا.
والمشكلة في هذا النهج هي أنّ المترجَم يتألّف من أنظمة فرعية كثيرة مختلفة، بل ومن مراحل كثيرة مختلفة في المُحسِّن، لكلٍّ منها الفرصة أن يغيّر شكل الشيفرة المُدخَلة بحلول الوقت الذي تصل فيه إلى الشيفرة التي كان فيها الخلل سابقًا. فإذا تغيّر شيء في الواجهة الأمامية أو في مُحسِّن أسبق، فإنّ حالة اختبار بوسعها أن تفشل في اختبار ما يفترض أن تختبره.
وباستخدام الشكل النصّي للتمثيل الوسيط مع المُحسِّن النمطي، تمتلك مجموعة اختبارات LLVM اختبارات انحدار شديدة التركيز تستطيع تحميل التمثيل الوسيط من القرص، وتمريره عبر مرحلة تحسين واحدة بالضبط، والتحقّق من السلوك المتوقّع. وإلى جانب الانهيار، فإنّ اختبارًا سلوكيًّا أعقد يريد التحقّق من أنّ تحسينًا ما قد نُفِّذ فعلًا. وإليك حالة اختبار بسيطة تتحقّق من أنّ مرحلة نشر الثوابت تعمل مع تعليمات الجمع:
; RUN: opt < %s -constprop -S | FileCheck %s
define i32 @test() {
  %A = add i32 4, 5
  ret i32 %A
  ; CHECK: @test()
  ; CHECK: ret i32 9
}
يحدّد سطر RUN الأمر الذي ينبغي تنفيذه: في هذه الحالة، أدوات سطر الأوامر opt وFileCheck. وبرنامج opt هو غلاف بسيط حول مدير مراحل LLVM، يربط كل المراحل القياسية (ويستطيع تحميل إضافات (plugins) تحتوي على مراحل أخرى ديناميكيًّا) ويعرضها عبر سطر الأوامر. تتحقّق الأداة FileCheck من أنّ مُدخَلها القياسي يطابق سلسلة من توجيهات CHECK. وفي هذه الحالة، يتحقّق هذا الاختبار البسيط من أنّ مرحلة constprop تطوي عملية add بين 4 و5 إلى 9.
ورغم أن يبدو هذا مثالًا شديد اليساطة، فإنّ اختباره بكتب ملفات .c صعب جدًّا: فالواجهات الأمامية غالبًا ما تُجري طيَّ الثوابت (constant folding) أثناء التحليل، لذا من الصعب جدًّا وهشّ كتابة شيفرة تُمرَّر إلى أسفل حتى تبلغ مرحلة تحسين طي الثوابت. ولأنّنا نستطيع تحميل التمثيل الوسيط لـ LLVM كنصّ وتمريره عبر مرحلة التحسين التي تهمّنا تحديدًا، ثم تفريغ النتيجة في ملف نصّي آخر، فإنّ اختبار ما نريده بالضبط — سواء في اختبارات الانحدار أم في اختبارات المزايا — يصبح مباشرًا إلى حدٍّ كبير.
11.6.3. التصغير التلقائي لحالات الاختبار باستخدام BugPoint
وحين يُكتشف خلل في مترجَم أو في عميل آخر لمكتبات LLVM، فإنّ الخطوة الأولى في إصلاحه هي الحصول على حالة اختبار تُعيد إنتاج المشكلة. وبمجرد توفّر حالة اختبار، فمن الأفضل تصغيرها إلى أصغر مثال يُعيد إنتاج المشكلة، فضلًا عن تضييقها على الجزء من LLVM الذي تحدث فيه المشكلة، مثل مرحلة التحسين المسؤولة عنها. ورغم أنّك تتعلّم في النهاية كيفية القيام بذلك، فإنّ العملية مملّة يدوية، ومؤلمة على وجه الخصوص في الحالات التي يُنتج فيها المترجَم شيفرة خاطئة من غير أن ينهار.
وتستخدم أداة BugPoint في LLVM[7] تسلسل التمثيل الوسيط (IR) والتصميم النمطي لـ LLVM لأتمتة هذه العملية. فمثلًا، عند إعطائها ملف مُدخَل بامتداد .ll أو .bc مع قائمة من مراحل التحسين التي تسبّب انهيار مُحسِّن، تُصغّر BugPoint المُدخَل إلى حالة اختبار صغيرة وتحدّد أيّ المُحسِّنات هو المسؤول عن الخلل. ثم تُخرِج حالة الاختبار المصغّرة وأمر opt المستخدم لإعادة إنتاج الفشل. وتجد ذلك باستخدام تقنيات تشبه «تنقيح دلتا» (delta debugging) لتصغير المُدخَل وقائمة مراحل المُحسِّن. ولأنّها تعرف بنية التمثيل الوسيط لـ LLVM، فإنّ BugPoint لا تُضيّع وقتها في توليد تمثيل IR غير صالح كمدخل للمُحسِّن، بخلاف أداة سطر الأوامر القياسية «delta».
وفي حالة الترجمة الخاطئة (miscompilation) الأكثر تعقيدًا، يمكنك تحديد المُدخَل، ومعلومات مولِّد الشيفرة، وسطر الأوامر الذي يُمرَّر إلى الملف التنفيذي، ومخرَجًا مرجعيًّا. وثم تحدّد BugPoint أولًا ما إذا كانت المشكلة بسبب مُحسِّن أم بسبب مولِّد شيفرة، ثم تقسّم حالة الاختبار تكرارًا إلى جزأين: جزء يُرسَل إلى المكوّن «المعروف جيّدًا» (known good)، وجزء يُرسَل إلى المكوّن «المعروف أنّه معطوب» (known buggy). ومن خلال نقل المزيد والمزيد من الشيفرة، على نحو تكراري، خارج الجزء الذي يُرسَل إلى مولِّد الشيفرة المعروف أنّه معطوب، تُصغّر حالة الاختبار.
وBugPoint أداة بسيطة جدًّا، وقد وفّرت ساعات لا تُحصى من تصغير حالات الاختبار طوال عمر LLVM. ولا يملك أي مترجَم مفتوح المصدر آخر أداة مماثلة في القوة، لأنّه يعتمد على تمثيل وسيط محدَّد المعالم بدقّة. ومع ذلك، فـ BugPoint ليست كاملة، وستستفيد من إعادة كتابتها. فهي تعود إلى عام 2002، ولا تُطوَّر عادةً إلّا حين يصطدم أحدهم بخلل شديد التعقيد يتعذّر على الأداة القائمة معالجته جيدًا. وقد نمت مع الوقت، وتراكمت فيها مزايا جديدة (مثل تنقيح JIT) من غير تصميم متّسق ولا مالك مسؤول.
11.7. استرجاع الماضي والاتجاهات المستقبلية
لم تُصمَّم نمطية LLVM في الأصل لتحقيق أيٍّ من الأهداف الموصوفة هنا مباشرةً. كانت آلية دفاع عن النفس: فمن الواضح أنّنا لن نحصل على كل شيء صحيح من المحاولة الأولى. فخط أنابيب المراحل النمطي مثلًا موجود يسهل عزل المراحل بحيث يمكن التخلّص منها بعد استبدالها بتنفيذات أفضل[8].
ومن الجوانب الرئيسة الأخرى لبقاء LLVM مرنًا (وهو موضوع مثير للجدل مع عملاء المكتبات) هو استعدادنا لإعادة النظر في القرارات السابقة وإجراء تغييرات واسعة على واجهات البرمجة (APIs) من غير قلق على التوافق الخلفي (backwards compatibility). فالتغييرات البالغة في التمثيل الوسيط لـ LLVM نفسه، على سبيل المثال، تتطلّب تحديث جميع مراحل التحسين وتسبّب اضطرابًا كبيرًا في واجهات C++ البرمجية. وقد فعلنا هذا عدّة مرّات، ورغم أنّه يسبّب الألم للعملاء، فإنّه الشيء الصحيح للحفاظ على تقدّم أمامي سريع. ولتسهيل الحياة على العملاء الخارجيين (ودعم الربط بلغات أخرى)، نوفّر أغلفة C (wrappers) للعدّة من الواجهات البرمجية الشائعة (المقصود بها أن تكون مستقرّة إلى حدٍّ كبير)، وتسعى الإصدارات الجديدة من LLVM إلى مواصلة قراءة ملفات .ll و.bc القديمة.
ونظرًا إلى الأمام، نودّ أن نواصل جعل LLVM أكثر نمطية وأسهل تجزئة. فمثلًا، ما زال مولِّد الشيفرة أحادي الكتلة أكثر ممّا ينبغي: إذ لا يمكن حاليًا تجزئة LLVM بناءً على المزايا. فمثلًا، إن أردت استخدام JIT لكن لا حاجة لديك إلى التجميع المضمّن (inline assembly)، ولا إلى معالجة الاستثناءات، ولا إلى توليد معلومات التنقيح، فينبغي أن يكون من الممكن بناء مولِّد الشيفرة من غير ربط دعم هذه المزايا. كما نواصل تحسين جودة الشيفرة التي يولّدها المُحسِّن ومولِّد الشيفرة، وإضافة مزايا إلى التمثيل الوسيط (IR) لدعم أفضل للبُنى اللغوية وبنى الأهداف الجديدة، وإضافة دعم أفضل لتنفيذ تحسينات عالية المستوى خاصّة بكل لغة داخل LLVM.
ويواصل مشروع LLVM النموّ والتحسّن بطرق لا تُحصى. ومن المثير فعلًا رؤية عدد الطرق المختلفة التي يُستخدم بها LLVM في مشاريع أخرى، وكيف يظهر مرّة بعد مرّة في سياقات جديدة مفاجئة لم يفكّر فيها مصمّموه البتّة. ومن الأمثلة الجيّدة على ذلك منقِّح الأخطاء الجديد LLDB: فهو يستخدم محلِّلات Clang للغات C/C++/Objective-C لتحليل التعابير، ويستخدم JIT الخاص بـ LLVM لترجمتها إلى شيفرة خاصّة بالهدف، ويستخدم مفكّكات ترميز LLVM، ويستخدم أهداف LLVM للتعامل مع اصطلاحيات الاستدعاء (calling conventions) من بين أمور أخرى. وتتيح إعادة استخدام هذه الشيفرة القائمة لمن يطوّرون منقِّحات الأخطاء أن يركّزوا على كتابة منطق المنقِّح، بدلًا من إعادة تنفيذ محلِّل لغة C++ آخر (صحيح إلى حدٍّ ضئيل).
ورغم نجاحه حتى الآن، فما زال هناك الكثير ممّا ينبغي إنجازه، فضلًا عن الخطر الدائم القائم بأنّ LLVM سيصير أقلّ مرونة وأكثر تصلّبًا مع شيخوخته. ولا توجد إجابة سحرية لهذه المشكلة، لكنّني آمل أن يساعد التعرّض المستمر على مجالات مشكلات جديدة، والاستعداد لإعادة تقييم القرارات السابقة، وإعادة تصميم الشيفرة والتخلّص منها. فبعد كل شيء، الهدف ليس الكمال، بل أن نواصل التحسّن مع الوقت.
الحواشي
http://llvm.orghttp://clang.llvm.orghttp://en.wikipedia.org/wiki/List_of_JVM_languages- لاحقة تكرارية (backronym) صارت الآن تقف على عبارة "GNU Compiler Collection".
- ويقابل ذلك مجموعات تعليمات ثنائية العناوين مثل X86، والتي تُحدِّث سجل مُدخَل إتلافيًّا، أو آلات أحادية العنوان تأخذ معاملًا صريحًا واحدًا وتعمل على مرّاكِم (accumulator) أو على قمة المكدّس في آلات المكدّس.
- للاطلاع على جميع التفاصيل، انظر دليل كتابة مرحلة LLVM (Writing an LLVM Pass manual) في
http://llvm.org/docs/WritingAnLLVMPass.html. http://llvm.org/docs/Bugpoint.html- كثيرًا ما أقول إنّه لا يُعدّ أي نظام فرعي في LLVM جيّدًا حقًّا إلى أن تُعاد كتابته مرّة واحدة على الأقلّ.
http://llvm.org↩︎http://clang.llvm.org↩︎http://en.wikipedia.org/wiki/List_of_JVM_languages↩︎لاحقة تكرارية (backronym) صارت الآن تقف على عبارة «GNU Compiler Collection». ↩︎
ويقابل ذلك مجموعات تعليمات ثنائية العناوين مثل X86، والتي تُحدِّث سجل مُدخَل إتلافيًّا، أو آلات أحادية العنوان تأخذ معاملًا صريحًا واحدًا وتعمل على مرّاكِم (accumulator) أو على قمة المكدّس في آلات المكدّس. ↩︎
للاطلاع على جميع التفاصيل، انظر دليل كتابة مرحلة LLVM (Writing an LLVM Pass manual) في
http://llvm.org/docs/WritingAnLLVMPass.html. ↩︎http://llvm.org/docs/Bugpoint.html↩︎كثيرًا ما أقول إنّه لا يُعدّ أي نظام فرعي في LLVM جيّدًا حقًّا إلى أن تُعاد كتابته مرّة واحدة على الأقلّ. ↩︎