نظام الملفات الموزّع Hadoop
معمارية تطبيقات المصادر المفتوحة (المجلد الأول)نظام الملفات الموزّع لـ Hadoop
معمارية تطبيقات المصادر المفتوحة (المجلد الأول) نظام الملفات الموزّع لـ Hadoop
Robert Chansler, Hairong Kuang, Sanjay Radia, Konstantin Shvachko, وSuresh Srinivas
إذا استمتعت بهذه الكتب، فقد يعجبك أيضًا التصميم البرمجي بالأمثلة في Python والتصميم البرمجي بالأمثلة في JavaScript.
صُمِّم نظام الملفات الموزّع لـ Hadoop (HDFS) ليخزّن مجموعات بيانات ضخمة موثوقيةً، ولي streams تلك مجموعات البيانات بعرض نطاق عالٍ إلى تطبيقات المستخدم. وفي العناقيد الكبيرة، تستضيف آلاف الخوادم تخزينًا موصولًا مباشرةً (directly attached storage) وتنفّذ في الوقت نفسه مهامّ تطبيقات المستخدم. وبتوزيع التخزين والحساب على خوادم عديدة، يمكن أن ينمو المورد مع الطلب مع بقائه اقتصاديًّا على كلّ حجم. نحن نصف هنا معمارية HDFS، ونُبلّغ عن تجربتنا في استخدام HDFS لإدارة 40 بيتابايت (petabyte) من بيانات المؤسسات في Yahoo!.
8.1. مقدّمة
يوفّر Hadoop[1] نظام ملفات موزّعًا وإطار عمل لتحليل وتحويل مجموعات البيانات الضخمة باستخدام نموذج MapReduce DG04. ومع أنّ واجهة HDFS مستوحاة من نظام ملفات Unix، فإنّ الالتزام بالمعايير قد أُضحّي به لصالح أداء أفضل للتطبيقات المعنيّة.
من السمات المهمّة في Hadoop تقسيم البيانات والحساب علىgazillions من الأجهزة — بل على آلاف المضيفين (hosts) — وتنفيذ حسابات التطبيق على التوازي بالقرب من بياناتها. يوسّع عنقود Hadoop القدرة الحسابية وسعة التخزين وعرض نطاق الإدخال/الإخراج (I/O) بمجرّد إضافة خوادم تجارية (commodity servers). تمتدّ عناقيد Hadoop في Yahoo! على 40,000 خادم، وتخزّن 40 بيتابايت من بيانات التطبيقات، وأكبر عنقود فيها يتألّف من 4000 خادم. وتفيد مئة مؤسسة أخرى حول العالم بأنها تستخدم Hadoop.
يخزّن HDFS البيانات الوصفية (metadata) لنظام الملفات وبيانات التطبيقات بصورة منفصلة. وكما في أنظمة الملفات الموزّعة الأخرى، مثل PVFS CIRT00، وLustre[2]، وGFS GGL03، فإنّ HDFS يخزّن البيانات الوصفية على خادم مخصّص اسمه NameNode. أمّا بيانات التطبيقات فتُخزَّن على خوادم أخرى تُسمّى DataNodes. جميع الخوادم موصولة ببعضها تمامًا وتتبادل الرسائل فيما بينها عبر بروتوكولات قائمة على TCP. وبخلاف Lustre وPVFS، لا تعتمد DataNodes في HDFS على آليات حماية البيانات مثل RAID لجعل البيانات دائمة (durable). بل إنّ محتوى الملف، كما في GFS، يُنسَّخ على عدّة DataNodes من أجل الموثوقية. فبينما تضمن هذه الاستراتيجية ديمومة البيانات، فإنّ لها ميزة إضافية وهي مضاعفة عرض نطاق نقل البيانات، وتقليل الفوارق بين مواضع الحساب والبيانات التي يحتاج إليها.
8.2. المعمارية
8.2.1. NameNode
مساحة الأسماء (namespace) في HDFS هي تدرّج هرمي من الملفات والمجلّدات. وتمثَّل الملفات والمجلّدات على NameNode بعُقد فهرسة (inodes). وتسجّل العُقد سماتٍ مثل الأذونات، وأوقات التعديل والوصول، وحصص مساحة الأسماء (namespace quotas) وقرص التخزين. يُقسَّم محتوى الملف إلى كتل كبيرة (عادةً 128 ميغابايت، لكنّ اختيار المستخدم يتمّ لكل ملف على حدة)، ويُنسَّخ كلّ كتلة من الملف بشكل مستقلّ على عدّة DataNodes (عادةً ثلاث، لكنّ اختيار المستخدم يتمّ لكل ملف على حدة). يحتفظ NameNode بشجرة مساحة الأسماء وبخريطة الكتل إلى DataNodes. ويقوم التصميم الحالي على NameNode واحد لكلّ عنقود. وقد يحتوي العنقود على آلاف من DataNodes وعشرات الآلاف من عملاء HDFS، إذ يمكن لكلّ DataNode أن ينفّذ مهامّ تطبيق متعدّدة على التوازي.
8.2.2. الصورة والمجلّة
العُقد وقائمة الكتل التي تُعرّف البيانات الوصفية لنظام الأسماء تُسمّى الصورة (image). يحتفظ NameNode بالصورة الكاملة لمساحة الأسماء في الذاكرة العشوائية (RAM). أمّا السجلّ الدائم للصورة المخزَّن في نظام الملفات الأصليّ (native filesystem) المحليّ الخاصّ بـ NameNode فيُسمّى نقطة تفتيش (checkpoint). ويسجّل NameNode التغييرات على HDFS في سجلّ كتابة أماميّة (write-ahead log) يُسمّى المجلّة (journal) في نظام الملفات الأصليّ المحليّ الخاصّ به. أمّا مواضع نسخ الكتل فلا تشكّل جزءًا من نقطة التفتيش الدائمة.
تُسجَّل كلّ معاملة يبدأها العميل في المجلّة، ثمّ يُفرَّغ ملفّ المجلّة إلى القرص ويُزامَن (synced) قبل إرسال الإيذاك (acknowledgment) إلى العميل. لا يغيّر NameNode ملفّ نقطة التفتيش إطلاقًا؛ بل يُكتب ملفٌّ جديد عند إنشاء نقطة تفتيش أثناء إعادة التشغيل، أو عند طلب مدير النظام لها، أو بواسطة CheckpointNode الموصوف في القسم التالي. وأثناء بدء التشغيل، يهيّئ NameNode صورة مساحة الأسماء من نقطة التفتيش، ثمّ يعيد تشغيل التغييرات الواردة في المجلّة. وتُكتب نقطة تفتيش جديدة ومجلّة فارغة إلى مجلّدات التخزين قبل أن يبدأ NameNode في خدمة العملاء.
لتحسين الديمومة، تُخزَّن عادةً نسخٌ زائدة من نقطة التفتيش والمجلّة على عدّة وحدات تخزين محلّية مستقلّة وعلى خوادم NFS بعيدة. فالخيار الأول يمنع الفقدان الناتج عن تعطّل وحدة تخزين واحدة، والخيار الثاني يحمي من تعطّل العقدة بأكملها. وإذا واجه NameNode خطأً أثناء كتابة المجلّة في أحد مجلّدات التخزين، فإنّه يستبعد ذلك المجلّد تلقائيًّا من قائمة مجلّدات التخزين. ويوقف NameNode نفسه تلقائيًّا إذا لم يتوفّر أيّ مجلّد تخزين.
يُعدّ NameNode نظامًا متعدّد الخيوط (multithreaded)، ويعالج الطلبات في الوقت نفسه من عدّة عملاء. ويصبح حفظ المعاملة على القرص عنق زجاجة، إذ تنتظر بقية الخيوط حتى تكتمل إجراءcedure التفخير والمزامنة المتزامنة التي بدأتها إحدى الخيوط. ولتحسين هذه العملية، يقوم NameNode بتجميع عدّة معاملات في دفعة واحدة (batch). وحين تبدأ إحدى خيوط NameNode عملية تفخير ومزامنة، تُثبَّت جميع المعاملات المجمَّعة في تلك اللحظة معًا. أمّا الخيوط المتبقّية فلا تكفيها التحقّق من أنّ معاملاتها قد حُفظت، ولا تحتاج إلى بدء عملية تفخير ومزامنة.
8.2.3. DataNodes
تُمثَّل كلّ نسخة كتلة على DataNode بملفّين في نظام الملفات الأصليّ المحليّ. يحوي الملفّ الأول البيانات نفسها، ويسجّل الملفّ الثاني البيانات الوصفية للكتلة، بما في ذلك مجاميع التحقّق (checksums) للبيانات وختم التوليد (generation stamp). ويساوي حجم ملفّ البيانات الطول الفعليّ للكتلة، ولا يحتاج إلى مساحة إضافية لتقريبه إلى حجم الكتلة الاسميّ كما في أنظمة الملفات التقليدية. لذلك، إذا كانت الكتلة ممتلئة إلى النصف فإنّها تحتاج إلى نصف حجم الكتلة الكاملة على القرص المحلّي.
أثناء بدء التشغيل، يتّصل كلّ DataNode بالـ NameNode ويجري مصافحة (handshake). والهدف من المصافحة هو التحقّق من معرّف مساحة الأسماء (namespace ID) وإصدار برمجية DataNode. فإذا لم يتطابق أيٌّ منهما مع ما عند NameNode، فإنّ DataNode يوقف نفسه تلقائيًّا.
يُسنَد معرّف مساحة الأسماء إلى النسخة الحالية (instance) من نظام الملفات عند تنسيقها. ويُخزَّن معرّف مساحة الأسماء بشكل دائم على جميع عقد العنقود. ولن تستطيع العقد التي تحمل معرّفًا مختلفًا لمساحة الأسماء الانضمام إلى العنقود، ممّا يحمي سلامة نظام الملفات. ويُسمح لـ DataNode المُهيّأ حديثًا والذي لا يملك معرّف مساحة أسماء بالانضمام إلى العنقود وتلقّي معرّف مساحة الأسماء الخاصّ بالعنقود.
بعد المصافحة، يسجّل DataNode نفسه لدى NameNode. ويخزّن DataNodes معرّفات تخزينه الفريدة بشكل دائم. ومعرّف التخزين (storage ID) هو مُعرِّف داخلي خاصّ بـ DataNode يجعله قابلًا للتعرّف حتى إن أُعيد تشغيله بعنوان IP أو منفذ مختلف. ويُسنَد معرّف التخزين إلى DataNode حين يسجّل نفسه لدى NameNode للمرة الأولى، ولا يتغيّر بعد ذلك.
يبلّغ DataNode الـ NameNode عن نسخ الكتل التي يملكها فيوتّر تقرير كتلة (block report). ويتضمّن تقرير الكتلة معرّف الكتلة وختم التوليد والطول لكلّ نسخة كتلة يستضيفها الخادم. ويُرسَل أول تقرير كتلة فور تسجيل DataNode. وتُرسَل تقارير الكتل اللاحقة كلّ ساعة، وتوفّر لـ NameNode صورة محدَّثة عن مواضع نسخ الكتل داخل العنقود.
أثناء التشغيل الطبيعي، ترسل DataNodes نبضات قلب (heartbeats) إلى NameNode لتأكيد أنّ DataNode يعمل وأنّ نسخ الكتل التي يستضيفها متاحة. والفاصل الزمني الافتراضي بين النبضات ثلاث ثوانٍ. فإذا لم يتلقَّ NameNode نبضة من DataNode خلال عشر دقائق، فإنّه يعتبر DataNode خارج الخدمة، ويعتبر نسخ الكتل التي يستضيفها غير متاحة. ثمّ يجدول NameNode إنشاء نسخ جديدة من تلك الكتل على DataNodes أخرى.
تحمل نبضات القلب من DataNode أيضًا معلومات عن سعة التخزين الكلّية، ونسبة المساحة المستخدَمة، وعدد عمليات نقل البيانات الجاري تنفيذها حاليًّا. وتُستخدَم هذه الإحصاءات في قرارات NameNode الخاصة بتخصيص الكتل وموازنة الحمل.
لا يرسل NameNode طلبات مباشرةً إلى DataNodes. بل يستعمل ردود نبضات القلب لإرسال التعليمات إلى DataNodes. وتشمل هذه التعليمات أوامرَ بنسخ الكتل إلى عقد أخرى، وحذف نسخ الكتل المحلّية، وإعادة التسجيل وإرسال تقرير كتلة فوريّ، وإيقاف العقدة.
تكتسب هذه الأوامر أهميتها من دورها في الحفاظ على سلامة النظام كلّه، ولذلك فإنّ إبقاء النبضات متكرّرة أمر حاسم حتى في العناقيد الكبيرة. ويستطيع NameNode معالجة آلاف نبضات القلب في الثانية الواحدة دون التأثير في عملياته الأخرى.
8.2.4. عميل HDFS
تصل تطبيقات المستخدم إلى نظام الملفات عبر عميل HDFS، وهو مكتبة تصدّر واجهة نظام ملفات HDFS.
وكما في معظم أنظمة الملفات التقليدية، يوفّر HDFS عمليات قراءة الملفات وكتابتها وحذفها، وعمليات إنشاء المجلّدات وحذفها. ويُشير المستخدم إلى الملفات والمجلّدات عبر مسارات داخل مساحة الأسماء. ولا يحتاج تطبيق المستخدم إلى معرفة أنّ البيانات الوصفية لنظام الملفات والتخزين موزّعان على خوادم مختلفة، أو أنّ للكتل نسخًا متعدّدة.
عندما يقرأ تطبيق ملفًّا، يسأل عميل HDFS أوّلًا NameNode عن قائمة DataNodes التي تستضيف نسخ كتل الملف. وتُرتَّب هذه القائمة حسب مسافة طوبولوجيا الشبكة عن العميل. ثمّ يتواصل العميل مع DataNode مباشرةً ويطلب نقل الكتلة المطلوبة. أمّا حين يكتب العميل، فيسأل أوّلًا NameNode أن يختار DataNodes تستضيف نسخ الكتلة الأولى من الملف. ثمّ ينظّم العميل خطّ أنابيب (pipeline) من عقدة إلى عقدة ويرسل البيانات. وحين تمتلئ الكتلة الأولى، يطلب العميل اختيار DataNodes جديدة تستضيف نسخ الكتلة التالية. ويُنظَّم خطّ أنابيب جديد، ويرسل العميل بقية بايتات الملف. ومن المرجَّح أن يكون اختيار DataNodes مختلفًا لكلّ كتلة. وتمرّ التفاعلات بين العميل وNameNode وDataNodes كما هي موضَّحة في الشكل 8.1.
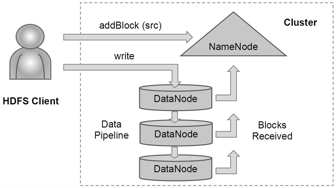
الشكل 8.1: عميل HDFS ينشئ ملفًّا جديدًا
وبخلاف أنظمة الملفات التقليدية، يوفّر HDFS واجهة برمجية (API) تكشف مواضع كتل الملف. ويتيح ذلك للتطبيقات مثل إطار عمل MapReduce أن تجدول المهمة حيث توجد البيانات، وبذلك يتحسّن أداء القراءة. كما يتيح للتطبيق ضبط عامل التكرار (replication factor) للملف. ويكون عامل التكرار الافتراضي للملف ثلاثة. أمّا الملفات الحرجة أو كثيرة الاستخدام، فإنّ رفع عامل التكرار يزيد تحمّلها للأعطال ويرفع عرض نطاق القراءة.
8.2.5. CheckpointNode
إضافةً إلى دوره الرئيسي في خدمة طلبات العملاء، يمكن لـ NameNode في HDFS أن يؤدّي بدلًا من ذلك أحد دورينآخرين: CheckpointNode أو BackupNode. ويُحدَّد الدور عند بدء تشغيل العقدة.
يجمع CheckpointNode دوريًّا نقطة التفتيش والمجلّة القائمتين لإنشاء نقطة تفتيش جديدة ومجلّة فارغة. ونادرًا ما يعمل CheckpointNode على المضيف نفسه الذي يعمل عليه NameNode، إذ متطلبات الذاكرة الخاصة به مطابقة لمتطلبات NameNode. فهو ينزّل ملفّ نقطة التفتيش والمجلّة الحاليّين من NameNode، ويدمجهما محلّيًّا، ثمّ يعيد نقطة التفتيش الجديدة إلى NameNode.
إنّ إنشاء نقاط تفتيش دورية إحدى وسائل حماية البيانات الوصفية لنظام الملفات. فإذا لم تعد كلّ النسخ الدائمة الأخرى لصورة مساحة الأسماء أو للمجلّة متاحة،ikkan يمكن للنظام أن يبدأ من أحدث نقطة تفتيش. ويتيح إنشاء نقطة التفتيش أيضًا لـ NameNode اقتطاع (truncate) المجلّة حين تُرفَع نقطة التفتيش الجديدة إليه. وتعمل عناقيد HDFS لفترات طويلة دون إعادة تشغيل، وخلالها ينمو المجلّة باستمرار. فإذا منى المجلّة كثيرًا جدًّا، ازداد احتمال فقدان ملفّ المجلّة أو تلفه. كما أنّ المجلّة الكبير جدًّا يطيل الوقت اللازم لإعادة تشغيل NameNode. وفي العنقود الكبير، تستغرق معالجة مجلّة تغطّي أسبوعًا ساعةً كاملة. والممارسة الجيّدة هي إنشاء نقطة تفتيش يومية.
8.2.6. BackupNode
من الميزات التي أُدخلت حديثًا في HDFS هي BackupNode. فمثل CheckpointNode، يستطيع BackupNode إنشاء نقاط تفتيش دورية، لكنّه إضافةً إلى ذلك يحتفظ بصورة محدَّثة في الذاكرة لمساحة أسماء نظام الملفات، تبقى متزامنة دائمًا مع حالة NameNode.
يقبل BackupNode تدفّق المجلّة الخاصّ بمعاملات مساحة الأسماء من NameNode النشط، ويحفظه في مجلّة في مجلّدات تخزينه الخاصة، ويطبّق هذه المعاملات على صورته الخاصّة لمساحة الأسماء في الذاكرة. ويتعامل NameNode مع BackupNode بوصفه مخزن مجلّات، على نحو ما يتعامل مع ملفات المجلّة في مجلّدات تخزينه. فإذا تعطّل NameNode، فإنّ صورة BackupNode في الذاكرة ونقطة التفتيش الموجودة على القرص تمثّلان سجلًّا لأحدث حالة لمساحة الأسماء.
يستطيع BackupNode إنشاء نقطة تفتيش دون تنزيل ملفّات نقطة التفتيش والمجلّة من NameNode النشط، لأنّه يملك أصلًا صورة محدَّثة لمساحة الأسماء في ذاكرته. ويجعل هذا عمليّة نقطة التفتيش على BackupNode أكثر كفاءة، إذ لا يحتاج إلا إلى حفظ مساحة الأسماء في مجلّدات تخزينه المحلّية.
يمكن النظر إلى BackupNode بوصفه NameNode للقراءة فقط. فهو يحوي كلّ معلومات البيانات الوصفية لنظام الملفات باستثناء مواضع الكتل. ويستطيع تنفيذ جميع عمليات NameNode العاديّة التي لا تتضمّن تعديل مساحة الأسماء ولا تتطلّب معرفة مواضع الكتل. ويمنح استخدام BackupNode خيار تشغيل NameNode دون تخزين دائم، مع إسناد مسؤولية حفظ حالة مساحة الأسماء إلى BackupNode.
8.2.7. الترقيات ولقطات نظام الملفات
أثناء ترقيات البرمجيات، يزداد احتمال تلف نظام الملفات بسبب أخطاء برمجية أو أخطاء بشرية. والهدف من إنشاء اللقطات (snapshots) في HDFS هو تقليل الضرر المحتمل للبيانات المخزَّنة في النظام أثناء الترقيات.
تتيح آلية اللقطة للمديرين حفظ الحالة الحاليّة لنظام الملفات بشكل دائم، بحيث إن أدّت الترقية إلى فقدان بيانات أو تلفها، أمكن التراجع عن الترقية وإعادة HDFS إلى مساحة الأسماء وحالة التخزين كما كانا وقت أخذ اللقطة.
تُنشأ اللقطة (ولا يمكن أن توجد سوى لقطة واحدة) بناءً على خيار مدير العنقود كلّما بُدِئ تشغيل النظام. فإذا طُلبت لقطة، فإنّ NameNode يقرأ أوّلًا ملفّات نقطة التفتيش والمجلّة ويدمجها في الذاكرة. ثمّ يكتب نقطة التفتيش الجديدة والمجلّة الفارغة إلى موضع جديد، بحيث تبقى نقطة التفتيش والمجلّة القديمتان دون تغيير.
أثناء المصافحة، يوجّه NameNode إلى DataNodes ما إذا كان ينبغي إنشاء لقطة محلّية أم لا. ولا يمكن إنشاء اللقطة المحلّية على DataNode عبر نسخ المجلّدات الحاوية لملفات البيانات، لأنّ ذلك سيتطلّب مضاعفة السعة التخزينية لكلّ DataNode في العنقود. وبدلًا من ذلك، ينشئ كلّ DataNode نسخة من مجلّد التخزين ويربط فيها ملفات الكتل الموجودة عبر روابط صلبة (hard links). وحذف DataNode لكتلة يعني حذف الرابط الصلب فقط، أمّا تعديلات الكتل أثناء الإلحاق فتستخدم تقنية الكتابة عند النسخ (copy-on-write). وبذلك تبقى نسخ الكتل القديمة سليمةً في مجلّداتها القديمة.
يستطيع مدير العنقود أن يختار التراجع عن حالة HDFS إلى حالة اللقطة عند إعادة تشغيل النظام. فيستعيد NameNode نقطة التفتيش التي حُفظت عند إنشاء اللقطة. وتستعيد DataNodes المجلّدات التي أُعيدت تسميتها سابقًا، وتبدأ عملية في الخلفية لحذف نسخ الكتل التي أُنشئت بعد أخذ اللقطة. وبعد أن اخترنا التراجع، لا يوجد أيّ آلية للتجاوز إلى الأمام. ويستطيع مدير العنقود استعادة المساحة التي يشغلها محتوى اللقطة بأن يأمر النظام بالتخلي عن اللقطة؛ بالنسبة إلى اللقطات التي أُخذت أثناء ترقية، فإنّ هذا يُنهي الترقية البرمجية.
قد يؤدّي تطوّر النظام إلى تغيير في تنسيق ملفّات نقطة التفتيش والمجلّة لدى NameNode، أو في تمثيل البيانات في ملفّات نسخ الكتل لدى DataNodes. وتحدّد إصدار التخطيط (layout version) صيغ تمثيل البيانات، ويُخزَّن بشكل دائم في مجلّدات تخزين NameNode وDataNodes. وأثناء بدء التشغيل، تقارن كلّ عقدة إصدار تخطيط البرمجية الحاليّة بالإصدار المخزَّن في مجلّدات تخزينها، وتحوّل البيانات تلقائيًّا من الصيغ الأقدم إلى الصيغ الأحدث. ويتطلّب هذا التحويل إنشاء لقطة إلزامية حين يعيد النظام تشغيله بإصدار تخطيط برمجية جديد.
8.3. عمليات إدخال/إخراج الملفات وإدارة النسخ المكرّرة
طبعيًّا، فإنّ الغرض كلّه من نظام الملفات هو تخزين البيانات في ملفات. ولنفهم كيف يفعل HDFS ذلك، علينا النظر في كيفية عمل القراءة والكتابة، وفي كيفية إدارة الكتل.
8.3.1. قراءة الملفات وكتابتها
يضيف التطبيق بيانات إلى HDFS بأن ينشئ ملفًّا جديدًا ويكتب البيانات فيه. وبعد إغلاق الملف، لا يمكن تغيير البايتات المكتوبة أو حذفها، إلا بأنّه من الممكن إضافة بيانات جديدة إلى الملف بإعادة فتحه للإلحاق. وينفّذ HDFS نموذج «كاتب واحد، وقّراء متعدّدون» (single-writer, multiple-reader).
يُمنح عميل HDFS الذي يفتح ملفًّا للكتابة إيجازًا (lease) على ذلك الملف، فلا يستطيع أيّ عميل آخر الكتابة إليه. ويجدّد عميل الكتابة الإيجاز دوريًّا بإرسال نبضة قلب إلى NameNode. وحين يُغلق الملف، يُلغى الإيجاز. وتحدّدت مدة الإيجاز بحدّ لين (soft limit) وحدّ قاسٍ (hard limit). فحتّى ينتهي الحدّ اللين، يتيقّن الكاتب من أنّ له وصولًا حصريًّا إلى الملف. أمّا إذا انتهى الحدّ اللين ولم ينجح العميل في إغلاق الملف أو تجديد الإيجاز، فيستطيع عميل آخر انتزاع الإيجاز. أمّا إذا انتهى الحدّ القاسٍ (ساعة واحدة) ولم ينجح العميل في تجديد الإيجاز، فإنّ HDFS يفترض أنّ العميل قد انسحب، ويغلق الملف تلقائيًّا نيابةً عن الكاتب ويستعيد الإيجاز. ولا يمنع إيجاز الكاتب عملاء آخرين من قراءة الملف؛ إذ قد يكون للملف قرّاء متعدّدون على التوازي.
يتألّف ملفّ HDFS من كتل. وحين تظهر الحاجة إلى كتلة جديدة، يخصيص NameNode كتلة بمعرّف كتلة فريد ويحدّد قائمة DataNodes تستضيف نسخها. وتُشكّل DataNodes خطّ أنابيب، يكون ترتيبه بحيث يُصغّر مجموع مسافة الشبكة من العميل إلى آخر DataNode في الخطّ. وتُدفع البايتات إلى خطّ الأنابيب على هيئة تسلسل من الحِزَم (packets). أمّا البايتات التي يكتبها التطبيق أوّلًا فتُخزَّن مؤقّتًا عند العميل. وبعد امتلاء مخزن الحزمة (عادةً 64 كيلوبايت)، تُدفع البيانات إلى خطّ الأنابيب. ويمكن دفع الحزمة التالية إلى خطّ الأنابيب قبل تسلّم إيذاك الحزم السابقة. ويحدّ حجم نافذة الحزم المعلّقة عند العميل من عدد الحزم المعلّقة.
بعد كتابة البيانات في ملفّ HDFS، لا يقدّم HDFS أيّ ضمان بأنّ البيانات ستكون مرئية لقارئ جديد قبل إغلاق الملف. فإذا احتاج تطبيق المستخدم إلى هذا الضمان، فيستطيع أن يستدعي صراحةً عملية hflush. عندئذٍ تُدفع الحزمة الحالية فورًا إلى خطّ الأنابيب، وتنتظر عملية hflush حتى إيذاك جميع DataNodes في الخطّ بنجاح الإرسال. وعندئذٍ نكون على يقين من أنّ جميع البيانات المكتوبة قبل عملية hflush أصبحت مرئية للقرّاء.
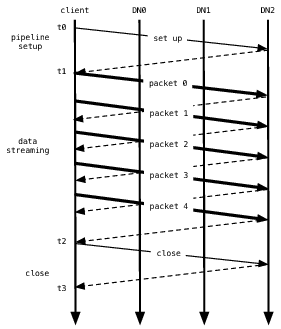
الشكل 8.2: خطّ أنابيب البيانات أثناء كتابة كتلة
إذا لم يحدث أيّ خطأ، فإنّ بناء الكتلة يمرّ بثلاث مراحل كما هو مبيَّن في الشكل 8.2، ويوضّح ذلك خطّ أنابيب من ثلاث DataNodes (DN) وكتلة من خمس حِزَم. وفي الصورة، تمثّل الخطوط الغامقة حِزَم البيانات، والخطوط المتقطّعة رسائل الإيذاك، والخطوط الرفيعة رسائل التحكّم في إعداد خطّ الأنابيب وإغلاقه. وتمثّل الخطوط الرأسية النشاط عند العميل وعند DataNodes الثلاثة، حيث يتقدّم الزمن من الأعلى إلى الأسفل.isms frente من t0 إلى t1 هي مرحلة إعداد خطّ الأنابيب. أمّا الفترة من t1 إلى t2 فهي مرحلة بثّ البيانات، حيث t1 هو الوقت الذي تُرسَل فيه أول حزمة بيانات وt2 هو الوقت الذي يُستلم فيه إيذاك آخر حزمة. وهنا تنقل عملية hflush الحزمة packet 2. ويصاحب تنبيه hflush بيانات الحزمة ولا يُعدّ عملية منفصلة. أمّا الفترة الأخيرة من t2 إلى t3 فهي مرحلة إغلاق خطّ الأنابيب لهذه الكتلة.
في عنقود يتألّف من آلاف العقد، تكون أعطال العقد (وأكثرها شيوعًا أعطال التخزين) أمرًا يوميًّا. وقد تتلف النسخة المخزَّنة على DataNode بسبب أعطال في الذاكرة أو القرص أو الشبكة. ويولّد HDFS مجاميع تحقّق (checksums) لكلّ كتلة بيانات في ملفّ HDFS ويخزّنها. وتتحقّق منها عميل HDFS أثناء القراءة، ليساعد ذلك في كشف أيّ تلف ينشأ عن العميل أو DataNodes أو الشبكة. وحين ينشئ العميل ملفّ HDFS، فإنّه يحسب تسلسل مجاميع التحقّق لكلّ كتلة ويرسله إلى DataNode مع البيانات. ويخزّن DataNode مجاميع التحقّق في ملفّ بيانات وصفية منفصل عن ملفّ بيانات الكتلة. وحين يقرأ HDFS ملفًّا، تُشحن بيانات كلّ كتلة ومجاميع تحقّقها إلى العميل. فيحسب العميل مجموع التحقّق للبيانات المستلَمة ويتحقّق من أنّ مجاميع التحقّق المحسوبة حديثًا تطابق المجاميع التي استلمها. فإن لم تتطابق، يُبلّغ العميل NameNode بأنّ النسخة تالفة، ثمّ يجلب نسخة أخرى من الكتلة من DataNode آخر.
حين يفتح العميل ملفًّا للقراءة، فإنّه يجلب من NameNode قائمة الكتل ومواضع كلّ نسخة كتلة. وتُرتَّب مواضع كلّ كتلة حسب مسافتها عن القارئ. وحين يقرأ محتوى كتلة، يجرّب العميل أقرب نسخة أولًا. فإذا أخفقت محاولة القراءة، يجرّب العميل النسخة التالية بالتسلسل. وقد تفشل القراءة إذا كانت DataNode الهدف غير متاحة، أو إذا لم تعد العقدة تستضيف نسخة من الكتلة، أو إذا ثبت تلف النسخة عند اختبار مجاميع التحقّق.
يسمح HDFS للعميل بقراءة ملفّ مفتوح للكتابة. وعند قراءة ملفّ مفتوح للكتابة، لا يعرف NameNode طول الكتلة الأخيرة التي ما تزال قيد الكتابة. وفي هذه الحالة، يسأل العميل إحدى النسخ عن أحدث طول قبل بدء قراءة المحتوى.
صُمِّم إدخال/إخراج HDFS تحديدًا ليُحسَّن لأنظمة المعالجة على دفعات (batch processing) مثل MapReduce، التي تتطلّب إنتاجية عالية في القراءة والكتابة المتسلسلتين. وستُبذل جهود مستمرّة لتحسين زمن استجابة القراءة/الكتابة للتطبيقات التي تتطلّب بثّ بيانات فوريًّا (real-time) أو وصولًا عشوائيًّا.
8.3.2. موضع الكتل
في العنقود الكبير، قد لا يكون عمليًّا وصل كلّ العُقد في طوبولوجيا مسطّحة. ومن الممارسات الشائعة توزيع العُقد على عدّة رفوف (racks). تتشارك عقد الرفّ الواحد مفتاح تبديل (switch)، وترتبط مفاتيح تبديل الرفوف بمفاتيح تبديل أساسية (core switches) أو أكثر. ولا بدّ من أن يمرّ الاتصال بين عقدتين في رفوف مختلفين عبر عدّة مفاتيح تبديل. وفي معظم الحالات، يكون عرض نطاق الشبكة بين العُقد داخل الرفّ الواحد أكبر من عرض نطاق الشبكة بين العُقد في رفوف مختلفة. ويصف الشكل 8.3 عنقودًا من رفّين، في كلّ منهما ثلاث عقد.
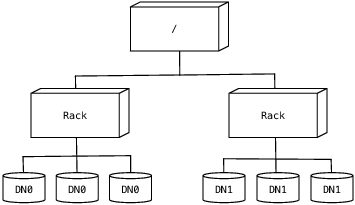
الشكل 8.3: طوبولوجيا العنقود
يقدّر HDFS عرض نطاق الشبكة بين عقدتين بواسطة المسافة بينهما. وتُفترض المسافة من العقدة إلى العقدة الأمّ مساويةً واحدًا. ويمكن حساب المسافة بين عقدتين بجمع المسافتين إلى أقرب سلف مشترك بينهما (closest common ancestor). كلّما قصُرت المسافة بين عقدتين، زاد عرض النطاق الذي يمكنهما استخدامه لنقل البيانات.
يسمح HDFS للمدير بتهيئة سكربت (script) يُعيد تعريف رفّ عقدة ما انطلاقًا من عنوانها. وNameNode هو المكان المركزي الذي يحلّ موقع كلّ DataNode من حيث الرفّ. وحين يسجّل DataNode نفسه لدى NameNode، ينفّذ NameNode السكربت المهيّأ ليقرّر أيّ رفّ تنتمي إليه العقدة. وإذا لم تكن هناك سكربتات مهيّأة من هذا النوع، فإنّ NameNode يفترض أنّ جميع العُقد تنتمي إلى رفّ افتراضيّ واحد.
إنّ موضع النسخ المكرّرة أمر حاسم في موثوقية بيانات HDFS وفي أداء القراءة/الكتابة. وينبغي لسياسة جيدة لوضع النسخ أن تحسّن موثوقية البيانات وتوافرها واستخدام عرض نطاق الشبكة. ويوفّر HDFS حاليًا واجهة قابلة للتهيئة لسياسة وضع الكتل، كي يتمكّن المستخدمون والباحثون من تجربة واختبار سياسات بديلة تكون مثلى لتطبيقاتهم.
تقدّم سياسة وضع كتل HDFS الافتراضيّة مقايضة بين تقليل تكاليف الكتابة، وتعظيم موثوقية البيانات وتوافرها وعرض نطاق القراءة الكلّي. وحين تُنشأ كتلة جديدة، يضع HDFS النسخة الأولى على العقدة التي يوجد عندها الكاتب. وتُوضع النسخة الثانية والثالثة على عقدتين مختلفتين في رفّ مختلف. وتُوضع البقية على عقد عشوائية مع القيود التالية: لا تُوضع أكثر من نسخة واحدة عند أيّ عقدة، ولا تُوضع أكثر من نسختين في الرفّ نفسه، إن أمكن. واختيار وضع النسخة الثانية والثالثة في رفّ مختلف يوزّع نسخ كتل الملفّ الواحد توزيعًا أفضل على العنقود كلّه. فإذا وُضعت النسختان الأوليان في الرفّ نفسه، فإنّ ثلثَي نسخ كتل أيّ ملفّ ستقع في الرفّ نفسه.
بعد اختيار جميع العقد الهدف، تُنظَّم العقد في خطّ أنابيب وفق ترتيب قُربها من النسخة الأولى. وتُدفع البيانات إلى العقد بهذا الترتيب. أمّا في القراءة، فإنّ NameNode يتحقّق أوّلًا ممّا إذا كانت عقدة العميل موجودة داخل العنقود. فإن كانت كذلك، تُعاد مواضع الكتل إلى العميل وفق ترتيب قُربها من القارئ. وتُقرأ الكتلة من DataNodes وفق هذا الترتيب المفضّل.
تقلّل هذه السياسة حركة الكتابة بين الرفوف وبين العُقد، وتحسّن أداء الكتابة عمومًا. ولأنّ احتمال تعطّل رفّ أقلّ بكثير من احتمال تعطّل عقدة، فإنّ هذه السياسة لا تمسّ بضمانات موثوقية البيانات وتوافرها. وفي الحالة المعتادة من ثلاث نسخ، يمكنها أن تقلّل عرض نطاق الشبكة الكلّي المستخدَم في قراءة البيانات، إذ تُوضَع الكتلة في رفّين فريدين فقط لا ثلاثة.
8.3.3. إدارة النسخ المكرّرة
يسعى NameNode إلى ضمان أنّ لكلّ كتلة العدد المقصود من النسخ دائمًا. ويكتشف NameNode أنّ كتلة أصبحت ناقصة التكرار أو زائدة عنه حين يصله تقرير كتلة من DataNode. وحين تصبح الكتلة زائدة التكرار، يختار NameNode نسخة لحذفها. ويفضّل NameNode ألّا يقلّل عدد الرفوف التي تستضيف النسخ، ثمّ يفضّل، ثانيًا، حذف النسخة من DataNode التي تملك أقلّ قدر متاح من مساحة القرص. والهدف هو موازنة استخدام التخزين عبر DataNodes من دون تقليص توافر الكتلة.
حين تصبح الكتلة ناقصة التكرار، توضع في طابور أولويات النسخ. فالكتلة التي ليس لها سوى نسخة واحدة لها أعلى أولوية، بينما الكتلة التي يتجاوز عدد نسخها ثلثَي عامل تكرارها لها أدنى أولوية. ويفحص خيط في الخلفية رأس طابور النسخ دوريًّا ليقرّر أين توضع النسخ الجديدة. وتتبع نسخ الكتل سياسة مشابهة لتلك المستخدمة في وضع الكتل الجديدة. فإذا كان عدد النسخ القائمة واحدًا، يضع HDFS النسخة التالية في رفّ مختلف. أمّا إذا كانت للكتلة نسختان قائمتان، فإذا كانتا في الرفّ نفسه وُضعت النسخة الثالثة في رفّ مختلف؛ وإلا وُضعت النسخة الثالثة في عقدة مختلفة ضمن الرفّ نفسه الذي توجد فيه إحدى النسختين القائمتين. والهدف هنا هو تقليل تكاليف إنشاء النسخ الجديدة.
يتأكّد NameNode أيضًا من ألّا تكون جميع نسخ الكتلة موجودة في رفّ واحد. فإذا اكتشف NameNode أنّ نسخ كتلة ما انتهت إلى رفّ واحد، فإنّه يعتبر الكتلة موضوعة في غير موضعها (mis-replicated) وينسخها إلى رفّ مختلف مستخدمًا سياسة وضع الكتل نفسها الموصوفة أعلاه. وبعد أن يتلقّى NameNode إشعارًا بأنّ النسخة أُنشئت، تصبح الكتلة زائدة التكرار. وعندئذٍ يقرّر NameNode حذف نسخة قديمة، لأنّ سياسة زيادة التكرار تفضّل ألّا يقلّل عدد الرفوف.
8.3.4. الموازِن
لا تراعي استراتيجية وضع كتل HDFS استهلاك مساحة أقراص DataNode. وذلك تجنّبًا لوضع بيانات جديدة — وهي بيانات يُرجَّح أكثر أن تُستشهد بها — على مجموعة فرعية صغيرة من DataNodes تملك مساحة تخزين شاغرة كبيرة. لذلك، قد لا تتوزّع البيانات بالتساوي دائمًا على DataNodes. كما يظهر اختلال التوازن عند إضافة عقد جديدة إلى العنقود.
الموازِن (balancer) أداة توازن استهلاك مساحة القرص على عنقود HDFS. وهو يأخذ قيمة عتبة (threshold) معاملًا إدخاليًّا، وهي كسر بين 0 و1. يكون العنقود متوازنًا إذا كانت، لكلّ DataNode، نسبة استخدام العقدة[3] لا تختلف عن نسبة استخدام العنقود كلّه[4] بأكثر من قيمة العتبة.
يُنشر هذا الأداء بوصفه برنامج تطبيقٍ يمكن لمدير العنقود تشغيله. وهو ينقل النسخ تكراريًّا من DataNodes ذات الاستخدام المرتفع إلى DataNodes ذات الاستخدام المنخفض. ومن المتطلّبات الأساسية للموازِن الحفاظ على توافر البيانات. وحين يختار نسخة لنقلها ويقرّر وجهتها، يضمن الموازِن ألّا يؤدّي هذا القرار إلى تقليل عدد النسخ ولا عدد الرفوف.
يُحسِّن الموازِن عملية الموازنة عبر تقليل نسخ البيانات بين الرفوف. فإذا قرّر الموازِن أنّ النسخة A تحتاج إلى النقل إلى رفّ مختلف، وحدثت المصادفة أنّ رفّ الوجهة يحتوي على نسخة B من الكتلة نفسها، فإنّ البيانات ستُنسخ من النسخة B بدلًا من النسخة A.
There تحدّ معامل تهيئة (configuration parameter) عرض نطاق النطاق الذي تستهلكه عمليات إعادة الموازنة. وكلّما كان عرض النطاق المسموح به أكبر، اتّسع العنقود إلى حالة التوازن أسرع، لكنّها زادت المنافسة مع عمليات التطبيقات.
8.3.5. ماسح الكتل
يشغّل كلّ DataNode ماسح كتل (block scanner) يفحص نسخ كتله دوريًّا ويتحقّق من أنّ مجاميع التحقّق المخزَّنة تطابق بيانات الكتل. وفي كلّ فترة فحص، يضبط الماسح عرض نطاق القراءة كي يتمكّن من إتمام التحقّق خلال فترة قابلة للتهيئة. فإذا قرأ عميل كتلة كاملة ونجح التحقّق من مجموع التحقّق، فإنه يُعلم DataNode. ويعامل DataNode ذلك بوصفه تحقّقًا من النسخة.
يُخزَّن زمن التحقّق من كلّ كتلة في ملفّ سجلّ قابل للقراءة من قِبل الإنسان (human-readable). وفي أيّ لحظة، توجد في مجلّد DataNode الرئيسيّ حتى ملفّين: ملفّ السجلّ الحاليّ والملفّ السابق له. وتُلحَق أزمنة التحقّق الجديدة بالملفّ الحاليّ. وعلى نحو مقابل، يملك كلّ DataNode قائمة فحص في الذاكرة مرتّبة بحسب زمن التحقّق لكلّ نسخة.
كلّما اكتشف عميل قراءة أو ماسح كتل كتلة تالفة، يُبلّغ NameNode. ويضع NameNode علامة على النسخة بأنّها تالفة، لكنّه لا يجدول حذفها فورًا. وبدلًا من ذلك، يبدأ إنشاء نسخة سليمة من الكتلة. ولا تُجدوَل حذف النسخة التالفة إلا حين يبلغ عدد النسخ السليمة عامل تكرار الكتلة. وتستهدف هذه السياسة الحفاظ على البيانات لأطول مدّة ممكنة. لذلك، حتى لو تلفت جميع نسخ كتلة ما، فإنّ السياسة تسمح للمستخدم باسترجاع بياناتها من النسخ التالفة.
8.3.6. إخراج العقد من الخدمة (Decommissioning)
يحدّد مدير العنقود قائمة العُقد التي ستُخرَج من الخدمة. وبعد أن تُعلَّم DataNode بأنّها مخصّصة للإخراج من الخدمة، لن تُختار كوجهة لوضع النسخ، لكنّها ستظلّ تخدم طلبات القراءة. ويبدأ NameNode بجدولة نسخ كتلها إلى DataNodes أخرى. وبعد أن يكتشف NameNode أنّ جميع الكتل الموجودة على DataNode قيد الإخراج قد نُسخت، تدخل العقدة في حالة «مُخرَجة من الخدمة». وعندئذٍ يمكن إزالتها من العنقود بأمان من دون تعريض أيّ بيانات للخطر.
8.3.7. نسخ البيانات بين العناقيد
عند العمل مع مجموعات بيانات ضخمة، يكون نسخ البيانات إلى عنقود HDFS وإخراجه منه مهمةً شاقة. ويوفّر HDFS أداة تُسمّى DistCp للنسخ المتوازي على نطاق واسع داخل العنقود وخارجه. وهي مهمة MapReduce؛ تنسخ كلّ من مهام map جزءًا من البيانات المصدرية إلى نظام الملفات الوجهة. ويتولّى إطار عمل MapReduce تلقائيًّا جدولة المهامّ المتوازية وكشف الأخطاء والتعافي منها.
8.4. الممارسة في Yahoo!
تضمّ عناقيد HDFS الكبيرة في Yahoo! نحو 4000 عقدة. تتضمّن العقدة النموذجية في العنقود معالجَي Xeon رباعيّ النواة يعملان بتردّد 2.5 غيغاهرتز، و4–12 قرص SATA موصولًا مباشرةً (كلّ منها يسع تيرابايتين)، و24 غيغابايت من الذاكرة العشوائية، واتصال إيثرنت بسرعة 1 غيغابت. ويُخصَّص سبعون بالمئة من مساحة القرص لـ HDFS. أمّا الباقي فيُحجَز لنظام التشغيل (Red Hat Linux)، والسجلّات، والمساحة الفارغة لتفريغ مخرجات مهام map (فإنّ البيانات الوسيطة لـ MapReduce لا تُخزَّن في HDFS).
تتشارك أربعون عقدةً في رفّ واحد مفتاح تبديل IP. وترتبط مفاتيح تبديل الرفوف بكلّ واحد من ثمانية مفاتيح تبديل أساسية. وتوفّر مفاتيح التبديل الأساسية الاتصال بين الرفوف ومع الموارد خارج العنقود. وفي كلّ عنقود، تكون مضيفي NameNode وBackupNode مجهَّزين على وجه الخصوص بما يصل إلى 64 غيغابايت من الذاكرة العشوائية؛ ولا تُسنَد مهامّ التطبيقات إلى هذين المضيفين إطلاقًا. وفي المجموع، يتوفّر في عنقود من 4000 عقدة ما مقداره 11 بيتابايت (بيتا؛ 1000 تيرابايت) من التخزين المتاح ككتلات تُنسَّخ ثلاث مرّات، ممّا ينتج صافيًا 3.7 بيتابايت من التخزين لتطبيقات المستخدم. وخلال السنوات التي استُخدم فيها HDFS، استفاد المضيفات المختارة كعقد عناقيد من التحسّنات التقنية. فالعقد الجديدة في العنقود تملك دائمًا معالجات أسرع وأقراصًا أكبر وذاكرة عشوائية أوفر. أمّا العُقد الأبطأ والأصغر فتُسحب من الخدمة أو تُخصَّص للعناقيد المحجوزة لتطوير Hadoop واختباره.
في عنقود كبير نموذجيّ (4000 عقدة)، توجد نحو 65 مليون ملفّ و80 مليون كتلة. وبما أنّ كلّ كتلة تُنسَّخ عادةً ثلاث مرّات، تستضيف كلّ عقدة بيانات 60 000 نسخة كتلة. ويوميًا، ستنشئ تطبيقات المستخدم ملفّين جديدين على العنقود — أي مليونَي ملفّ. وتوفّر العقد الـ 40 000 في عناقيد Hadoop لدى Yahoo! تخزينًا متّصلًا (on-line) بسعة 40 بيتابايت.
أصبح HDFS مكوّنًا رئيسيًّا في حزمة تقنيات Yahoo!، ما يعني التصدّي للمشكلات التقنية التي تفصل بين مشروع بحثي وبين أن يكون وصيًّا على بيتابايتات من بيانات الشركة. وأبرز هذه المشكلات مسألة متانة البيانات (robustness) وديمومتها. لكنّ الأداء الاقتصادي، وتهيئة المشاركة في الموارد بين أعضاء مجتمع المستخدم، وسهولة الإدارة من قِبل مشغّلي النظام لا تقلّ أهمية.
8.4.1. ديمومة البيانات
النسخ ثلاث مرّات أداة متينة تحمي البيانات من الفقدان الناتج عن أعطال العُقد غير المرتبطة ببعضها. ومن المستبعد تمامًا أن يكون Yahoo! قد فقد كتلةً بهذه الطريقة؛ فبالنسبة إلى عنقود كبير، تقلّ احتمال فقدان كتلة في السنة الواحدة عن 0.005. والفهم المفتاح هنا هو أنّ نحو 0.8 بالمئة من العُقد تتعطّل كلّ شهر. (حتى إذا استُعيدت العقدة لاحقًا، لا يُبذل أيّ جهد لاسترجاع البيانات التي كانت قد استضافتها.) لذلك، في العنقود الكبير النموذجي الموصوف أعلاه، تُفقد عقدة أو عقدتان يوميًا. ويعيد العنقود نفسه إنشاء نسخ الكتل الـ 60 000 التي كانت تستضيفها العقدة المتعطّلة في نحو دقيقتين: فالنسخ من جديد سريع لأنّه مسألة متوازية تتوسّع مع حجم العنقود. احتمال أن تتعطّل عدّة عقد خلال دقيقتين بحيث تضيع جميع نسخ كتلة ما هو احتمال صغير فعلًا.
يعتبر تعطّل العُقد المترابط (correlated failure) تهديدًا مختلفًا. والخلل الأكثر شيوعًا في هذا الصدد هو تعطّل رفّ أو مفتاح تبديل أساسي. ويستطيع HDFS تحمّل فقدان مفتاح تبديل رفّ (فلكلّ كتلة نسخة على رفّ آخر). أمّا بعض أعطال مفاتيح التبديل الأساسية فقد تفصل فعليًّا شريحة من العنقود عن عدّة رفوف، وعندئذٍ يُحتمل أن تصبح بعض الكتل غير متاحة. وفي الحالتين، فإنّ إصلاح مفتاح التبديل يعيد النسخ غير المتاحة إلى العنقود. ومن أنواع التعطّل المترابط أخرى فقدان التغذية الكهربائية للعنقود عن طريق الخطأ أو عن قصد. فإذا امتدّ فقدان الطاقة عبر عدّة رفوف، ف يُحتمل أن تصبح بعض الكتل غير متاحة. لكنّ استعادة الطاقة قد لا تكون علاجًا، لأنّ نصف العُقد إلى واحد بالمئة لن تنجو من إعادة تشغيل كاملة بعد عودة التيار. وإحصائيًّا وعمليًّا، سيفقد العنقود الكبير حفنة من الكتل أثناء إعادة التشغيل بعد عودة التيار.
إلى جانب الأعطال الكاملة للعُقد، قد تتلف البيانات المخزَّنة أو تُفقد. ويفحص ماسح الكتل جميع الكتل في العنقود الكبير كلّ أسبوعين، ويجد في أثناء ذلك نحو 20 نسخة تالفة. وتُستبدَل النسخ التالفة فور اكتشافها.
8.4.2. ميزات لمشاركة HDFS
مع نموّ استخدام HDFS، اضطرّ نظام الملفات نفسه إلى اتّخاذ وسائل لمشاركة المورد مع عدد كبير ومتنوّع من المستخدمين. وكانت أولى هذه الميزات إطار أذونات (permissions framework) مصمَّمًا إلى حدٍّ بعيد على أساس نظام أذونات Unix للملفات والمجلّدات. وفي هذا الإطار، تملك الملفات والمجلّدات أذونات وصول منفصلة للمالك، ولبقية أعضاء مجموعة المستخدم المرتبطة بالملفّ أو المجلّد، ولكلّ المستخدمين الآخرين. أمّا الفروق الجوهرية بين Unix (POSIX) وHDFS فهي أنّ الملفات العاديّة في HDFS لا تملك لا أذونات تنفيذ ولا بتات لاصقة (sticky bits).
في الإصدار الأقدم من HDFS، كانت هوية المستخدم ضعيفة: كنتَ من تقول إنّه أنت. وعند الوصول إلى HDFS، كان عميل التطبيق يستعلم نظام التشغيل المحلّي عن هوية المستخدم وانتمائه إلى المجموعات. وفي الإطار الجديد، على عميل التطبيق أن يقدّم لنظام الأسماء بيانات اعتماد (credentials) مكتسبةً من مصدر موثوق. وهناك إمكانيات متعدّدة لإدارة بيانات الاعتماد؛ والتنفيذ الأوّلي يستخدم Kerberos. ويستطيع تطبيق المستخدم استعمال الإطار نفسه للتأكّد من أنّ لنظام الأسماء هوية موثوقة كذلك. ويستطيع نظام الأسماء بدوره أن يطلب بيانات اعتماد من كلّ عقدة بيانات تشارك في العنقود.
تُحدَّد المساحة الكلّية المتاحة لتخزين البيانات بعدد عقد البيانات وبسعة التخزين المهيّأة لكلّ عقدة. وأظهرت الخبرة الأولى مع HDFS الحاجة إلى وسيلة ما لفرض سياسة تخصيص الموارد عبر مجتمعات المستخدمين. فليس إنصاف المشاركة فحسب هو ما يجب فرضه، بل إنّ حماية التطبيقات من استنزاف الموارد عن غير قصد مهمّة أيضًا، إذ قد تكون تطبيقات المستخدم مشغولة بعشرات الآلاف من المضيفات وهي تكتب البيانات. بالنسبة إلى HDFS، ولأنّ البيانات الوصفية للنظام محفوظة دائمًا في الذاكرة العشوائية، فإنّ حجم مساحة الأسماء (عدد الملفات والمجلّدات) موردٌ منتهٍ أيضًا. ولإدارة موردي التخزين ومساحة الأسماء، يمكن تعيين حصة (quota) لكلّ مجلّد تمثّل المساحة الكلّية التي تشغلها الملفات في الشجرة الفرعية لمساحة الأسماء التي تبدأ عند ذلك المجلّد. كما يمكن تعيين حصة منفصلة للعدد الكلّي للملفات والمجلّدات في تلك الشجرة الفرعية.
بينما تفترض معمارية HDFS أنّ معظم التطبيقات ستبثّ مجموعات بيانات كبيرة كمدخلات، فإنّ إطار عمل البرمجة MapReduce قد يميل إلى إنتاج كثير من ملفات الإخراج الصغيرة (ملف من كلّ مهمة reduce)، ممّا يزيد الضغط على مورد مساحة الأسماء. ولتيسير ذلك، يمكن طيّ شجرة مجلّدات في ملفّ Hadoop Archive واحد (HAR). وملفّ HAR شبيه بملفات tar أو JAR أو Zip المألوفة، لكنّ عمليات نظام الملفات يمكنها استهداف الملفات المفردة داخل الأرشيف، ويمكن استعمال ملفّ HAR بشفافية بوصفه مدخلًا لمهمة MapReduce.
8.4.3. التوسّع واتحاد HDFS
كان التوسّع في NameNode صراعًا رئيسيًّا Shv10. ولأنّ NameNode يحتفظ بمساحة الأسماء كلّها ومواضع الكتل في الذاكرة، فإنّ حجم كومة NameNode (heap) يحدّ من عدد الملفات، وكذلك من عدد الكتل التي يمكن معالجتها. وهذا يحدّ أيضًا من إجمالي تخزين العنقود الذي يمكن لـ NameNode دعمه. ويُشجَّع المستخدمون على إنشاء ملفات أكبر، لكنّ ذلك لم يحدث لأنّه يتطلّب تغييرات في سلوك التطبيقات. وفوق ذلك، نرى أصنافًا جديدة من تطبيقات HDFS تحتاج إلى تخزين عدد كبير من الملفات الصغيرة. وقد أُضيفت الحصص لإدارة الاستخدام، وأُتيحت أداة أرشفة، لكنّ هذين الإجراءين لا يعالجان مشكلة التوسّع جذريًّا.
تتيح ميزة جديدة لمساحات أسماء متعدّدة ومستقلّة (وNameNodes متعدّدة) أن تتشارك التخزين الماديّ داخل العنقود. وتستخدم مساحات الأسماء كتلًا مُجمَّعة تحت مجموعة كتل (Block Pool). ومجموعات الكتل تشبه الوحدات المنطقية (LUNs) في أنظمة تخزين SAN، كما أنّ مساحة أسماء مع مجموعة كتلها تشبه حجماً (volume) في نظام ملفات.
يقدّم هذا النهج عددًا من المزايا إلى جانب قابلية التوسّع: فهو يتيح عزل مساحات أسماء التطبيقات المختلفة، ومن ثمّ تحسين التوافر العامّ للعنقود. وتتيح تجريد مجموعة الكتل لخدمات أخرى استعمال تخزين الكتل ببنية مساحات أسماء مختلفة ربّما. ونخطّط لاستكشاف سبل أخرى للتوسّع، مثل تخزين جزء فقط من مساحة الأسماء في الذاكرة، وتنفيذ موزّع فعلّي لـ NameNode.
تفضّل التطبيقات على الاستمرار في استعمال مساحة أسماء واحدة. ويمكن تثبيت (mount) مساحات الأسماء لتوليد هذه الصورة الموحّدة. وتوفّر جدول التحميل (mount table) عند العميل وسيلةً فعّالة للقيام بذلك مقارنةً بجدول تحميل في جهة الخادم: فهو يتجنّب استدعاء RPC إلى جدول التحميل المركزيّ ويتحمّل أعطاله أيضًا. وأبسط منهج هو وجود مساحة أسماء واحدة مشتركة على مستوى العنقود كلّه؛ ويمكن تحقيق ذلك بمنح كلّ عميل في العنقود جدول التحميل نفسه الموجود عند العميل. كما تتيح جداول التحميل عند العميل للتطبيقات إنشاء صورة خاصة لمساحة الأسماء. وهذا يشبه مساحات الأسماء لكلّ عملية (per-process namespaces) المستخدَمة للتعامل مع التنفيذ البعيد في الأنظمة الموزّعة [PPT+93, Rad94, RP93].
8.5. الدروس المستفادة
تمكّن فريقٌ صغير جدًّا من بناء نظام ملفات Hadoop وجعله مستقرًّا ومتّينًا بما يكفي لاستخدامه في الإنتاج. تميّزت المساهمة الأكبر في هذا النجاح ببساطة المعمارية الشديدة: كتل منسوخة، وتقارير كتل دورية، وخادم بيانات وصفية مركزي. كما ساعد التجنّب من الدلالات الكاملة لـ POSIX. فمع أنّ الاحتفاظ بجميع البيانات الوصفية في الذاكرة حدّ من قابلية توسّع مساحة الأسماء، إلا أنّه جعل NameNode بسيطًا جدًّا: فهو يتجنّب التعقيد الحاسم (locking) المعتاد في أنظمة الملفات. وكان السبب الآخر لنجاح Hadoop هو الاستخدام السريع للنظام في الإنتاج في Yahoo!، إذ حُسِّن بسرعة وعلى دفعات متزايدة. نظام الملفات متين جدًّا ونادرًا ما يتعطّل NameNode، غير أنّ معظم حالات التوقف سببها الترقيات البرمجية. ولم تظهر حلول التحوّل التلقائي (failover) — وإن كانت يدوية — إلا مؤخرًا.
كثيرون فوجئوا باختيار Java لبناء نظام ملفات قابل للتوسّع. وبينما كانت Java تمثّل تحدّيات أمام توسّع NameNode بسبب الحمل الزائد للذاكرة في الكائنات وجمع القمامة (garbage collection)، فإنّ Java كانت سببًا في متانة النظام؛ فهي تجنّبت التلف الناتج عن أخطاء المؤشّرات أو إدارة الذاكرة.
8.6. شكر وتقدير
نشكر Yahoo! على استثمارها في Hadoop وعلى مواصلتها إتاحته بوصفه مصدرًا مفتوحًا؛ فقد طُوِّر 80% من شيفرة HDFS وMapReduce في Yahoo! ونشكر جميع المساهمين والمتعاونين في Hadoop على مساهماتهم القيّمة.
الحواشي
http://hadoop.apache.orghttp://www.lustre.org- تُعرَّف بأنّها نسبة المساحة المستخدَمة عند العقدة إلى السعة الكلّية للعقدة.
- تُعرَّف بأنّها نسبة المساحة المستخدَمة في العنقود إلى السعة الكلّية للعنقود.