Graphite
معمارية تطبيقات المصادر المفتوحة (المجلد الأول)Graphite
معمارية تطبيقات المصادر المفتوحة (المجلد الأول) Graphite
Chris Davis
إذا استمتعت بهذه الكتب، فقد يعجبك أيضًا التصميم البرمجي بالأمثلة في بايثون (Software Design by Example in Python) والتصميم البرمجي بالأمثلة في جافاسكربت (Software Design by Example in JavaScript).
يؤدي Graphite[1] مهمّتين بسيطتين إلى حدٍّ كبير: تخزين أرقام تتغيّر مع الزمن، ورسمها بيانيًّا. وقد كُتبت على مدى السنين برمجيات كثيرة جدًّا تؤدّي المهمّتين نفسيهما. أمّا ما يجعل Graphite فريدًا فهو أنّه يقدّم هذه الوظائف بوصفها خدمةً شبكية (network service) سهلة الاستخدام، وقابلة للتوسّع إلى درجة عالية. وبروتوكول تغذية Graphite بالبيانات بسيط إلى حدّ يكفي لتتعلّم كتابته يدويًّا في بضع دقائق (وليس وكأنّك ستفعل ذلك عن طيب خاطر، لكنّه اختبار عملي جيّد لمدى البساطة). أمّا رسم الرسوم البيانية واسترجاع نقاط البيانات فكأنّك تجلب عنوان URL فحسب. وهذا يجعل دمج Graphite مع بقية البرمجيات أمرًا طبيعيًّا إلى حدٍّ كبير، ويتيح للمستخدمين بناء تطبيقات قويّة فوق Graphite. ومن أكثر استخدامات Graphite شيوعًا بناء لوحات معلومات (dashboards) قائمة على الويب لأغراض المراقبة والتحليل. وقد وُلدت Graphite في بيئة تجارة إلكترونية (e-commerce) عالية الحجم، ويعكس تصميمُها هذه البيئة. أمّا قابلية التوسّع والوصول الفوري (real-time) إلى البيانات فهما الهدفان الأساسيان.
تشمل المكوّنات التي تمكّن Graphite من بلوغ هذه الأهداف مكتبةَ قواعد بيانات متخصّصة وصيغةَ تخزينها، وآليّةَ تخزين مؤقّت (caching) لتحسين عمليات الإدخال والإخراج (I/O)، وطريقةً بسيطة وفعّالة لتجميع خوادم Graphite في عناقيد (clustering). وبدلًا من أن أكتفي بوصف كيفية عمل Graphite اليوم، سأشرح كيف نُفِّذت Graphite في بدايتها (بصورة ساذجة إلى حدٍّ كبير)، وما هي المشكلات التي اصطدمتُ بها، وكيف توصّلت إلى حلول لها.
7.1. مكتبة قاعدة البيانات: تخزين بيانات السلاسل الزمنية
Graphite مكتوبة بالكامل بلغة Python، وتتألّف من ثلاثة مكوّنات رئيسية: مكتبة قواعد بيانات اسمها whisper، وبرنامج خدمي (daemon) للواجهة الخلفية اسمه carbon، وتطبيق ويب للواجهة الأمامية (front end) يرسم الرسوم البيانية ويوفّر واجهة مستخدم أساسية. ورغم أنّ whisper كُتبت خصيصًا لـ Graphite، فإنّها يمكن أن تُستخدم بصورة مستقلّة أيضًا. وهي مشابهة إلى حدٍّ كبير في التصميم لقاعدة بيانات الدوران (round-robin database) المستخدَمة في RRDtool، ولا تخزّن سوى البيانات الرقمية المتسلسلة زمنيًّا (time-series). عادةً ما نتخيَّل قواعد البيانات بوصفها عمليات خادمية (server processes) تتحدّث إليها تطبيقات العميل عبر المقابس (sockets). لكنّ whisper، مثل RRDtool إلى حدٍّ بعيد، هي مكتبة قواعد بيانات تستخدمها التطبيقات للتعامل مع البيانات المخزَّنة في ملفات ذات تنسيق خاص واسترجاعها. أمّا أبسط عمليات whisper فهي create لإنشاء ملف whisper جديد، وupdate لكتابة نقاط بيانات جديدة في ملف، وfetch لاسترجاع نقاط البيانات.
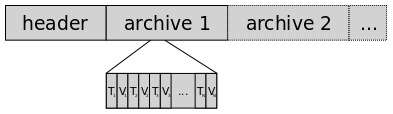
الشكل 7.1: التشريح الأساسي لملف whisper
وكما هو مبيَّن في الشكل 7.1، تتكوّن ملفات whisper من قسم ترويسة (header) يحوي بيانات وصفية (metadata) متنوّعة، يليها قسم واحد أو أكثر من أقسام الأرشيف (archive). كل أرشيف هو تسلسل من نقاط البيانات المتتالية، وهي أزواج من الشكل (timestamp, value). وحين تُنفَّذ عملية update أو fetch، يحدّد whisper الإزاحة (offset) في الملف التي ينبغي أن تُكتب البيانات إليها أو تُقرأ منها، بناءً على الطابع الزمني وإعداد الأرشيف.
7.2. الواجهة الخلفية: خدمة تخزين بسيطة
الواجهة الخلفية في Graphite هي عملية خادمية (daemon process) اسمها carbon-cache، ويشار إليها عادةً ببساطة باسم carbon. وهي مبنيّة على Twisted، وهو إطار عمل للغة Python قابل للتوسّع بدرجة عالية في عمليات الإدخال والإخراج (I/O) ومبني على الأحداث (event-driven). ويتيح Twisted لـ carbon التخاطب بكفاءة مع عدد كبير من تطبيقات العميل والتعامل مع حجم كبير من حركة البيانات بتحميل زائد (overhead) منخفض. ويبيّن الشكل 7.2 تدفّق البيانات بين carbon وwhisper وتطبيق الويب: تجمع تطبيقات العميل البيانات وترسلها إلى الواجهة الخلفية لـ Graphite وهي carbon، الذي يخزّن البيانات باستخدام whisper. ثم يمكن لتطبيق Graphite على الويب أن يستخدم هذه البيانات في توليد الرسوم البيانية.
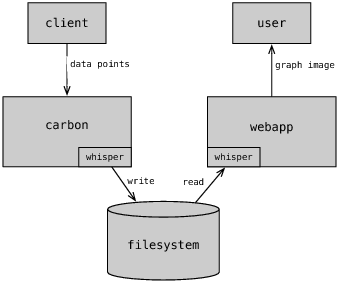
الشكل 7.2: تدفّق البيانات
الوظيفة الأساسية لـ carbon هي تخزين نقاط البيانات للمقاييس (metrics) التي يوفّرها تطبيقات العميل. وفي مصطلح Graphite، المقياس (metric) هو أي كمية قابلة للقياس يمكن أن تتغيّر مع الزمن (مثل معدّل استخدام المعالج في خادم أو عدد مبيعات منتج). أمّا نقطة البيانات (data point) فهي مجرّد زوج من الشكل (timestamp, value) يقابل القيمة المقاسة لمقياس معيّن عند لحظة زمنية بعينها. وتُعرَّف المقاييس تعريفًا فريدًا بأسمائها، ويقدّم اسم كل مقياس ونقاط بياناته تطبيقات العميل. ومن الأنواع الشائعة لتطبيقات العميل وكيلُ مراقبة (monitoring agent) يجمع مقاييس النظام أو التطبيق، ويرسل القيم التي جمعها إلى carbon ليسهل تخزينها وعرضها. أمّا أسماء المقاييس في Graphite فبسيطة وهرمية (hierarchical)، تشبه مسارات نظام الملفات، إلّا أن النقطة (dot) هي ما يفصل بين مستويات التدرّج بدلًا من الشرطة المائلة أو الشرطة المائلة العكسية. وسيقبل carbon أي اسم قانوني، وينشئ ملف whisper لكل مقياس لتخزين نقاط بياناته. وتُخزَّن ملفات whisper داخل دليل بيانات carbon ضمن تدرّج لنظام الملفات يعكس التدرّج المفصول بنقاط في اسم كل مقياس، بحيث — على سبيل المثال — يقابل servers.www01.cpuUsage المسار …/servers/www01/cpuUsage.wsp.
حين يرغب تطبيق العميل في إرسال نقاط بيانات إلى Graphite، عليه أن ينشئ اتصال TCP مع carbon، عادةً على المنفذ 2003[2]. والعميل هو من يُجري كل عملية الكلام؛ إذ لا يرسل carbon أي شيء عبر الاتصال. ويرسل العميل نقاط البيانات بتنسيق نصّي عادي (plain-text) بسيط، مع إمكان ترك الاتصال مفتوحًا وإعادة استخدامه عند الحاجة. ويتكوّن التنسيق من سطر نصّي واحد لكل نقطة بيانات، ويحتوي كل سطر على اسم المقياس المفصول بنقاط، وقيمته، وطابع زمني بالثواني منذ حقبة Unix (Unix epoch)، مفصولةً بمسافات. فمثلًا قد يرسل العميل ما يلي:
servers.www01.cpuUsage 42 1286269200
products.snake-oil.salesPerMinute 123 1286269200
[one minute passes]
servers.www01.cpuUsageUser 44 1286269260
products.snake-oil.salesPerMinute 119 1286269260
على مستوى عالٍ، لا يفعل carbon سوى الاستماع إلى البيانات بهذا التنسيق ومحاولة تخزينها على القرص في أقرب وقت ممكن باستخدام whisper. وسنناقش لاحقًا تفاصيل بعض الحيل المستخدَمة لضمان قابلية التوسّع للحصول على أفضل أداء ممكن من القرص الصلب النموذجي.
7.3. الواجهة الأمامية: رسوم بيانية عند الطلب
يتيح تطبيق Graphite على الويب للمستخدمين طلب رسوم بيانية مخصّصة عبر واجهة برمجية (API) بسيطة قائمة على عناوين URL. وتُحدَّد معاملات الرسم في سلسلة الاستعلام (query string) ضمن طلب HTTP من نوع GET، وتُعاد صورة بصيغة PNG في الاستجابة. فمثلًا، العنوان:
http://graphite.example.com/render?target=servers.www01.cpuUsage&
width=500&height=300&from=-24h
يطلب رسمًا بيانيًّا بأبعاد 500×300 للمقياس servers.www01.cpuUsage ولبيانات آخر 24 ساعة. وفي الواقع، لا يلزم سوى معامل target؛ فجميع المعاملات الأخرى اختيارية وتستخدم قيمك الافتراضية عند إغفالها.
يدعم Graphite مجموعةً واسعة من خيارات العرض، فضلًا عن دوال معالجة البيانات التي تتبع صياغة وظيفية (functional) بسيطة. فمثلًا، يمكننا رسم متوسّط متحرّك (moving average) من عشر نقاط للمقياس في مثالنا السابق هكذا:
target=movingAverage(servers.www01.cpuUsage,10)
ويمكن تداخل الدوال، ما يتيح تعبيرات وحسابات معقّدة.
وهذا مثال آخر يعطي المجموع التراكمي (running total) لمبيعات اليوم، مستخدمًا مقاييس المبيعات في الدقيقة لكل منتج على حدة:
target=integral(sumSeries(products.*.salesPerMinute))&from=midnight
تحسب الدالة sumSeries سلسلة زمنية تمثّل مجموع كل مقياس يطابق النمط products.*.salesPerMinute. ثم تحسب integral مجموعًا تراكميًّا بدلًا من عدد لكل دقيقة. ومن هنا ليس من الصعب تصوّر كيفية بناء واجهة ويب لعرض الرسوم البيانية ومعالجتها. ويأتي Graphite مع واجهة Composer خاصة به، المبيَّنة في الشكل 7.3، تؤدّي ذلك باستخدام Javascript لتعديل معاملات عنوان URL الخاص بالرسم البياني أثناء تنقّل المستخدم في قوائم المزايا المتاحة.
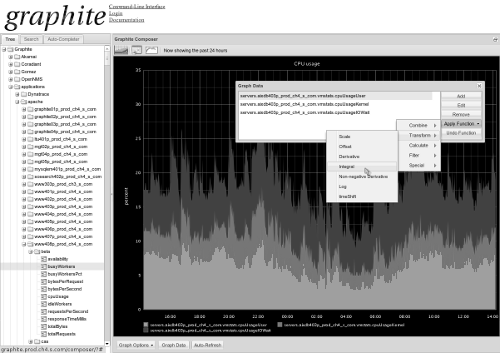
الشكل 7.3: واجهة Composer في Graphite
7.4. لوحات المعلومات
منذ بدايتها استُخدم Graphite أداةً لإنشاء لوحات معلومات قائمة على الويب. وتجعل واجهة URL هذا حالة استخدام طبيعية إلى حدٍّ تامّ. فصناعة لوحة معلومات لا تتجاوز بساطة إنشاء صفحة HTML مليئة بوسوم من هذا النوع:
<img src="../http://graphite.example.com/render?parameters-for-my-awesome-graph">
غير أنّ ليس كل من يحبّ صياغة عناوين URL يدويًّا، لذا توفّر واجهة Composer في Graphite طريقة بالنقر لإنشاء رسم بياني يمكنك ببساطة نسخ عنوان URL منه ولصقه. وحين تُقرَن بأداة أخرى تسمح بإنشاء صفحات الويب بسرعة (مثل ويكي)، تصبح العملية سهلة إلى حدٍّ يكفي يستطيع المستخدمون غير التقنيين بناء لوحات معلوماتهم بسهولة تامّة.
7.5. عنق زجاجة واضح
بمجرد أن بدأ مستخدمي في بناء لوحات المعلومات، سرعان ما بدأت Graphite تعاني مشكلات في الأداء. ففحصت سجلّات خادم الويب لأرى ما هي الطلبات التي تثقله. وكان الأمر واضحًا إلى حدٍّ كبير: المشكلّة تكمن في العدد الهائل من طلبات الرسم البياني. فالتطبيق على الويب كان محدودًا بالمعالج (CPU-bound)، إذ كان يرسم الرسوم باستمرار. ولاحظت أنّ هناك طلبات متطابقة كثيرة، ولوحات المعلومات هي المسؤولة عنها.
تخيّل أنّ لديك لوحة معلومات فيها 10 رسوم بيانية، وأنّ الصفحة تتحدّث مرّة واحدة في الدقيقة. في كلّ مرّة يفتح فيها المستخدم لوحة المعلومات في متصفّحه، على Graphite أن تتعامل مع 10 طلبات إضافية في الدقيقة. وبذلك يصبح الأمر مكلفًا بسرعة.
الحلّ البسيط هو رسم كل رسم بياني مرّة واحدة فقط، ثم تقديم نسخة منه إلى كل مستخدم. ويوفّر إطار العمل Django (الذي بُنيت عليه Graphite) آليّة تخزين مؤقّت (caching) ممتازة يمكنها استخدام طرفيات خلفية (back ends) متنوّعة مثل memcached. وmemcached[3] هو في جوهره جدول تجزئة (hash table) مُقدَّم بوصفه خدمة شبكية. ويمكن لتطبيقات العميل أن تجلب أزواج المفاتيح والقيم وتضبطها تمامًا كجدول التجزئة العادي. والفائدة الرئيسية من استخدام memcached هي إمكانية تخزين نتيجة طلب مكلف (مثل رسم رسم بياني) بسرعة فائقة واسترجاعها لاحقًا للتعامل مع الطلبات التالية. ولتجنّب إعادة الرسوم القديمة نفسها إلى الأبد، يمكن ضبط memcached بحيث تنتهي صلاحية الرسوم المخزَّنة مؤقتًا بعد مدّة قصيرة. وحتى لو كانت هذه المدّة بضع ثوانٍ فقط، فإنّ الحِمل الذي يزيحه عن Graphite هائل، لأنّ الطلبات المكرّرة شائعة إلى حدٍّ كبير.
ومن الحالات الشائعة الأخرى التي تولّد كثيرًا من طلبات الرسم، أن يكون المستخدم يبدّل خيارات العرض ويطبّق دوالًا في واجهة Composer. وفي كلّ مرّة يغيّر فيها المستخدم شيئًا ما، على Graphite أن تعيد رسم الرسم البياني. وبما أنّ البيانات نفسها تتكرّر في كل طلب، فمن المنطقي وضع البيانات الأساسية في ذاكرة memcached المؤقتة أيضًا. وهذا يُبقي الواجهة سريعة الاستجابة للمستخدم، إذ تُختصر خطوة استرجاع البيانات.
7.6. تحسين عمليات الإدخال والإخراج
تخيّل أنّ لديك 60,000 مقياس ترسلها إلى خادم Graphite، وأنّ لكل مقياس منها نقطة بيانات واحدة في الدقيقة. وتذكّر أنّ لكل مقياس ملف whisper خاصًّا به على نظام الملفات. وهذا يعني أنّ carbon ملزَم بتنفيذ عملية كتابة واحدة في 60,000 ملف مختلف في كل دقيقة. ما دام بإمكان carbon الكتابة في ملف واحد كل جزء من الثانية، فينبغي أن يتمكّن من مجاراة المعدّل المطلوب. وليس هذا بعيدًا عن الواقع، فلنفترض — على سبيل المثال — أنّ لديك 600,000 مقياس يتحدّث كل دقيقة، أو أنّ مقاييسك تتحدّث كل ثانية، أو أنّك ببساطة لا تستطيع تحمّل تكلفة تخزين سريع بما يكفي. وأيًّا كان الحال، فافترض أنّ معدّل نقاط البيانات الواردة يتجاوز معدّل عمليات الكتابة التي يستطيع تخزينك مجاراتها. وكيف ينبغي التعامل مع هذه الحالة؟
معظم الأقراص الصلبة اليوم تملك زمن بحث (seek time) بطيئًا[4]، أي التأخير بين تنفيذ عمليتي إدخال وإخراج عند موقعين مختلفين، مقارنةً بكتابة تسلسل متّصل من البيانات. وهذا يعني كلّما زاد تواتر الكتابة على نحو متّصل، زادت الإنتاجية (throughput) التي نحصل عليها. لكنّ لدينا آلاف الملفات التي يجب الكتابة إليها كثيرًا، وكلّ كتابة فيها صغيرة جدًّا (نقطة بيانات واحدة في whisper لا تتجاوز 12 بايت)، فإنّ أقراصنا ستقضي بالتأكيد معظم وقتها في البحث.
انطلاقًا من افتراض أنّ معدّل عمليات الكتابة مقيَّد بسقف منخفض نسبيًّا، فالطريقة الوحيدة لزيادة إنتاجية نقاط البيانات فوق ذلك المعدّل هي كتابة عدّة نقاط بيانات في عملية كتابة واحدة. وهذا ممكن لأنّ whisper ترتّب نقاط البيانات المتتالية على القرص بصورة متّصلة. ولذلك أضفت دالة update_many إلى whisper، تأخذ قائمةً من نقاط البيانات لمقياس واحد وتضغط نقاط البيانات المتتالية في عملية كتابة واحدة. ورغم أنّ هذا جعل كل كتابة أكبر، فإنّ الفرق في الزمن اللازم لكتابة عشر نقاط بيانات (120 بايت) مقابل نقطة واحدة (12 بايت) لا يُذكر. ويحتاج الأمر إلى عدد أكبر بكثير من نقاط البيانات قبل أن يبدأ حجم كل كتابة في التأثير بوضوح في زمن الاستجابة (latency).
ثم نفّذتُ آليّة تخزين مؤقّت (buffering) في carbon. فتُوجَّه كل نقطة بيانات واردة إلى طابور (queue) بناءً على اسم المقياس، ثم تُضاف إلى ذلك الطابور. ويعود خيط (thread) آخر على نحو متكرّر إلى جميع الطوابير، ويسحب من كلٍّ منها كل نقاط البيانات ويكتبها في ملف whisper المناسب بواسطة update_many. وبالعودة إلى مثالنا، إذا كان لدينا 600,000 مقياس يتحدّث كل دقيقة وكان تخزيننا لا يستطيع مجاراة سوى كتابة واحدة لكل جزء من الثانية، فإنّ الطوابير ستنتهي إلى احتواء نحو 10 نقاط بيانات لكلٍّ منها في المتوسط. والمورد الوحيد الذي يكلّفنا إياه هو الذاكرة، وهي وفيرة نسبيًّا لأنّ كل نقطة بيانات لا تتجاوز بضعة بايتات.
تتكفّل هذه الاستراتيجة بتخزين عدد من نقاط البيانات في مخزن مؤقّت وبكمّية ديناميكية على النحو اللازم للحفاظ على معدّل وارد من نقاط البيانات قد يتجاوز معدّل عمليات الإدخال والإخراج (I/O) الذي يستطيع تخزينك مجاراته. ومن مزايا هذا النهج اللافتة أنه يضيف درجةً من المرونة (resiliency) للتعامل مع تباطؤات الإدخال والإخراج المؤقّتة. فإذا احتاج النظام إلى تنفيذ أعمال إدخال وإخراج أخرى خارج Graphite، فمن المرجّح أن ينخفض معدّل عمليات الكتابة، وعندئذٍ ستكبر طوابير carbon ببساطة. وكلّما كبرت الطوابير، كبرت عمليات الكتابة. وبما أنّ الإنتاجية الكلية لنقاط البيانات تساوي معدّل عمليات الكتابة مضروبًا في متوسّط حجم كل كتابة، فإنّ carbon قادر على المجاراة ما دام هناك ذاكرة كافية للطوابير. ويُصوَّر آليّة الطوابير في carbon في الشكل 7.4.
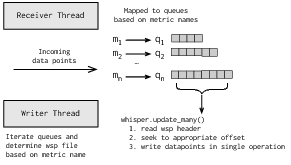
الشكل 7.4: آليّة الطوابير في Carbon
7.7. إبقاء البيانات فورية
كان تخزين نقاط البيانات في مخزن مؤقّت طريقةً جيّدة لتحسين عمليات الإدخال والإخراج في carbon، لكنّه لم يمرّ وقت طويل قبل أن يلاحظ مستخدمي تأثيرًا جانبيًّا مزعجًا إلى حدٍّ كبير. وبالعودة إلى مثالنا مرّة أخرى، لدينا 600,000 مقياس يتحدّث كل دقيقة، ونفترض أنّ تخزيننا لا يستطيع مجاراة سوى 60,000 عملية كتابة في الدقيقة. وهذا يعني أنّ لدينا في أي لحظة معطاة نحو عشر دقائق من البيانات جالسةً في طوابير carbon. وبالنسبة إلى المستخدم، يعني هذا أنّ الرسوم البيانية التي يطلبها من تطبيق Graphite على الويب ستفتقر إلى أحدث عشر دقائق من البيانات: وهذا ليس جيّدًا!
ولحسن الحظ فإنّ الحلّ مباشر إلى حدٍّ كبير. فأضفت ببساطة مستمع مقابس (socket listener) إلى carbon يوفّر واجهة استعلام للوصول إلى نقاط البيانات المخزَّنة مؤقتًا، ثم عدّلت تطبيق Graphite على الويب ليستخدم هذه الواجهة في كلّ مرّة يحتاج فيها إلى استرجاع البيانات. ثم يدمج التطبيق نقاط البيانات التي استرجعها من carbon مع نقاط البيانات التي استرجعها من القرص، وبذلك تصبح الرسوم البيانية فورية. صحيح أنّ نقاط البيانات في مثالنا تتحدّث كل دقيقة، ومن ثمّ ليست «فورية» على وجه الدقّة، لكنّ واقعة أنّ كل نقطة بيانات تصبح متاحة فورًا داخل الرسم البياني بمجرّد استلامها من carbon هي ما يجعل الأمر فوريًّا.
7.8. النوى والتخزين المؤقّت وحالات الفشل الكارثية
كما هو واضح على الأرجح الآن، فإنّ سمةً أساسية لأداء النظام تعتمد عليها أداء Graphite نفسه هي زمن الإدخال والإخراج (I/O latency). وقد افترضنا حتى الآن أنّ لنظامنا زمن إدخال وإخراج منخفضًا ومتسقًا بمعدّل نحو جزء من الثانية لكل كتابة، لكنّ هذا افتراض كبير يستوجب بعض التحليل الأعمق. فمعظم الأقراص الصلبة ليست بهذه السرعة؛ وحتى مع عشرات الأقراص في مصفوفة RAID، فمن المرجّح جدًّا أن يتجاوز زمن الاستجابة للوصول العشوائي جزءًا من الثانية. لكنّك إن حاولت اختبار مدى سرعة كتابة حاسوب محمول قديم لقرص كامل كيلوبايت واحد، لوجدت أنّ استدعاء النظام write يعود في زمن أقل بكثير من جزء من الثانية. ولماذا؟
حينما تمتلك البرمجيات سمات أداء متضاربة أو غير متوقّعة، فالمسبّب يكون عادةً إمّا التخزين المؤقّت (buffering) أو التخزين المؤقت (caching). وفي حالتنا هذه نتعامل مع الاثنين معًا. فاستدعاء النظام write لا يكتب بياناتك إلى القرص تقنيًّا، إنما يضعها في مخزن مؤقّت ثم تكتبها النواة (kernel) إلى القرص لاحقًا. ولهذا يعود استدعاء الكتابة عادةً بهذه السرعة العالية. وحتى بعد أن يُكتب المخزن المؤقّت في القرص، كثيرًا ما يبقى مخزَّنًا مؤقتًا لعمليات القراءة اللاحقة. وسُلوكيتا التخزين المؤقّت والتخزين المؤقت يتطلّبان الذاكرة بالطبع.
مطوّرو النواة، وهم الأشخاص الأذكياء كما هم، قرّروا أن يكون من الجيد استخدام ما تبقّى من ذاكرة مساحة المستخدم (user space) حاليًّا بدلًا من تخصيص الذاكرة صراحةً. وقد ثبت أنّ هذا مُعزِّزٌ مفيد إلى حدٍّ هائل للأداء، وهو أيضًا يفسّر لماذا لا يبقى لدى النظام أيّ ذاكرة «حرّة» تقريبًا بعد قدر معيّن من عمليات الإدخال والإخراج مهما أضفتَ إليه من ذاكرة. فإذا كانت تطبيقاتك في مساحة المستخدم لا تستخدم تلك الذاكرة، فمن المرجّح أن تكون النواة هي من يستخدمها. أمّا الجانب السلبي لهذا النهج هو أنّ هذه الذاكرة «الحرّة» يمكن أن تُسحَب من النواة في اللحظة التي تقرّر فيها تطبيقٌ في مساحة المستخدم أنه يحتاج إلى تخصيص ذاكرة إضافية لنفسه. وليس أمام النواة سوى التنازل عنها، فتضيع معها أيّ مخازن مؤقّتة كانت فيها.
فماذا يعني كلّ ذلك بالنسبة إلى Graphite؟ لقد أبرزنا للتو اعتماد carbon على زمن إدخال وإخراج منخفض ومتسق، ونعلم أيضًا أنّ استدعاء النظام write لا يعود سريعًا إلّا لأنّ البيانات مجرّدًا تُنسخ إلى مخزن مؤقّت. فماذا يحدث حين لا تتوفّر ذاكرة كافية لتستمرّ النواة في التخزين المؤقّت لعمليات الكتابة؟ تصبح عمليات الكتابة متزامنة (synchronous) وبالتالي شديدة البطء! ويؤدي ذلك إلى انخفاض حادّ في معدّل عمليات الكتابة في carbon، ما يؤدي إلى نموّ طوابير carbon، وهو ما يستهلك ذاكرةً أكبر فيحرم النواة من مزيد من الذاكرة. وفي النهاية، فإنّ هذا النوع من الحالات يؤدّي عادةً إلى نفاد ذاكرة carbon أو إلى إماتته على يد مسؤول نظام غاضب.
ولتجنّب هذه الكارثة، أضفت إلى carbon عدّة مزايا، منها حدودٌ قابلة للضبط لعدد نقاط البيانات التي يمكن أن تُصطفّ في الطوابير، وحدودٌ لمعدّل سرعة تنفيذ عمليات whisper المختلفة. ويمكن لهذه المزايا أن تحمي carbon من الانحراف عن السيطرة، وأن تفرض بدلًا من ذلك آثارًا أقلّ قسوة، مثل إسقاط بعض نقاط البيانات أو رفض قبول مزيد من نقاط البيانات. غير أنّ القيم المناسبة لهذه الإعدادات تعتمد على النظام، وتستلزم قدرًا لا بأس به من الاختبار لضبطها. وهي مفيدة، لكنّها لا تحلّ المشكلة جوهريًّا. وسنحتاج إلى مزيد من العتاد من أجل ذلك.
7.9. التجميع
لا يصعب إلى حدٍّ كبير جعل عدّة خوادم Graphite تبدو بوصفها نظامًا واحدًا من منظور المستخدم، على الأقلّ في حالة تنفيذ ساذجة. ويتكوّن تفاعل المستخدم مع التطبيق على الويب أساسًا من عمليتين: البحث عن المقاييس وجلب نقاط البيانات (عادةً في صورة رسم بياني). وقد أُخفيت عمليتا البحث والجلب داخل مكتبة تحصر تنفيذهما عن بقية الشيفرة، وهما أيضًا معروضتان عبر معالِجات طلبات HTTP لتسهيل الاستدعاءات البعيدة.
تبحث عملية find في نظام الملفات المحلي لبيانات whisper عن أشياء تطابق نمطًا يحدّده المستخدم، تمامًا كما يطابق glob من نوع *.txt الملفات ذات الامتداد نفسه. ولأنّ البنية شجرية، فإنّ ما تعيده find هو مجموعة من كائنات Node، يشتقّ كلٌّ منها إمّا من الصنفين الفرعيين Branch أو Leaf التابعين لـ Node. وتُقابَل المجلّدات بعقد الفروع، وتُقابَل ملفات whisper بعقد الأوراق. وجعل طبقة التجريد هذه يسهّل دعم مختلف أنواع التخزين الأساسي، بما في ذلك ملفات RRD[5] وملفات whisper المضغوطة بصيغة gzip.
تعرّف واجهة Leaf دالة fetch التي يعتمد تنفيذها على نوع عقدة الورقة. وفي حالة ملفات whisper، فهي مجرّد غلاف رقيق (thin wrapper) لدالة fetch الخاصة بمكتبة whisper. وعندما أُضيف دعم التجميع، وُسِّعت الدالة find لتتمكّن من إجراء عمليات بحث بعيدة عبر HTTP على خوادم Graphite الأخرى المحدَّدة في إعدادات التطبيق على الويب. وتُغلَّف بيانات العقد الواردة في نتائج استدعاءات HTTP هذه في كائنات RemoteNode الممتثلة لواجهات Node وBranch وLeaf المعتادة. ويجعل هذا التجميع شفّافًا بالنسبة إلى بقية شيفرة التطبيق على الويب. أمّا دالة fetch لعقدة ورقة بعيدة فمُنفَّذة بوصفها استدعاء HTTP آخر لجلب نقاط البيانات من خادم Graphite الخاص بتلك العقدة.
تُجرى جميع هذه الاستدعاءات بين تطبيقات الويب بالطريقة نفسها التي يستدعي بها العميل، إلّا مع معامل إضافي واحد يحدّد أنّ العملية يجب أن تُنفَّذ محليًّا فقط وألّا يُعاد توزيعها في العنقود. وحين يُطلب من التطبيق على الويب رسم رسم بياني، فإنه ينفّذ عملية find لتحديد المقاييس المطلوبة، ثم يستدعي fetch على كلٍّ منها لجلب نقاط بياناته. وهذا يعمل سواءً كانت البيانات على الخادم المحلي، أو على خوادم بعيدة، أو كليهما. وإذا تعطّل خادم ما، تنتهي مهلة الاستدعاءات البعيدة بسرعة إلى حدٍّ معقول، ويُعلَّم الخادم بأنّه خارج الخدمة لمدّة قصيرة لا تُجرى خلالها أيّ استدعاءات إضافية إليه. ومن منظور المستخدم، فإنّ أيّ بيانات كانت على الخادم المفقود ستغيب عن رسومه البيانية، إلّا إذا كانت تلك البيانات مكرَّرة على خادم آخر في العنقود.
7.9.1. تحليل موجز لكفاءة التجميع
أغلى جزء في طلب رسم بياني هو رسم الرسم نفسه. ويُنفَّذ كل رسم على خادم واحد، لذا فإنّ إضافة مزيد من الخوادم تزيد فعلًا من طاقة رسم الرسوم البيانية. لكنّ كون عدّة طلبات تنتهي إلى توزيع عمليات find على كل خادم آخر في العنقود يعني أنّ مخطّط التجميع لدينا يشارك قدرًا كبيرًا من حمل الواجهة الأمامية بدلًا من تشتيته. غير أنّ ما حقّقناه في هذه المرحلة هو طريقة فعّالة لتوزيع الحمل على الواجهة الخلفية، إذ تعمل كل نسخة من carbon بصورة مستقلّة. وهذه خطوة أولى جيّدة، لأنّ الواجهة الخلفية تصير عنق زجاجة معظم الوقت قبل أن تكون الواجهة الأمامية كذلك، لكنّ الواجهة الأمامية لن تتوسّع أفقيًّا بهذا النهج.
ولكي تتوسّع الواجهة الأمامية بفاعلية أكبر، لا بدّ من تقليل عدد استدعاءات find البعيدة التي يجريها التطبيق على الويب. وهنا أيضًا، الحلّ الأسهل هو التخزين المؤقّت (caching). فتمامًا كما استُخدم memcached بالفعل لتخزين نقاط البيانات والرسوم البيانية مؤقتًا، يمكن أيضًا استخدامه لتخزين نتائج طلبات find مؤقتًا. وبما أنّ مواقع المقاييس أقلّ احتمالًا للتغيّر كثيرًا، فمن المتوقّع عادةً أن يُخزَّن هذا لمدة أطول. غير أنّ المقابل الذي تدفعه إن جعلت مهلة التخزين المؤقّت لنتائج find طويلة جدًّا هو أنّ المقاييس الجديدة المضافة إلى التدرّج قد لا تظهر للمستخدم بالسرعة نفسها.
7.9.2. توزيع المقاييس في عنقود
تطبيق Graphite على الويب متجانس إلى حدٍّ كبير في جميع أنحاء العنقود، إذ يؤدّي المهمة نفسها بالضبط على كل خادم. أمّا دور carbon فيمكن أن يختلف من خادم إلى آخر تبعًا للبيانات التي تقرّر إرسالها إلى كل نسخة. وكثيرًا ما يكون هناك عملاء مختلفون كثيرون يرسلون البيانات إلى carbon، لذا سيكون ربط إعدادات كل عميل بتخطيط عنقود Graphite لديك أمرًا مزعجًا إلى حدٍّ كبير. فقد تذهب مقاييس التطبيق إلى خادم carbon واحد، في حين تُرسَل المقاييس التجارية إلى عدّة خوادم carbon من أجل التكرار (redundancy).
ولتبسيط إدارة حالات مثل هذه، يأتي Graphite مع أداة إضافية اسمها carbon-relay. ومهمّتها بسيطة إلى حدٍّ كبير؛ فهي تستقبل بيانات المقاييس من العملاء تمامًا كبرنامج carbon القياسي (والذي يحمل اسم carbon-cache في الواقع)، لكنّها بدلًا من تخزين البيانات تطبّق مجموعةً من القواعد على أسماء المقاييس لتحديد خوادم carbon-cache التي تُرحَّل إليها البيانات. وتتكوّن كل قاعدة من تعبير نمطي (regular expression) وقائمةٍ من خوادم الوجهة. ولكل نقطة بيانات واردة، تُقيَّم القواعد بالترتيب، وتُستخدَم أول قاعدة يطابق تعبيرها النمطي اسم المقياس. وبهذا لا يحتاج جميع العملاء سوى إرسال بياناتهم إلى carbon-relay لتصل إلى الخوادم الصحيحة.
بمعنىً ما، يوفّر carbon-relay وظيفة تكرار (replication)، وإن كان من الأدقّ وصفها بأنّها ازدواج على مستوى الإدخال (input duplication) لأنّها لا تعالج مشكلات المزامنة. فإذا تعطّل خادم مؤقتًا، ستفقد نقاط البيانات الخاصّة بالمدّة التي كان متوقفًا فيها، لكنه سيعمل بصورة طبيعية فيما عدا ذلك. وهناك سكربتات إدارية تترك التحكّم في عمليّة إعادة المزامنة بيد مسؤول النظام.
7.10. تأمّلات في التصميم
لقد عزّزت تجربتي في العمل على Graphite اقتناعي بأنّ قابلية التوسّع لها علاقة ضئيلة بالأداء على المستوى الأدنى (low-level)، وأنّها في المقابل نتاجٌ للتصميم ككل. فقد اصطدمت بعدد كبير من عناق الزجاجة على طول الطريق، لكنّني في كل مرّة كنت أبحث عن تحسينات في التصميم بدلًا من دفعات تسريع في الأداء. وقد سُئلت مرّات كثيرة عمّا كتبتُ Graphite بلغة Python بدلًا من Java أو C++، وإجابتي دائمًا هي أنّني لم أصب يومًا حاجةً حقيقية إلى الأداء الذي يمكن أن تقدّمه لغة أخرى. وفي Knu74 قال Donald Knuth على نحو شهير إنّ التحسين المبكّر (premature optimization) هو جذر كل الشرور. ما دام نفترض أنّ شيفرتنا ستواصل التطور بطرق غير تافهة، فإنّ كل تحسين[6] هو، بمعنىً ما، تحسين مبكّر.
من أقوى نقاط قوة Graphite وأضعفها في آنٍ واحد هو أنّ جزءًا ضئيلًا جدًّا منها صُمِّم فعليًّا بالمعنى التقليدي. وتطوّرت Graphite تدريجيًّا، عقبةً تلو الأخرى، مع ظهور المشكلات. ومرّات كثيرة كانت العقبات متوقّعة، وكانت حلولُ الوقاية المختلفة تبدو أمرًا بديهيًّا. لكنّ من المفيد تجنّب حلّ مشكلات ليس لديك فعلًا حتى الآن، حتى لو بدا محتمَلًا أن تصيبك قريبًا. والسبب في ذلك هو أنّك تتعلّم أكثر بكثير من دراسة الأعطال الفعلية عن قرب مقارنةً بالتأمّل في استراتيجيات أفضل. فحلّ المشكلات يقوده معًا البيانات التجريبية المتوفّرة لدينا ومعرفتنا وحدسنا الخاصّان. وقد اكتشفتُ أنّ التشكيك الكافي في حكمك الشخصي يدفعك إلى النظر في بياناتك التجريبية بعين أكثر شمولًا.
فمثلًا، حين كتبتُ whisper للمرّة الأولى كنت مقتنعًا بأنّها ستُعاد كتابتها بلغة C من أجل السرعة، وأنّ تنفيذي بالغة Python لن يكون سوى نموذج أوّلي (prototype). ولولا أنّني كنت تحت ضغط الوقت لربما أجتزُ التنفيذ بالـ Python تمامًا. غير أنّ الأمر تبيّن في النهاية أنّ الإدخال والإخراج (I/O) يصير عنق زجاجة قبل وحدة المعالجة (CPU) بوقت طويل جدًّا، فتكفاءة Python الأقلّ لا تصنع أيّ فرق يُذكر في الممارسة الفعلية.
لكنّ كما قلتُ، فإنّ النهج التطوّري يمثّل أيضًا نقطة ضعف كبيرة في Graphite. فالواجهات، كما تبيّن، لا تناسب التطوّر التدريجي. والواجهة الجيدة متّسقة وتعتمد أعرافًا (conventions) لرفع مستوى القابلية للتنبّؤ. وبهذا المقياس، أرى أنّ واجهة URL في Graphite دون المستوى المقبول في الوقت الحالي. فقد رُكِّبت الخيارات والدوال على مرّ السنين، وشكّلت أحيانًا جزرًا صغيرة من الاتّساق، لكنّها تفتقر إجمالًا إلى حسّ عامّ بالاتّساق. والطريق الوحيد لحلّ مشكلة كهذه هو إضافة أرقام إصدارات للواجهات (versioning)، لكنّ لهذا أيضًا عيوبه. فبمجرد تصميم واجهة جديدة، تبقى الواجهة القديمة عسيرة التخلّص منها، وتبقى معلّقةً كحِمل تطوّري مثل زائدة الملحق في جسم الإنسان. وقد تبدو غير ضارّة إلى حدٍّ ما، إلى أن يصيب شيفرتك ذات يوم التهابُ الزائدة (appendicitis)، أي خللًا مرتبطًا بالواجهة القديمة، فتُضطرّ إلى التدخّل. ولو كان لي أن أغيّر أمرًا واحدًا في Graphite في مرحلته الأولى، لكان تعيين عناية أكبر بكثير بتصميم واجهات البرمجة الخارجية، بالتفكير المسبق بدلًا من تطويرها قطعةً قطعة.
ومن جوانب Graphite الأخرى التي تسبّب بعض الإحباط، المرونة المحدودة لنموذج تسمية المقاييس الهرمي. ورغم بساطته وملاءمته العالية لمعظم حالات الاستخدام، فإنّه يجعل صياغة بعض الاستعلامات المتطوّرة صعبةً جدًّا، بل مستحيلة. وحين فكّرت للمرّة الأولى في إنشاء Graphite، كنت أعرف منذ البداية أنّني أريد واجهة برمجية قائمة على URL يمكن تحريرها يدويًّا لإنشاء الرسوم البيانية[7]. ولا زلت مسرورًا بأنّ Graphite يوفّر ذلك اليوم، لكنّني أخشى أنّ هذا الشرط أثقل الواجهة بصياغة شديدة البساطة تجعل التعبيرات المعقّدة مرهقة. ويجعل التدرّج الهرمي مسألة تحديد «المفتاح الأساسي» للمقياس بسيطةً إلى حدٍّ كبير، لأنّ المسار هو في جوهره مفتاح أساسي لعقدة في الشجرة. أمّا الجانب السلبي فهو أنّ جميع البيانات الوصفية (أي بيانات الأعمدة) يجب أن تُدمج مباشرةً داخل المسار. ويكتمل الحلّ المحتمل في الحفاظ على النموذج الهرمي وإضافة قاعدة بيانات منفصلة للبيانات الوصفية تتيح اختيارًا أكثر تقدّمًا للمقاييس بصياغة خاصّة.
7.11. التحوّل إلى مصدر مفتوح
عند النظر إلى الوراء في تطوّر Graphite، ما زلت مندهشًا، سواءً من مدى التقدّم الذي حقّقه المشروع، أو من مدى ما أوصلني هو بصفتي مبرمجًا. فقد بدأ مشروعًا شخصيًا لم يكن يتجاوز بضعة مئات من أسطر الشيفرة. وبدأ محرّك الرسم بوصفه مجرّد تجربة لأعرف إن كنت أستطيع كتابة محرّك من هذا النوع. أمّا whisper فقد كُتبت على مدى عطلة نهاية أسبوع بدافع اليأس لحلّ مشكلة تعطّل كاملة قبل موعد إطلاق حاسم. وقد أُعيدت كتابة carbon مرّات أكثر ممّا أتذكّر. وحين سمح لي بأن أُصدر Graphite برخصة مفتوحة المصدر عام 2008، لم أتوقّع في الحقيقة أيّ استجابة كبيرة. وبعد بضع أشهر ذُكر المشروع في مقال على CNET نقلته Slashdot، فانطلق فجأة ولم يتوقّف منذ ذلك الحين. وهناك اليوم عشرات الشركات الكبيرة والمتوسطة الحجم تستخدم Graphite. والمجتمع نشيط إلى حدٍّ كبير ويواصل النموّ. وGraphite بعيدة كلّ البعد عن منتج مكتمل، إذ يجري فيها قدر كبير من العمل التجريبيّ الرائع، وهذا ما يبقي العمل عليها ممتعًا ومليئًا بالإمكانات.
الحواشي
http://launchpad.net/graphite- هناك منفذ آخر يمكن عبره إرسال كائنات مُسلسَلة (serialized objects)، وهو أكثر كفاءةً من تنسيق النص العادي. ولا يلزم هذا إلّا عند مستويات مرتفعة جدًّا من حجم الحركة.
http://memcached.org- تمتلك الأقراص الصلبة الحالة (solid-state drives) أزمنة بحث شديدة السرعة عمومًا مقارنةً بالأقراص الصلبة التقليدية.
- ملفات RRD هي في الحقيقة عقد فروع لأنّها قد تحوي عدّة مصادر بيانات؛ أمّا مصدر بيانات RRD الواحد فهو عقدة ورقة.
- قصد Knuth تحديدًا تحسين الشيفرة على المستوى الأدنى (low-level)، لا التحسينات البنيوية (macroscopic) مثل تحسينات التصميم.
- هذا يفرض أن تكون الرسوم البيانية نفسها مفتوحة المصدر. فبإمكان أي شخص النظر في عنوان URL الخاص بالرسم البياني لفهمه أو تعديله.
http://launchpad.net/graphite↩︎هناك منفذ آخر يمكن عبره إرسال كائنات مُسلسَلة (serialized objects)، وهو أكثر كفاءةً من تنسيق النص العادي. ولا يلزم هذا إلّا عند مستويات مرتفعة جدًّا من حجم الحركة. ↩︎
http://memcached.org↩︎تمتلك الأقراص الصلبة الحالة (solid-state drives) أزمنة بحث شديدة السرعة عمومًا مقارنةً بالأقراص الصلبة التقليدية. ↩︎
ملفات RRD هي في الحقيقة عقد فروع لأنّها قد تحوي عدّة مصادر بيانات؛ أمّا مصدر بيانات RRD الواحد فهو عقدة ورقة. ↩︎
قصد Knuth تحديدًا تحسين الشيفرة على المستوى الأدنى (low-level)، لا التحسينات البنيوية (macroscopic) مثل تحسينات التصميم. ↩︎
هذا يفرض أن تكون الرسوم البيانية نفسها مفتوحة المصدر. فبإمكان أي شخص النظر في عنوان URL الخاص بالرسم البياني لفهمه أو تعديله. ↩︎