Berkeley DB
المعمارية المصادر المفتوحة (المجلد الأول)Berkeley DB
هندسة تطبيقات البرمجيات مفتوحة المصدر (المجلد الأول) Berkeley DB
Margo Seltzer و Keith Bostic
إذا استمتعتُ بهذه الكتب، فقد تستمتع أيضًا بـ Software Design by Example in Python و Software Design by Example in JavaScript.
تنص «قانون كونيواي» (Conway's Law) على أن التصميم يعكس بنية المنظمة التي أنتجته. وإذا وسّعنا الفكرة قليلًا، فقد نتوقّع أن قطعة البرمجيات التي صمّمها وأنتجها في البداية شخصان، قد تعكس — لا بنية المنظمة فحسب، بل التحيزات والفلسفات الداخلية التي يحملها كل منهما إلى الطاولة. أمضينا إحدىنا (سلتزر) حياتها المهنية بين عالمَي أنظمة الملفات وأنظمة إدارة قواعد البيانات. وحين تُسأل عن ذلك، تجادل بأن الاثنين الشيء نفسه جوهريًا، بل إن أنظمة التشغيل وأنظمة إدارة قواعد البيانات كلاهما في جوهره مُدير موارد ومزوِّد تجريدات مريحة. الاختلافات «مجردًا» تفاصيل تنفيذ. أمّا الآخر (بوستيك) فيؤمن بمنهج هندسة البرمجيات القائم على الأدوات، وببناء المكوّنات على أساس لبنات أبسط، لأن هذه الأنظمة تتفوق دائمًا على البنى الأحادية (monolithic) في «ـيّات» (‑bilities) المهمة: قابلية الفهم، وقابلية التوسيع، وقابلية الصيانة، وقابلية الاختبار، والمرونة.
عندما تجمع بين هاتين الرؤيتين، لا يُدهشك أن تكتشف أننا أمضينا معًا جزءًا كبيرًا من العقدين الماضيين في العمل على Berkeley DB—مكتبة برمجيات توفّر إدارة بيانات سريعة ومرنة وموثوقة وقابلة للتوسّع. توفّر Berkeley DB الكثير من الوظائف نفسها التي يتوقّعها الناس من الأنظمة الأكثر تقليدية، مثل قواعد البيانات العلائقية، لكنها تحزمها بطريقة مختلفة. على سبيل المثال، توفّر Berkeley DB وصولاً سريعًا إلى البيانات، مفاتيحًا وتسلسليًا، فضلًا عن دعم المعاملات (transactions) والتعافي من الأعطال (recovery from failure). غير أنها توفّر تلك الميزات في مكتبة ترتبط مباشرة بالتطبيق الذي يحتاج تلك الخدمات، بدلًا من إتاحتها عبر تطبيق خادم مستقل.
في هذا الفصل، سننظر إلى Berkeley DB عن قرب أكبر، ونرى أنها مركّبة من مجموعة من الوحدات (modules)، تجسّد كلٌّ منها فلسفة Unix في «افعل شيئًا واحدًا بشكل جيّد». التطبيقات التي تدمج Berkeley DB في داخلها تستطيع استخدام هذه المكوّنات مباشرة، أو أن تستخدمها ضمنيًا ببساطة عبر العمليات المألوفة وهي الجلب (get) والوضع (put) وحذف عناصر البيانات. سنركّز على البنية المعمارية (architecture)—كيف بدأنا، وما الذي كنّا نصمّمه، وأين انتهينا ولماذا. يمكن للتصاميم (بل ستضطر قطعًا) أن تتكيّف وتتغيّر—الأمر الحيوي هو الحفاظ على المبادئ ورؤية متّسقة عبر الزمن. وسنتناول أيضًا بإيجاز تطوّر الشيفرة في مشاريع البرمجيات طويلة الأمد. لدى Berkeley DB أكثر من عشرين عامًا من التطوير المتواصل، وهذا يُنقض حتمًا ثمنه على جودة التصميم.
4.1. في البداية
يعود أصل Berkeley DB إلى حقبة كان فيها نظام التشغيل Unix مملوكًا حصريًا لشركة AT&T، وكانت هناك مئات الأدوات والمكتبات التي كانت لنَسَبها قيود ترخيص صارمة. كانت Margo Seltzer طالبة دراسات عليا في جامعة كاليفورنيا، بيركلي، وكان Keith Bostic عضوًا في مجموعة أبحاث أنظمة الحاسوب في بيركلي. في ذلك الوقت، كان Keith يعمل على إزالة البرمجيات المملوكة لـ AT&T من توزيع بيركلي للبرمجيات (Berkeley Software Distribution).
بدأ مشروع Berkeley DB بهدف متواضع: استبدال حزمة تجزئة (hash) hsearch الموجودة في الذاكرة، وحزمتَي التجزئة dbm/ndbm الموجودة على القرص، بتنفيذ تجزئة جديد ومُحسَّن قادر على العمل في الذاكرة وعلى القرص معًا، وكذلك على إعادة توزيعه بحرية دون رخصة مملوكة. استندت مكتبة hash التي كتبتها Margo Seltzer SY91 إلى أبحاث Litwin في «التجزئة الخطية القابلة للتوسيع» (Extensible Linear Hashing). وافتخرت بمخطط ذكي يسمح بإجراء ربط (mapping) ثابت الزمن بين قيم التجزئة وعناوين الصفحات، فضلًا عن القدرة على التعامل مع بيانات كبيرة—عناصر أكبر من حجم دلو التجزئة (hash bucket) أو حجم صفحة نظام الملفات الأساسي، وهو عادةً من أربعة إلى ثمانية كيلوبايتات.
إذا كانت جداول التجزئة جيدة، فإن أشجار Btree مع جداول التجزئة ستكون أفضل. كان Mike Olson، وهو أيضًا طالب دراسات عليا في جامعة كاليفورنيا بيركلي، قد كتب عددًا من تطبيقات Btree، ووافق على كتابة تطبيق آخر. قمنا نحن الثلاثة بتحويل برمجيات التجزئة لدى Margo وبرمجيات Btree لدى Mike إلى واجهة برمجية (API) لا تعني طريقة الوصول (access-method-agnostic)، حيث تشير إليها التطبيقات عبر مقابض قواعد البيانات (database handles) التي تملك دوال (handle methods) لقراءة البيانات وتعديلها.
بنيان على هاتين الطريقتين للوصول، كتب Mike Olson و Margo Seltzer ورقة بحثية (SO92) تصف LIBTP، وهي مكتبة معاملات برمجية تعمل داخل فضاء عنوانيات التطبيق.
أُدرجت مكتبتا التجزئة و Btree في إصدارات 4BSD النهائية تحت اسم Berkeley DB 1.85. ومن الناحية التقنية، تنفّذ طريقة الوصول Btree شجرة B+link، غير أننا سنستخدم مصطلح Btree في بقية هذا الفصل، لأن هذا هو اسم طريقة الوصول. على الأرجح تكون بنية Berkeley DB 1.85 وواجهاتها البرمجية مألوفة لأي شخص استخدم أي نظام قائم على Linux أو BSD.
بقيت مكتبة Berkeley DB 1.85 خامدة بضع سنوات، حتى عام 1996 حين تعاقدت Netscape مع Margo Seltzer و Keith Bostic لبناء التصميم المعاملي الكامل الموصوف في ورقة LIBTP وإنشاء نسخة من البرمجيات بجودة جاهزة للإنتاج. وقد أنتج هذا الجهد أول إصدار معاملي من Berkeley DB، وهو الإصدار 2.0.
تاريخ Berkeley DB اللاحق أبسط وأكثر تقليدية: فقد أدخل Berkeley DB 2.0 (1997) المعاملات إلى Berkeley DB؛ وكان Berkeley DB 3.0 (1999) نسخة أُعيد تصميمها، تضيف مستويات إضافية من التجريد والتوجيه لاستيعاب وظائف متنامية. وأدخل Berkeley DB 4.0 (2001) النسخ الاحتياطي (replication) والتوافرية العالية (high availability)، وأضاف Oracle Berkeley DB 5.0 (2010) دعم SQL.
عند كتابة هذا الكتاب، كانت Berkeley DB هي طقم أدوات قواعد البيانات الأكثر استخدامًا في العالم، مع مئات الملايين من النسخ المنشورة العاملة في كل شيء من الموجّهات (routers) والمتصفحات إلى برامج البريد وأنظمة التشغيل. ورغم مرور أكثر من عشرين عامًا عليها، فقد سمح لها منهج Berkeley DB القائم على الأدوات والموجَّه نحو الكائنات (object-oriented) بأن تتحسّن تدريجيًا وتعيد اختراع ذاتها لتلائم متطلبات البرمجيات التي تستخدمها.
الدرس التصميمي الأول
إن تصميم أي حزمة برمجيات معقّدة وبناؤها كمجموعة متعاونة من الوحدات ذات حدود واجهة برمجية (API boundaries) واضحة المعالم أمر حيوي بالنسبة لاختبارها وصيانتها. يمكن أن تتغيّر هذه الحدود حسب الحاجة (وينبغي أن تتغيّر)، لكنها تبقى ضرورية دائمًا. يمنح وجود تلك الحدود البرمجيات من التحول إلى كومة من المعكرات غير القابلة للصيانة. قال بَتلر لامبسون مرة إن كل مشكلات في علوم الحاسوب يمكن حلّها بمستوى آخر من التوجيه (indirection). والأدق من ذلك، حين سُئل عمّا يعنيه أن يكون شيء ما موجَّهًا نحو الكائنات، قال لامبسون إن ذلك يعني القدرة على تعدد التطبيقات (implementations) خلف واجهة برمجية واحدة. ويجسّد تصميم Berkeley DB وتطبيقها هذا النهج الذي يسمح بتعدد التطبيقات خلف واجهة مشتركة، يوفر مظهرًا وإحساسًا موجَّهين نحو الكائنات، رغم أن المكتبة مكتوبة بلغة C.
4.2. نظرة عامة على البنية المعمارية
في هذا القسم، سنستعرض البنية المعمارية لمكتبة Berkeley DB، بدءًا من LIBTP، ونبرز الجوانب الرئيسية في تطورها.
يُظهر الشكل 4.1، المأخوذ من ورقة Seltzer و Olson الأصلية، بنية LIBTP الأصلية، بينما يعرض الشكل 4.2 البنية المعمارية المصمَّمة لـ Berkeley DB 2.0.
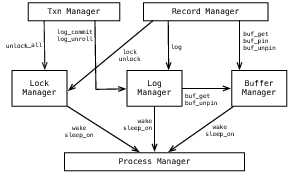
الشكل 4.1: بنية نظام LIBTP النموذجي
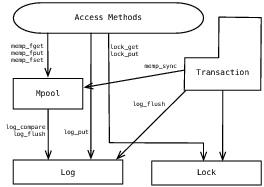
الشكل 4.2: البنية المعمارية المقصودة لـ Berkeley DB-2.0.
كان الاختلاف الوحيد ذو الأهمية بين تنفيذ LIBTP والتصميم المعماري لـ Berkeley DB 2.0 هو إزالة مدير العمليات (process manager). فقد تطلّب LIBTP أن يسجّل كل خيط تحكّم نفسه لدى المكتبة، ثم يزامن الخيوط/العمليات الفردية بدلًا من توفير مزامنة على مستوى الأنظمة الفرعية. وكما هو مبيَّن في القسم 4.4، كان هذا التصميم الأصلي قد يكون في صالحنا أكثر.
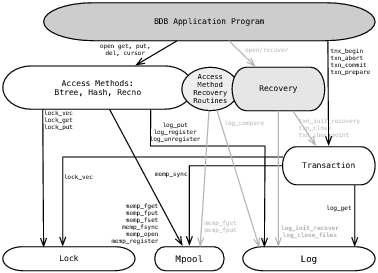
الشكل 4.3: البنية المعمارية الفعلية لـ Berkeley DB 2.0.6.
يكشف الفرق بين التصميم وبين بنية db-2.0.6 المُصدَرة فعليًا، والموضحة في الشكل 4.3، واقع تنفيذ مدير تعافٍ متين. ويُظهر نظام التعافي (recovery subsystem) باللون الرمادي. يشمل التعافي بنية التوجيه (driver infrastructure) المصوّرة في صندوق التعافي، فضلًا عن مجموعة من إجراءات إعادة التنفيذ (redo) والتراجع (undo) تستعيد العمليات التي أدتها طرق الوصول. ويمثّلها الدائرة الموسومة بـ «إجراءات تعافي طرق الوصول». وهناك تصميم متّسق لطريقة التعامل مع التعافي في Berkeley DB 2.0، على النقيض من إجراءات يدوية خاصة بطرق وصول بعينها في LIBTP. وهذا التصميم العام الغرض ينتج أيضًا واجهة أغنى بكثير بين الوحدات المختلفة.
يوضح الشكل 4.4 بنية Berkeley DB-5.0.21. وتشير الأرقام في المخطط إلى الواجهات البرمجية المدرجة في الجدول في الجدول 4.1. ورغم أن البنية الأصلية لا تزال ظاهرة، فإن البنية الحالية تُظهر شيخوختها بإضافة وحدات جديدة، وتفكيك الوحدات القديمة (مثلًا، لقد أصبح log هو log و dbreg)، وزيادة كبيرة في عدد الواجهات البرمجية بين الوحدات).
بعد أكثر من عقد من التطور، وعشرات الإصدارات التجارية، ومئات الميزات الجديدة، نرى أن البنية أصبحت أعقد بكثير من أسلافها. والأمور الجوهرية التي يجب الإشارة إليها هي: أولًا، النسخ الاحتياطي يضيف طبقة جديدة كليًا إلى النظام، لكنه يفعل ذلك بنظافة، إذ يتفاعل مع بقية النظام عبر الواجهات البرمجية نفسها التي يتفاعل بها الكود التاريخي. ثانيًا، تُقسَّم الوحدة log إلى log و dbreg (تسجيل قواعد البيانات). وهذا مشروح بمزيد من التفصيل في القسم 4.8. ثالثًا، لقد وضعنا جميع الاستدعاءات بين الوحدات في فضاء أسماء (namespace) يُحدَّد ببادئة من الشرطة السفلية، بحيث لا تتعارض التطبيقات مع أسماء دوالنا. نتناول هذا الأمر بمزيد من التفصيل في الدرس التصميمي 6.
رابعًا، أصبحت واجهة نظام التسجيل البرمجية (API) قائمة على المؤشرات (cursor based) (لا توجد واجهة log_get؛ حلّت محلها واجهة log_cursor). تاريخيًا، لم يكن لدى Berkeley DB أكثر من خيط تحكّم واحد يقرأ السجل أو يكتبه في أي لحظة زمنية، لذا كانت المكتبة تملك تصورًا واحدًا لمؤشر seek الحالي داخل السجل. لم يكن هذا تجريدًا جيدًا أبدًا، لكنه أصبح غير قابل للتطبيق مع النسخ الاحتياطي. تمامًا كما تدعم واجهة التطبيقات التكرار (iteration) باستخدام المؤشرات، أصبح السجل يدعم التكرار باستخدام المؤشرات. خامسًا، تقدّم الوحدة fileop داخل طرق الوصول دعمًا لعمليات إنشاء قواعد البيانات وحذفها وإعادة تسميتها المحميّة معامليًا. استغرق الأمر لدينا محاولات متعددة حتى أصبحت التنفيذيات مقبولة (ولا تزال أقل نظافة مما نود)، وبعد إعادة عملها مرات عديدة، استخرجناها إلى وحدة مستقلة خاصة بها.
الدرس التصميمي الثاني
التصميم البرمجي ليس سوى إحدى الطرق التي تجعلك تفرض على نفسك التفكير في المشكلة كاملة قبل محاولة حلّها. ويستخدم المبرمجون المهرة تقنيات مختلفة لهذا الغرض: فبعضهم يكتب نسخة أولى ويتخلص منها، وبعضهم يكتب صفحات يدوية شاملة أو مستندات تصميم، وبعضهم الآخر يملأ قالب شيفرة يُحدَّد فيه كل متطلب ويُسنَد إلى دالة أو تعليق محدد. على سبيل المثال، في Berkeley DB أنشأنا مجموعة كاملة من الصفحات اليدوية بأسلوب Unix لِطُرق الوصول ومكوناتها الأساسية قبل كتابة أي شيفرة. وبغض النظر عن التقنية المستخدمة، من الصعب التفكير بوضوح في بنية البرنامج بعد بدء تنقيح الشيفرة، فضلًا عن أن التغييرات المعمارية الكبيرة كثيرًا ما تُهدِر مجهود التنقيح السابق. تتطلب بنية البرمجيات عقلية مختلفة عن تنقيح الشيفرة، والبنية التي تبدأ بها التنقيح هي عادةً البنية التي ستُسلِّمها في ذلك الإصدار.
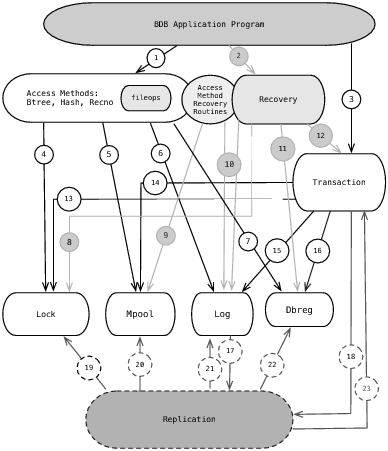
الشكل 4.4: بنية Berkeley DB-5.0.21
| واجهات تطبيقات المستخدم | ||||
|---|---|---|---|---|
| 1. DBP handle operations | 2. DB_ENV Recovery | 3. Transaction APIs | ||
| open | open(… DB_RECOVER …) | DB_ENV->txn_begin | ||
| get | DB_TXN->abort | |||
| put | DB_TXN->commit | |||
| del | DB_TXN->prepare | |||
| cursor | ||||
| الواجهات البرمجية المستخدمة من قبل طرق الوصول | ||||
| 4. إلى Lock | 5. إلى Mpool | 6. إلى Log | 7. إلى Dbreg | |
| __lock_downgrade | __memp_nameop | __log_print_record | __dbreg_setup | |
| __lock_vec | __memp_fget | __dbreg_net_id | ||
| __lock_get | __memp_fput | __dbreg_revoke | ||
| __lock_put | __memp_fset | __dbreg_teardown | ||
| __memp_fsync | __dbreg_close_id | |||
| __memp_fopen | __dbreg_log_id | |||
| __memp_fclose | ||||
| __memp_ftruncate | ||||
| __memp_extend_freelist | ||||
| واجهات التعافي البرمجية | ||||
| 8. إلى Lock | 9. إلى Mpool | 10. إلى Log | 11. إلى Dbreg | 12. إلى Txn |
| __lock_getlocker | __memp_fget | __log_compare | __dbreg_close_files | __txn_getckp |
| __lock_get_list | __memp_fput | __log_open | __dbreg_mark_restored | __txn_checkpoint |
| __memp_fset | __log_earliest | __dbreg_init_recover | __txn_reset | |
| __memp_nameop | __log_backup | __txn_recycle_id | ||
| __log_cursor | __txn_findlastckp | |||
| __log_vtruncate | __txn_ckp_read | |||
| الواجهات البرمجية المستخدمة من قبل وحدة المعاملات | ||||
| 13. إلى Lock | 14. إلى Mpool | 15. إلى Log | 16. إلى Dbreg | |
| __lock_vec | __memp_sync | __log_cursor | __dbreg_invalidate_files | |
| __lock_downgrade | __memp_nameop | __log_current_lsn | __dbreg_close_files | |
| __dbreg_log_files | ||||
| واجهة برمجية إلى نظام النسخ الاحتياطي | ||||
| 17. من Log | 18. من Txn | |||
| __rep_send_message | __rep_lease_check | |||
| __rep_bulk_message | __rep_txn_applied | |||
| __rep_send_message | ||||
| واجهة برمجية من نظام النسخ الاحتياطي | ||||
| 19. إلى Lock | 20. إلى Mpool | 21. إلى Log | 22. إلى Dbreg | 23. إلى Txn |
| __lock_vec | __memp_fclose | __log_get_stable_lsn | __dbreg_mark_restored | __txn_recycle_id |
| __lock_get | __memp_fget | __log_cursor | __dbreg_invalidate_files | __txn_begin |
| __lock_id | __memp_fput | __log_newfile | __dbreg_close_files | __txn_recover |
| __memp_fsync | __log_flush | __txn_getckp | ||
| __log_rep_put | __txn_updateckp | |||
| __log_zero | ||||
| __log_vtruncate |
الجدول 4.1: واجهات Berkeley DB 5.0.21 البرمجية
لماذا نُصمّم المكتبة المعاملية من مكونات (components) بدلًا من ضبطها لاستخدام واحد متوقَّع؟ هناك ثلاثة أجوبة لهذا السؤال. أولًا، لأنه يفرض تصميمًا أكثر انضباطًا. ثانيًا، فبدون حدود قوية في الشيفرة، تتراجع حزم البرمجيات المعقّدة حتمًا إلى أكوام من الفوضى غير القابلة للصيانة. ثالثًا، يمكنك أبدًا توقّع كل الطرق التي سيستخدم بها العملاء برمجياتك؛ فإذا خوّلت المستخدمين الوصول إلى مكوّنات البرمجيات، فسيستخدمونها بطرق لم تفكّر فيها قط.
في الأقسام اللاحقة، سندرس كل مكوّن من مكوّنات Berkeley DB، ونفهم ما يفعله وكيف يندمج في الصورة الأكبر.
4.3. طرق الوصول: Btree و Hash و Recno و Queue
تقدّم طرق الوصول في Berkeley DB كلًا من البحث المفتاحي عن سلاسل البايتات متغيّرة الطول وثابتة الطول، والتكرار عليها. ويدعم Btree و Hash أزواج مفاتيح/قيم متغيّرة الطول. أما Recno و Queue فيدعمان أزواج أرقام سجلات/قيم (حيث يدعم Recno قيمًا متغيّرة الطول، بينما يدعم Queue قيمًا ثابتة الطول فقط).
الفرق الرئيسي بين طرقي الوصول Btree و Hash أن Btree يوفّر مرجعية موضعية (locality of reference) للمفاتيح، بينما Hash لا يوفّر ذلك. وهذا يعني أن Btree هو طريقة الوصول المناسبة يكاد لكل مجموعات البيانات؛ غير أن طريقة الوصول Hash مناسبة لمجموعات بيانات ضخمة لدرجة أن بنى فهرسة Btree نفسها لا تتّسع في الذاكرة. عند تلك النقطة، يكون استخدام الذاكرة للبيانات أفضل من استخدامها لبنى الفهرسة. وكان هذا المفاضلة (trade-off) منطقيًا أكثر بكثير في عام 1990 حين كانت الذاكرة الرئيسية أصغر بكثير مما هي اليوم.
الفرق بين Recno و Queue أن Queue يدعم القفل على مستوى السجل (record-level locking)، على حساب اشتراطه قيمًا ثابتة الطول. أما Recno فيدعم كائنات متغيّرة الطول، لكنه مثل Btree و Hash، لا يدعم سوى القفل على مستوى الصفحة.
صممنا Berkeley DB في الأصل بحيث كانت وظائف CRUD (الإنشاء والقراءة والتحديث والحذف) قائمة على المفاتيح وتُعدّ الواجهة الأساسية للتطبيقات. ثم أضفنا لاحقًا المؤشرات (cursors) لدعم التكرار. وقد أدى هذا الترتيب إلى حالة مربكة ومهدِرة، تتكرر فيها مسارات الشيفرة إلى حد بعيد داخل المكتبة. ومع مرور الوقت، أصبح هذا غير قابل للصيانة، فحوّلنا جميع العمليات القائمة على المفاتيح إلى عمليات عبر المؤشرات (تخصص العمليات القائمة على المفاتيح الآن مؤشرًا مخبأ، وتنفّذ العملية، ثم تعيد المؤشر إلى مجمع المؤشرات). وهذه تطبيق لقاعدة من القواعد التي تكررت بلا نهاية في هندسة البرمجيات: لا تحسّن أي مسار شيفرة بأي طريقة تضرّ بالوضوح والبساطة حتى تعرف أن ذلك ضروري.
الدرس التصميمي الثالث
لا تتقادم بنية البرمجيات بشكل جيّد. إذ تتدهور البنية المعمارية للبرمجيات بمقدار مباشر يتناسب مع عدد التغييرات التي تجريها عليها: فإصلاحات الأخطاء تآكل الطبقات (layering)، والميزات الجديدة تضغط على التصميم. قرار تحديد متى تكون البنية المعمارية قد تدهورت بما يكفي ينبغي أن تعيد تصميم وحدة أو إعادة كتابتها قرار صعب. فمن جهة، ومع تدهور البنية، تصبح الصيانة والتطوير أصعب، ويكون نهاية ذلك المسار قطعة برمجية قديمة لا يمكن صيانتها إلا بتوظيف جيش من المختبِرين العنيفين عند كل إصدار، لأن لا أحد يفهم كيف تعمل البرمجيات في داخلها. ومن جهة أخرى، سيشتكي المستخدمون بمرارة من عدم الاستقرار والتوافقات الناتجة عن التغييرات الجذرية. وكمهندس برمجيات، فإن الضمان الوحيد الذي لديك هو أن أحدهم سيغضب منك أيًّا كان المسار الذي تختاره.
نُغفل هنا مناقشات تفصيلية لتفاصيل بُنى طرق الوصول الداخلية في Berkeley DB؛ فهي تنفّذ خوارزميات Btree وتجزئة معروفة إلى حدّ كبير (إذ إن Recno طبقة فوق شيفرة Btree، و Queue دالة بحث عن كتل في ملف، وإن كانت معقّدة بإضافة القفل على مستوى السجل).
4.4. طبقة واجهة المكتبة
مع مرور الوقت، ومع إضافتنا وظائف إضافية، اكتشفنا أن كلًا من التطبيقات والشيفرة الداخلية يحتاج إلى وظائف المستوى الأعلى نفسها (على سبيل المثال، تستخدم عملية ضم جدول (join) عدة مؤشرات للتكرار على الصفوف، تمامًا كما قد يستخدم التطبيق مؤشرًا للتكرار على الصفوف نفسها).
الدرس التصميمي الرابع
لا يهم كيف تسمي متغيراتك أو توابعك أو دوالك، أو ما التعليقات أو أسلوب الشيفرة الذي تستخدمه؛ بمعنى أنه يوجد عدد كبير من الصيغ والأساليب «جيدة بما يكفي». وما يهم فعلًا، ويهم كثيرًا جدًا، هو أن يكون التسمية والأسلوب متّسقين. يستمد المبرمجون المهرة معلومات هائلة من تنسيق الشيفرة وتسمية الكائنات. وينبغي أن تنظر إلى حالات عدم اتّساق التسمية والأسلوب على أنها ﴿استثمار بعض المبرمجين وقتًا وجهدًا في الكذب على بقية المبرمجين، وبالمثل﴾. والإخفاق في الالتزام بأعراف الشيفرة السائدة في البيت جريمة تستوجب الفصل.
لهذا السبب، فكّكنا واجهات طرق الوصول إلى طبقات محدّدة بدقة. وتؤدي طبقات دوال الواجهة هذه كل عمليات التحقق العام من الأخطاء، والتحقق من الأخطاء الخاصة بكل دالة، وتتبّع الواجهة، ومهام أخرى مثل الإدارة التلقائية للمعاملات. حين تستدعي التطبيقات Berkeley DB، فإنها تستدعي المستوى الأول من دوال الواجهة استنادًا إلى توابع موجودة في مقابض الكائنات. (على سبيل المثال، __dbc_put_pp هي استدعاء الواجهة الخاص بطريقة الوضع (put) الخاصة بمؤشر Berkeley DB لتحديث عنصر بيانات. أما اللاحقة "_pp" فهي اللاحقة التي نستخدمها للتعريف على جميع الدوال التي يمكن للتطبيق استدعاؤها.)
إحدى مهام Berkeley DB التي تُؤدَّى في طبقة الواجهة هي تتبّع الخيوط التي تعمل داخل مكتبة Berkeley DB. وهذا ضروري لأن بعض عمليات Berkeley DB الداخلية قد لا تُنفَّذ إلا عندما لا يكون هناك أي خيط يعمل داخل المكتبة. وتتتبّع Berkeley DB الخيوط في المكتبة عبر تعليم علَم بأن خيطًا ما يفتّش داخل المكتبة في بداية كل واجهة برمجية للمكتبة، ومسح ذلك العلَم عندما يعود استدعاء الواجهة. ويُجرى دائمًا هذا التحقق من الدخول والخروج في طبقة الواجهة، وكذلك تحقق مشابه لتحديد ما إذا كان الاستدعاء يجري في بيئة منسوخة (replicated environment).
السؤال الواضح هو: «لماذا لا نمرّر مُعرِّف خيط إلى المكتبة؟ أليس ذلك أسهل؟» والجواب هو نعم، سيكون أسهل بكثير، ونتمنى تمامًا أننا فعلنا ذلك. لكن هذا التغيير كان سيعدّل كل تطبيق من تطبيقات Berkeley DB على الإطلاق، ومعظم استدعاءات كل تطبيق إلى Berkeley DB، وفي حالات كثيرة كان سيتطلب إعادة هيكلة التطبيقات.
الدرس التصميمي الخامس
على مهندسي البرمجيات أن يختاروا معاركهم الترقية بعناية: سيقبل المستخدمون التغييرات الطفيفة للترقية إلى إصدارات جديدة (إذا ضمنت أخطاء وقت الترجمة، أي إخفاقات واضحة حتى اكتمال الترقية؛ ولا ينبغي أبدًا أن تفشل تغييرات الترقية بطرق خفية). لكن لإجراء تغييرات جذرية فعلية، يجب أن تعترف بأنها قاعدة شيفرة جديدة تتطلب نقلًا (port) لقاعدة المستخدمين لديك. ومن البديهي أن قواعد الشيفرة الجديدة ونقل التطبيقات ليسا رخيصين من حيث الوقت أو الموارد، لكنه أيضًا ليس رخيصًا إغضاب قاعدة المستخدمين بإخبارهم أن إعادة الهيكلة الشاملة هائلة هي مجرد ترقية طفيفة.
مهمة أخرى تُؤدَّى في طبقة الواجهة هي توليد المعاملات (transaction generation). تدعم مكتبة Berkeley DB وضعًا تحدث فيه كل عملية داخل معاملة مُولَّدة تلقائيًا (وهذا يوفّر على التطبيق إنشاء معاملاته الصريحة وإيداعها). ويتطلب دعم هذا الوضع أن يتم، في كل مرة يستدعي فيها التطبيق عبر الواجهة البرمجية دون تحديد معاملته الخاصة، إنشاء معاملة تلقائيًا.
أخيرًا، تتطلب جميع واجهات Berkeley DB البرمجية التحقق من الوسائط. وفي Berkeley DB هناك نوعان من التحقق من الأخطاء—تحققات عامة لتحديد ما إذا كانت قاعدة بياناتنا قد تلفت أثناء عملية سابقة، أو ما إذا كنا في منتصف تغيير في حالة النسخ الاحتياطي (مثلًا، تغيير النسخة التي تسمح بالكتابة). وهناك أيضًا تحققات خاصة بكل واجهة: الاستخدام الصحيح للعلامات، والاستخدام الصحيح للوسائط، وتوليفات الخيارات الصحيحة، وأي نوع آخر من الأخطاء يمكننا فحصه قبل تنفيذ العملية المطلوبة فعليًا.
كل هذا التحقق الخاص بكل واجهة مُغلَّف في دوال تنتهي باللاحقة _arg. وهكذا يوجد التحقق من الأخطاء الخاص بطريقة الوضع (put) الخاصة بالمؤشر في الدالة __dbc_put_arg، التي تستدعيها الدالة __dbc_put_pp.
أخيرًا، عند اكتمال التحقق من جميع الوسائط وتوليد المعاملة، نستدعي تابع العامل (worker method) الذي ينفّذ العملية فعليًا (في مثالنا، سيكون __dbc_put)، وهو الدالة نفسها التي نستخدمها عند استدعاء وظيفة الوضع في المؤشر داخليًا.
تطوّر هذا التفكيك خلال فترة من النشاط المكثّف، حين كنا نحدّد بدقة ما هي الإجراءات التي نحتاج إلى اتخاذها عند العمل في بيئات منسوخة. وبعد أن تكرّرنا في قاعدة الشيفرة عددًا ليس بالقليل من المرات، فصلنا كل هذا التحقق التمهيدي ليسهل تغييره في المرة التالية التي نكتشف فيها مشكلة فيه.
4.5. المكوّنات الأساسية
هناك أربعة مكوّنات تقوم عليها طرق الوصول: مدير مخازن مؤقتة (buffer manager)، ومدير أقفال (lock manager)، ومدير سجلات (log manager)، ومدير معاملات (transaction manager). سنناقش كلًّا منها على حدة، لكنها تشترك جميعها في بعض الخصائص المعمارية المشتركة.
أولًا، لكل الأنظمة الفرعية واجهاتها البرمجية الخاصة، وقد كان لكل نظام فرعي في البداية مقبض كائن (object handle) خاص به تعتمد عليه جميع توابع ذلك النظام الفرعي. على سبيل المثال، يمكنك استخدام مدير الأقفال في Berkeley DB لإدارة أقفالك الخاصة، أو لكتابة مدير أقفال بعيد خاص بك، أو يمكنك استخدام مدير المخازن المؤقتة في Berkeley DB لإدارة صفحات ملفاتك الخاصة في الذاكرة المشتركة. ومع مرور الوقت، أُزيلت المقابض الخاصة بكل نظام فرعي من الواجهة البرمجية لتبسيط تطبيقات Berkeley DB. ورغم أن الأنظمة الفرعية ما زالت مكوّنات منفصلة يمكن استخدامها بمعزل عن بقية الأنظمة الفرعية، فإنها تتشارك الآن مقبض كائن مشتركًا، وهو مقبض «البيئة» DB_ENV. وهذه البنية المعمارية تفرض الطبقات والتعميم (generalization). وحتى وإن كانت الطبقة تنتقل من حين إلى آخر، ولا تزال هناك بضعة أماكن يصل فيها نظام فرعي إلى نظام فرعي آخر، فإنه من الانضباط الجيد للمبرمجين أن يفكّروا في أجزاء النظام بوصفها منتجات برمجية منفصلة بذاتها.
ثانيًا، تعيد جميع الأنظمة الفرعية (بل في الحقيقة جميع دوال Berkeley DB) رموز خطأ تصعد عبر مكدس الاستدعاء. فكمكتبة، لا تستطيع Berkeley DB أن تتطاول على فضاء أسماء التطبيق بإعلان متغيّرات عامة، فضلًا عن أن إلزام الأخطاء بالعودة في مسار واحد عبر مكدس الاستدعاء يفرض انضباطًا جيدًا على المبرمج.
الدرس التصميمي السادس
في تصميم المكتبات، الاحترام لفضاء الأسماء أمر حيوي. لا ينبغي أن يحتاج المبرمجون الذين يستخدمون مكتبتك إلى حفظ عشرات الأسماء المحجوزة للدوال والثوابت والبنيات والمتغيّرات العامة لتفادي تعارضات التسمية بين التطبيق والمكتبة.
أخيرًا، تدعم جميع الأنظمة الفرعية الذاكرة المشتركة. ولأن Berkeley DB تدعم مشاركة قواعد البيانات بين عدة عمليات قيد التشغيل، فلا بد أن تعيش جميع بنى البيانات المهمة في الذاكرة المشتركة. وأهم ما يترتّب على هذا الاختيار هو أن بنى البيانات في الذاكرة يجب أن تستخدم أزواجًا من (العنوان الأساس، والإزاحة) بدلًا من المؤشرات (pointers)، حتى تعمل بنى البيانات المعتمدة على المؤشرات في سياق عمليات متعددة. بمعنى آخر، بدلًا من التوجيه عبر مؤشر، يجب على مكتبة Berkeley DB أن تنشئ مؤشرًا من عنوان أساس (العنوان الذي تُسقَط عنده شريحة الذاكرة المشتركة في الذاكرة) زائد إزاحة (إزاحة بنية بيانات بعينها في تلك الشريحة المُسقَطة). ولدعم هذه الميزة، كتبنا نسخة من حزمة queue في توزيع بيركلي للبرمجيات (Berkeley Software Distribution) نفّذت مجموعة واسعة من القوائم المترابطة.
الدرس التصميمي السابع
قبل أن نكتب حزمة قوائم مترابطة للذاكرة المشتركة، كان مهندسو Berkeley DB يكتبون يدويًا مجموعة متنوعة من بنى البيانات المختلفة في الذاكرة المشتركة، وكانت هذه التطبيقات هشّة وصعبة التنقيح. وحلّت حزمة القوائم الخاصة بالذاكرة المشتركة، والمصمَّمة على أساس حزمة قوائم BSD (queue.h)، محل كل تلك الحلول. وبعد أن جرى تنقيحها، لم نضطر أبدًا إلى تنقيح مشكلة أخرى في القوائم المترابطة للذاكرة المشتركة. ويوضح هذا ثلاثة مبادئ تصميمية مهمة: أولًا، إن كانت لديك وظيفة تتكرر أكثر من مرة، فاكتب الدوال المشتركة واستخدمها، لأن مجرد وجود نسختين من أي وظيفة محددة في شيفرتك يضمن أن إحداهما منفَّذة على نحو خاطئ. ثانيًا، حين تطوّر مجموعة من الدوال العامة الغرض، فاكتب مجموعة اختبارات لتلك الدوال كي تتمكّن من تنقيحها بشكل منعزل. ثالثًا، كلما كانت الشيفرة أصعب في الكتابة، كان استخراجها وكتابتها وصيانتها على نحو منفصل أهم؛ فشبه المستحيل منع الشيفرة المحيطة من إصابتها والتآكل فيها.
4.6. مدير المخازن المؤقتة: Mpool
نظام Berkeley DB الفرعي Mpool هو مجمّع مخازن مؤقتة في الذاكرة لصفحات الملفات، يخفي حقيقة أن الذاكرة الرئيسية مورد محدود، مما يفرض على المكتبة نقل صفحات قواعد البيانات من القرص وإليه عند التعامل مع قواعد بيانات أكبر من الذاكرة. وكان تخزين صفحات قواعد البيانات مؤقتًا في الذاكرة هو ما مكّن مكتبة التجزئة الأصلية من التفوّق بدرجة كبيرة على التنفيذيات التاريخية hsearch و ndbm.
ورغم أن طريقة الوصول Btree في Berkeley DB هي تنفيذ لشجرة B+tree تقليدي إلى حدٍّ كبير، فإن المؤشرات بين عُقد الشجرة ممثَّلة كأرقام صفحات لا كمؤشرات فعلية في الذاكرة، لأن تنفيذ المكتبة يستخدم صيغة القرص بوصفها صيغة الذاكرة أيضًا. وميزة هذا التمثيل أنه يمكن تفريغ الصفحة من الذاكرة المؤقتة دون تحويل الصيغة؛ أما عيبه فهو أن اجتياز بنية فهرسة يتطلّب عمليات بحث متكررة (أعلى كلفة) في مجمّع المخازن المؤقتة بدلًا من توجيهات ذاكرة (أقل كلفة).
هناك آثار أخرى على الأداء تنبع من الافتراض الأساسي القائل بأن تمثيل مؤشرات Berkeley DB في الذاكرة هو في الحقيقة ذاكرة مؤقتة (cache) لبيانات ثابتة على القرص. على سبيل المثال، كلما وصلت Berkeley DB إلى صفحة مخزَّنة مؤقتًا، فإنها أولًا تثبّت الصفحة (pins) في الذاكرة. وهذا التثبيت يمنع أي خيوط أو عمليات أخرى من إخراجها من مجمّع المخازن المؤقتة. وحتى لو كانت بنية فهرسة تتّسع بالكامل في الذاكرة المؤقتة ولا تحتاج إطلاقًا إلى تفريغها على القرص، فإن Berkeley DB تظل تكتسب هذه التثبيتات وتحرّرها في كل وصول، لأن النموذج الأساسي الذي يوفره Mpool هو ذاكرة مؤقتة، لا تخزينًا ثابتًا.
4.6.1. تجريد الملف في Mpool
يفترض Mpool أنه يقع فوق نظام ملفات، ويصدّر تجريد الملف عبر الواجهة البرمجية. على سبيل المثال، تمثّل مقابض DB_MPOOLFILE ملفًا على القرص، وتوفّر توابع لجلب الصفحات من الملف ووضعها فيه. ورغم أن Berkeley DB تدعم قواعد البيانات المؤقتة وقواعد البيانات الموجودة في الذاكرة خالصة، فإن هذه أيضًا يُشار إليها بمقابض DB_MPOOLFILE بسبب تجريدات Mpool الأساسية. وتُعد توابع get و put الواجهات البرمجية الأساسية لـ Mpool: فـ get تضمن وجود الصفحة في الذاكرة المؤقتة وتكتسب تثبيتًا (pin) عليها وتعيد مؤشرًا إلى الصفحة. وعندما تنتهي المكتبة من الصفحة، فإن استدعاء put يفكّ التثبيت عنها ويحرّرها لتُخرَج من الذاكرة المؤقتة. ولم تميّز الإصدارات المبكرة من Berkeley DB بين تثبيت الصفحة لأغراض القراءة وتثبيتها لأغراض الكتابة. لكن غينا زيادة التوازي، وسّعنا واجهة Mpool البرمجية لتتيح للمُستدعين الإفصاح عن بنيّتهم تحديث الصفحة. وكانت هذه القدرة على التمييز بين وصول القراءة ووصول الكتابة ضرورية لتنفيذ التحكم بالتوازي متعدد الإصدارات (multi-version concurrency control). فالصفحة المثبَّتة لأغراض القراءة، إن كانت متّسخة (dirty)، يمكن كتابتها على القرص، بينما الصفحة المثبَّتة لأغراض الكتابة لا يمكن ذلك، لأنها قد تكون في حالة غير متّسقة في أي لحظة.
4.6.2. التسجيل المسبق للكتابة
تستخدم Berkeley DB أسلوب التسجيل المسبق للكتابة (write-ahead logging، WAL) كآلية معاملاتها لجعل التعافي بعد الأعطال ممكنًا. ويعرّف مصطلح التسجيل المسبق للكتابة سياسة تشترط أن تُنشر سجلات السجل (log records) التي تصف أي تغيير إلى القرص قبل تحديثات البيانات الفعلية التي تصفها. ولاستخدام Berkeley DB لـ WAL كآلية معاملات فيها آثار مهمّة على Mpool، وعلى Mpool أن يوازن بين موقعه التصميمي كآلية تخزين مؤقت عامة وبين حاجته إلى دعم بروتوكول WAL.
تكتب Berkeley DB أرقام تسلسل السجل (log sequence numbers، LSNs) على جميع صفحات البيانات لتوثيق سجل السجل المقابل لآخر تحديث لصفحة بعينها. ويفرض تطبيق WAL أن يتحقق Mpool، قبل كتابة أي صفحة على القرص، من أن سجل السجل المقابل للـ LSN الموجود على الصفحة موجود بأمان على القرص. والتحدي التصميمي هو كيفية توفير هذه الوظيفة دون اشتراط أن تستخدم جميع جهات الاتصال بـ Mpool صيغة صفحة مطابقة للصيغة التي تستخدمها Berkeley DB. ويعالج Mpool هذا التحدي بتوفير مجموعة من توابع set (و get) لتوجيه سلوكه. ويوفّر تابع Mpool DB_MPOOLFILE المسمّى set_lsn_offset إزاحة بالبايت داخل الصفحة، تحدّد أين ينبغي لـ Mpool أن يبحث عن LSN لفرض WAL. وإذا لم يُستدعَ هذا التابع أبدًا، فلا يفرض Mpool بروتوكول WAL. وبالمثل، يحدّد تابع set_clearlen لـ Mpool عدد البايتات في الصفحة التي تمثّل بيانات وصفية (metadata) ينبغي مسحها صراحةً عند إنشاء الصفحة في الذاكرة المؤقتة. وتتيح هذه الواجهات البرمجية لـ Mpool توفير الوظائف اللازمة لدعم المتطلبات المعاملية لـ Berkeley DB، دون إجبار جميع مستخدمي Mpool على فعل الشيء نفسه.
الدرس التصميمي الثامن
يُعدّ التسجيل المسبق للكتابة مثالًا آخر على توفير التجريد (encapsulation) والطبقات (layering)، حتى عندما لا يُحتفظ بأن الوظيفة ستكون مفيدة أبدًا لقطعة برمجية أخرى: فكم برنامجًا في العالم يهتم بأرقام LSN في الذاكرة المؤقتة؟ ومع ذلك، فالانضباط مفيد ويجعل البرمجيات أسهل في الصيانة والاختبار والتنقيح والتوسّع.
4.7. مدير الأقفال: Lock
مثل Mpool، صُمِّم مدير الأقفال كمكوّن عام الغرض: مدير أقفال هرمي (انظر GLPT76)، صُمِّم لدعم تدرّج هرمي من الكائنات القابلة للقفل (مثل عناصر البيانات المفردة، والصفحة التي يقع عليها عنصر بيانات، والملف الذي يقع فيه عنصر بيانات، أو حتى مجموعة من الملفات). وبينما نصف ميزات مدير الأقفال، سنشرح أيضًا كيف تستخدمها Berkeley DB. لكن كما في Mpool، من المهم أن نتذكّر أن تطبيقات أخرى تستطيع استخدام مدير الأقفال بطرق مختلفة تمامًا، وهذا مقبول—فقد صُمِّم ليكون مرنًا ويدعم استخدامات مختلفة كثيرة.
يمتلك مدير الأقفال ثلاثة تجريدات (abstractions) رئيسية: «الخزانة» (locker) التي تحدّد نيابة مَن يُكتسب القفل، و«كائن القفل» (lock_object) الذي يحدّد العنصر المقفول، و«مصفوفة التعارض» (conflict matrix).
الخزانات (Lockers) أعداد صحيحة غير موقّعة بطول 32 بت. وتقسم Berkeley DB هذا فضاء الأسماء بطول 32 بت إلى خزانات معاملية (transactional) وغير معاملية (non-transactional) (مع أن هذا التمييز شفّاف بالنسبة إلى مدير الأقفال). وحين تستخدم Berkeley DB مدير الأقفال، فإنها تخصّص مُعرّفات خزانات في المدى من 0 إلى 0x7fffffff للخزانات غير المعاملية، وفي المدى من 0x80000000 إلى 0xffffffff للمعاملات. على سبيل المثال، حين يفتح تطبيق قاعدة بيانات، تكتسب Berkeley DB قفل قراءة طويل الأمد على تلك قاعدة البيانات لضمان عدم إزالة خيط تحكّم آخر لها أو إعادة تسميتها ما دامت قيد الاستخدام. ولأن هذا قفل طويل الأمد، فلا ينتمي إلى أي معاملة، والخزانة الحاملة لهذا القفل غير معاملية.
يحتاج أي تطبيق يستخدم مدير الأقفال إلى تخصيص مُعرّفات خزانات، لذا توفّر واجهة مدير الأقفال البرمجية كلا من الاستدعاءين DB_ENV->lock_id و DB_ENV->lock_id_free لتخصيص الخزانات وتحريرها. وبذلك لا تحتاج التطبيقات إلى تنفيذ مخصّص مُعرّفات خزانات خاص بها، وإن كان بإمكانها ذلك بالطبع.
4.7.1. كائنات الأقفال
كائنات الأقفال سلاسل بايتات معتمة (opaque) وطولها عشوائي، تمثّل الكائنات المقفولة. وحين يريد خزانان مختلفان قفل كائن بعينه، فإنهما يستخدمان سلسلة البايتات المعتمة نفسها للإشارة إلى ذلك الكائن. أي أن المسؤولية تقع على التطبيق في الاتفاق على اتفاقيات (conventions) لوصف الكائنات في صورة سلاسل البايتات المعتمة.
على سبيل المثال، تستخدم Berkeley DB بنية DB_LOCK_ILOCK لوصف أقفال قواعد بياناتها. وتحتوي هذه البنية على ثلاثة حقول: مُعرِّف ملف، ورقم صفحة، ونوع.
في كل الحالات تقريبًا، تحتاج Berkeley DB إلى وصف الملف والصفحة المحدَّدين اللذين تريد قفلهما فقط. وتخصّص Berkeley DB رقمًا فريدًا بطول 32بت لكل قاعدة بيانات عند وقت الإنشاء، وتكتبه في صفحة البيانات الوصفية لتلك القاعدة، ثم تستخدمه بوصفه المُعرِّف الفريد لقاعدة البيانات في أنظمة Mpool والأقفال والتسجيل. وهذا هو fileid الذي نشير إليه في بنية DB_LOCK_ILOCK. ومن غير المفاجئ أن يُشير رقم الصفحة إلى أي صفحة من قاعدة البيانات تلك نريد قفلها. وحين نشير إلى أقفال الصفحات، فإننا نضبط حقل النوع في البنية على DB_PAGE_LOCK. لكن يمكننا أيضًا قفل أنواع أخرى من الكائنات عند الحاجة. وكما ذُكر في السابق، فإننا نقفل أحيانًا مقبض قاعدة البيانات، وهو ما يتطلّب نوع DB_HANDLE_LOCK. ويسمح لنا نوع DB_RECORD_LOCK بتنفيذ القفل على مستوى السجل في طريقة الوصول Queue، ويسمح لنا نوع DB_DATABASE_LOCK بقفل قاعدة بيانات بأكملها.
الدرس التصميمي التاسع
اتُّخذ اختيار Berkeley DB لاستخدام القفل على مستوى الصفحة لأسباب وجيهة، لكننا وجدنا أن هذا الاختيار أحيانًا ما يكون إشكاليًا. فالقفل على مستوى الصفحة يحدّ من توازي التطبيق، إذ يمنع خيط تحكّم واحد يعدّل سجلًا في صفحة قاعدة بيانات خيوط التحكم الأخرى من تعديل سجلات أخرى في الصفحة نفسها، بينما تسمح أقفال مستوى السجل بهذا التوازي ما دام خيطا التحكم لا يعدّلان السجل نفسه. ويكمن القفل على مستوى الصفحة في أنه يزيد الاستقرار لأنه يحدّ من عدد مسارات التعافي الممكنة (فالصورة تكون دائمًا في إحدى حالتين أو حالتين أثناء التعافي، على خلاف العدد اللانهائي من الحالات الممكنة التي قد تكون فيها الصفحة إذا أُضيفت سجلات إليها وحُذفت منها). وبما أن Berkeley DB صُمِّمت للاستخدام كنظام مدمج (embedded system) لا يتوفّر فيه مدير قواعد بيانات لإصلاح الأمور في حال حدوث تلف، فقد اخترنا الاستقرار على حساب زيادة التوازي.
4.7.2. مصفوفة التعارض
آخر تجريد في نظام الأقفال الفرعي سنناقشه هو مصفوفة التعارض. وتعرّف مصفوفة التعارض أنواع الأقفال المختلفة الموجودة في النظام وكيف تتفاعل. لنسمِّ الكيان الحامل للقفل «الحامل» (holder) والكيان طالب القفل «الطالب» (requester)، ولنفترض أيضًا أن للحامل والطالب مُعرّفي خزان مختلفين. مصفوفة التعارض مصفوفة مفهرسة بـ [requester][holder]، حيث يحتوي كل مدخل على صفر إذا لم يكن هناك تعارض، ما يدل على أن القفل المطلوب يمكن منحه، وعلى واحد إذا كان هناك تعارض، ما يدل على أن الطلب لا يمكن منحه.
يحتوي مدير الأقفال على مصفوفة تعارض افتراضية، وهي على وجه الدقة ما تحتاجه Berkeley DB، لكن التطبيق حرٌّ في تصميم أوضاع أقفال خاصة به ومصفوفة تعارض تناسب أغراضه. والشرط الوحيد على مصفوفة التعارض أنها مربّعة (لها عدد صفوف مساوٍ لعدد الأعمدة) وأن يستخدم التطبيق أعدادًا صحيحة متسلسلة تبدأ من 0 لوصف أوضاع أقفاله (مثل القراءة والكتابة إلخ). ويعرض الجدول 4.2 مصفوفة تعارض Berkeley DB.
| Holder | |||||||||
|---|---|---|---|---|---|---|---|---|---|
| Requester | No-Lock | Read | Write | Wait | iWrite | iRead | iRW | uRead | wasWrite |
| No-Lock | |||||||||
| Read | ✓ | ✓ | ✓ | ✓ | |||||
| Write | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | |
| Wait | |||||||||
| iWrite | ✓ | ✓ | ✓ | ✓ | |||||
| iRead | ✓ | ✓ | |||||||
| iRW | ✓ | ✓ | ✓ | ✓ | |||||
| uRead | ✓ | ✓ | ✓ | ||||||
| iwasWrite | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
الجدول 4.2: مصفوفة تعارض القراءة والكتابة.
4.7.3. دعم الأقفال الهرمية
قبل شرح أوضاع الأقفال المختلفة في مصفوفة تعارض Berkeley DB، لنتحدث عن كيفية دعم النظام الفرعي للأقفال للقفل الهرمي. والقفل الهرمي هو القدرة على قفل عناصر مختلفة ضمن تدرّج احتواء (hierarchy). على سبيل المثال، تحتوي الملفات على صفحات، وتحتوي الصفحات على عناصر فردية. وحين نعدّل عنصرًا واحدًا في صفحة ضمن نظام أقفال هرمي، نريد قفل ذلك العنصر وحده؛ أما إذا كنا نعدّل كل عناصر الصفحة، فالأكثر كفاءة هو قفل الصفحة ببساطة، وإذا كنا نعدّل كل الصفحات في ملف، فالأفضل قفل الملف بأكمله. وإلى جانب ذلك، يجب أن يفهم القفل الهرمي تدرّج الحاويات (containers)، لأن قفل صفحة يقول الشيء نفسه أيضًا عن قفل الملف: لا يمكنك تعديل الملف الذي يحتوي صفحة ما في الوقت نفسه الذي تُعدَّل فيه صفحات في ذلك الملف.
السؤال إذن هو كيف نسمح لخزانات مختلفة بالقفل على مستويات هرمية مختلفة دون أن ينتج عن ذلك فوضى. والجواب يكمن في بنية تُسمّى قفل النية (intention lock). يكتسب الخزان قفل نيّة على حاوية للدلالة على نيّته قفل أشياء داخل تلك الحاوية. وهكذا، فإن الحصول على قفل قراءة على صفحة يستلزم الحصول على قفل نيّة القراءة على الملف. وبالمثل، لكتابة عنصر واحد في صفحة، عليك اكتساب قفل نيّة الكتابة على الصفحة وعلى الملف معًا. وفي مصفوفة التعارض أعلاه، فإن الأقفال iRead و iWrite و iWR هي جميعها أقفال نيّة تدلّ على نيّة القراءة أو الكتابة أو كليهما على التوالي.
لذلك، عند إجراء قفل هرمي، وبدلًا من طلب قفل واحد على شيء ما، من الضروري طلب أقفال محتملة كثيرة: القفل على الكيان الفعلي فضلًا عن أقفال النية على أي كيانات حاوية. وقد أدّت هذه الحاجة إلى واجهة Berkeley DB DB_ENV->lock_vec، التي تأخذ مصفوفة من طلبات الأقفال وتمنحها (أو ترفضها) بشكل ذرّي (atomically).
ورغم أن Berkeley DB لا تستخدم الأقفال الهرمية داخليًا، فإنها تستفيد من القدرة على تحديد مصفوفات تعارض مختلفة، ومن القدرة على تحديد طلبات أقفال متعددة في آن واحد. ونستخدم مصفوفة التعارض الافتراضية عند توفير الدعم المعاملي، لكن نستخدم مصفوفة تعارض مختلفة لتوفير وصول متزامن بسيط دون دعم معاملي أو تعافٍ. ونستخدم DB_ENV->lock_vec لأداء اقتران الأقفال (lock coupling)، وهي تقنية تعزّز توازي اجتيازات Btree Com79. وفي اقتران الأقفال، تحتفظ بقفل واحد مدة تكفي فقط لاكتساب القفل التالي. أي أنك تقفل صفحة داخلية في Btree مدة تكفي فقط لقراءة المعلومات التي تتيح لك اختيار صفحة في المستوى التالي وقفلها.
الدرس التصميمي العاشر
كان تصميم Berkeley DB العام الغرض محلّ تقدير كبير حين أضفنا وظيفة مخزن بيانات متزامن (concurrent data store). فقد وفّرت Berkeley DB في البداية وضعَي تشغيل فقط: إما أن تشغّل دون أي توافقية كتابة، أو مع دعم معاملي كامل. ويحمل الدعم المعاملي قدرًا من التعقيد للمطوّر، تبيّن لنا أن بعض التطبيقات تريد توافقية محسَّنة دون التكلفة الكاملة للدعم المعاملي الكامل. ولتوفير هذه الميزة، أضفنا دعمًا للقفل على مستوى الواجهة البرمجية (API-level locking) يتيح التوافقية مع ضمان عدم حدوث جمود (deadlocks). وقد تطلّب ذلك وضع قفل جديدًا ومختلفًا للعمل في وجود المؤشرات. وبدلًا من إضافة شيفرة مخصّصة لغرض معيّن إلى مدير الأقفال، تمكّنّا من إنشاء مصفوفة أقفال بديلة تدعم أوضاع الأقفال الضرورية للقفل على مستوى الواجهة البرمجية فقط. وبذلك، وبمجرد ضبط مدير الأقفال بشكل مختلف، تمكّنّا من توفير دعم الأقفال الذي احتجناه. (ولأسف، لم يكن تغيير طرق الوصول بالأمر بهذه البساطة؛ فما زالت هناك أجزاء كبيرة من شيفرة طرق الوصول تحتاج إلى معالجة هذا الوضع الخاص من الوصول المتزامن.)
4.8. مدير السجل: Log
يوفّر مدير السجل تجريد ملف منظَّم يُلحق به فقط (append-only). وكما في الوحدات الأخرى، كنا نعتزم تصميم منشأة تسجيل (logging facility) عامة الغرض، لكن نظام التسجيل الفرعي هو على الأرجح الوحدة التي كنّا الأقل نجاحًا فيها.
الدرس التصميمي الحادي عشر
حين تصادف مشكلة معمارية لا تريد إصلاحها «الآن» وتميل إلى تركها فحسب، فتذكّر أن موتك موتًا بطيئًا لا يقلّ فتكًا بموتك منطحقًا فيلًا من الفيلة. لا تتردد أكثر من اللازم في تغيير الأطر الكاملة لتحسين بنية البرمجيات، وحين تجري التغييرات، فلا تجرِ تغييرًا جزئيًا على فكرة أنك ستُنظّف لاحقًا—افعل كل شيء ثم تقدّم. وكما تكرر كثيرًا: «إن لم يكن لديك الوقت للقيام بذلك الآن، فلن تجد الوقت للقيام به لاحقًا.» وأثناء تغييرك للإطار، فاكتب أيضًا هيكل الاختبارات.
السجل بسيط إلى حد كبير من حيث المفهوم: فهو يأخذ سلاسل بايتات معتمة ويكتبها تسلسليًا في ملف، ويخصّص لكلٍّ منها مُعرِّفًا فريدًا يُسمّى رقم تسلسل السجل (LSN). وإضافةً إلى ذلك، يجب أن يوفّر السجل اجتيازًا واسترجاعًا كفيفين في الاتجاهين، الأمامي والخلفي، بالإضافة إلى الاسترجاع بحسب LSN. وهناك جانبان صعبان: أولًا، يجب أن يضمن السجل أنه في حالة متّسقة بعد أي عطل محتمل (بمعنى أن يحتوي على تسلسل متّصل من سجلات السجل غير التالفة)؛ ثانيًا، ولأن سجلات السجل يجب أن تُكتب في تخزين ثابت حتى تُودَع المعاملات، فإن أداء السجل هو عادةً ما يحدّ من أداء أي تطبيق معاملي.
ولأن السجل بنية بيانات تُلحق بها فقط،,يمكنأنه أن ينمو بلا حد. وننفّذ السجل كمجموعة ملفات مرقّمة تسلسليًا، لذا يمكن استرداد مساحة السجل ببساطة عبر إزالة ملفات السجل القديمة. ونظرًا لبنية السجل متعددة الملفات، نشكّل أرقام LSN كأزواج تحدّد رقم ملف وإزاحة داخل الملف. وبذلك، عند وجود LSN، يكون الأمر تافهًا لمدير السجل أن يحدد موقع السجل: إذ ينتقل إلى الإزاحة المعطاة في ملف السجل المعطى ويعيد السجل المكتوب في ذلك الموقع. لكن كيف يعرف مدير السجل كم بايتًا عليه أن يُعيد من ذلك الموقع؟
4.8.1. تنسيق سجلات السجل
يجب أن يحتفظ السجل ببيانات وصفية لكل سجل (per-record metadata) بحيث يتمكّن مدير السجل، عند وجود LSN، من تحديد حجم السجل الذي يُعيده. ويحتاج على الأقل إلى معرفة طول السجل. ونُسبق كل سجل سجل بترويسة (log record header) تحتوي على طول السجل، وإزاحة السجل السابق (لتسهيل الاجتياز الخلفي)، وبصمة تحقّق (checksum) لسجل السجل (لتحديد تلف السجل ونهاية ملف السجل). وهذه البيانات الوصفية كافية لمدير السجل كي يحافظ على تسلسل سجلات السجل، لكنها ليست كافية لتنفيذ التعافي فعليًا؛ فتلك الوظيفة مُرمَّزة في محتويات سجلات السجل وفي كيفية استخدام Berkeley DB لتلك السجلات.
تستخدم Berkeley DB مدير السجل لكتابة الصور السابقة واللاحقة (before- and after-images) للبيانات قبل تحديث عناصر في قاعدة البيانات HR83. وتحتوي سجلات السجل هذه على معلومات كافية لإعادة تنفيذ (redo) عمليات على قاعدة البيانات أو التراجع (undo) عنها. ثم تستخدم Berkeley DB السجل لأغراض الإلغاء المعاملي (transaction abort) — أي التراجع عن أي آثار لمعاملة ما عند إبطالها — ولأغراض التعافي بعد فشل التطبيق أو النظام.
إلى جانب الواجهات البرمجية لقراءة سجلات السجل وكتابتها، يوفّر مدير السجل واجهة برمجية تُجبر سجلات السجل على الكتابة على القرص (DB_ENV->log_flush). وهذا يتيح لـ Berkeley DB تنفيذ التسجيل المسبق للكتابة—فقبل إخراج صفحة من Mpool، تفحص Berkeley DB قيمة LSN على الصفحة وتطلب من مدير السجل أن يضمن وجود LSN المحدَّد في تخزين ثابت. وعندئذٍ فقط يكتب Mpool الصفحة على القرص.
الدرس التصميمي الثاني عشر
يستخدم Mpool و Log توابع المقابض الداخلية لتسهيل التسجيل المسبق للكتابة، وفي بعض الحالات يكون تصريح التابع أطول من الشيفرة التي ينفّذها، لأن الشيفرة غالبًا ما تقارن قيمتين صحيحتين فحسب. ولماذا نتكفّل بهذه التوابع عديمة الأهمية، لمجرد الحفاظ على طبقة متّسقة؟ لأن إذا لم تكن شيفرتك موجَّهة نحو الكائنات بالدرجة التي تُوجع أسنانك، فهي ليست موجَّهة نحو الكائنات بما يكفي. وينبغي لكل قطعة شيفرة أن تقوم بعدد قليل من الأشياء، وأن يكون هناك تصميم عالي المستوى يشجّع المبرمجين على بناء الوظائف من كتل وظيفية أصغر، وهكذا. وإن كان هناك أي شيء تعلّمناه عن هندسة البرمجيات خلال العقود القليلة الماضية، فهو أن قدرتنا على بناء وصيانة القطع البرمجية الكبيرة هشّة. فبناء البرمجيات الكبيرة وصيانتها صعب وعرضة للخطأ، وأنت كمهندس برمجيات عليك أن تفعل كل ما تستطيع فعله، وفي أبكر وقت تستطيع، وبأقصى تكرار تستطيع، لتقلّص أقصى قدر من المعلومات في بنية برمجياتك.
يفرض Berkeley DB بنية على سجلات السجل لتسهيل التعافي. تصف معظم سجلات Berkeley DB تحديثات معاملية. وهكذا، تقابل معظم سجلات السجل تعديلات صفحات في قاعدة بيانات، أُجريت نيابةً عن معاملة. ويوفّر هذا الوصف الأساس لتحديد البيانات الوصفية التي يجب أن يُرفقها Berkeley DB بكل سجل سجل: قاعدة بيانات، ومعاملة، ونوع سجل. وتوجد حقولا مُعرِّف المعاملة ونوع السجل في كل سجل في الموقع نفسه. وهذا يتيح لنظام التعافي استخراج نوع السجل وتوجيه السجل إلى معالِج مناسب يستطيع تفسير السجل وتنفيذ الإجراءات الملائمة. ويتيح مُعرِّف المعاملة لعملية التعافي تحديد المعاملة التي ينتمي إليها سجل السجل، بحيث يعرف أثناء المراحل المختلفة للتعافي ما إذا كان السجل يمكن تجاهله أم يجب معالجته.
4.8.2. كسر التجريد
هناك أيضًا عدد قليل من سجلات السجل «الخاصة». وسجلات نقاط الفحص (checkpoint records) هي على الأرجح أكثر تلك السجلات الخاصة شيوعًا. ونقطة الفحص (checkpointing) هي عملية جعل حالة قاعدة البيانات على القرص متّسقة اعتبارًا من لحظة زمنية ما. بمعنى آخر، تخزّن Berkeley DB صفحات قواعد البيانات مؤقتًا وبقوة في Mpool لأداء أفضل. لكن هذه الصفحات يجب أن تُكتب على القرص في النهاية، وكلما أسرعنا في ذلك، ازددنا سرعةً في التعافي عند فشل التطبيق أو النظام. ويفيد هذا مفاضلة (trade-off) بين تكرار نقاط الفحص وطول التعافي: كلما أخذ النظام نقاط فحص أكثر، تمكّن من التعافي أسرع. ونقطة الفحص وظيفة معاملية، لذا سنصف تفاصيلها في القسم التالي. ولأغراض هذا القسم، سنتحدث عن سجلات نقاط الفحص وكيف يتعثر مدير السجل بين كونه وحدة مستقلة بالدرجة الأولى وكونه مكوّنًا خاصًا في Berkeley DB.
بوجه عام، لا يملك مدير السجل بحد ذاته أي تصور لأنواع السجلات، لذا نظريًا لا ينبغي له أن يميّز بين سجلات نقاط الفحص والسجلات الأخرى—فهي ببساطة سلاسل بايتات معتمة يكتبها مدير السجل على القرص. لكن عمليًا، يحتفظ السجل ببيانات وصفية تكشف أنه يفهم محتوى بعض السجلات. على سبيل المثال، أثناء إقلاع السجل، يفحص مدير السجل جميع ملفات السجل التي يستطيع العثور عليها لتحديد آخر ملف سجل كُتب. ويفترض أن جميع ملفات السجل السابقة لذلك الملف مكتملة وسليمة، ثم يشرع في فحص أحدث ملف سجل وتحديد أي مقدار منه يحتوي على سجلات سجل صالحة. ويقرأ من بداية ملف السجل، ويتوقف إذا/عندما يصطدم بترويسة سجل سجل لا يجتاز فحص البصمة، وهو ما يشير إما إلى نهاية السجل أو إلى بداية تلف في ملف السجل. وفي كلتا الحالتين، يحدد النهاية المنطقية للسجل.
أثناء هذه العملية التي يقرأ بها السجل ليحدد نهايته الحالية، يستخرج مدير السجل نوع سجل Berkeley DB، بحثًا عن سجلات نقاط الفحص. ويحتفظ بموضع آخر سجل نقطة فحص يعثر عليه في البيانات الوصفية لمدير السجل كـ«خدمة» لنظام المعاملات. أي أن نظام المعاملات يحتاج إلى العثور على آخر نقطة فحص، لكن بدلًا من أن يقرأ كلٌّ من مدير السجل ومدير المعاملات ملف السجل بأكمله لفعل ذلك، يُفوّض مدير المعاملات تلك المهمة إلى مدير السجل. وهذه مثال كلاسيكي على انتهاك حدود التجريد مقابل الأداء.
ما نتائج هذه المفاضلة؟ تخيّل أن نظامًا غير Berkeley DB يستخدم مدير السجل. إذا وقع أن يكتب القيمة المقابلة لنوع سجل نقطة الفحص في الموضع نفسه الذي تضع فيه Berkeley DB نوع سجلها، فإن مدير السجل سيتعرّف على ذلك السجل بوصفه سجل نقطة فحص. لكن ما لم يطلب التطبيق من مدير السجل تلك المعلومة (عبر الوصول المباشر إلى الحقل cached_ckp_lsn في البيانات الوصفية للسجل)، فلن تؤثر هذه المعلومة في أي شيء. وباختصار، فهذا إما انتهاك ضار لطبقات التجريد أو تحسين أداء ماهر.
إدارة الملفات موضع آخر يكون فيه الفصل بين مدير السجل و Berkeley DB ضبابيًا. وكما ذُكر في السابق، يتعيّن على معظم سجلات Berkeley DB أن تحدّد قاعدة بيانات. ويمكن أن يحتوي كل سجل سجل على اسم الملف الكامل لقاعدة البيانات، لكن ذلك سيكون مكلفًا من حيث مساحة السجل، وغير عملي، لأن التعافي سيضطر إلى مطابقة ذلك الاسم مع نوع ما من المقابض يستطيع استخدامه للوصول إلى قاعدة البيانات (إما واصف ملف (file descriptor) أو مقبض قاعدة بيانات). وبدلًا من ذلك، تحدّد Berkeley DB قواعد البيانات في السجل بمُعرِّف عدد صحيح، يُسمّى مُعرِّف ملف السجل (log file id)، وتنفّذ مجموعة من الدوال تُسمّى dbreg (لـ«تسجيل قواعد البيانات»، database registration) للصيانة على الربط بين أسماء الملفات ومُعرِّفات ملفات السجل. وتُكتب النسخة الدائمة من هذا الربط (بنوع السجل DBREG_REGISTER) في سجلات السجل عند فتح قاعدة البيانات. لكننا نحتاج أيضًا إلى تمثيلات في الذاكرة لهذا الربط لتسهيل الإلغاء المعاملي والتعافي. فما النظام الفرعي الذي ينبغي أن يكون مسؤولًا عن صيانة هذا الربط؟
نظريًا، يمثّل ربط الملفات بمُعرِّفات ملفات السجل وظيفة عالية المستوى في Berkeley DB؛ فهو لا ينتمي إلى أي من الأنظمة الفرعية، التي قُصد أن تكون غافلة عن الصورة الأكبر. وفي التصميم الأصلي، تُركت هذه المعلومة في بنى بيانات نظام التسجيل الفرعية لأن نظام التسجيل بدا الخيار الأفضل. لكن بعد أن وجدنا وأصلحنا أخطاء في التنفيذ مرارًا وتكرارًا، نُقل دعم الربط خارج شيفرة نظام التسجيل الفرعي إلى نظام فرعي صغير خاص به، له واجهاته الموجَّهة نحو الكائنات وبنى بياناته الخاصة. (وفي ضوء النظر المتأخر، كان ينبغي منطقيًا أن توضع هذه المعلومة مع معلومات بيئة Berkeley DB نفسها، خارج أي نظام فرعي.)
الدرس التصميمي الثالث عشر
نادرًا ما يوجد ما يُسمّى خطأ غير مهم. صحيح، هناك خطأ مطبعي من حين لآخر، لكن الخطأ عادةً ما يعني أن أحدهم لم يفهم تمامًا ما كان يفعله ونفّذ الشيء الخطأ. وحين تُصلح خطأ، فلا تبحث عن العَرَض: ابحث عن السبب الكامن، أي سوء الفهم إن شئت، لأن ذلك يقود إلى فهم أفضل لبنية البرنامج فضلًا عن كشف عيوب جوهرية كامنة في التصميم نفسه.
4.9. مدير المعاملات: Txn
وحدتنا الأخيرة هي مدير المعاملات، الذي يربط المكونات الفردية لتوفير الخصائص المعاملية ACID: الذرّية (atomicity)، والاتّساق (consistency)، والعزل (isolation)، والديمومة (durability). ومدير المعاملات مسؤول عن بدء المعاملات وإتمامها (إما بالإيداع (commit) أو بالإلغاء (abort))، وتنسيق مدير السجل ومدير المخازن المؤقتة لأخذ نقاط فحص المعاملات، وتوجيه التعافي. وسنزور كلًّا من هذه المجالات بالترتيب.
ابتكر Jim Gray الاختصار ACID لوصف الخصائص الجوهرية التي توفّرها المعاملات Gra81. وتعني الذرّية أن جميع العمليات المنفَّذة داخل معاملة تظهر في قاعدة البيانات كوحدة واحدة—فهي إما أن تكون جميعها حاضرة في قاعدة البيانات أو جميعها غائبة. وتعني الاتّساق أن المعاملة تنقل قاعدة البيانات من حالة منطقية متّسقة إلى حالة أخرى. على سبيل المثال، إذا حدّد التطبيق أن على جميع الموظفين أن يكونوا منسبين إلى قسم موصوف في قاعدة البيانات، فإن خاصية الاتّساق تفرض ذلك (مع معاملات مكتوبة على نحو صحيح). وتعني العزل أنه من منظور معاملة ما، يبدو كأن المعاملة تعمل تسلسليًا دون أي معاملات متزامنة قيد التشغيل. وأخيرًا، تعني الديمومة أنه بمجرد إيداع معاملة تبقى مُودعة—ولا يستطيع أي فشل أن يُبطل معاملة مُودعة.
يفرض النظام الفرعي للمعاملات خصائص ACID، بمساعدة بقية الأنظمة الفرعية. وهو يستخدم عمليات بدء المعاملة وإيداعها وإلغائها التقليدية لتحديد نقطتي بداية المعاملة ونهايتها. كما يوفّر استدعاء prepare، الذي يتيح الإيداع على مرحلتين (two phase commit)، وهي تقنية لتوفير الخصائص المعاملية عبر المعاملات الموزّعة، وهي غير مشروحة في هذا الفصل. ويخصّص بدء المعاملة مُعرِّف معاملة جديدًا ويعيد مقبض معاملة، DB_TXN، إلى التطبيق. ويكتب إيداع المعاملة سجل «إيداع» في السجل ثم يُجبر السجل على الكتابة على القرص (ما لم يبدِ التطبيق راغبًا في التنازل عن الديمومة مقابل معالجة إيداع أسرع)، مما يضمن أن المعاملة ستكون مُودعة حتى في حال حدوث فشل. ويقرأ إلغاء المعاملة سجلات السجل الخاصة بالمعاملة المحدَّدة قراءة عكسية، مرتدًا بكل عملية أنجزتها المعاملة، عادِدة قاعدة البيانات إلى حالتها قبل المعاملة.
4.9.1. معالجة نقاط الفحص
مدير المعاملات مسؤول أيضًا عن أخذ نقاط الفحص. وهناك عدد من التقنيات المختلفة في الأدبيات لأخذ نقاط الفحص HR83. وتستخدم Berkeley DB صيغة من «نقطة الفحص غير الدقيقة» (fuzzy checkpointing). وجوهريًا، تتضمن نقاط الفحص كتابة مخازن Mpool المؤقتة على القرص. وهذه عملية قد تكون مكلفة، ومن المهم أن يواصل النظام معالجة معاملات جديدة أثناءها، تفاديًا لتوقف الخدمة الطويل. وفي بداية نقطة الفحص، تفحص Berkeley DB مجموعة المعاملات النشطة حاليًا للعثور على أدنى LSN كتبه أيٌّ منها. ويصبح هذا LSN هو LSN نقطة الفحص. ثم يطلب مدير المعاملات من Mpool تفريغ مخازنه المتّسخة على القرص؛ وقد تؤدّي كتابة تلك المخازن قد تُطلق عمليات تفريغ للسجل. وبعد أن تكون جميع المخازن على القرص بأمان، يكتب مدير المعاملات سجل نقطة فحص يحتوي على LSN نقطة الفحص. ويقول هذا السجل إن جميع العمليات التي تصفها سجلات السجل السابقة لـ LSN نقطة الفحص موجودة الآن بأمان على القرص. وبالتالي، لم تعد سجلات السجل السابقة لـ LSN نقطة الفحص ضرورية للتعافي. وهذا له أثران: أولًا، يستطيع النظام استرداد أي ملفات سجل سابقة لـ LSN نقطة الفحص. ثانيًا، لا يحتاج التعافي سوى معالجة السجلات التالية لـ LSN نقطة الفحص، لأن التحديثات التي تصفها السجلات السابقة لـ LSN نقطة الفحص تعكس في حالة قاعدة البيانات على القرص.
لاحظ أنه قد تكون هناك سجلات سجل كثيرة بين LSN نقطة الفحص وسجل نقطة الفحص الفعلي. وهذا لا بأس به، لأن تلك السجلات تصف عمليات وقعت منطقيًا بعد نقطة الفحص وقد يلزم تعافيها في حال فشل النظام.
4.9.2. التعافي
القطع الأخير من أحجية المعاملات هو التعافي. والهدف من التعافي هو نقل قاعدة البيانات على القرص من حالة يحتمل أن تكون غير متّسقة إلى حالة متّسقة. وتستخدم Berkeley DB مخططًا من مرحلتين تقليديًا إلى حدٍّ كبير، يقابل تقريبًا العبارة: «بالنسبة إلى آخر LSN نقطة فحص، تراجع عن أي معاملات لم تُودَع وأعد تنفيذ أي معاملات دُفِعت». والتفاصيل أكثر تعقيدًا بقليل.
تحتاج Berkeley DB إلى إعادة بناء ربطها بين مُعرِّفات ملفات السجل وقواعد البيانات الفعلية حتى تستطيع إعادة تنفيذ العمليات على قواعد البيانات وتراجع عنها. ويحتوي السجل على تاريخ كامل لسجلات DBREG_REGISTER، لكن بما أن قواعد البيانات تبقى مفتوحة مدة طويلة ولا نريد اشتراط بقاء ملفات السجل طوال فترة فتح قاعدة البيانات، نودّ طريقة أكثر كفاءة للوصول إلى هذا الربط. وقبل كتابة سجل نقطة فحص، يكتب مدير المعاملات مجموعة من سجلات DBREG_REGISTER تصف الربط الحالي بين مُعرِّفات ملفات السجل وقواعد البيانات. وأثناء التعافي، تستخدم Berkeley DB سجلات السجل هذه لإعادة بناء ربط الملفات.
حين يبدأ التعافي، يستعلم مدير المعاملات عن قيمة cached_ckp_lsn لدى مدير السجل لتحديد موقع آخر سجل نقطة فحص في السجل. ويحتوي هذا السجل على LSN نقطة الفحص. وتحتاج Berkeley DB إلى التعافي من ذلك LSN، لكن لكي تفعل ذلك عليها أن تعيد بناء ربط مُعرِّفات ملفات السجل الموجود عند LSN نقطة الفحص؛ وتظهر هذه المعلومة في نقطة الفحص ال سابقة لـ LSN نقطة الفحص. لذلك، يتعيّن على Berkeley DB أن تبحث عن آخر سجل نقطة فحص يقع قبل LSN نقطة الفحص. وتحتوي سجلات نقاط الفحص، لا على LSN نقطة الفحص فحسب، بل أيضًا على LSN نقطة الفحص السابقة لتسهيل هذه العملية. ويبدأ التعافي من أحدث نقطة فحص، ويستخدم الحقل prev_lsn في كل سجل نقطة فحص ليجتاز سجلات نقاط الفحص إلى الخلف عبر السجل حتى يجد سجل نقطة فحص يقع قبل LSN نقطة الفحص. وخوارزميًا:
ckp_record = read (cached_ckp_lsn)
ckp_lsn = ckp_record.checkpoint_lsn
cur_lsn = ckp_record.my_lsn
while (cur_lsn > ckp_lsn) {
    ckp_record = read (ckp_record.prev_ckp)
    cur_lsn = ckp_record.my_lsn
}
انطلاقًا من نقطة الفحص التي اختارتها الخوارزمية السابقة، يقرأ التعافي تسلسليًا حتى نهاية السجل لإعادة بناء ربط مُعرِّفات ملفات السجل. وحين يصل إلى نهاية السجل، يفترض أن تكون روابطه قد طابقت تمامًا الروابط التي كانت قائمة حين توقف النظام. وأثناء هذه المرور أيضًا، يتابع التعافي أي سجلات إيداع معاملات يصطدم بها، مسجّلًا مُعرِّفات معاملاتها. وأي معاملة تظهر لها سجلات في السجل لكن لا يظهر مُعرِّفها في أي سجل إيداع معاملة، فإنها إما أن تكون أُلغيت أو أنها لم تكتمل قط، ويجب معاملتها على أنها أُلغيت. وحين يصل التعافي إلى نهاية السجل، ينعكس الاتجاه ويبدأ القراءة إلى الخلف عبر السجل. ولكل سجل سجل معاملي يصطدم به، يستخرج مُعرِّف المعاملة ويستشير قائمة المعاملات التي دُفِعت ليحدد ما إذا كان ينبغي التراجع عن هذا السجل. وإذا وجد أن مُعرِّف المعاملة لا ينتمي إلى معاملة مُودعة، فإنه يستخرج نوع السجل ويستدعي إجراء تعافٍ لسجل السجل ذلك، موجّهًا إياه إلى التراجع عن العملية الموصوفة. وإذا كان السجل ينتمي إلى معاملة مُودعة، فيتجاهله التعافي في المرور الخلفي. ويستمر هذا المرور الخلفي حتى يعود إلى LSN نقطة الفحص[1]. وأخيرًا، يقرأ التعافي السجل مرة أخيرة في الاتجاه الأمامي، مع إعادة تنفيذ في هذه المرة أي سجلات سجل تنتمي إلى معاملات مُودعة. وحين يكتمل هذا المرور الأخير، يأخذ التعافي نقطة فحص. وعند هذه النقطة، تكون قاعدة البيانات متّسقة تمامًا وجاهزة لبدء تشغيل التطبيق.
وبالتالي، يمكن تلخيص التعافي فيما يأتي:
- أعثر على نقطة الفحص السابقة لـ LSN نقطة الفحص في أحدث نقطة فحص
- اقرأ إلى الأمام لاستعادة ربط مُعرِّفات ملفات السجل وأنشئ قائمة بالمعاملات المُودعة
- اقرأ إلى الخلف حتى LSN نقطة الفحص، مرتدًا بكل عمليات المعاملات غير المُودعة
- اقرأ إلى الأمام، معيدًا تنفيذ كل عمليات المعاملات المُودعة
- خذ نقطة فحص
نظريًا، نقطة الفحص الأخيرة غير ضرورية. لكن عمليًا، فهي تحدّ منزلة الزمن اللازمة لعمليات التعافي المستقبلية وتترك قاعدة البيانات في حالة متّسقة.
الدرس التصميمي الرابع عشر
تعافي قواعد البيانات موضوع معقّد، يصعب الكتابة عنه ويصعب تنقيحه أكثر، لأن التعافي من المفترض ألّا يحدث كثيرًا. وفي محاضرة جائزة تورينغ، دفع Edsger Dijkstra بأن البرمجة صعبة بطبيعتها وأن بداية الحكمة هي أن نعترف أننا غير قادرين على المهمة. وهدفنا كمهندسين ومبرمجين هو أن نستفيد من الأدوات المتاحة لدينا: التصميم، وتفكيك المشكلة، والمراجعة، والاختبار، واتفاقيات التسمية والأسلوب، وغيرها من العادات الجيدة، لتقييد مشكلات البرمجة ضمن مشكلات نستطيع حلّها.
4.10. الخاتمة
صار عمر Berkeley DB الآن أكثر من عشرين عامًا. ويمكن القول إنها كانت أول مخزن مفاتيح/قيم معاملي عام الغرض، وهي جدّ حركة NoSQL. ولا تزال Berkeley DB تعمل كنظام تخزين أساسي لمئات المنتجات التجارية وآلاف تطبيقات البرمجيات مفتوحة المصدر (بما فيها محركات SQL و XML و NoSQL)، ولها ملايين عمليات النشر حول العالم. والدروس التي تعلّمنا إياها خلال مسار تطويرها وصيانتها مُضمَّنة في الشيفرة وملخَّصة في النصائح التصميمية المعروضة أعلاه. ونقدّمها على أمل أن يجدها مصمّمو البرمجيات والمهندسون الآخرون مفيدة.
حواشٍ
- لاحظ أننا نحتاج فقط إلى الرجوع إلى LSN نقطة الفحص، لا إلى سجل نقطة الفحص السابقة له.
لاحظ أننا نحتاج فقط إلى الرجوع إلى LSN نقطة الفحص، لا إلى سجل نقطة الفحص السابقة له. ↩︎