خادم ويب بسيط
ـGreg Wilson هو مؤسّس Software Carpentry، وهي دورة مكثّفة في مهارات الحوسبة للعلماء والمهندسين. وقد عمل ثلاثين سنة في الصناعة والأكاديمية معًا، وهو مؤلّف أو محرّر لعدّة كتب في الحوسبة، منها Beautiful Code الفائز بجائزة Jolt لعام 2008، والمجلّدان الأولان من The Architecture of Open Source Applications. وحصل Greg على دكتوراه في علوم الحاسوب من جامعة إدنبرة عام 1993.
مقدّمة
غيّر الويب المجتمع بطرق لا تُحصى خلال العقدين الماضيين، لكنّ جوهره لم يتغيّر إلا قليلًا جدًّا. فمعظم الأنظمة لا تزال تتبع القواعد التي وضعها تيم بيرنرز-لي قبل ربع قرن. وتحديدًا، فإنّ معظم خوادم الويب لا تزال تعالج الأنواع نفسها من الرسائل التي كانت تعالجها حينها، بالطريقة نفسها.
سيستكشف هذا الفصل كيف تفعل ذلك. وفي الوقت نفسه، سيستكشف كيف بإمكان المطوّرين إنشاء أنظمة برمجية لا تحتاج إلى إعادة كتابة كي تُضاف إليها ميزات جديدة.
الخلفية
تشغيل كل برنامج على الويب تقريبًا يقع ضمن عائلة من معايير الاتصال تُسمّى بروتوكول الإنترنت (Internet Protocol، IP). والعضو من تلك العائلة الذي يهمّنا هو بروتوكول التحكّم في الإرسال (Transmission Control Protocol، TCP/IP)، وهو يجعل الاتصال بين الحواسيب يبدو كقراءة الملفات وكتابتها.
وتتّصل البرامج المستخدمة لـ IP عبر المقابس (sockets). وكل مقبس هو أحد طرفي قناة اتصال من نقطة إلى نقطة، تمامًا كما الهاتف هو أحد طرفي مكالمة. ويتكوّن المقبس من عنوان IP يحدّد آلة معيّنة ورقم منفذ (port) على تلك الآلة. ويتكوّن عنوان IP من أربعة أرقام بعرض 8 بت، مثل 174.136.14.108؛ ويطابق نظام أسماء النطاقات (Domain Name System، DNS) هذه الأسماء بأسماء رمزية مثل aosabook.org يسهل على البشر تذكّرها.
ورقم المنفذ هو عدد في المدى من 0 إلى 65535 يحدّد المقبس على نحو فريد على الآلة المضيفة. (إذا كان عنوان IP أشبه برقم هاتف شركة، فإنّ رقم المنفذ أشبه برقم داخلي.) أمّا المنافذ من 0 إلى 1023 فهي محجوزة لاستخدام نظام التشغيل؛ ويمكن لأيّ شخص آخر استخدام بقية المنافذ.
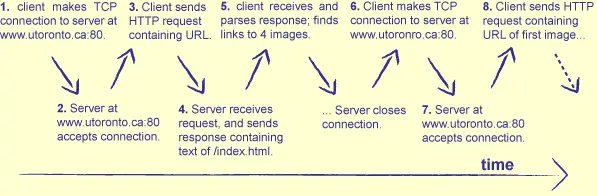
تصف بروتوكول نقل النصوص التشعبية (Hypertext Transfer Protocol، HTTP) إحدى الطرق التي يمكن بها للبرامج تبادل البيانات فوق IP. وHTTP بسيط عن قصد: يرسل العميل طلبًا يحدّد ما يريده عبر اتصال مقبس، ويردّ الخادم ببعض البيانات (cycle.) وقد تُنسخ البيانات من ملف على القرص، أو تُولَّد ديناميكيًّا بواسطة برنامج، أو تكون مزيجًا من الأمرَين.
وأهمّ ما في طلب HTTP هو أنّه مجرّد نصّ: فيمكن لأيّ برنامج أن ينشئ طلبًا أو يحلّله. لكنّ ذلك النصّ، كي يُفهَم، يجب أن يحتوي على الأجزاء المبيَّنة في request.
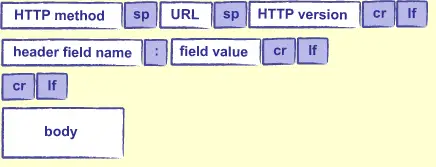
ودالة HTTP (method) هي دائمًا تقريبًا إمّا "GET" (لجلب معلومات) أو "POST" (لإرسال بيانات نموذج أو رفع ملفات). ويحدّد URL ما يريده العميل؛ وهو غالبًا مسار إلى ملف على القرص، مثل /research/experiments.html، لكن (وهذا هو الجزء المهمّ) من شأن الخادم وحده أن يقرّر تمامًا ما الذي يفعله به. أمّا إصدار HTTP فهو عادةً "HTTP/1.0" أو "HTTP/1.1"؛ والفروق بين الاثنين لا تهمّنا.
وترويسات HTTP (headers) هي أزواج من المفاتيح والقيم مثل الأزرار الثلاثة المبيَّنة أدناه:
Accept: text/html
Accept-Language: en, fr
If-Modified-Since: 16-May-2005
وعلى خلاف المفاتيح في جداول التجزئة، قد تظهر المفاتيح في ترويسات HTTP أيّ عدد من المرّات. وهذا يتيح للطلب أن يفعل أمورًا مثل تحديد أنّه مستعدّ قبول عدّة أنواع من المحتوى.
وأخيرًا، فإنّ جسم الطلب (body) هو أيّ بيانات إضافية مرتبطة بالطلب. ويُستخدم هذا عند إرسال بيانات عبر نماذج الويب، وعند رفع الملفات، وهكذا. ويجب أن يكون هناك سطر فارغ بين آخر ترويسة وبداية الجسم للإشارة إلى نهاية الترويسات.
وتخبر إحدى الترويسات، وتُسمّى Content-Length، الخادم بعدد البايتات التي يتوقّع أن يقرأها في جسم الطلب.
وتُنسَّق استجابات HTTP على نحو طلبات HTTP نفسه (response):
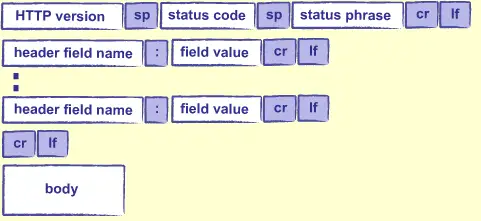
للإصدار والترويسات والجسم الصيغة والدلالة نفسها. أمّا رمز الحالة (status code) فهو عدد يدلّ على ما حدث حين عولج الطلب: 200 يعني "كل شيء على ما يرام"، و404 يعني "غير موجود"، ورموز أخرى لها معانٍ أخرى. وتُعيد عبارة الحالة (status phrase) تلك المعلومة في عبارة مقروءة للبشر مثل "OK" أو "غير موجود".
ولأغراض هذا الفصل، هناك أمران آخران فقط نحتاج إلى معرفتهما عن HTTP.
الأول أنّه عديم الحالة (stateless): كل طلب يُعالَج وحده، ولا يتذكّر الخادم شيئًا بين طلب وآخر. فإذا أراد تطبيق ما أن يتتبّع شيئًا مثل هوية المستخدم، فعليه أن يفعل ذلك بنفسه.
والطريقة المعتادة في ذلك هي استخدام ملف تعريف الارتباط (cookie)، وهو سلسلة محارف قصيرة يرسلها الخادم إلى العميل، ثمّ يعيدها العميل لاحقًا إلى الخادم. ف عندما ينفّذ مستخدم ما وظيفة تتطلّب حفظ حالة عبر عدّة طلبات، ينشئ الخادم ملف تعريف ارتباط جديدًا، ويخزّنه في قاعدة بيانات، ويرسله إلى متصفّحها. وفي كل مرّة يرسل متصفّحها الملفّ إليها، يستخدمه الخادم للبحث عن معلومات عمّا يقوم به المستخدم.
والأمر الثاني الذي نحتاج إلى معرفته عن HTTP هو أنّه يمكن استكمال URL بمعاملات (parameters) لتوفير معلومات أكثر. فمثلًا، إذا كنّا نستخدم محرّك بحث، فعلينا تحديد ماهية كلمات بحثنا. يمكننا إضافتها إلى المسار في URL، لكن ما ينبغي فعله هو إضافة معاملات إلى URL. ونفعل ذلك بإضافة '؟' إلى URL يليها أزواج من الشكل 'key=value' مفصولة بـ &. فمثلًا، إنّ URL http://www.google.ca?q=Python يطلب من Google البحث عن صفحات ذات صلة بـ Python: فالمفتاح هو الحرف 'q'، والقيمة هي 'Python'. أمّا الاستعلام الأطول http://www.google.ca/search?q=Python&client=Firefox فيخبر Google بأنّنا نستخدم Firefox، وهكذا. ويمكننا تمرير أيّ معاملات نريدها، لكن مرةً أخرى، الأمر متروك للتطبيق الذي يعمل على موقع الويب ليقرّر أيّها ينبغي الالتفات إليها، وكيف تفسيرها.
ولمن البديهي، إذا كان '؟' و& محرفين خاصّين، فلا بدّ من طريقة للهروب منهما، تمامًا كما لا بدّ من طريقة لوضع محرف اقتباس مزدوج داخل سلسلة محارف محدودة باقتباسين مزدوجين. ويمثّل معيار ترميز URL المحارف الخاصّة باستخدام '%' يليه رمز من رقمين، ويستبدل المسافات بالمحرف '+'. وهكذا، للبحث في Google عن "grade = A+" (بالمسافات)، سنستخدم URL http://www.google.ca/search?q=grade+%3D+A%2B.
وفتح المقابس، وإنشاء طلبات HTTP، وتحليل الاستجابات عمل مملّ، لذا يستخدم معظم الناس مكتبات للقيام بمعظم العمل. وتأتي بايثون مع مكتبة اسمها urllib2 (لأنّها بديل عن مكتبة أقدم اسمها urllib)، لكنّها تكشف عن كثير من التجهيزات الداخلية (plumbing) التي لا يريد معظم الناس أن يعبوا بها. ومكتبة Requests هي بديل أسهل استخدامًا من urllib2. وإليك مثالًا يستخدمها لتنزيل صفحة من موقع كتاب AOSA:
import requests
response = requests.get('http://aosabook.org/en/500L/web-server/testpage.html')
print 'status code:', response.status_code
print 'content length:', response.headers['content-length']
print response.text
status code: 200
content length: 61

  <body>
    <p>Test page.</p>
  </body>
ويرسل request.get طلب HTTP من نوع GET إلى خادم، ويعيد كائنًا يحتوي على الاستجابة. وعضو status_code في ذلك الكائن هو رمز حالة الاستجابة؛ وعضو content_length هو عدد البايتات في بيانات الاستجابة، وtext هي البيانات الفعلية (في هذه الحالة، صفحة HTML).
مرحبًا يا ويب
نحن الآن مستعدّون لكتابة أوّل خادم ويب بسيط لدينا. والفكرة الأساسية بسيطة:
- انتظار أن يتّصل أحدهم بخادمنا وإرسال طلب HTTP؛
- تحليل ذلك الطلب؛
- تحديد ما يطلبه؛
- جلب تلك البيانات (أو توليدها ديناميكيًّا)؛
- تنسيق البيانات بوصفها HTML؛ ثمّ
- إرسالها مرّة أخرى.
والخطوات 1 و2 و6 واحدة من تطبيق إلى آخر، لذا تحتوي مكتبة بايثون القياسية على وحدة اسمها BaseHTTPServer تتولّى ذلك نيابةً عنّا. وكلّ ما علينا فعله هو العناية بالخطوات من 3 إلى 5، وهو ما نفعله في البرنامج الصغير التالي:
import BaseHTTPServer

class RequestHandler(BaseHTTPServer.BaseHTTPRequestHandler):
    '''Handle HTTP requests by returning a fixed 'page'.'''

    # Page to send back.
    Page = '''\

<body>
<p>Hello, web!</p>
</body>

'''

    # Handle a GET request.
    def do_GET(self):
        self.send_response(200)
        self.send_header("Content-Type", "text/html")
        self.send_header("Content-Length", str(len(self.Page)))
        self.end_headers()
        self.wfile.write(self.Page)

#----------------------------------------------------------------------

if __name__ == '__main__':
    serverAddress = ('', 8080)
    server = BaseHTTPServer.HTTPServer(serverAddress, RequestHandler)
    server.serve_forever()
يتولّى صنف BaseHTTPRequestHandler الخاصّ بالمكتبة تحليل طلب HTTP الوارد وتحديد الدالة التي يحتويها. فإذا كانت الدالة هي GET، فإنّ الصنف يستدعي دالة اسمها do_GET. ويتجاوز صنفنا RequestHandler هذه الدالة ليُولّد ديناميكيًّا صفحة بسيطة: يُخزَّن النصّ في متغيّر على مستوى الصنف اسمه Page، ونُعيده إلى العميل بعد إرسال رمز استجابة 200، وترويسة Content-Type التي تطلب من العميل تفسير بياناتنا بوصفها HTML، وطول الصفحة. (ويُدرج استدعاء الدالة end_headers السطر الفارغ الذي يفصل ترويساتنا عن الصفحة نفسها.)
لكنّ RequestHandler ليست القصّة كاملة: فما زال علينا إضافة الأسطر الثلاثة الأخيرة كي يعمل خادم بالفعل. ويحدّد السطر الأول منها عنوان الخادم على هيئة طور: فالسلسلة الفارغة تعني "شغّله على الآلة الحالية"، و8080 هي رقم المنفذ. ثمّ ننشئ نسخة من \newline BaseHTTPServer.HTTPServer بهذا العنوان وباسم صنف معالِج الطلبات لدينا كوسائط، ثمّ نطلب منها أن تعمل إلى الأبد (وهذا عمليًا يعني حتى نقتلها بـ Control-C).
وإذا شغّلنا هذا البرنامج من سطر الأوامر، فلا يعرض أيّ شيء:
$ python server.py
لكنّنا إذا ذهبنا بعد ذلك إلى http://localhost:8080 بمتصفّحنا، نحصل على هذا في المتصفّح:
Hello, web!
وعلى هذا في الصدفة (shell):
127.0.0.1 - - [24/Feb/2014 10:26:28] "GET / HTTP/1.1" 200 -
127.0.0.1 - - [24/Feb/2014 10:26:28] "GET /favicon.ico HTTP/1.1" 200 -
والسطر الأول واضح: بما أنّنا لم نطلب ملفًّا معيّنًا، فقد طلب متصفّحنا '/' (الدليل الجذر لكلّ ما يقدّمه الخادم). أمّا السطر الثاني فيظهر لأنّ متصفّحنا يرسل تلقائيًّا طلبًا ثانيًا لملف صورة اسمه /favicon.ico، وسيعرضه كأيقونة في شريط العنوان إن كان موجودًا.
عرض القيم
لنعدّل خادم الويب لدينا كي يعرض بعض القيم المضمّنة في طلب HTTP. (سنفعل هذا كثيرًا إلى حدٍّ ما عند التنقيح، فلا ضير منّا أن نتدبّر على ذلك.) ولإبقاء شيفرتنا نظيفة، سنفصل إنشاء الصفحة عن إرسالها:
class RequestHandler(BaseHTTPServer.BaseHTTPRequestHandler):

    # ...page template...

    def do_GET(self):
        page = self.create_page()
        self.send_page(page)

    def create_page(self):
        # ...fill in...

    def send_page(self, page):
        # ...fill in...
وsend_page هي إلى حدٍّ كبير ما كان لدينا قبل ذلك:
    def send_page(self, page):
        self.send_response(200)
        self.send_header("Content-type", "text/html")
        self.send_header("Content-Length", str(len(page)))
        self.end_headers()
        self.wfile.write(page)
والقالب (template) الخاصّ بالصفحة التي نريد عرضه هو مجرّد سلسلة محارف تحتوي على جدول HTML مع بعض العناصر النائبة للتنسيق:
    Page = '''\

<body>
<table>
<tr>  <td>Header</td>         <td>Value</td>          </tr>
<tr>  <td>Date and time</td>  <td>{date_time}</td>    </tr>
<tr>  <td>Client host</td>    <td>{client_host}</td>  </tr>
<tr>  <td>Client port</td>    <td>{client_port}s</td> </tr>
<tr>  <td>Command</td>        <td>{command}</td>      </tr>
<tr>  <td>Path</td>           <td>{path}</td>         </tr>
</table>
</body>

'''
والدالة التي تملأ هذا هي:
    def create_page(self):
        values = {
            'date_time'   : self.date_time_string(),
            'client_host' : self.client_address[0],
            'client_port' : self.client_address[1],
            'command'     : self.command,
            'path'        : self.path
        }
        page = self.Page.format(**values)
        return page
ويبقى الجسم الرئيسي للبرنامج كما هو: كما من قبل، ينشئ نسخة من صنف HTTPServer بعنوان وبمعالِج الطلبات هذا كوسائط، ثمّ يخدم الطلبات إلى الأبد. فإذا شغّلناه وأرسلنا طلبًا من متصفّح على http://localhost:8080/something.html، نحصل على:
  Date and time  Mon, 24 Feb 2014 17:17:12 GMT
  Client host    127.0.0.1
  Client port    54548
  Command        GET
  Path           /something.html
ولاحظ أنّنا لا نحصل على خطأ 404، رغم أنّ الصفحة something.html غير موجودة كملف على القرص. والسبب في ذلك أنّ خادم الويب مجرّد برنامج، ويمكنه أن يفعل ما يشاء حين يتلقّى طلبًا: أن يُعيد الملفّ المذكور في الطلب السابق، أو أن يقدّم صفحة من ويكيبيديا مختارة عشوائيًّا، أو أيّ شيء آخر نبرمجه على ذلك.
تقديم الصفحات الساكنة
والخطوة التالية البديهية هي أن نبدأ بتقديم الصفحات من القرص بدلًا من توليدها في الحال. وسنبدأ بإعادة كتابة do_GET:
    def do_GET(self):
        try:

            # Figure out what exactly is being requested.
            full_path = os.getcwd() + self.path

            # It doesn't exist...
            if not os.path.exists(full_path):
                raise ServerException("'{0}' not found".format(self.path))

            # ...it's a file...
            elif os.path.isfile(full_path):
                self.handle_file(full_path)

            # ...it's something we don't handle.
            else:
                raise ServerException("Unknown object '{0}'".format(self.path))

        # Handle errors.
        except Exception as msg:
            self.handle_error(msg)
تفترض هذه الدالة أنّه مسموح لها بتقديم أيّ ملفات في الدليل الذي يعمل فيه خادم الويب أو تحته (والحصول عليهبـ os.getcwd). وتدمج هذا مع المسار المقدَّم في URL (الذي تضعه المكتبة تلقائيًّا في self.path، والذي يبدأ دائمًا بـ '/') للحصول على مسار الملف الذي يريده المستخدم.
وإن لم يكن ذلك المسار موجودًا، أو إن لم يكن ملفًّا، فإنّ الدالة تُبلّغ عن خطأ عبر رمي استثناء والتقاطه. أمّا إذا كان المسار يطابق ملفًّا، فإنّها في المقابل تستدعي دالة مساعدة اسمها handle_file لقراءة المحتويات وإعادتها. وتكتفي هذه الدالة بقراءة الملف واستخدام send_content القائمة لدينا لإعادته إلى العميل:
    def handle_file(self, full_path):
        try:
            with open(full_path, 'rb') as reader:
                content = reader.read()
            self.send_content(content)
        except IOError as msg:
            msg = "'{0}' cannot be read: {1}".format(self.path, msg)
            self.handle_error(msg)
ولاحظ أنّنا نفتح الملفّ في الوضع الثنائي—أي الحرف 'b' في 'rb'—حتى لا تحاول بايثون "مساعدتنا" بتعديل تسلسلات البايتات التي تشبه نهاية سطر في ويندوز. ولاحظ أيضًا أنّ قراءة الملفّ كلّه في الذاكرة عند تقديمه فكرة سيّئة في الواقع، إذ قد يكون الملفّ عدة غيغابايتات من بيانات الفيديو. ومعالجة تلك الحالة خارج نطاق هذا الفصل.
ولإتمام هذا الصنف، نحتاج إلى كتابة دالة معالجة الأخطاء وقالب صفحة الإبلاغ عن الخطأ:
    Error_Page = """\

        <body>
        <h1>Error accessing {path}</h1>
        <p>{msg}</p>
        </body>

        """

    def handle_error(self, msg):
        content = self.Error_Page.format(path=self.path, msg=msg)
        self.send_content(content)
يعمل هذا البرنامج، لكن فقط إن لم ننظر إليه عن قرب أكثر من اللازم. والمشكلة أنّه يُعيد رمز حالة 200 دائمًا، حتى حين لا توجد الصفحة المطلوبة. نعم، الصفحة المُعادة في تلك الحالة تحتوي على رسالة خطأ، لكنّ متصفّحنا لا يستطيع قراءة الإنكليزية، فلا يعرف أنّ الطلب فشل في الواقع. ولجعل ذلك واضحًا، نحتاج إلى تعديل handle_error وsend_content على النحو التالي:
    # Handle unknown objects.
    def handle_error(self, msg):
        content = self.Error_Page.format(path=self.path, msg=msg)
        self.send_content(content, 404)

    # Send actual content.
    def send_content(self, content, status=200):
        self.send_response(status)
        self.send_header("Content-type", "text/html")
        self.send_header("Content-Length", str(len(content)))
        self.end_headers()
        self.wfile.write(content)
ولاحظ أنّنا لا نرمي ServerException حين لا يُعثر على ملفّ، بل نولّد صفحة خطأ بدلًا من ذلك. فاستثناء ServerException مقصود للإشارة إلى خطأ داخلي في شيفرة الخادم، أي إلى شيء أخطأنا نحن فيه. أمّا صفحة الخطأ التي ينشئها handle_error فتظهر عندما يخطئ المستخدم، أي حين يرسل لنا URL لملف غير موجود. [1]
سرد الدلائل
وخطوتنا التالية هي أن نعلّم خادم الويب أن يعرض سردًا لمحتويات دليل عندما يكون المسار في URL دليلًا لا ملفًّا. بل يمكننا أن نذهب خطوة أبعد، فنجعله يبحث في ذلك الدليل عن ملف index.html ليعرضه، ولا يعرض سردًا لمحتويات الدليل إلّا إن لم يكن ذلك الملفّ موجودًا.
لكنّ بناء هذه القواعد داخل do_GET سيكون خطأً، إذ إنّ الدالة الناتجة ستكون تشابكًا طويلًا من جمل if تتحكّم في سلوكات خاصة. والحلّ الصحيح هو أن نتراجع خطوة ونحلّ المشكلة العامة، وهي تحديد ما ينبغي فعله مع URL. وهذه إعادة كتابة للدالة do_GET:
    def do_GET(self):
        try:

            # Figure out what exactly is being requested.
            self.full_path = os.getcwd() + self.path

            # Figure out how to handle it.
            for case in self.Cases:
                handler = case()
                if handler.test(self):
                    handler.act(self)
                    break

        # Handle errors.
        except Exception as msg:
            self.handle_error(msg)
والخطوة الأولى هي نفسها: تحديد المسار الكامل إلى الشيء المطلوب. لكنّ بعد ذلك تبدو الشيفرة مختلفة تمامًا. فبدلًا من مجموعة من الفحوص المضمّنة، تمرّر هذه النسخة في حلقة على مجموعة حالات مخزَّنة في قائمة. وكلّ حالة كائن له دالتان: test، وهي تخبرنا بما إذا كان قادرًا للتعامل مع الطلب، وact، وهي التي تتّخذ إجراءً فعليًّا. وفي اللحظة التي نجد فيها الحالة الصحيحة، نتركها تتعامل مع الطلب ونخرج من الحلقة.
وتُعيد هذه الحالات الثلاث من أصناف الحالات سلوك خادمنا السابق:
class case_no_file(object):
    '''File or directory does not exist.'''

    def test(self, handler):
        return not os.path.exists(handler.full_path)

    def act(self, handler):
        raise ServerException("'{0}' not found".format(handler.path))

class case_existing_file(object):
    '''File exists.'''

    def test(self, handler):
        return os.path.isfile(handler.full_path)

    def act(self, handler):
        handler.handle_file(handler.full_path)

class case_always_fail(object):
    '''Base case if nothing else worked.'''

    def test(self, handler):
        return True

    def act(self, handler):
        raise ServerException("Unknown object '{0}'".format(handler.path))
وهكذا نبني قائمة معالِجات الحالات في أعلى صنف RequestHandler:
class RequestHandler(BaseHTTPServer.BaseHTTPRequestHandler):
    '''
    If the requested path maps to a file, that file is served.
    If anything goes wrong, an error page is constructed.
    '''

    Cases = [case_no_file(),
             case_existing_file(),
             case_always_fail()]

    ...everything else as before...
والآن، على السطح، جعل هذا خادمنا أكثر تعقيدًا لا أقلّ: فقد نما الملفّ من 74 سطرًا إلى 99، وهناك مستوى إضافي من التفويض (indirection) من دون أيّ وظيفة جديدة. وتأتي الفائدة حين نعود إلى المهمة التي بدأت بها هذا الفصل ونحاول تعليم خادمنا أن يقدّم صفحة index.html لدليل إن كانت موجودة، وسردًا للدليل إن لم تكن موجودة. والمعالِج للحالة الأولى هو:
class case_directory_index_file(object):
    '''Serve index.html page for a directory.'''

    def index_path(self, handler):
        return os.path.join(handler.full_path, 'index.html')

    def test(self, handler):
        return os.path.isdir(handler.full_path) and \
               os.path.isfile(self.index_path(handler))

    def act(self, handler):
        handler.handle_file(self.index_path(handler))
وهنا تبني الدالة المساعدة index_path المسار إلى ملف index.html؛ ووضعها في معالِج الحالة يمنع الفوضى في RequestHandler الرئيسي. وتحقّق test ممّا إذا كان المسار دليلًا يحتوي على صفحة index.html، وتطلب act من معالِج الطلبات الرئيسي تقديم تلك الصفحة.
والتغيير الوحيد اللازم في RequestHandler هو إضافة كائن case_directory_index_file إلى قائمة Cases لدينا:
    Cases = [case_no_file(),
             case_existing_file(),
             case_directory_index_file(),
             case_always_fail()]
وماذا عن الدلائل التي لا تحتوي على صفحات index.html؟ الفحص هو نفسه الفحص السابق مع إدراج not في موضع استراتيجيّ، لكنّ ماذا عن دالة act؟ وماذا ينبغي لها أن تفعل؟
class case_directory_no_index_file(object):
    '''Serve listing for a directory without an index.html page.'''

    def index_path(self, handler):
        return os.path.join(handler.full_path, 'index.html')

    def test(self, handler):
        return os.path.isdir(handler.full_path) and \
               not os.path.isfile(self.index_path(handler))

    def act(self, handler):
        ???
ويبدو أنّنا قد ضاقت بنا الدائرة. ومنطقيًّا، ينبغي أن تُنشئ دالة act سرد الدليل وتُعيده، لكنّ شيفرتنا القائمة لا تسمح بذلك: فدالة RequestHandler.do_GET تستدعي act، لكنّها لا تتوقّع قيمة إرجاع منها ولا تتعامل معها. ولأجل الحاضر، لنضف دالة إلى RequestHandler تولّد سردًا للدليل، ونستدعيها من دالة act في معالِج الحالة:
class case_directory_no_index_file(object):
    '''Serve listing for a directory without an index.html page.'''

    # ...index_path and test as above...

    def act(self, handler):
        handler.list_dir(handler.full_path)

class RequestHandler(BaseHTTPServer.BaseHTTPRequestHandler):

    # ...all the other code...

    # How to display a directory listing.
    Listing_Page = '''\

        <body>
        <ul>
        {0}
        </ul>
        </body>

        '''

    def list_dir(self, full_path):
        try:
            entries = os.listdir(full_path)
            bullets = ['<li>{0}</li>'.format(e)
                for e in entries if not e.startswith('.')]
            page = self.Listing_Page.format('\n'.join(bullets))
            self.send_content(page)
        except OSError as msg:
            msg = "'{0}' cannot be listed: {1}".format(self.path, msg)
            self.handle_error(msg)
بروتوكول CGI
ولمن البديهي، لن يريد معظم الناس تحرير مصدر خادم الويب لديهم كي يضيفوا وظيفة جديدة. ولتوفير عليهم عن ذلك، دعمت الخوادم على الدوام آلية تُسمّى واجهة البوابة الشائعة (Common Gateway Interface، CGI)، وهي توفّر طريقة قياسية لخادم الويب كي يشغّل برنامجًا خارجيًا من أجل تلبية طلب.
فمثلًا، لنفترض أننا نريد للخادم أن يكون قادرًا على عرض الوقت المحلي في صفحة HTML. يمكننا فعل ذلك في برنامج مستقلّ ببضعة أسطر فقط:
from datetime import datetime
print '''\

<body>
<p>Generated {0}</p>
</body>
'''.format(datetime.now())
ولكي تجعل خادم الويب يشغّل هذا البرنامج نيابةً عنّا، نضيف معالِج الحالة هذا:
class case_cgi_file(object):
    '''Something runnable.'''

    def test(self, handler):
        return os.path.isfile(handler.full_path) and \
               handler.full_path.endswith('.py')

    def act(self, handler):
        handler.run_cgi(handler.full_path)
والفحص بسيط: هل ينتهي مسار الملفّ بـ .py؟ إن كان كذلك، يشغّل RequestHandler هذا البرنامج.
    def run_cgi(self, full_path):
        cmd = "python " + full_path
        child_stdin, child_stdout = os.popen2(cmd)
        child_stdin.close()
        data = child_stdout.read()
        child_stdout.close()
        self.send_content(data)
وهذا غير آمن تمامًا: فإذا عرف أحدهم مسار ملف بايثون على خادمنا، فإنّنا نسمح له فقط بتشغيله دون أن نهتمّ بما تصل إليه بياناته، أو بما إذا كان يحتوي على حلقة لا نهائية، أو أيّ شيء آخر.[2]
ونحن نطرح ذلك جانبًا، فالفكرة الأساسية بسيطة:
- تشغيل البرنامج في عملية فرعية.
- التقاط كلّ ما ترسله تلك العملية الفرعية إلى المخرجات القياسية.
- إرسال ذلك مرّة أخرى إلى العميل الذي أنشأ الطلب.
وبروتوكول CGI الكامل أغنى بكثير من هذا—على سبيل المثال، يسمح بمعاملات في URL يمرّرها الخادم إلى البرنامج الذي يجري تشغيله—لكنّ هذه التفاصيل لا تؤثّر في البنية العامة للنظام...
...التي صارت متشابكة مرّة أخرى إلى حدّ ما. فقد كان لدى RequestHandler في البداية دالة واحدة، وهي handle_file، للتعامل مع المحتوى. وقد أضفنا الآن حالتين خاصّتين على هيئة list_dir وrun_cgi. وهذه الدوالّ الثلاث لا تنتمي حقًّا إلى مكانها الحالي، لأنّها تُستخدم أساسًا من قِبل غيرها.
والحلّ مباشر: أنشئ صنفًا أبًا لجميع معالِجات الحالات لدينا، وانقل الدوالّ الأخرى إلى ذلك الصنف إذا (وإذا فقط) كانت مشتركة بين معالِجَين أو أكثر. وحين ننتهي، سيبدو صنف RequestHandler على النحو التالي:
class RequestHandler(BaseHTTPServer.BaseHTTPRequestHandler):

    Cases = [case_no_file(),
             case_cgi_file(),
             case_existing_file(),
             case_directory_index_file(),
             case_directory_no_index_file(),
             case_always_fail()]

    # How to display an error.
    Error_Page = """\

        <body>
        <h1>Error accessing {path}</h1>
        <p>{msg}</p>
        </body>

        """

    # Classify and handle request.
    def do_GET(self):
        try:

            # Figure out what exactly is being requested.
            self.full_path = os.getcwd() + self.path

            # Figure out how to handle it.
            for case in self.Cases:
                if case.test(self):
                    case.act(self)
                    break

        # Handle errors.
        except Exception as msg:
            self.handle_error(msg)

    # Handle unknown objects.
    def handle_error(self, msg):
        content = self.Error_Page.format(path=self.path, msg=msg)
        self.send_content(content, 404)

    # Send actual content.
    def send_content(self, content, status=200):
        self.send_response(status)
        self.send_header("Content-type", "text/html")
        self.send_header("Content-Length", str(len(content)))
        self.end_headers()
        self.wfile.write(content)
بينما يكون الصنف الأب لمعالِجات الحالات لدينا هو:
class base_case(object):
    '''Parent for case handlers.'''

    def handle_file(self, handler, full_path):
        try:
            with open(full_path, 'rb') as reader:
                content = reader.read()
            handler.send_content(content)
        except IOError as msg:
            msg = "'{0}' cannot be read: {1}".format(full_path, msg)
            handler.handle_error(msg)

    def index_path(self, handler):
        return os.path.join(handler.full_path, 'index.html')

    def test(self, handler):
        assert False, 'Not implemented.'

    def act(self, handler):
        assert False, 'Not implemented.'
ومعالِج الملفّ الموجود (لنختر مثالًا اعتباطيًّا) هو:
class case_existing_file(base_case):
    '''File exists.'''

    def test(self, handler):
        return os.path.isfile(handler.full_path)

    def act(self, handler):
        self.handle_file(handler, handler.full_path)
مناقشة
وتعكس الفروق بين شيفرتنا الأصلية والنسخة المعاد بناؤها فكرتين مهمّتين. والأولى هي أن نرى الصنف على هيئة مجموعة من الخدمات المترابطة. فـ RequestHandler وbase_case لا يتّخذان قرارات ولا يتّخذان إجراءات؛ بل يوفّران أدوات يمكن لأصناف أخرى استخدامها للقيام بذلك.
والفكرة الثانية هي قابلية التوسّع: يستطيع الناس إضافة وظائف جديدة إلى خادم الويب لدينا إمّا بكتابة برنامج CGI خارجي، أو بإضافة صنف معالِج حالة. ويتطلّب الثاني تغييرًا من سطر واحد في RequestHandler (لإدراج معالِج الحالة في قائمة Cases)، لكنّنا يمكننا التخلّص من ذلك بأن يجعل خادم الويب يقرأ ملفّ إعدادات ويحمّل أصناف المعالِجات منه. وفي الحالتين، يمكنهما تجاهل معظم التفاصيل منخفضة المستوى، تمامًا كما سمح لنا مؤلفو صنف BaseHTTPRequestHandler بأن نتجاهل تفاصيل التعامل مع اتصالات المقابس وتحليل طلبات HTTP.
وهذه الأفكار مفيدة عمومًا؛ فحاول أن تجد طرقًا لاستخدامها في مشاريعك.
سنستخدم
handle_errorعدّة مرّات في مختلف مواضع هذا الفصل، بما في ذلك حالات عدّة لا يكون فيها رمز الحالة404مناسبًا. حاول وأنت تقرأ أن تفكّر في كيفية توسيع هذا البرنامج بحيث يمكن تمرير رمز استجابة الحالة بسهولة في كلّ حالة. ↩︎تستخدم شيفرتنا أيضًا دالة المكتبة
popen2، التي أُهملت لصالح وحدةsubprocess. لكنّpopen2كانت الأداة الأقلّ تشتيتًا لاستخدامها في هذا المثال. ↩︎