أخذ عيّنات بالارفض
جيس طالبة دكتوراه في جامعة كاليفورنيا في بيركلي، حيث تدرس الإدراك البشري عبر الجمع بين النماذج الاحتمالية من التعلّم الآلي والتجارب السلوكية من علم النفس المعرفي. وفي وقت فراغها، جيس مساهِمة أساسية في IPython وJupyter. كما أنها حاصلة على بكالوريوس وماجستير هندسة في علوم الحاسوب من معهد التقنية (MIT).
مقدمة
كثيراً ما نصطدم، في علوم الحاسوب والهندسة، بمشاكل لا يمكن حلّها باستخدام معادلة. وعادةً ما تنتج هذه المشكلات عن أنظمة معقّدة أو مدخلات مشوّشة (noisy inputs) أو كليهما. وإليك بعض الأمثلة على مشكلات في العالم الحقيقي لا تملك حلولاً تحليلية دقيقة:
-
لقد بنيت نموذجاً حاسوبياً لطائرة، وتريد أن تعرف مدى تحمّل الطائرة لظروف الطقس المختلفة.
-
تريد أن تعرف ما إذا كانت التصريفات الكيميائية من مصنع مقترح ستؤثّر في إمداد المياه لسكان المنطقة القريبة، انطلاقاً من نموذج لانتشار المياه الجوفية.
-
لديك روبوت يلتقط صوراً مشوّشة من كاميرته، وتريد استعادة البنية ثلاثية الأبعاد للشيء الذي تصوّره تلك الصور.
-
تريد حساب احتمال فوزك في الشطرنج إذا اتّخذت حركة معيّنة.
ولرغم أن هذه الأنواع من المشاكل لا يمكن حلّها بدقة، يمكننا في الغالب الحصول على حلّ تقريبي لها باستخدام تقنيات تُعرف بطرق أخذ العينات في مونت كارلو (Monte Carlo sampling). وفي طرق مونت كارلو، تكمن الفكرة الأساسية في أخذ كثير من العيّنات (samples)، مما يتيح لك بدوره تقدير الحلّ.[1]
ما هو أخذ العينات؟
المصطلح أخذ العينات (sampling) يعني توليد قيم عشوائية من توزيع احتمالي. فمثلاً، القيمة التي تحصل عليها من رمي نرد بستة أوجه هي عيّنة. والبطاقة التي تسحبها من أعلى المجموعة بعد خلطها هي عيّنة. والموضع الذي تصيب فيه السهام اللوح هو عيّنة أيضاً. والاختلاف الوحيد بين هذه العيّنات المختلفة أنها مُولَّدة من توزيعات احتمالية مختلفة. ففي حالة النرد، يضع التوزيع وزناً متساوياً على ست قيم. وفي حالة البطاقة، يضع التوزيع وزناً متساوياً على 52 قيمة. وفي حالة لوح السهام، يضع التوزيع وزناً على منطقة دائرية (مع أنه قد لا يكون موزّعاً بانتظام، بحسب مهارتك كلاعب سهام).
هناك طريقتان نودّ عادةً استعمال العيّنات فيهما. الأولى هي ببساطة توليد قيمة عشوائية تُستعمل لاحقاً: فمثلاً سحب البطاقات عشوائياً في لعبة بوكر حاسوبية. أما الطريقة الثانية التي تُستعمل بها العيّنات فهي للتقدير. فمثلاً، إن اشتبهت في أن صديقك يلعب بنردٍ مغشوش (loaded dice)، فقد تريد رمي النردمرات كثيرة لمعرفة ما إذا كانت أرقام معيّنة تطلع أكثر مما هو متوقّع. أو قد تريد ببساطة تحديد نطاق الاحتمالات، كما في مثال الطائرة أعلاه. الطقس نظام فوضوي إلى حدّ كبير، ما يعني أنه يستحيل حساب ما إذا كانت ستنجُ الطائرة في موقف طقس معيّن بدقّة. وبدلاً من ذلك، يمكنك محاكاة سلوك الطائرة تحت ظروف طقس مختلفة كثيرة، مراراً وتكراراً، مما يتيح لك أن ترى في أي الظروف تكون الطائرة أكثر عرضة للفشل.
البرمجة بالعيّنات والاحتمالات
كما في معظم تطبيقات علوم الحاسوب، يمكنك اتخاذ قرارات تصميمية عند البرمجة بالعيّنات والاحتمالات ستؤثّر في نظافة شيفرتك وتماسكها وصحّتها الإجمالية. وسنمرّ في هذا الفصل على مثال بسيط لكيفية أخذ عيّنات عشوائية من عناصر في لعبة حاسوبية. ولأن الأمر جوهري هنا، سنركّز على قرارات التصميم الخاصة بالعمل بالاحتمالات، بما في ذلك دوالّ المعاينة وأخرى لتقييم الاحتمالات، والتعامل مع اللوغاريتمات، وإتاحة إمكانية إعادة الإنتاج، وفصل عملية توليد العيّنات عن التطبيق تحديداً.
ملاحظة وجيزة عن الترميز
سنستعمل ترميزاً رياضياً مثل للإشارة إلى أن هي دالة كثافة الاحتمال (PDF) أو دالة كتلة الاحتمال (PMF) على قيم لمتغيّر عشوائي. فدالة الكثافة هي دالة متصلة بحيث ، في حين أن دالة الكتلة هي دالة متقطّعة بحيث ، حيث هي مجموعة الأعداد الصحيحة كلّها.
سيكون التوزيع الاحتمالي في حالة لوح السهام دالة كثافة متصلة، بينما سيكون التوزيع الاحتمالي في حالة النرد دالة كتلة متقطّعة. وفي الحالتين معاً، يكون لكل ؛ أي أن الاحتمالات يجب أن تكون غير سالبة.
هناك أمران قد نودّ فعلهما بتوزيع احتمالي. فومعطًى قيمة (أو موضع) ، قد نودّ أن نقيّم ما هي كثافة الاحتمال (أو كتلته) عند ذلك الموضع. وفي الترميز الرياضي، نكتب هذا على صورة (كثافة الاحتمال عند القيمة ).
ومعطى دالة الكثافة أو دالة الكتلة، قد نودّ أيضاً أن نأخذ عيّنة من قيمة بطريقة متناسبة مع التوزيع (بحيث نكون أكثر عرضة للحصول على عيّنة في المواضع التي يكون فيها الاحتمال أعلى). وفي الترميز الرياضي، نكتب هذا على صورة ، ما يدلّ على أن قد أُخذت عيّنة بما يتناسب مع .
أخذ عيّنات العناصر السحرية
ولنأتَ بمثال بسيط لتوضيح قرارات التصميم المختلفة التي تنطوي عليها البرمجة بالاحتمالات، ولنفترض أننا نكتب لعبة لعب أدوار (RPG). ونودّ طريقة لتوليد إحصاءات إضافية للعناصر السحرية التي تُسقطها الوحوش عشوائياً. وقد نقرّر أن أقصى زيادة نريد أن يمنحه عنصر هو +5، وأن الزيادات الأكبر أقل احتمالاً من الأصغر. فإذا كان متغيّراً عشوائياً على قيم الزيادة، فإن:
ويمكننا أيضاً أن نحدّد أن هناك ست إحصاءات (الرشاقة، والبنية، والقوة، والذكاء، والحكمة، والكاريزما) نريد أن تُوزَّع الزيادة بينها. فعنصر ذو زيادة قدرها +5 يمكن أن تكون نقاطه موزَّعة على إحصاءات مختلفة (مثل +2 حكمة و +3 ذكاء) أو مركَّزة في إحصاء واحد (مثل +5 كاريزما).
فكيف يمكننا أن نأخذ عيّنة عشوائية من هذا التوزيع؟ ولعلّ أسهل طريقة هي أن نأخذ أولاً الزيادة الإجمالية للعنصر، ثم نأخذ طريقة توزيع الزيادة على الإحصاءات. ولحسن الحظ، فإن التوزيعين الاحتماليين الخاصين بالزيادة وبطريقة توزيعها كلاهما حالة من التوزيع المتعدّد الحدود (multinomial distribution).
التوزيع المتعدّد الحدود
يُستعمل التوزيع المتعدّد الحدود عندما تكون لديك نتائج محتملة متعدّدة، وتريد تحديد احتمال حدوث كل نتيجة من تلك النتائج. والمثال الكلاسيكي المستخدم في شرح التوزيع المتعدّد الحدود هو الكرة والصندوق (ball and urn). وتتمثّل الفكرة في أن لديك صندوقاً يحوي كرات بألوان مختلفة (مثلاً، 30% حمراء، و20% زرقاء، و50% خضراء). فتسحب كرة، وتسجّل لونها، ثم تضعها مرّة أخرى في الصندوق، ثم تكرّر هذا مرات عديدة. في هذه الحالة، تقابل النتيجة (outcome) سحب كرة بلون معيّن، ويقابل احتمال كل نتيجة نسبة الكرات من ذلك اللون (فمثلاً، لنتيجة سحب كرة زرقاء، الاحتمال هو ). ومن ثمّ يُستعمل التوزيع المتعدّد الحدود لوصف التركيبات الممكنة للنتائج عند سحب كرات متعدّدة (مثل كرتين خضراوين وكرة زرقاء).
تقع الشيفرة في هذا القسم في الملف multinomial.py.
صنف MultinomialDistribution
بوجه عام، هناك حالتا استعمال للتوزيع: قد نودّ أن نأخذ عيّنة من ذلك التوزيع، وقد نودّ أن نقيّم احتمال عيّنة (أو عيّنات) تحت دالة الكتلة الاحتمالية أو دالة الكثافة الاحتمالية لذلك التوزيع. ورغم أن الحسابات الفعلية اللازمة لأداء هذين الدورين مختلفة إلى حدّ كبير، فإنهما يعتمدان على معلومة مشتركة واحدة: ما هي معاملات (parameters) التوزيع. وفي حالة التوزيع المتعدّد الحدود، تكون المعاملات هي احتمالات الأحداث، (التي تقابل نسب الكرات الملوّنة المختلفة في مثال الصندوق أعلاه).
والحل الأبسط سيكون ببساطة إنشاء دالتين تأخذان المعاملات نفسها، لكنهما مستقلتان فيما بينهما. غير أنني عادةً ما أفضّل استعمال صنف لتمثيل توزيعاتي. وهناك عدة فوائد ذلك:
-
لا تحتاج إلا إلى تمرير المعاملات مرّة واحدة، عند إنشاء الصنف.
-
هناك صفات إضافية قد نودّ معرفتها عن التوزيع: المعدّل، والتباين، والمشتقّة، وغيرها. وبمجرد أن يتوفّر لدينا حتى حفنة صغيرة من الدوال التي تعمل على كائن مشترك، يصبح استعمال الصنف أكثر ملاءمة من تمرير المعاملات نفسها إلى دوال مختلفة كثيرة.
-
من الأفضل عادةً التحقّق من صحّة قيم المعاملات (ففي حالة التوزيع المتعدّد الحدود، مثلاً، يجب أن يكون متجه لاحتمالات الأحداث مجموعه 1). ويؤدّى هذا الفحص مرّة واحدة، في بانِي الصنف، أكفأ بكثير من فعله في كل مرّة تُستدعى فيها إحدى الدوال.
-
أحياناً ما ينطوي حساب PMF أو PDF على حساب قيم ثابتة (معطاة المعاملات). ومع الصنف، يمكننا أن نحسب هذه الثوابت مسبقاً في الباني، بدلاً من اضطرارنا إلى حسابها في كل مرّة تُستدعى فيها دالة PMF أو PDF.
وهذه في الممارسة العملية طريقة عمل كثير من حزم الإحصاء، بما فيها توزيعات SciPy نفسها، الموجودة في الوحدة scipy.stats. لكننا بينما نستعمل دوال SciPy الأخرى، لا نستعمل توزيعاتها الاحتمالية، وذلك لأجل التوضيح، ولأن SciPy لا تحتوي حالياً على توزيع متعدّد الحدود.
وهذه هي شيفرة الباني (constructor) للصنف:
import numpy as np

class MultinomialDistribution(object):

    def __init__(self, p, rso=np.random):
        """Initialize the multinomial random variable.

        Parameters
        ----------
        p: numpy array of length `k`
            The event probabilities
        rso: numpy RandomState object (default: None)
            The random number generator

        """

        # Check that the probabilities sum to 1. If they don't, then
        # something is wrong! We use `np.isclose` rather than checking
        # for exact equality because in many cases, we won't have
        # exact equality due to floating-point error.
        if not np.isclose(np.sum(p), 1.0):
            raise ValueError("event probabilities do not sum to 1")

        # Store the parameters that were passed in
        self.p = p
        self.rso = rso

        # Precompute log probabilities, for use by the log-PMF, for
        # each element of `self.p` (the function `np.log` operates
        # elementwise over NumPy arrays, as well as on scalars.)
        self.logp = np.log(self.p)
يأخذ الصنف كوسيطين احتمالات الأحداث، ، ومتغيّراً اسمه rso. أولاً، يتحقّق الباني من صحّة المعاملات، أي أن p مجموعه 1. ثم يخزّن الوسائط التي مُرِّرت إليه، ويستخدم احتمالات الأحداث لحساب احتمالات الأحداث اللوغاريتمية. (وسنعود إلى سبب الحاجة إلى ذلك بعد قليل). أما كائن rso فهو ما سنستعمله لاحقاً لإنتاج أرقام عشوائية. (وسنتحدّث أكثر عمّا هو لاحقاً أيضاً).
قبل أن ننتقل إلى بقية الصنف، لنراجع أمرين يتعلقان بالباني.
أسماء المتغيّرات الوصفية مقابل الرياضية
عادةً ما يُشجَّع المبرمجون على استعمال أسماء متغيّرات وصفية: فمثلاً، يُعدّ من الممارسات الأفضل استعمال الاسمين independent_variable وdependent_variable بدل x وy. وقاعدة إرشادية شائعة هي ألا نستعمل أبداً أسماء متغيّرات لا تتجاوز حرفاً أو حرفين. لكنك ستلاحظ أن في باني صنف MultinomialDistribution نستعمل اسم المتغيّر p، وهو ما يخالف اصطلاحات التسمية المعتادة.
ورغم أنني أتفق على أن اصطلاحات التسمية هذه ينبغي أن تنطبق في كل المجالات تقريباً، هناك استثناء واحد: الرياضيات. والصعوبة في ترميز المعادلات الرياضية أن تلك المعادلات تحمل عادةً أسماء متغيّرات لا تتجاوز حرفاً واحداً: و و وغيرها. فإذا كنت ستترجمها مباشرةً إلى شيفرة، لأصبحت أسماء المتغيّرات الأسهل هي x وy وalpha. ومن الواضح أن هذه ليست أسماء المتغيّرات الأكثر إفادة (فاسم x لا ينقل الكثير من المعلومات)، لكن استعمال أسماء متغيّرات أكثر وصفاً قد يجعل التنقّل بين الشيفرة والمعادلة أصعب أيضاً.
أعتقد أن حين تكتب شيفرة تنفّذ معادلةً مباشرة، ينبغي أن تُستعمل أسماء المتغيّرات نفسها المستعملة في المعادلة. فإن ذلك يجعل من السهل رؤية أي أجزاء من الشيفرة تنفّذ أي أجزاء من المعادلة. وهذا بالطبع قد يجعل الشيفرة أصعب في الفهم منفرداً، لذا من المهمّة خاصةً أن تقوم التعليقات بوظيفتها التوضيحية على نحو جيّد. وإذا كانت المعادلة مدرجة في ورقة علمية، فينبغي أن تشير التعليقات إلى رقم المعادلة ليسهل الرجوع إليه.
استيراد NumPy
لعلّك لاحظت أننا استوردنا الوحدة numpy باسم np. وهذه ممارسة معتادة في عالم الحوسبة العددية، لأن NumPy تقدّم عدداً هائلاً من الدوال المفيدة، كثير منها قد يُستعمل حتى في ملف واحد. وفي الأمثلة البسيطة من هذا الفصل، نستعمل إحدى عشرة دالة من دوال NumPy فقط، لكن العدد قد يكون أكبر بكثير: ف ليس من غير المألوف أن أستعمل نحو أربعين دالة مختلفة من دوال NumPy في مشروع كامل!
وهناك بعض الخيارات لاستيراد NumPy. يمكننا استعمال from numpy import *، لكن هذه عادةً أسلوب سيّئ لأنها تجعل تحديد مصدر الدوال صعباً. يمكننا استيراد الدوال فرادى على الصورة from numpy import array, log, ...، لكن ذلك يصبح مرتجلاً سريعاً. يمكننا ببساطة استعمال import numpy، لكن هذا يؤدّي غالباً إلى شيفرة أصعب في القراءة بكثير. وكلا المثالين التاليين صعب في القراءة، لكن المثال الذي يستعمل np بدل numpy أوضح بدرجة كبيرة:
>>> numpy.sqrt(numpy.sum(numpy.dot(numpy.array(a), numpy.array(b))))
>>> np.sqrt(np.sum(np.dot(np.array(a), np.array(b))))
أخذ عيّنات من توزيع متعدّد الحدود
أخذ عيّنة من توزيع متعدّد الحدود أمر في الواقع بسيط إلى حدّ كبير، لأن NumPy تقدّم لنا دالة تفعله: np.random.multinomial[2].
ورغم أن هذه الدالة موجودة بالفعل، هناك بعض قرارات التصميم المتعلقة بها يمكننا اتخاذها.
تهيئة مولّد الأرقام العشوائية
رغم أننا نريد فعلاً سحب عيّنة عشوائية، فإننا نريد أحياناً أن تكون نتائجنا قابلة لإعادة الإنتاج: فرغم أن الأرقام تبدو عشوائية، إذا أعدنا تشغيل البرنامج فقد نريد منه أن يستعمل التسلسل نفسه من الأرقام «العشوائية».
ولتتيح توليد مثل هذه الأرقام «العشوائية القابلة لإعادة الإنتاج»، نحتاج إلى أن نخبر دالة أخذ العينات لدينا بكيفية توليد الأرقام العشوائية. يمكننا تحقيق ذلك باستعمال كائن RandomState من NumPy، وهو في جوهره كائن مولّد أرقام عشوائية يمكن تمريره هنا وهناك. ولديه معظم الدوال نفسها الموجودة في np.random؛ والفرق أن موضع مصدر الأرقام العشوائية يصبح بأيدينا. ننشئه على الصورة التالية:
>>> import numpy as np
>>> rso = np.random.RandomState(230489)
حيث يكون الرقم المُمرَّر إلى باني RandomState هو البذرة (seed) الخاصة بمولّد الأرقام العشوائية. ما دامّنا ننشئه بالبذرة نفسها، فإن كائن RandomState سينتج الأرقام «العشوائية» نفسها بالترتيب نفسه، مما يضمن إمكانية التكرار:
>>> rso.rand()
0.5356709186237074
>>> rso.rand()
0.6190581888276206
>>> rso.rand()
0.23143573416770336
>>> rso.seed(230489)
>>> rso.rand()
0.5356709186237074
>>> rso.rand()
0.6190581888276206
راجعنا سابقاً أن الباني كان يأخذ وسيطاً اسمه rso. وهذا المتغيّر rso هو كائن RandomState مهيّأ بالفعل. وأنا أحبّ أن أجعل كائن RandomState وسيطاً اختيارياً: فبينما يكون من غير الملائم في بعض الأحيان ألّا تكون مضطرّاً إلى استعماله، فإنني أودّ أن تكون لديّ الخيار في استعماله (وهو أمر لن أستطيعه لو اكتشفت الاكتفاء باستعمال وحدة np.random).
فإذا لم يُعطَ المتغيّر rso، فإن الباني يرجع افتراضياً إلى np.random.multinomial. وإلّا فإنه يستعمل دالّة أخذ العينات المتعدّدة الحدود من كائن RandomState نفسه[3].
ما المقصود بالمعامل؟
بعد أن قرّرنا ما إذا كنّا سنستعمل np.random.multinomial أم rso.multinomial، لا يصير أخذ العيّنات سوى مسألة استدعاء الدالة المناسبة. غير أن هناك قراراً آخر قد نودّ اتخاذه: ما الذي يُعدّ معاملاً؟
لقد قلت سابقاً إن احتمالات النتائج، ، هي معاملات التوزيع المتعدّد الحدود. غير أنه، بحسب من تسأله، قد يكون عدد الأحداث، ، أيضاً معاملاً للتوزيع المتعدّد الحدود. فلماذا إذن لم نُدرِج كوسيط للباني؟
هذا السؤال، وإن كان نوعاً ما خاصاً بالتوزيع المتعدّد الحدود، يتكرّر في الواقع إلى حدّ كبير عند التعامل مع التوزيعات الاحتمالية، والإجابة تعتمد فعلياً على حالة الاستعمال. بالنسبة إلى متعدّد الحدود، هل يمكنك أن تفترض أن عدد الأحداث يبقى نفسه دائماً؟ إن كان كذلك، فقد يكون من الأفضل تمرير كوسيط إلى الباني. وإن لم يكن كذلك، فإن اشتراط تحديد وقت إنشاء الكائن قد يكون مقيّداً جداً، وقد يستلزم حتى إنشاء كائن توزيع جديد في كل مرّة تحتاج فيها إلى سحب عيّنة!
أنا عادةً لا أحبّ أن أكون مقيّداً إلى هذا الحدّ بواسطة شيفرتي، وأختار من ثمّ أن يكون n وسيطاً لدالة sample، بدلاً من أن يكون وسيطاً للباني. ويمكن أن يكون الحل البديل هو جعل n وسيطاً للباني، مع تضمين توابع تسمح بتغيير قيمة n، دون الحاجة إلى إنشاء كائن جديد تماماً. لكن لأغراضنا، من المرجّح أن يكون هذا الحل مبالغاً فيه، لذا سنكتفي بجعله وسيطاً لـ sample:
def sample(self, n):
    """Samples draws of `n` events from a multinomial distribution with
    outcome probabilities `self.p`.

    Parameters
    ----------
    n: integer
        The number of total events

    Returns
    -------
    numpy array of length `k`
        The sampled number of occurrences for each outcome

    """
    x = self.rso.multinomial(n, self.p)
    return x
تقييم دالة الكتلة الاحتمالية المتعدّدة الحدود
رغم أننا لا نحتاج صراحةً إلى حساب احتمال العناصر السحرية التي نولّدها، فإن من الأفضل دائماً تقريباً كتابة دالة تستطيع حساب دالة كتلة الاحتمال (PMF) أو دالة كثافة الاحتمال (PDF) الخاصة بالتوزيع. لماذا؟
أحد الأسباب هو أننا نستطيع استعمالها في الاختبار: فإذا أخذنا كثيراً من العيّنات بدالتنا، فينبغي أن تقارب دالة الكثافة أو دالة الكتلة الدقيقة. فإذا كانت التقارب سيّئاً أو خاطئاً على نحو واضح بعد أخذ عيّنات كثيرة، نعرف عندئذٍ أن في شيفرتنا خللاً في مكان ما.
وسبب آخر لتطبيق PMF أو PDF هو أنك كثيراً ما ستحتاج إليها لاحقاً في الطريق دون أن تنتبه لها في البداية. فمثلاً، قد نودّ تصنيف عناصرنا المولَّدة عشوائياً إلى شائعة (common) وغير شائعة (uncommon) ونادرة (rare)، بحسب احتمال توليدها. ولتحديد ذلك، نحتاج إلى القدرة على حساب PMF.
وأخيراً، في كثير من الحالات، ستدفعك حالة استعمالك تحديداً إلى تطبيق PMF أو PDF منذ البداية على أي حال.
معادلة PMF المتعدّدة الحدود
رسمياً، يتمتع التوزيع المتعدّد الحدود بالمعادلة التالية:
حيث متجه طوله يحدّد عدد مرّات حدوث كل حدث، و متجه يحدّد احتمال حدوث كل حدث. وكما ذُكر أعلاه، فإن احتمالات الأحداث هي معاملات التوزيع.
يمكن في الواقع التعبير عن العوامل (factorials) في المعادلة أعلاه بدالة خاصة، ، تُسمّى دالة غاما (gamma function). وعندما نصل إلى كتابة الشيفرة، سيكون استعمال دالة غاما بدل العوامل أكثر ملاءمة وكفاءة، لذا سنعيد كتابة المعادلة باستعمال :
العمل بالقيم اللوغاريتمية
قبل الدخول في الشيفرة الفعلية اللازمة لتطبيق المعادلة أعلاه، أودّ أن أُشدّد على واحدة من أهم قرارات التصميم عند كتابة شيفرة بالاحتمالات: العمل بالقيم اللوغاريتمية. ويعني ذلك أننا بدل العمل مباشرةً بالاحتمالات ، ينبغي أن نعمل بـاحتمالات لوغاريتمية، . والسبب في ذلك أن الاحتمالات قد تصير صغيرة جداً بسرعة فائقة، مما يؤدّي إلى أخطاء في نزول القيم تحت الحدّ الأدنى (underflow).
ولإبراز هذا، لاحظ أن الاحتمالات يجب أن تقع في المدى بين 0 و1 (شاملةً الطرفين). ولدى NumPy دالة مفيدة هي finfo تخبرنا بحدود قيم الفاصلة العائمة في نظامنا. فمثلاً، على آلة 64-بت، نرى أن أصغر عدد موجب صالح للاستعمال (الذي تعطيه tiny) هو:
>>> import numpy as np
>>> np.finfo(float).tiny
2.2250738585072014e-308
ورغم أن ذلك قد يبدو صغيراً جداً، إلا أنه ليس من غير المألوف مصادفة احتمالات بهذا المقدار، أو حتى أصغر. وإضافةً إلى ذلك، فإن ضرب الاحتمالات عملية شائعة، غير أن محاولة فعل ذلك باحتمالات صغيرة جداً تسبّب لنا مشكلات في الفيض:
>>> tiny = np.finfo(float).tiny
>>> # if we multiply numbers that are too small, we lose all precision
>>> tiny * tiny
0.0
غير أن أخذ اللوغاريتم يمكن أن يساعد في التخفيف من هذه المشكلة، لأننا نستطيع تمثيل مدى أوسع بكثير من الأعداد باللوغاريتمات مقارنةً بما هو ممكن عادةً. رسمياً، تقع القيم اللوغاريتمية في المدى من إلى الصفر.لكن الممارسة العملية، تقع في المدى من قيمة min التي يعيدها finfo، وهي أصغر عدد يمكن تمثيله، إلى الصفر. وقيمة min أصغر بكثير من لوغاريتم قيمة tiny (والذي سيكون حدّنا الأدنى لو لم نعمل في الفضاء اللوغاريتمي):
>>> # this is our lower bound normally
>>> np.log(tiny)
-708.39641853226408
>>> # this is our lower bound when using logs
>>> np.finfo(float).min
-1.7976931348623157e+308
وعملنا بالقيم اللوغاريتمية يوسّع إلى حدّ بعيد مدى الأعداد التي نستطيع تمثيلها. وإضافةً إلى ذلك، يمكننا إجراء الضرب باللوغاريتمات باستعمال الجمع، لأن . فإذا أنجزنا المضروب أعلاه باللوغاريتمات، فلن نضطر إلى القلق (إلى هذا الحدّ) بشأن فقدان الدقّة نتيجة لنزول القيم تحت الحدّ الأدنى:
>>> # the result of multiplying small probabilities
>>> np.log(tiny * tiny)
-inf
>>> # the result of adding small log probabilities
>>> np.log(tiny) + np.log(tiny)
-1416.7928370645282
وبطبيعة الحال، هذا الحل ليس رصاصة سحرية. فإذا احتجنا اشتقاق العدد من اللوغاريتم (مثلاً،لإضافة الاحتمالات بدلاً من ضربها)، فإننا نعود إلى مشكلة نزول القيم تحت الحدّ الأدنى:
>>> tiny*tiny
0.0
>>> np.exp(np.log(tiny) + np.log(tiny))
0.0
ومع ذلك، فإن إجراء كل حساباتنا باللوغاريتمات يوفّر علينا عناءً كبيراً. قد نضطر إلى فقدان تلك الدقّة إذا احتجنا العودة إلى الأعداد الأصلية، لكننا على الأقل نحتفظ بـبعض المعلومات عن الاحتمالات—تكفي للمقارنة بينها مثلاً—وهو ما كان يضيع لولا ذلك.
كتابة شيفرة PMF
الآن وقد رأينا أهمية العمل باللوغاريتمات، يمكننا فعلاً كتابة دالتنا لحساب log-PMF:
def log_pmf(self, x):
    """Evaluates the log-probability mass function (log-PMF) of a
    multinomial with outcome probabilities `self.p` for a draw `x`.

    Parameters
    ----------
    x: numpy array of length `k`
        The number of occurrences of each outcome

    Returns
    -------
    The evaluated log-PMF for draw `x`

    """
    # Get the total number of events
    n = np.sum(x)

    # equivalent to log(n!)
    log_n_factorial = gammaln(n + 1)
    # equivalent to log(x1! * ... * xk!)
    sum_log_xi_factorial = np.sum(gammaln(x + 1))

    # If one of the values of self.p is 0, then the corresponding
    # value of self.logp will be -inf. If the corresponding value
    # of x is 0, then multiplying them together will give nan, but
    # we want it to just be 0.
    log_pi_xi = self.logp * x
    log_pi_xi[x == 0] = 0
    # equivalent to log(p1^x1 * ... * pk^xk)
    sum_log_pi_xi = np.sum(log_pi_xi)

    # Put it all together
    log_pmf = log_n_factorial - sum_log_xi_factorial + sum_log_pi_xi
    return log_pmf
في معظمها، هذه تنفيذ مباشر للمعادلة أعلاه الخاصة بـ PMF المتعدّدة الحدود. ودالة gammaln تأتي من scipy.special، وتحسب دالة غاما اللوغاريتمية، . وكما ذُكر أعلاه، استعمال دالة غاما بدل دالة العوامل هو أكثر ملاءمة؛ والسبب في ذلك أن SciPy توفّر لنا دالة غاما لوغاريتمية، لكنها لا توفّر دالة عوامل لوغاريتمية.
log_n_factorial = np.sum(np.log(np.arange(1, n + 1)))
sum_log_xi_factorial = np.sum([np.sum(np.log(np.arange(1, i + 1))) for i in x])
لكنه أسهل في الفهم، وأسهل في الترميز، وأكثر كفاءة حسابية، إذا استعملنا دالة غاما الموجودة أصلاً في SciPy.
هناك حالة حدّية واحدة علينا معالجتها: عندما تكون إحدى احتمالاتنا صفراً. فعند ، يكون . وسيكون هذا حسناً، لولا السلوك التالي عند ضرب ما لا نهاية في الصفر:
>>> # it's fine to multiply infinity by integers...
>>> -np.inf * 2.0
-inf
>>> # ...but things break when we try to multiply by zero
>>> -np.inf * 0.0
nan
تعني nan «ليس رقماً» (not a number)، وهي في الغالب عبءٌ في التعامل معها، لأن معظم الحسابات التي تجري على nan تنتج nan أخرى. فإذا لم نتعامل مع الحالة التي يكون فيها و، فسننتهي إلى nan. وسيُجمع ذلك مع أعداد أخرى، مما ينتج nan أخرى، وهو أمر غير مفيد على الإطلاق. ولمعالجة ذلك، نفحص تحديداً الحالة التي يكون فيها ، ونضبط الناتجة لتكون صفراً أيضاً.
لنعد لحظةً إلى مناقشتنا استعمال اللوغاريتمات. وحتى لو كنا لا نحتاج فعلياً إلا إلى PMF لا إلى log-PMF، فإن الأفضل عموماً أن نحسبها أولاً باللوغاريتمات، ثم نرفعها إلى أُسّ إن احتجنا إلى ذلك:
def pmf(self, x):
    """Evaluates the probability mass function (PMF) of a multinomial
    with outcome probabilities `self.p` for a draw `x`.

    Parameters
    ----------
    x: numpy array of length `k`
        The number of occurrences of each outcome

    Returns
    -------
    The evaluated PMF for draw `x`

    """
    pmf = np.exp(self.log_pmf(x))
    return pmf
ولإبراز أهمية العمل باللوغاريتمات أكثر من ذلك، يمكننا النظر في مثال يتضمّن متعدّد الحدود فقط:
>>> dist = MultinomialDistribution(np.array([0.25, 0.25, 0.25, 0.25]))
>>> dist.log_pmf(np.array([1000, 0, 0, 0])
-1386.2943611198905
>>> dist.log_pmf(np.array([999, 0, 0, 0])
-1384.9080667587707
في هذه الحالة، نحصل على احتمالات شديدة الصغر (ولن تلاحظ، فهي أصغر بكثير من قيمة tiny التي ناقشناها أعلاه). والسبب في ذلك أن البسط في PMF ضخم: فمضروب 1000 لا يمكن حتى حسابه بسبب تجاوز الحدّ الأعلى. لكن لوغاريتم المضروب يمكن حسابه:
>>> from scipy.special import gamma, gammaln
>>> gamma(1000 + 1)
inf
>>> gammaln(1000 + 1)
5912.1281784881639
ولو حاولنا حساب PMF وحده باستعمال دالة gamma، لانتهينا إلى gamma(1000 + 1) / gamma(1000 + 1)، وهو ما ينتج قيمة nan (مع أننا نستطيع أن نرى أنها ينبغي أن تكون 1). لكن بما أننا نُجري الحساب باللوغاريتمات، فليست هذه مشكلة ولا نحتاج إلى القلق بشأنها!
أخذ عيّنات العناصر السحرية، من جديد
الآن وقد كتبنا دوالّ التوزيع المتعدّد الحدود، يمكننا أن نضعها في العمل لتوليد عناصرنا السحرية. ولهذا سننشئ صنفاً اسمه MagicItemDistribution، يوجد في الملف rpg.py:
class MagicItemDistribution(object):

    # these are the names (and order) of the stats that all magical
    # items will have
    stats_names = ("dexterity", "constitution", "strength",
                   "intelligence", "wisdom", "charisma")

    def __init__(self, bonus_probs, stats_probs, rso=np.random):
        """Initialize a magic item distribution parameterized by `bonus_probs`
        and `stats_probs`.

        Parameters
        ----------
        bonus_probs: numpy array of length m
            The probabilities of the overall bonuses. Each index in
            the array corresponds to the bonus of that amount (e.g.,
            index 0 is +0, index 1 is +1, etc.)

        stats_probs: numpy array of length 6
            The probabilities of how the overall bonus is distributed
            among the different stats. `stats_probs[i]` corresponds to
            the probability of giving a bonus point to the ith stat;
            i.e., the value at `MagicItemDistribution.stats_names[i]`.

        rso: numpy RandomState object (default: np.random)
            The random number generator

        """
        # Create the multinomial distributions we'll be using
        self.bonus_dist = MultinomialDistribution(bonus_probs, rso=rso)
        self.stats_dist = MultinomialDistribution(stats_probs, rso=rso)
يأخذ باني صنف MagicItemDistribution معاملات لاحتمالات الزيادة، واحتمالات الإحصاءات، ومولّد الأرقام العشوائية. ورغم أننا حدّدنا أعلاه ما نريد أن تكون عليه احتمالات الزيادة، فمن الأفضل عموماً ترميز المعاملات كوسائط تُمرَّر إلى الدالة. وهذا يترك الباب مفتوحاً لاحتمال أخذ عيّنات من عناصر تحت توزيعات مختلفة. (فمثلاً، ربما تتغيّر احتمالات الزيادة مع ارتفاع مستوى اللاعب.) ونرمّز أسماء الإحصاءات كمتغيّر في الصنف، stats_names، مع أن هذا يمكن أن يكون بسهولة معاملاً آخر للباني.
وكما ذُكر سابقاً، هناك خطوتان لأخذ عيّنة عنصر سحري: أولاً أخذ الزيادة الإجمالية، ثم أخذ توزيع الزيادة على الإحصاءات. ولهذا نرمّز هاتين الخطوتين كدالتين: _sample_bonus و_sample_stats:
def _sample_bonus(self):
    """Sample a value of the overall bonus.

    Returns
    -------
    integer
        The overall bonus

    """
    # The bonus is essentially just a sample from a multinomial
    # distribution with n=1; i.e., only one event occurs.
    sample = self.bonus_dist.sample(1)

    # `sample` is an array of zeros and a single one at the
    # location corresponding to the bonus. We want to convert this
    # one into the actual value of the bonus.
    bonus = np.argmax(sample)
    return bonus

def _sample_stats(self):
    """Sample the overall bonus and how it is distributed across the
    different stats.

    Returns
    -------
    numpy array of length 6
        The number of bonus points for each stat

    """
    # First we need to sample the overall bonus
    bonus = self._sample_bonus()

    # Then, we use a different multinomial distribution to sample
    # how that bonus is distributed. The bonus corresponds to the
    # number of events.
    stats = self.stats_dist.sample(bonus)
    return stats
كان من الممكن أن ندمج هاتين الدالتين في دالة واحدة—ولا سيما أن _sample_stats هي الدالة الوحيدة التي تعتمد على _sample_bonus—غير أنني اخترت إبقاءهما منفصلتين، أولاً لأن ذلك يجعل إجراء أخذ العينات أسهل في الفهم، وثانياً لأن تقسيمه إلى أجزاء أصغر يجعل الشيفرة أسهل في الاختبار.
ولن تلاحظ أيضاً أن هاتين الدالتين مسبقتان بشرطة سفلية، ما يدلّ على أنهما ليس مقصوداً استعمالهما في خارج الصنف حقاً. وبدلاً من ذلك، نوفّر الدالة sample:
def sample(self):
    """Sample a random magical item.

    Returns
    -------
    dictionary
        The keys are the names of the stats, and the values are
        the bonus conferred to the corresponding stat.

    """
    stats = self._sample_stats()
    item_stats = dict(zip(self.stats_names, stats))
    return item_stats
وتقوم دالة sample بالشيء نفسه تقريباً الذي تقوم به _sample_stats، إلا أنها تُعيد قاموساً مفاتيحه أسماء الإحصاءات. وهذا يوفّر واجهة نظيفة ومفهومة لأخذ عيّنات العناصر—فمن الواضح أي الإحصاءات كعدد نقاط الزيادة—لكنه يترك أيضاً الخيار مفتوحاً لاستعمال _sample_stats وحدها إذا احتاج أحدهم إلى أخذ عيّنات كثيرة وكان الأداء ضرورياً.
ونستعمل تصميماً مماثلاً لتقييم احتمال العناصر. فمرة أخرى نكشف توابع عالية المستوى هي pmf وlog_pmf التي تأخذ قاميصاً من الشكل الذي تنتجه sample:
def log_pmf(self, item):
    """Compute the log probability of the given magical item.

    Parameters
    ----------
    item: dictionary
        The keys are the names of the stats, and the values are
        the bonuses conferred to the corresponding stat.

    Returns
    -------
    float
        The value corresponding to log(p(item))

    """
    # First pull out the bonus points for each stat, in the
    # correct order, then pass that to _stats_log_pmf.
    stats = np.array([item[stat] for stat in self.stats_names])
    log_pmf = self._stats_log_pmf(stats)
    return log_pmf

def pmf(self, item):
    """Compute the probability the given magical item.

    Parameters
    ----------
    item: dictionary
        The keys are the names of the stats, and the values are
        the bonus conferred to the corresponding stat.

    Returns
    -------
    float
        The value corresponding to p(item)

    """
    return np.exp(self.log_pmf(item))
وتعتمد هذه التوابع على _stats_log_pmf، التي تحسب احتمال الإحصاءات (لكنها تأخذ متجه بدلاً من قاموس):
def _stats_log_pmf(self, stats):
    """Evaluate the log-PMF for the given distribution of bonus points
    across the different stats.

    Parameters
    ----------
    stats: numpy array of length 6
        The distribution of bonus points across the stats

    Returns
    -------
    float
        The value corresponding to log(p(stats))

    """
    # There are never any leftover bonus points, so the sum of the
    # stats gives us the total bonus.
    total_bonus = np.sum(stats)

    # First calculate the probability of the total bonus
    logp_bonus = self._bonus_log_pmf(total_bonus)

    # Then calculate the probability of the stats
    logp_stats = self.stats_dist.log_pmf(stats)

    # Then multiply them together (using addition, because we are
    # working with logs)
    log_pmf = logp_bonus + logp_stats
    return log_pmf
وتعتمد الدالة _stats_log_pmf بدورها على _bonus_log_pmf، التي تحسب احتمال الزيادة الإجمالية:
def _bonus_log_pmf(self, bonus):
    """Evaluate the log-PMF for the given bonus.

    Parameters
    ----------
    bonus: integer
        The total bonus.

    Returns
    -------
    float
        The value corresponding to log(p(bonus))

    """
    # Make sure the value that is passed in is within the
    # appropriate bounds
    if bonus < 0 or bonus >= len(self.bonus_dist.p):
        return -np.inf

    # Convert the scalar bonus value into a vector of event
    # occurrences
    x = np.zeros(len(self.bonus_dist.p))
    x[bonus] = 1

    return self.bonus_dist.log_pmf(x)
ويمكننا الآن إنشاء توزيعنا على الصورة التالية:
>>> import numpy as np
>>> from rpg import MagicItemDistribution
>>> bonus_probs = np.array([0.0, 0.55, 0.25, 0.12, 0.06, 0.02])
>>> stats_probs = np.ones(6) / 6.0
>>> rso = np.random.RandomState(234892)
>>> item_dist = MagicItemDistribution(bonus_probs, stats_probs, rso=rso)
وبعد إنشائه، يمكننا استعماله لتوليد بضعة عناصر مختلفة:
>>> item_dist.sample()
{'dexterity': 0, 'strength': 0, 'constitution': 0,
 'intelligence': 0, 'wisdom': 0, 'charisma': 1}
>>> item_dist.sample()
{'dexterity': 0, 'strength': 0, 'constitution': 1,
 'intelligence': 0, 'wisdom': 2, 'charisma': 0}
>>> item_dist.sample()
{'dexterity': 1, 'strength': 0, 'constitution': 1,
 'intelligence': 0, 'wisdom': 0, 'charisma': 0}
وإن أردنا، يمكننا تقييم احتمال عنصر أخذت عيّنة منه:
>>> item = item_dist.sample()
>>> item
{'dexterity': 0, 'strength': 0, 'constitution': 0,
 'intelligence': 0, 'wisdom': 2, 'charisma': 0}
>>> item_dist.log_pmf(item)
-4.9698132995760007
>>> item_dist.pmf(item)
0.0069444444444444441
تقدير ضرر الهجوم
لقد رأينا تطبيقاً واحداً لأخذ العينات: توليد عناصر عشوائية تُسقطها الوحوش. وقد أشرتُ سابقاً إلى أن أخذ العينات يمكن أن يُستعمل أيضاً حين تريد تقدير شيء ما من التوزيع ككل، وهناك بالتأكيد حالات يمكننا فيها استعمال MagicItemDistribution لهذا الغرض. فمثلاً، لنفترض أن الضرر في لعبتنا للأدوار يعمل برمي عدد ما من نرد D12 (نرد باثني عشر وجهاً). يحصل اللاعب على رمية نرد واحدة افتراضياً، ثم يضيف نرداً بحسب زيادة قوته. فمثلاً، إذا كانت لديه زيادة قوة +2، فيستطيع رمي ثلاث نردات. والضرر الذي يُلحق يكون بعد ذلك مجموع النردات.
قد نودّ معرفة مقدار الضرر الذي قد يُلحقه اللاعب بعد العثور على عدد ما من الأسلحة؛ فمثلاً، بوصفه عاملاً في ضبط صعوبة الوحوش. ولنقل إنه بعد جمع عنصرين، نريد للاعب أن يستطيع هزيمة الوحوش في ثلاث ضربات في نحو 50% من المعارك. فكم يجب أن تكون نقاط الحياة (hit points) للوحش؟
وإجابةً عن هذا السؤال، إحدى الطرق هي عن طريق أخذ العينات. يمكننا استعمال المخطط التالي:
- اختر عنصراً سحرياً عشوائياً.
- بناءً على زيادات العنصر، احسب عدد النردات التي ستُرمى عند الهجوم.
- بناءً على عدد النردات التي ستُرمى، ولّد عيّنة للضرر الذي يُلحق خلال ثلاث ضربات.
- كرّر الخطوات 1-3 مرّات كثيرة. وسيؤدّي ذلك إلى تقريب للتوزيع على الضرر.
تطبيق توزيع على الضرر
يُظهر الصنف DamageDistribution (أيضاً في rpg.py) تطبيقاً لهذا المخطط:
class DamageDistribution(object):

    def __init__(self, num_items, item_dist,
                 num_dice_sides=12, num_hits=1, rso=np.random):
        """Initialize a distribution over attack damage. This object can
        sample possible values for the attack damage dealt over
        `num_hits` hits when the player has `num_items` items, and
        where attack damage is computed by rolling dice with
        `num_dice_sides` sides.

        Parameters
        ----------
        num_items: int
            The number of items the player has.
        item_dist: MagicItemDistribution object
            The distribution over magic items.
        num_dice_sides: int (default: 12)
            The number of sides on each die.
        num_hits: int (default: 1)
            The number of hits across which we want to calculate damage.
        rso: numpy RandomState object (default: np.random)
            The random number generator

        """

        # This is an array of integers corresponding to the sides of a
        # single die.
        self.dice_sides = np.arange(1, num_dice_sides + 1)

        # Create a multinomial distribution corresponding to one of
        # these dice.  Each side has equal probabilities.
        self.dice_dist = MultinomialDistribution(
            np.ones(num_dice_sides) / float(num_dice_sides), rso=rso)

        self.num_hits = num_hits
        self.num_items = num_items
        self.item_dist = item_dist

    def sample(self):
        """Sample the attack damage.

        Returns
        -------
        int
            The sampled damage

        """
        # First, we need to randomly generate items (the number of
        # which was passed into the constructor).
        items = [self.item_dist.sample() for i in xrange(self.num_items)]

        # Based on the item stats (in particular, strength), compute
        # the number of dice we get to roll.
        num_dice = 1 + np.sum([item['strength'] for item in items])

        # Roll the dice and compute the resulting damage.
        dice_rolls = self.dice_dist.sample(self.num_hits * num_dice)
        damage = np.sum(self.dice_sides * dice_rolls)
        return damage
يأخذ الباني كوسائط عدد أوجه النردات، وعدد الضربات التي نريد حساب الضرر عليها، وعدد العناصر التي يملكها اللاعب، وتوزيعاً على العناصر السحرية (من نوع MagicItemDistribution)، وكائن حالة عشوائية. وافتراضياً، نضبط num_dice_sides على 12، لأنه رغم أنه معامل تقنياً، فمن المرجّح ألّا يتغيّر. وعلى نحو مماثل، نضبط num_hits على 1 كقيمة افتراضية، لأن حالة الاستعمال الأكثر ترجيحاً هي أننا نريد فقط أخذ عيّنة واحدة من الضرر لضربة واحدة.
ثم نطبّق منطق أخذ العينات الفعلي في sample. (لاحظ التشابه البنيوي مع MagicItemDistribution.) أولاً، نولّد مجموعة من العناصر السحرية الممكنة التي يملكها اللاعب. ثم ننظر إلى إحصاء القوة في تلك العناصر، ونحسب منه عدد النردات المراد رميها. وأخيراً، نرمي النردات (معتمدين مرة أخرى على دوالّ التوزيع المتعدّد الحدود التي نثق بها) ونحسب الضرر من ذلك.
ما الذي حدث لتقييم الاحتمالات؟
لعلّك لاحظت أننا لم نُدرج دالة log_pmf أو pmf في DamageDistribution. والسبب في ذلك أننا لا نعرف في الواقع ما الذي ينبغي أن تكون عليه PMF! وهذه هي المعادلة:
تقول هذه المعادلة إننا سنحتاج إلى حساب احتمال كل مقدار ممكن للضرر، معطى كل مجموعة ممكنة من عناصر. يمكننا في الواقع أن نحسب هذا بالقوة الغاشمة (brute force)، لكن ذلك لن يكون جميلاً. وهذه في الحقيقة مثال مثالي على حالة نريد فيها استعمال أخذ العينات لتقريب حلّ لمشكلة لا يمكننا حسابها بدقة (أو التي سيكون حسابها دقيقاً صعباً جداً). فبدلاً من وجود دالة لـ PMF، سنُظهر في القسم التالي كيف يمكننا تقريب التوزيع بعدد كبير من العيّنات.
تقريب التوزيع
لدينا الآن الأدوات للإجابة عن سؤالنا السابق: إذا كان اللاعب يملك عنصرين، وأردنا للاعب أن يستطيع هزيمة الوحش في ثلاث ضربات 50% من الوقت، فكم يجب أن تكون نقاط حياة الوحش؟
أولاً، ننشئ كائن التوزيع، باستعمال item_dist وrso نفسها التي أنشأناها سابقاً:
>>> from rpg import DamageDistribution
>>> damage_dist = DamageDistribution(2, item_dist, num_hits=3, rso=rso)
والآن يمكننا سحب حفنة من العيّنات، وحساب المئين الخمسين (قيمة الضرر التي تفوق 50% من العيّنات):
>>> samples = np.array([damage_dist.sample() for i in xrange(100000)])
>>> samples.min()
3
>>> samples.max()
154
>>> np.percentile(samples, 50)
27.0
ولو رسمنا مخطّطاً تكرارياً (histogram) لعدد العيّنات التي حصلنا عليها لكل مقدار من مقادير الضرر، لكان شيئاً من هذا الشكل damage.
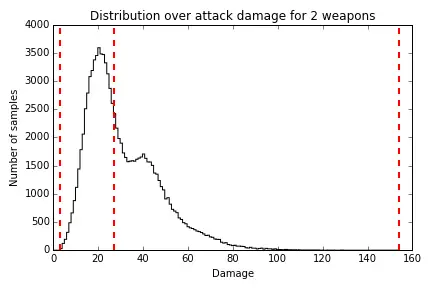
هناك مدى واسع إلى حدّ ما من الضرر يمكن أن يُلحقه اللاعب، لكن له ذيلاً طويلاً: فالمئين الخمسين يقع عند 27 نقطة، ما يعني أن في نصف العيّنات لم يُلحق اللاعب أكثر من 27 نقطة من الضرر. وعليه، إن أردنا استعمال هذا المعيار لضبط صعوبة الوحش، لجعلنا له 27 نقطة حياة.
الخلاصة
في هذا الفصل، رأينا كيف نكتب شيفرة لتوليد عيّنات من توزيع احتمالي غير قياسي، وكيف نحسب احتمالات تلك العيّنات أيضاً. وفي معرض العمل على هذا المثال، غطّينا عدة قرارات تصميمية تنطبق في الحالة العامة:
- تمثيل التوزيعات الاحتمالية باستعمال صنف، مع تضمين دوالّ للمعاينة وأخرى لتقييم PMF (أو PDF).
- حساب PMF (أو PDF) باستعمال اللوغاريتمات.
- توليد العيّنات من كائن مولّد أرقام عشوائية لإتاحة عشوائية قابلة لإعادة الإنتاج.
- كتابة دوالّ تكون مدخلاتها ومخرجاتها واضحة ومفهومة (مثلاً، باستعمال قاموس كمخرج لـ
MagicItemDistribution.sample)، مع الإبقاء في الوقت نفسه على النسخة الأقل وضوحاً لكن الأكثر كفاءة والرقمية بالكامل من تلك الدوالّ (مثلMagicItemDistribution._sample_stats).
وإضافةً إلى ذلك، رأينا كيف يكون أخذ العيّنات من توزيع احتمالي مفيداً سواء لإنتاج قيمة عشوائية مفردة (مثل توليد عنصر سحري واحد بعد هزيمة وحش) أو لحساب معلومات عن توزيع لا نعرفه لولا ذلك (مثل اكتشاف مقدار الضرر الذي يُنشّده لاعب يملك عنصرين على الأرجح). وتقريباً كل نوع من أنواع أخذ العينات الذي قد تصادفه يندرج تحت إحدى هاتين الفئتين؛ ولا الاختلافات إلا فيما يتعلق بالتوزيعات التي تأخذ منها عيّنات. ويبقى الهيكل العام للشيفرة—مستقلاً عن تلك التوزيعات—على حاله.
يفترض هذا الفصل قدراً من الإلمام بالإحصاء ونظرية الاحتمالات. ↩︎
تضمّ NumPy دوالّ لسحب عيّنات من أنواع كثيرة مختلفة من التوزيعات. ولمعرفة القائمة الكاملة، انظر وحدة أخذ العينات العشوائية
np.random. ↩︎تعتمد الدوال في
np.randomفي الواقع على مولّد أرقام عشوائية يمكننا التحكّم فيه، وهو مولّد الأرقام العشوائية العام في NumPy. ويمكنك ضبط البذرة العامة بـnp.seed. وهناك مقايضة بين استعمال المولّد العام وبين استعمال كائنRandomStateمحلّي. فإذا استعملت المولّد العام، فلن تحتاج إلى تمرير كائنRandomStateفي كل مكان. غير أنك في المقابل تتعرّض لخطر الاعتماد على شيفرة طرف ثالث تستعمل المولّد العام أيضاً دون علمك. وإذا استعملت كائناً محلّياً، يصبح من الأسهل أيّهما كان يعرف ما إذا كان ما إذا كان عدم الحتمية يأتي من مكان آخر غير شيفرتك أنت. ↩︎