عدّاد خطوات في العالم الحقيقي
ديسي مهندسة بحكم عملها، ورائدة أعمال بحماسها، ومطوّرة في جوهرها. وهي حاليًا المديرة التقنية والمؤسِّسة الشائعة لـ Nudge Rewards وحين لا تنشغل ببناء المنتج مع فريقها، فإنك تجدها تُعلّم الآخرين البرمجة، أو تحضر أو تستضيف حدثًا تقنيًا في تورونتو، أو تكون متّصلة على dessydaskalov.com و@dess_e.
عالم مثالي
كثير من مهندسي البرمجيات، حين يستحضرون تدريبهم، يتذكّرون متعة العيش في عالم مثالي للغاية. كنّا نُعلَّم حلّ مشكلات محدَّدة المعالم في مجالات مثالية.
ثمّ أُلقي بنا في العالم الحقيقي، بكل تعقيداته وتحدّياته. إنه فوضوي، وهذا ما يجعله أكثر إثارةً بكثير. وحين تستطيع حلّ مشكلة من الحياة الواقعية بكل مراوغاتها، تستطيع بناء برمجيات تساعد الناس فعلًا.
في هذا الفصل، سنفحص مشكلة تبدو بسيطة على السطح، وتتشابك بسرعة شديدة بمجرّد إدخال العالم الحقيقي والناس الحقيقيين إلى المعادلة.
سنعمل معًا لبناء عدّاد خطوات أساسي. سنبدأ بمناقشة النظر وراء عدّاد الخطوات، وبناء حلّ لعدّ الخطوات خارج الشيفرة. ثمّ سننفّذ حلّنا في الشيفرة. وأخيرًا، سنضيف طبقة ويب إلى شيفرتنا لنحصل على واجهة ودّية يعمل بها المستخدم.
لنرفع أكمامنا، ونستعدّ لفكّ اشتباك مشكلة من العالم الحقيقي.
نظرية عدّاد الخطوات
أتى ظهور الأجهزة المحمولة consigoّه اتجاهًا لجمع بيانات أكثر فأكثر عن حياتنا اليومية. ومن أنواع البيانات التي يجمعها كثيرون عدد الخطوات التي قطعوها خلال فترة زمنية. ويمكن استخدام هذه البيانات لتتبّع الصحة، أو للتدريب على الفعاليات الرياضية، أو — لمن عشنا هوس جمع البيانات وتحليله — لمجرّد المتعة. ويمكن عدّ الخطوات باستخدام عدّاد خطوات، وهو ما يستخدم غالبًا بيانات مقياس التسارع (accelerometer) بوصفه مُدخلًا.
ما هو مقياس التسارع؟
مقياس التسارع قطعة عتاد تقيس التسارع في اتجاهات و و. يحمل كثيرون مقياس تسارع معهم أينما ذهبوا، لأنه مدمج في كل الهواتف الذكية الموجودة في السوق تقريبًا. أمّا اتجاهات و و فهي نسبية إلى الهاتف.
يُعيد مقياس التسارع إشارة (signal) في فضاء ثلاثي الأبعاد. والإشارة مجموعة نقاط بيانات مسجَّلة عبر الزمن. وكل مكوّن من مكوّنات الإشارة هو سلسلة زمنية (time series) تمثّل التسارع في أحد اتجاهات أو أو . وكل نقطة في السلسلة الزمنية هي التسارع في ذلك الاتجاه عند لحظة زمنية بعينها. ويُقاس التسارع بوحدات قوة الجاذبية، أو ما يُرمز له بـ g. وتُساوى g الواحدة 9.8 ، أي التسارع الناتج عن جاذبية الأرض في المتوسط.
يعرض accelerationtotal مثالًا لإشارة من مقياس تسارع مع السلاسل الزمنية الثلاث.
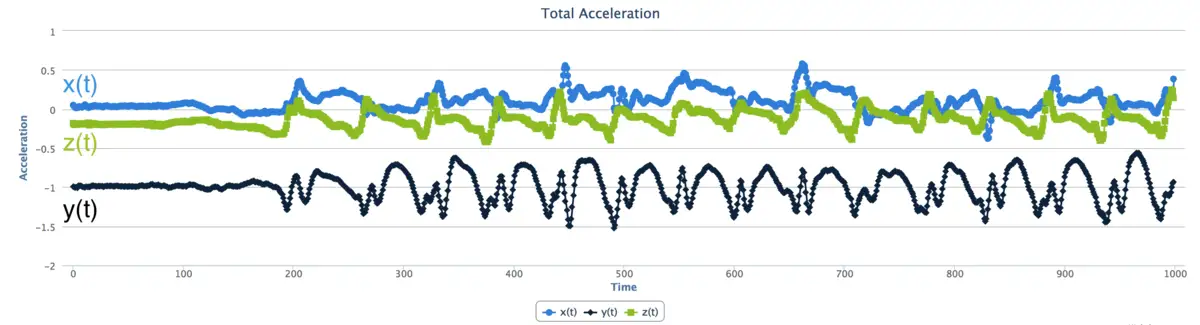
معدل أخذ العينات (sampling rate) لمقياس التسارع، والذي يمكن معايرته في غالب الأحيان، يحدّد عدد القياسات في الثانية. فمثلًا، مقياس تسارع معدل أخذ عيّناته 100 يُعيد 100 نقطة بيانات لكل سلسلة زمنية من و و في كل ثانية.
لنتحدّث عن المشي
حين يمشي شخص، فإنّه يقفز قليلًا مع كل خطوة. راقب فقط أعلى رأس شخصٍ وأنت يبتعد عنك. إنّ رأسه وجذعه وورَكَيه متزامنة في حركة نطّية ناعمة. ورغم أنّ الناس لا يقفزون بعيدًا — مسافة سنتيمتر أو سنتيمترين فقط — فإنّ هذه واحدة من أوضح أجزاء إشارة تسارع مشي الشخص وأكثرها ثباتًا وأكثرها تمييزًا.
يقفز الشخص إلى أعلى وأسفل، في الاتجاه العمودي، مع كل خطوة. وإن كنت تمشي على الأرض (أو على كرة ضخمة أخرى ذات كتلة تطفو في الفضاء) فإنّ القفزة تقع، بسوء حظّ مريح، في الاتجاه نفسه الذي تتّجه إليه الجاذبية.
سنعدّ الخطوات باستخدام مقياس التسارع لعدّ القفزات إلى أعلى وأسفل. ولأنّ الهاتف يمكن أن يدور في أي اتجاه، سنستخدم الجاذبية لمعرفة أيّ اتجاه هو الأسفل. يستطيع عدّاد الخطوات أن يعدّ الخطوات بعدّ عدد القفزات في اتجاه الجاذبية.
لننظر إلى شخصٍ يمشي والهاتف الذكي المزوَّد بمقياس تسارع في جيب قميصه أو قميصها (walk1).
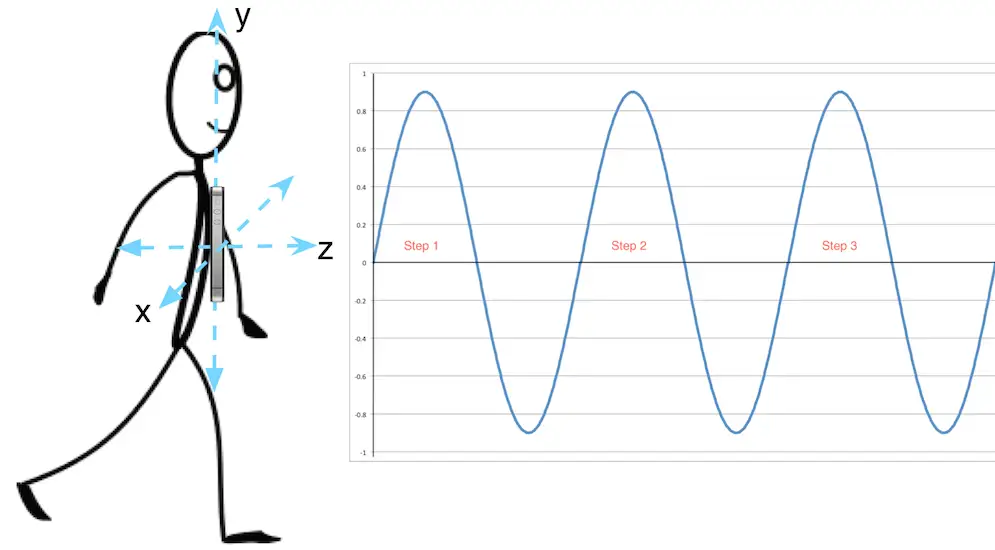
لأغراض البساطة، سنفترض أنّ الشخص:
- يمشي في الاتجاه ؛
- يقفز مع كل خطوة في الاتجاه ؛ و
- يُبقي الهاتف في الاتجاهية نفسها طوال المشية كلّها.
في عالمنا المثالي، سيُشكّل التسارع الناتج عن قفزات الخطوات موجة جيبية مثالية في الاتجاه . وكل قمة في الموجة الجيبية هي خطوة بالضبط. ويصبح عدّ الخطوات مجرّد مسألة عدّ هذه القمم المثالية.
آه، مباهج العالم المثالي، الذي لا نجرّبه إلا في النصوص مثل هذا. لا تقلق، فالأمور على وشك أن تصبح أكثر فوضوية قليلًا، وأكثر إثارةً بكثير. لنضف قليلًا من الواقعية إلى عالمنا.
حتى العوالم المثالية تخضع لقوى الطبيعة الأساسية
قوة الجاذبية تسبّب تسارعًا في اتجاه الجاذبية، ونشير إليه بـالتسارع الجاذبي. وهذا التسارع فريد من نوعه لأنه موجود دائمًا، وهو — لأغراض هذا الفصل — ثابت عند 9.8 .
لنفترض أن هاتفًا ذكيًا مستلقٍ على طاولة وشاشته إلى الأعلى. وفي هذه الاتجاهية، يكون نظام الإحداثيات لدينا بحيث إنّ الاتجاه السالب هو الاتجاه الذي تعمل عليه الجاذبية. ستسحب الجاذبية هاتفنا في الاتجاه السالب ، لذا فإنّ مقياس التسارع لدينا، حتى وهو ساكن تمامًا، سيُسجّل تسارعًا قدره 9.8 في الاتجاه السالب . وبيانات مقياس التسارع من هاتفنا في هذه الاتجاهية معروضة في accelerationtotalphonestill.
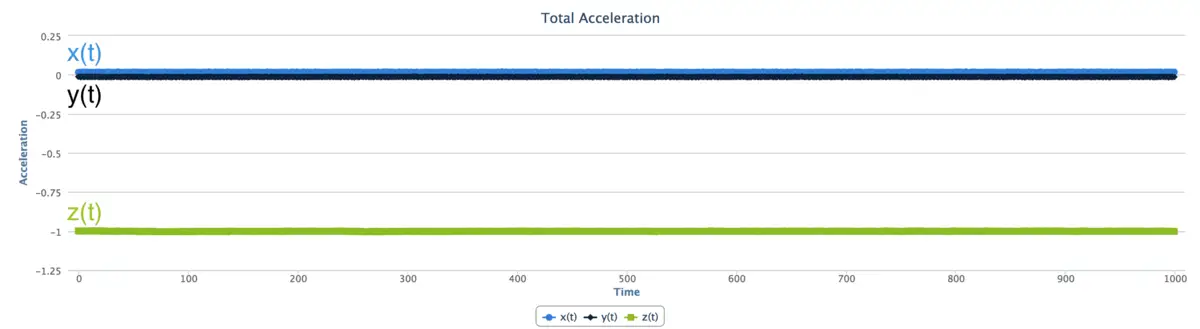
لاحظ أنّ و يبقيان ثابتين عند 0، بينما ثابت عند -1 g. فمقياس التسارع لدينا يُسجّل كل التسارع، بما فيه التسارع الجاذبي.
تقيس كل سلسلة زمنية التسارع الكلي (total acceleration) في ذلك الاتجاه. والتسارع الكلي هو مجموع تسارع المستخدم (user acceleration) والتسارع الجاذبي (gravitational acceleration).
تسارع المستخدم هو تسارع الجهاز الناتج عن حركة المستخدم، ويكون ثابتًا عند 0 حين يكون الهاتف ساكنًا تمامًا. غير أنّه حين يتحرّك المستخدم حاملًا الجهاز، نادرًا ما يكون تسارع المستخدم ثابتًا، لأنّ من الصعب على الإنسان أن يتحرّك بتسارع ثابت.
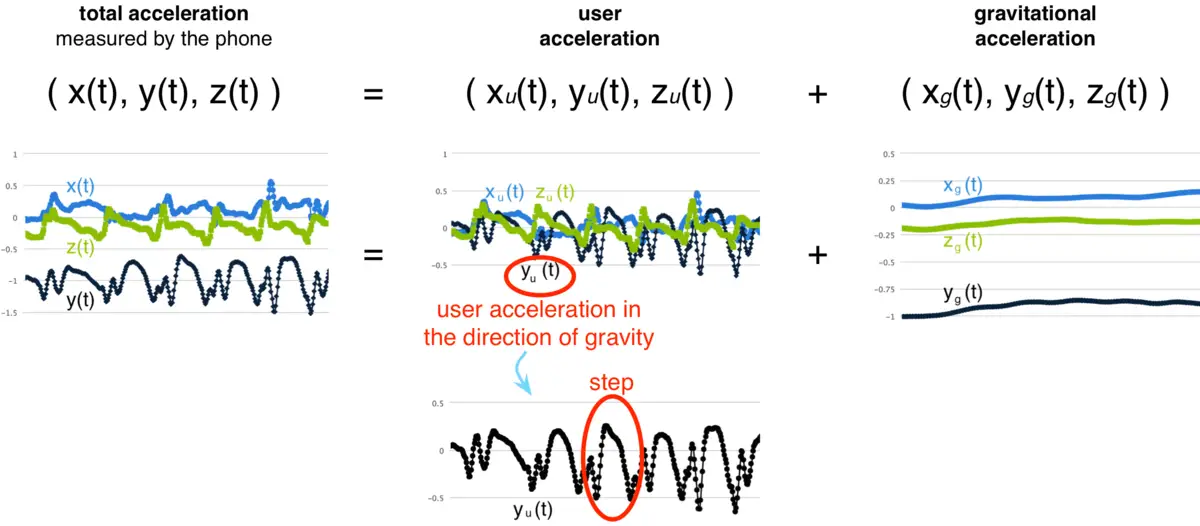
لعدّ الخطوات، يهمّنا القفزات التي ينتجها المستخدم في اتجاه الجاذبية. أي إنّنا نهتمّ بعزل السلسلة الزمنية ذات البُعد الواحد التي تصف تسارع المستخدم في اتجاه الجاذبية من إشارتنا ثلاثية الأبعاد للتسارع (componentsignals).
في مثالنا البسيط، يكون التسارع الجاذبي 0 في و وثابتًا عند 9.8 في . لذا، في مخطّط التسارع الكلي لدينا، تتذبذب و حول 0 بينما تتذبذب حول -1 g. وفي مخطّط تسارع المستخدم لدينا، نلاحظ أنّه — لأنّنا أزلنا التسارع الجاذبي — تتذبذب السلاسل الزمنية الثلاث كلها حول 0. لاحظ القمم الواضحة في . إنّها ناتجة عن قفزات الخطوات! وفي مخطّطنا الأخير، التسارع الجاذبي ثابت عند -1 g، و و ثابتان عند 0.
إذن، في مثالنا، السلسلة الزمنية ذات البُعد الواحد لتسارع المستخدم في اتجاه الجاذبية التي تهمّنا هي . ورغم أنّ ليس ناعمًا كموجتنا الجيبية المثالية، يمكننا تحديد القمم واستخدام تلك القمم لعدّ الخطوات. إلى الآن، الأمور على خير. والآن، لنضف المزيد من الواقعية إلى عالمنا.
البشر مخلوقات معقّدة
ماذا لو كان الشخص يحمل الهاتف في حقيبة على كتفه، والوضعية فيه أكثر اعوجاجًا؟ والأسوأ من ذلك، ماذا لو دار الهاتف داخل الحقيبة في منتصف المشية، كما في walk2؟
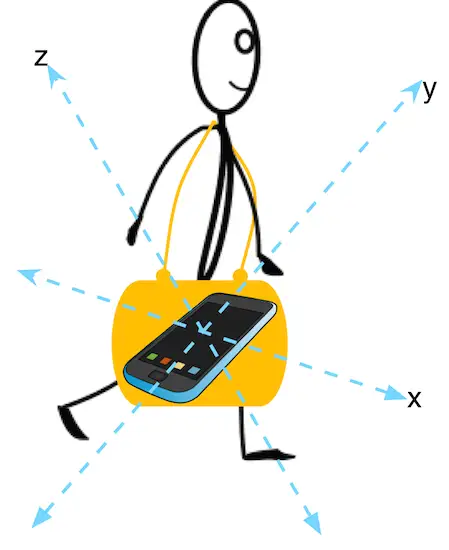
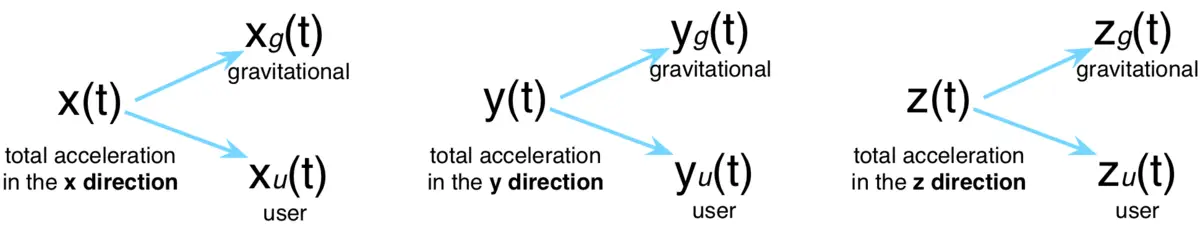
يا إلهي. الآن—all مكوّناتنا الثلاثة أصبح لها تسارع جاذبي غير صفري، لذا فإنّ تسارع المستخدم في اتجاه الجاذبية صار موزّعًا الآن على السلاسل الزمنية الثلاث جميعًا. ولتحديد تسارع المستخدم في اتجاه الجاذبية، علينا أوّلًا أن نحدّد أيّ اتجاه تعمل فيه الجاذبية. وللقيام بذلك، علينا أن نقسّم التسارع الكلي في كل سلسلة من السلاسل الزمنية الثلاث إلى سلسلة زمنية لتسارع المستخدم وأخرى للتسارع الجاذبي (component3).
بعد ذلك يمكننا عزل الجزء من تسارع المستخدم في كل مكوّن يقع في اتجاه الجاذبية، فتُنتج سلسلة زمنية واحدة تمثّل تسارع المستخدم في اتجاه الجاذبية فحسب.
لنُعرِّف هذا بالخطوتين التاليتين:
- تقسيم التسارع الكلي إلى تسارع المستخدم والتسارع الجاذبي.
- عزل تسارع المستخدم في اتجاه الجاذبية.
سننظر في كل خطوة على حدة، ونلبس قبعات الرياضيين.
1. تقسيم التسارع الكلي إلى تسارع المستخدم والتسارع الجاذبي
يمكننا استخدام أداة اسمها مُرشِّح (filter) لتقسيم سلسلة زمنية للتسارع الكلي إلى سلسلة زمنية لتسارع المستخدم وأخرى للتسارع الجاذبي.
مرشّحات التمرير المنخفض والمرتفع
المُرشِّح أداة تُستخدم في معالجة الإشارات لإزالة مكوّن غير مرغوب من إشارة.
يسمح مرشّح التمرير المنخفض (low-pass filter) بمرور إشارات منخفضة التردد، مع تخميد الإشارات الأعلى من عتبة محدَّدة. وعلى النقيض، يسمح مرشّح التمرير المرتفع (high-pass filter) بمرور إشارات عالية التردد، مع تخميد الإشارات الأدنى من عتبة محدَّدة. وباستخدام الموسيقى تشبيهًا، يستطيع مرشّح التمرير المنخفض إزالة النغمات الحادة، ويستطيع مرشّح التمرير المرتفع إزالة النغمات المنخفضة.
في حالتنا، يصف التردد — المقاس بالهرتز — مدى سرعة تغيّر التسارع. ولتسارع ثابت التردد هو 0 هرتز، بينما للتسارع غير Constant التردد غير صفري. وهذا يعني أنّ تسارعنا الجاذبي Constant هو إشارة بتردد 0 هرتز، في حين إنّ تسارع المستخدم ليس كذلك.
لكل مكوّن، يمكننا تمرير التسارع الكلي عبر مرشّح تمرير منخفض، فيتبقّى لدينا سلسلة التسارع الجاذبي وحدها. ثمّ يمكننا طرح التسارع الجاذبي من التسارع الكلي، فتكون لدينا سلسلة تسارع المستخدم (lowpass).
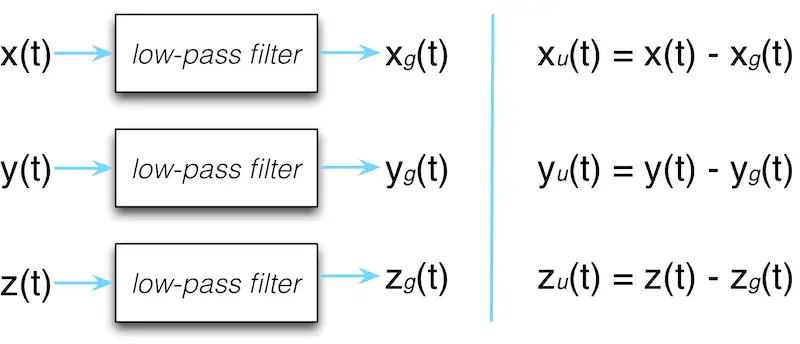
توجد أنواع كثيرة من المرشّحات. والمرشّح الذي سنستخدمه اسمه مُرشِّح استجابة نبضية لا نهائية (infinite impulse response, IIR). وقد اخترنا مرشّح IIR بسببالتكلفةه المنخفض وسهولة تنفيذه. أما مرشّح IIR الذي اخترناه منفَّذ بالمعادلة التالية:
تصميم المرشّحات الرقمية خارج نطاق هذا الفصل، لكنّ من المناسب تقديم لمحة قصيرة عنه. إنه موضوع مدروس جيّدًا ومثير للدهشة، وله تطبيقات عملية عديدة. ويمكن تصميم مرشّح رقمي يلغي أي تردد أو مدى من الترددات نرغب في إلغائه. أمّا قيم و في المعادلة فهي معاملات (coefficients)، تُضبط استنادًا إلى تردد القطع (cutoff frequency) ومدى الترددات الذي نرغب في الحفاظ عليه.
نرغب في إلغاء كل الترددات عدا تسارعنا الجاذبي Constant، لذا اخترنا معاملات تخمّد الترددات الأعلى من 0.2 هرتز. لاحظ أننا ضبطنا عتبتنا أعلى قليلًا من 0 هرتز. فرغم أنّ الجاذبية تنتج فعلًا تسارعًا بتردد 0 هرتز حقيقي، فإنّ عالمنا الحقيقي الناقص يحوي مقاييس تسارع حقيقية ناقصة، لذا نسمح بهامش خطأ صغير في القياس.
تنفيذ مرشّح تمرير منخفض
لنعمل على تنفيذ مرشّح تمرير منخفض باستخدام مثالنا السابق. سنقسم:
- إلى و،
- إلى و، و
- إلى و.
سنهيّئ أول قيمتين للتسارع الجاذبي لتكونا 0، بحيث تتوفّر للمعادلة قيم ابتدائية تعمل بها.
ثمّ سننفّذ معادلة المرشّح لكل سلسلة زمنية.
السلاسل الزمنية الناتجة بعد الترشيح بالتمرير المنخفض معروضة في accelerationgravitational.
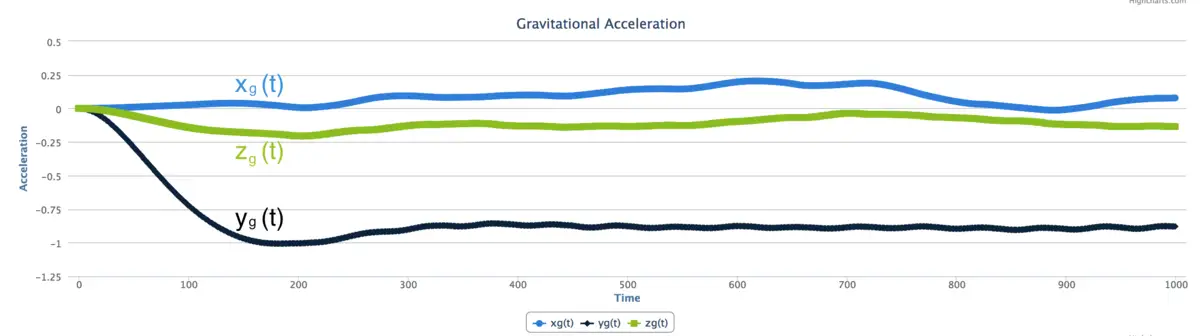
تدور و حول 0، و تهبط بسرعة شديدة إلى . أمّا القيمة 0 الابتدائية في فتأتي من تهيئة المعادلة.
الآن، ولحساب تسارع المستخدم، يمكننا طرح التسارع الجاذبي من تسارعنا الكلي:
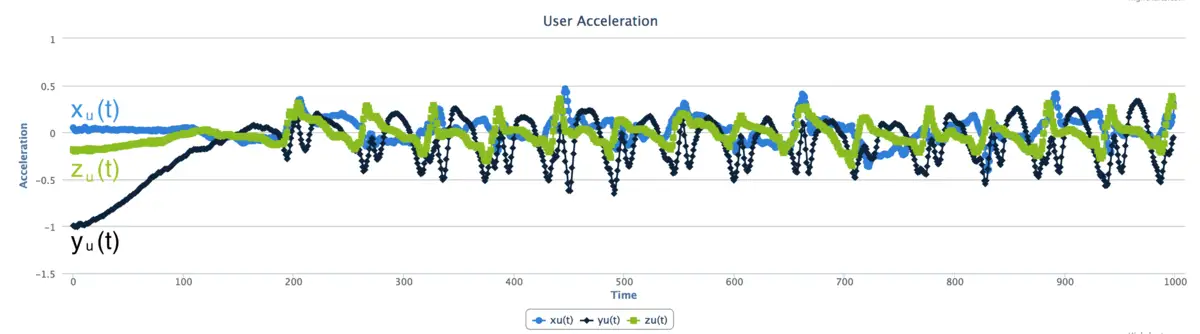
والنتيجة هي السلسلة الزمنية الموضَّحة في accelerationuser. لقد نجحنا في تقسيم تسارعنا الكلّي إلى تسارع المستخدم والتسارع الجاذبي!
2. عزل تسارع المستخدم في اتجاه الجاذبية
تشمل و و كل حركات المستخدم، لا مجرّد الحركات الواقعة في اتجاه الجاذبية. وهدفنا هنا هو أن نصل في النهاية إلى سلسلة زمنية ذات بُعد واحد تمثّل تسارع المستخدم في اتجاه الجاذبية. وستتضمّن ذلك أجزاء من تسارع المستخدم في كل اتجاه.
لنبدأ. أوّلًا، بعض الجبر الخطّي 101. لا تخلع قبّعة الرياضي بعد!
حاصل الضرب النقطي
حين تعمل مع الإحداثيات، لن تمضي بعيدًا قبل أن تُقدَّم إلى حاصل الضرب النقطي (dot product)، إحدى الأدوات الأساسية المستخدمة في مقارنة مقدار واتجاه إحداثيات و و.
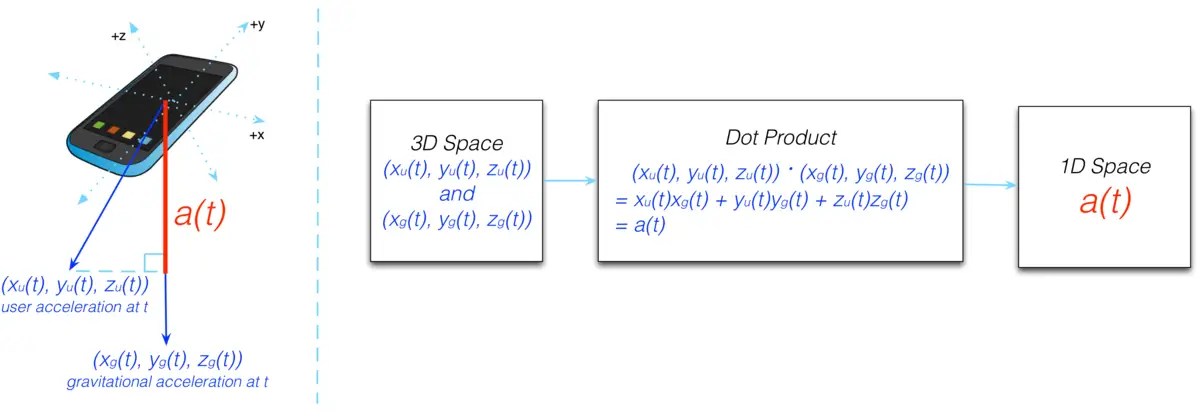
يأخذنا حاصل الضرب النقطي من فضاء ثلاثي الأبعاد إلى فضاء أحادي البُعد (dotproduct). وحين نأخذ حاصل الضرب النقطي للسلسلتين الزمنيتين — تسارع المستخدم وتسارع الجاذبي، وكلاهما في فضاء ثلاثي الأبعاد — يتبقّى لدينا سلسلة زمنية واحدة في فضاء أحادي البُعد تمثّل الجزء من تسارع المستخدم في اتجاه الجاذبية. وسنسمّي هذه السلسلة الزمنية الجديدة بشكل اعتباطي، لأنّ، حسنًا، كل سلسلة زمنية مهمّة تستحقّ اسمًا.
تنفيذ حاصل الضرب النقطي
يمكننا تنفيذ حاصل الضرب النقطي لمثالنا السابق باستخدام المعادلة ، فتتبقّى لدينا في فضاء أحادي البُعد (accelerationdotproduct).
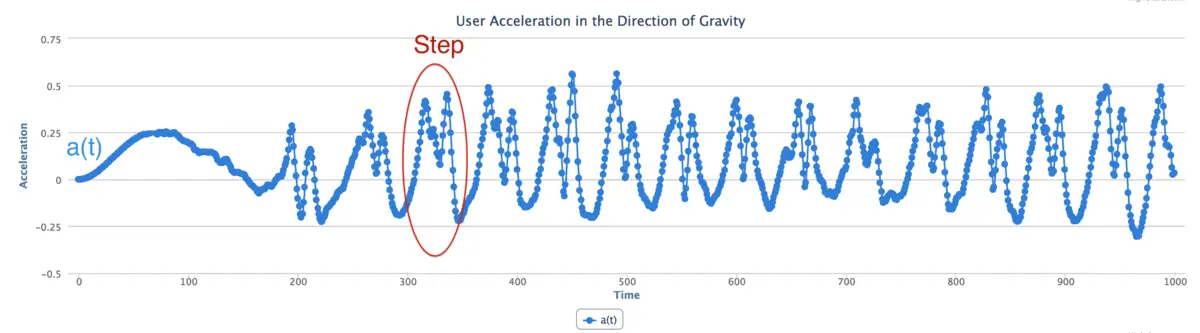
أصبح بإمكاننا الآن تمييز مواضع الخطوات بصريًا في . حاصل الضرب النقطي قويّ جدًا، وبسيط بجمال.
الحلول في العالم الحقيقي
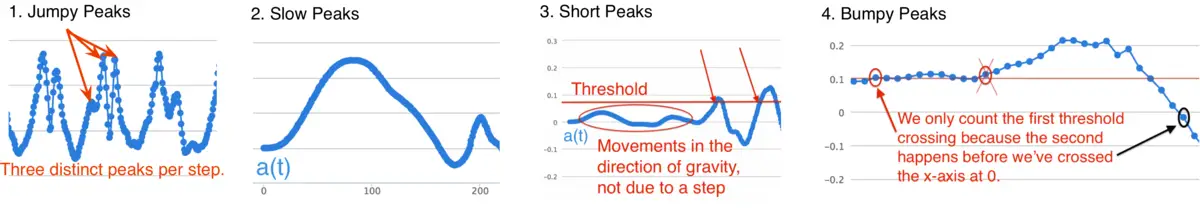
رأينا مدى سرعة تحوّل مشكلتنا التي تبدو بسيطة إلى أكثر تعقيدًا عندما ألقينا في Commitment تحدّيات العالم الحقيقي والناس الحقيقيين. لكنّنا نقترب كثيرًا من عدّ الخطوات، ونرى كيف بدأت تشبه موجتنا الجيبية المثالية. لكنّها فقط "إلى حدٍّ ما، نوعًا ما" بدأت تشبهها. ما زال علينا أن نُنعّم سلسلة الفوضوية لدينا. وهناك أربع مشكلات رئيسية (problems) في في حالتها الحالية. لنفحص كل واحدة منها.
1. قمم متقطّعة
«متقطّعة» جدًا، لأنّ الهاتف يمكن أن يهتزّ مع كل خطوة، مضافًا thereby مكوّنًا عالي التردد إلى سلسلتنا الزمنية. وتُسمّى هذه التقطيعية ضجيجًا (noise). ومن خلال دراسة مجموعات بيانات عديدة، تبيّنا أنّ تسارع الخطوة يبلغ 5 هرتز كحدٍّ أقصى. يمكننا استخدام مرشّح تمرير منخفض من نوع IIR لإزالة الضجيج، مع اختيار و بحيث تخمّد كل الإشارات فوق 5 هرتز.
2. قمم بطيئة
مع معدل أخذ عينات قدره 100، تمتدّ القمة البطيئة المعروضة في على 1.5 ثانية، وهي بطيئة أكثر من اللازم لتُعدّ خطوة. وفي دراسة ما يكفي من عينات البيانات، تبيّنا أنّ أبطأ خطوة يمكننا قطعها تقع عند تردد 1 هرتز. أمّا التسارعات الأبطأ فسببها مكوّن منخفض التردد، يمكننا إزالته أيضًا باستخدام مرشّح تمرير مرتفع من نوع IIR، مع ضبط و لإلغاء كل الإشارات تحت 1 هرتز.
3. قمم قصيرة
حين يستخدم شخص تطبيقًا أو يُجري مكالمة، يسجّل مقياس التسارع حركات صغيرة في اتجاه الجاذبية، تظهر على هيئة قمم قصيرة في سلسلتنا الزمنية. يمكننا إلغاء هذه القمم القصيرة بضبط حدّ أدنى، وعدّ خطوة في كلّ مرّة تعبر فيها تلك العتبة في الاتجاه الموجب.
4. قمم متعرّجة
ينبغي أن يستوعب عدّاد الخطوات لدينا كثيرين من الناس بطرق مشي مختلفة، لذا فقد ضبطنا حدّ أدنى وحدًّا أقصى لتردد الخطوات استنادًا إلى عيّنة كبيرة من الناس وطرق المشي. وهذا يعني أننا قد نرشّح أحيانًا أكثر قليلًا أو أقلّ قليلًا. ورغم أننا سنحصل غالبًا على قمم ناعمة إلى حدٍّ معقول،WUsometimes — كلّ فترة وجينًا — سنحصل على قمة «أكثر تعرّجًا». ويقرب problems أحد هذه القمم.
عندما تقع التعرّجات عند عتبتنا، يمكننا أن نعدّ خطوات أكثر بالخطأ لقمة واحدة. وسنستخدم طريقة اسمها التخلّف (hysteresis) للتعامل مع ذلك. ويعني التخلّف اعتماد المُخرَج على المدخلات السابقة. يمكننا عدّ عبورات العتبة في الاتجاه الموجب، وكذلك عبورات 0 في الاتجاه السالب. ثمّ لا نعدّ إلا الخطوات التي يقع فيها عبور العتبة بعد عبور 0، بما يضمن أنّنا نعدّ كل خطوة مرة واحدة فقط.
قمم هي مضبوطة تمامًا
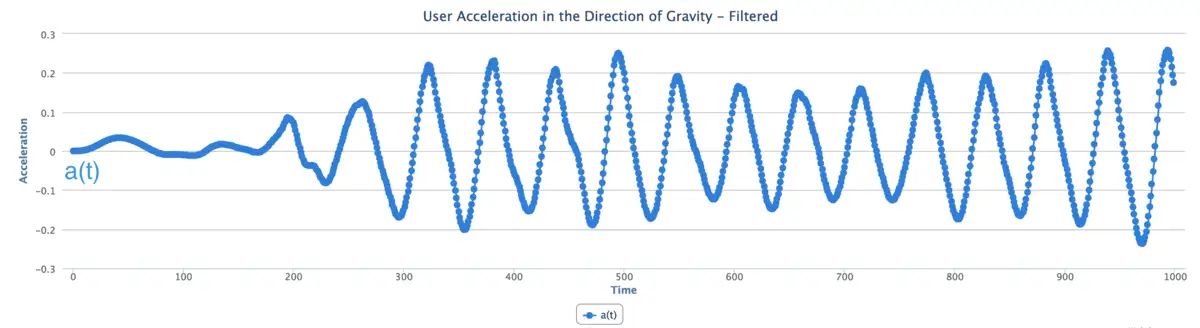
بعد أخذ هذه السيناريوهات الأربعة في الحسبان، تمكّنّا من تقريب الفوضوية لدينا إلى حدٍّ معقول من موجتنا الجيبية المثالية (accelerationfiltered)، مما يتيح لنا عدّ الخطوات.
الخلاصة
بدت المشكلة أوّل نظرة بسيطة. لكنّ العالم الحقيقي والناس الحقيقيين رمونا ببض كرات منحرفة في طريقنا. لنُراجع كيف حللنا المشكلة:
- بدأنا بالتسارع الكلي، .
- استخدمنا مرشّح تمرير منخفض لتقسيم التسارع الكلي إلى تسارع المستخدم والتسارع الجاذبي، و على التوالي.
- أخذنا حاصل الضرب النقطي بين و للحصول على تسارع المستخدم في اتجاه الجاذبية، .
- استخدمنا مرشّح تمرير منخفض مجدّدًا لإزالة المكوّن عالي التردد من ، أي إزالة الضجيج.
- استخدمنا مرشّح تمرير مرتفع لإلغاء المكوّن منخفض التردد من ، أي إزالة القمم البطيئة.
- ضبطنا عتبة لتجاهل القمم القصيرة.
- استخدمنا التخلّف لتجنّب العدّ المزدوج للخطوات ذات القمم المتعرّجة.
كمطوّري برمجيات في سياق تدريبي أو أكاديمي، من المحتمل أن يكون قد عُرضت علينا إشارة مثالية وطُلب منّا كتابة شيفرة تعدّ الخطوات فيها. وقد يكون ذلك تحدّي برمجيًا مثيرًا للاهتمام، لكنه لن يكون شيئًا يمكننا تطبيقه في وضع حيّ. رأينا أنّه في الواقع، عند إدخال الجاذبية والبشر إلى المعادلة، كانت المشكلة أكثر تعقيدًا بقليل. استخدمنا أدوات رياضية للتعامل مع التعقيدات، وتمكّنّا من حلّ مشكلة من العالم الحقيقي. حان وقت ترجمة حلّنا إلى شيفرة.
الغوص في الشيفرة
هدفنا في هذا الفصل هو إنشاء تطبيق ويب بلغة Ruby يقبل بيانات مقياس التسارع، ويحلّلها ويعالجها ويحللها، ويعيد عدد الخطوات المقطوعة، والمسافة المقطوعة، والزمن المنقضي.
أعمال تحضيرية
يتطلب حلّنا أن نرشّح سلاسلنا الزمنية عدّة مرّات. وبدلًا من نثر شيفرة الترشيح في كل أنحاء برنامجنا، من المنطقي أن ننشئ صنفًا يتولّى الترشيح، فإذا احتجنا يومًا ما إلى تحسينه أو تعديله، فلن نضطر إلّا إلى تغيير ذلك الصنف الواحد. وتُسمّى هذه الاستراتيجية فصل المسؤوليات (separation of concerns)، وهو مبدأ تصميم شائع يشجّع على تقسيم البرنامج إلى أجزاء متميّزة، لكل جزء فيها مسؤولية رئيسية واحدة. إنها طريقة جميلة لكتابة شيفرة نظيفة قابلة للصيانة وسهلة التوسّع. وسنعود إلى هذه الفكرة عدّة مرات طوال الفصل.
لنغُص في شيفرة الترشيح، والمحتضَنة منطقيًا في صنف Filter.
class Filter

  COEFFICIENTS_LOW_0_HZ = {
    alpha: [1, -1.979133761292768, 0.979521463540373],
    beta:  [0.000086384997973502, 0.000172769995947004, 0.000086384997973502]
  }
  COEFFICIENTS_LOW_5_HZ = {
    alpha: [1, -1.80898117793047, 0.827224480562408],
    beta:  [0.095465967120306, -0.172688631608676, 0.095465967120306]
  }
  COEFFICIENTS_HIGH_1_HZ = {
    alpha: [1, -1.905384612118461, 0.910092542787947],
    beta:  [0.953986986993339, -1.907503180919730, 0.953986986993339]
  }

  def self.low_0_hz(data)
    filter(data, COEFFICIENTS_LOW_0_HZ)
  end

  def self.low_5_hz(data)
    filter(data, COEFFICIENTS_LOW_5_HZ)
  end

  def self.high_1_hz(data)
    filter(data, COEFFICIENTS_HIGH_1_HZ)
  end

private

  def self.filter(data, coefficients)
    filtered_data = [0,0]
    (2..data.length-1).each do |i|
      filtered_data << coefficients[:alpha][0] *
                      (data[i]            * coefficients[:beta][0] +
                       data[i-1]          * coefficients[:beta][1] +
                       data[i-2]          * coefficients[:beta][2] -
                       filtered_data[i-1] * coefficients[:alpha][1] -
                       filtered_data[i-2] * coefficients[:alpha][2])
    end
    filtered_data
  end

end
في أيّ وقت يحتاج فيه برنامجنا إلى ترشيح سلسلة زمنية، يمكننا استدعاء إحدى طرائق الصنف في Filter مع البيانات التي نرغب في ترشيحها:
- تُستخدَم
low_0_hzلترشيح إشارات قريبة من 0 هرتز بمرشّح تمرير منخفض - تُستخدَم
low_5_hzلترشيح إشارات عند 5 هرتز أو أقلّ بمرشّح تمرير منخفض - تُستخدَم
high_1_hzلترشيح إشارات فوق 1 هرتز بمرشّح تمرير مرتفع
كلّ طريقة من طرائق الصنف تستدعي filter، وهي التي تنفّذ مرشّح IIR وتعيد النتيجة. وإذا رغبنا في إضافة مرشّحات أخرى مستقبلًا، فلن نضطر إلّا إلى تغيير هذا الصنف الواحد. ولاحظ أنّ كل الأعداد السحرية معرَّفة في الأعلى. وهذا يجعل صنفنا أسهل في القراءة والفهم.
صيغ الإدخال
تأتي بيانات الإدخال لدينا من أجهزة محمولة مثل هواتف أندرويد وآيفون. ومعظم الهواتف المحمولة الموجودة في السوق اليوم فيها مقاييس تسارع مدمجة قادرة على تسجيل التسارع الكلي. ولنسمِّ صيغة بيانات الإدخال التي تسجّل التسارع الكلي بـالصيغة المُدمَجة (combined format). كما أنّ كثيرًا من الأجهزة — لا جميعها — تستطيع كذلك تسجيل تسارع المستخدم والتسارع الجاذبي منفصلين. ولنسمِّ هذه الصيغة الصيغة المُنفصَلة (separated format). والجهاز القادر على إعادة البيانات بالصيغة المنفصلة يملك بالضرورة القدرة على إعادة البيانات بالصيغة المدمجة. لكنّ العكس ليس صحيحًا دائمًا. فبعض الأجهزة لا تستطيع تسجيل البيانات إلّا بالصيغة المدمجة. وستحتاج بيانات الإدخال بالصيغة المدمجة إلى المرور عبر مرشّح تمرير منخفض لتحويلها إلى الصيغة المنفصلة.
نريد لبرنامجنا أن يتعامل مع جميع الأجهزة المحمولة الموجودة في السوق والمزوّدة بمقاييس تسارع، لذا سنحتاج إلى قبول البيانات بكلتا الصيغتين. ولننظر إلى الصيغتين اللتين سنقبلهما كلٌّ على حدة.
الصيغة المدمجة
البيانات في الصيغة المدمجة هي التسارع الكلي في اتجاهات و و عبر الزمن. وستفصل قيم و و بفاصلة، وتفصل العيّنات لكل وحدة زمن بفاصلة منقوطة.
الصيغة المنفصلة
تعيد الصيغة المنفصلة تسارع المستخدم والتسارع الجاذبي في اتجاهات و و عبر الزمن. وستُفصل قيم تسارع المستخدم عن قيم التسارع الجاذبي بخطّ أنبوبي (pipe).
لديّ صيغ إدخال متعددة لكنّ صيغة قياسية ليست كذلك
التعامل مع صيغ إدخال متعددة مشكلة برمجية شائعة. فإذا أردنا أن يعمل برنامجنا بالكامل مع الصيغتين، لكان على كل جزء من الشيفرة الذي يتعامل مع البيانات أن يعرف كيفية التعامل مع الصيغتين. ويمكن أن يصبح هذا فوضويًا حقًا بسرعة بالغة، خاصّة إذا أُضيفت صيغة إدخال ثالثة (أو رابعة، أو خامسة، أو مئة).
الصيغة القياسية
أنظف طريقة بالنسبة لنا للتعامل مع هذا الأمر هي أن نأخذ صيغتَي الإدخال لدينا ونُدخلهما في صيغة قياسية في أقرب وقت ممكن، بما يسمح لبقية البرنامج بالعمل مع هذه الصيغة القياسية الجديدة. ويتطلب حلّنا أن نعمل مع تسارع المستخدم والتسارع الجاذبي منفصلين، لذا ستحتاج صيغتنا القياسية إلى أن تكون مُقسَّمة إلى التسارعين (standardformat).
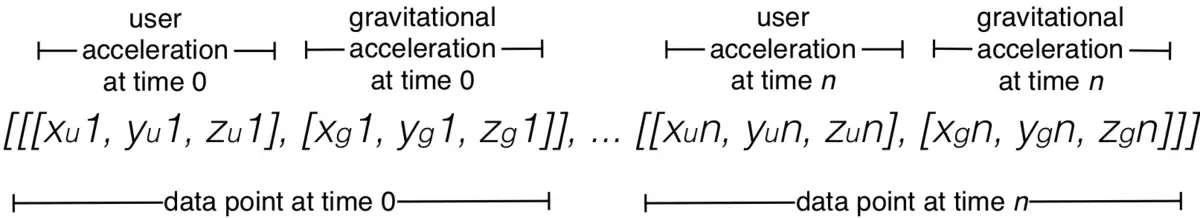
تتيح لنا صيغتنا القياسية تخزين سلسلة زمنية، لأنّ كل عنصر يمثّل تسارعًا عند نقطة زمنية. وقد عرّفناها كمصفوفة من مصفوفات من مصفوفات. لنقشّر هذه البصيلة.
- المصفوفة الأولى مجرّد غلاف للاحتفاظ بكل البيانات.
- المجموعة الثانية من المصفوفات تحتوي مصفوفة واحدة لكل عيّنة بيانات مأخوذة. فإذا كان معدل أخذ العينات لدينا 100 وأخذنا عيّنات البيانات لعشر ثوانٍ، فسيكون لدينا ، أي 1000، مصفوفة في هذه المجموعة الثانية.
- المجموعة الثالثة من المصفوفات هي زوج المصفوفات المغلَّف داخل المجموعة الثانية. كلتاهما تحتوي بيانات التسارع في اتجاهات و و؛ الأولى تمثّل تسارع المستخدم والثانية تمثّل التسارع الجاذبي.
خط أنابيب المعالجة
سيكون المُدخَل إلى نظامنا هو بيانات مقياس التسارع، ومعلومات عن المستخدم الذي يقوم بالمشي (الجنس، طول الخطوة، إلخ)، ومعلومات عن تجربة المشية نفسها (معدل أخذ العينات، الخطوات الفعلية المقطوعة، إلخ). وسيطبّق نظامنا حلّ معالجة الإشارات، ويُخرج عدد الخطوات المحسوب، والفارق بين الخطوات الفعلية والمحسوبة، والمسافة المقطوعة، والزمن المنقضي. ويمكن عرض العملية الكاملة من المُدخَل إلى المُخرَج بوصفها خطّ أنابيب معالجة (pipeline) (pipeline).
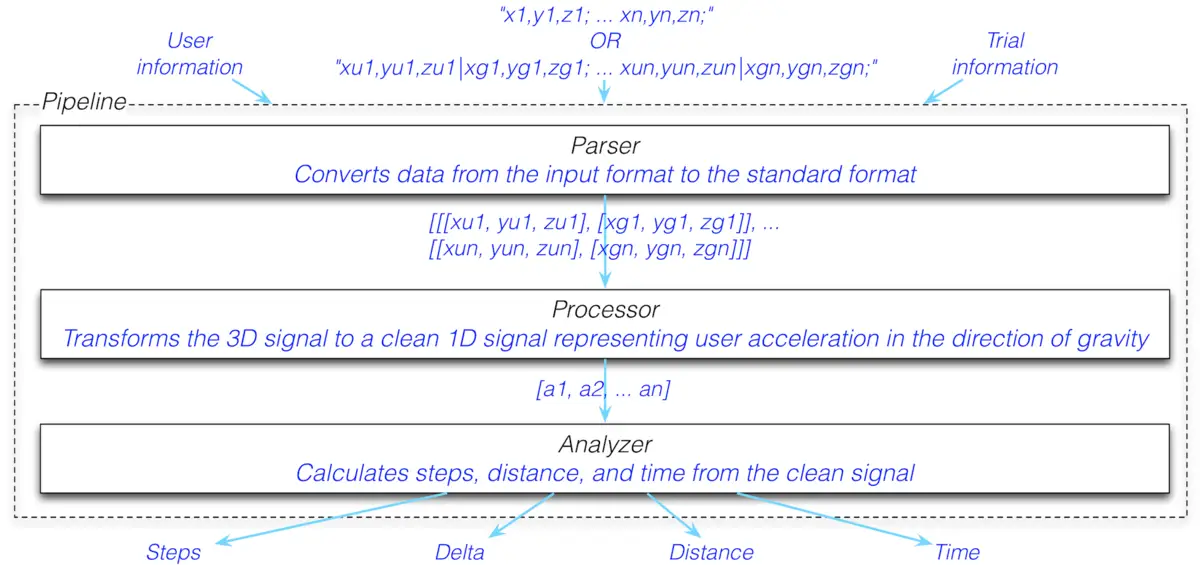
وفي روح فصل المسؤوليات، سنكتب شيفرة كل مكوّن من مكوّنات خط الأنابيب المتمايزة — التحليل النحوي، والمعالجة، والتحليل — على حدة.
التحليل النحوي
نظرًا لأنّنا نريد بياناتنا بالصيغة القياسية في أقرب وقت ممكن، من المنطقي أن نكتب محلّلًا (parser) يسمح لنا بأخذ صيغتَي الإدخال المعروفتين وتحويلهما إلى صيغة إخراج قياسية، بوصفه المكوّن الأوّل في خط أنابيب المعالجة. وحيث إنّ صيغتنا القياسية تفصل تسارع المستخدم عن التسارع الجاذبي، فإنّ ذلك يعني أنّه إذا كانت بياناتنا بالصيغة المدمجة، فسيحتاج محلّلنا أوّلًا إلى تمريرها عبر مرشّح تمرير منخفض لتحويلها إلى الصيغة القياسية.
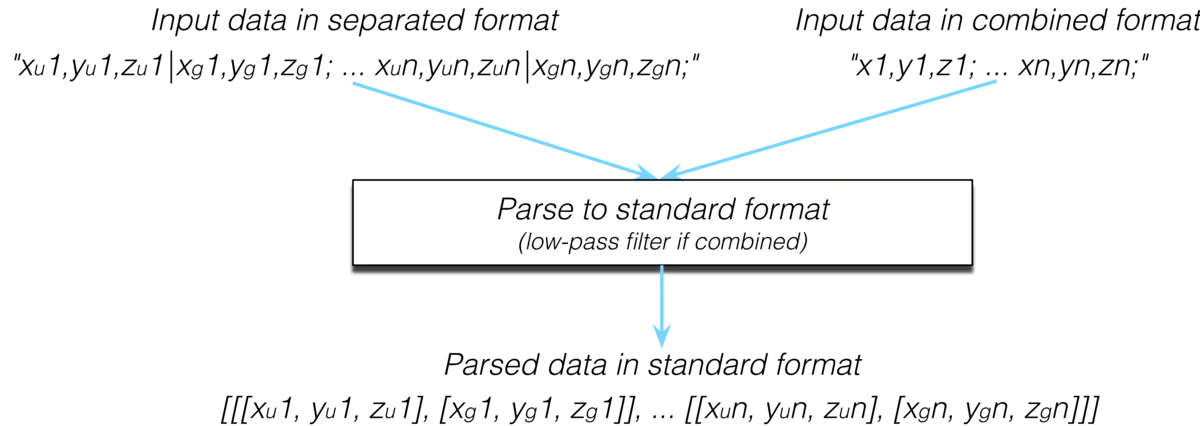
وفي المستقبل، إذا احتجنا يومًا ما إلى إضافة صيغة إدخال أخرى، فلن تكون الشيفرة الوحيدة التي سنحتاج إلى المساس بها هي هذا المحلّل. لنفصل المسؤوليات مرّة أخرى، ولننشئ صنف Parser للتعامل مع التحليل النحوي.
class Parser

  attr_reader :parsed_data

  def self.run(data)
    parser = Parser.new(data)
    parser.parse
    parser
  end

  def initialize(data)
    @data = data
  end

  def parse
    @parsed_data = @data.to_s.split(';').map { |x| x.split('|') }
                   .map { |x| x.map { |x| x.split(',').map(&:to_f) } }

    unless @parsed_data.map { |x| x.map(&:length).uniq }.uniq == [[3]]
      raise 'Bad Input. Ensure data is properly formatted.'
    end

    if @parsed_data.first.count == 1
      filtered_accl = @parsed_data.map(&:flatten).transpose.map do |total_accl|
        grav = Filter.low_0_hz(total_accl)
        user = total_accl.zip(grav).map { |a, b| a - b }
        [user, grav]
      end

      @parsed_data = @parsed_data.length.times.map do |i|
        user = filtered_accl.map(&:first).map { |elem| elem[i] }
        grav = filtered_accl.map(&:last).map { |elem| elem[i] }
        [user, grav]
      end
    end
  end

end
يمتلك Parser طريقة على مستوى الصنف اسمها run إلى جانب مُهيّئ. وهذا نمط سنستخدمه عدّة مرات، لذا فإنّ مناقشته تستحقّ القراءة. من المفترض أن تُستخدم المُهيّئات عمومًا لإعداد كائن، وألّا تقوم بالكثير من العمل. ومُهيّئ Parser يكتفي بأخذ data بالصيغة المدمجة أو المنفصلة وتخزينه في متغيّر النسخة @data. وتستخدم طريقة النسخة parse @data داخليًا، وتقوم بالجزء الأثقل من التحليل النحوي وتضع النتيجة في @parsed_data بالصيغة القياسية. وفي حالتنا، لن نضطر أبدًا إلى إنشاء نسخة Parser من دون استدعاء parse فورًا. لذا، نضيف طريقة مريحة على مستوى الصنف اسمها run تُنشئ نسخة من Parser، وتستدعي parse عليها، وتُعيد نسخة الكائن. ويمكننا الآن تمرير بيانات الإدخال إلى run، وأن نعلم بأنّنا سنحصل على نسخة Parser مع @parsed_data مضبوط مسبقًا.
لننظر إلى طريقتنا المجتهدة parse. الخطوة الأولى في العملية هي أخذ بيانات نصّية وتحويلها إلى بيانات عددية، ما يمنحنا مصفوفة من مصفوفات من مصفوفات. يبدو مألوفًا؟ أمّا الخطوة التالية فهي ضمان أنّ الصيغة كما هو متوقّع. فإذا لم يكن لدينا بالضبط ثلاثة عناصر في كل مصفوفة من المصفوفات الداخلية، فإنّنا نُطلق استثناءً. أمّا في غير ذلك، فنُكمل طريقنا.
لاحظ الفروق في @parsed_data بين الصيغتين في هذه المرحلة. في الصيغة المدمجة يحتوي على مصفوفات تحتوي بالضبط مصفوفة واحدة:
وفي الصيغة المنفصلة يحتوي على مصفوفات تحتوي بالضبط مصفوفتين:
الصيغة المنفصلة تكون بالفعل بصيغتنا القياسية المطلوبة بعد هذه العملية. رائع. لكن إذا كانت البيانات مدموجة (أو، بما يكافئ، تحتوي مصفوفة واحدة بالضبط حيث تحتوي الصيغة المنفصلة اثنتين)، فإنّنا نتابع بحلقتين. تفصل الحلقة الأولى التسارع الكلي إلى الجاذبي والمستخدم، باستخدام Filter من نوع :low_0_hz، وتعيد الحلقة الثانية ترتيب البيانات إلى الصيغة القياسية.
تترك لنا parse @parsed_data محتفظًا بالبيانات بالصيغة القياسية، سواء بدأنا ببيانات مدموجة أو منفصلة. يا لها من راحة!
ومع ازدياد برنامجنا رقيّة، فإنّ أحد ميادين التحسين هو جعل حياة مستخدمنا أسهل بإطلاق استثناءات ذات رسائل خطأ أكثر تحديدًا، ما يتيح لهم تتبّع مشكلات تنسيق الإدخال الشائعة بسرعة أكبر.
المعالجة
استنادًا إلى الحلّ الذي عرّفناه، ستحتاج شيفرتنا إلى إنجاز أمرين على بياناتنا المُحلَّلة قبل أن نتمكّن من عدّ الخطوات:
- عزل الحركة في اتجاه الجاذبية باستخدام حاصل الضرب النقطي.
- إزالة القمم المتقطّعة (عالية التردد) والبطيئة (منخفضة التردد) بمرشّح تمرير منخفض يليه مرشّح تمرير مرتفع.
وسنتعامل مع القمم القصيرة والمتعرّجة بتجنّبها أثناء عدّ الخطوات.
والآن وقد صار لدينا بياناتنا بالصيغة القياسية، يمكننا معالجتها لتصل إلى حالةٍ نمكّننا فيها من تحليلها لعدّ الخطوات (input2).
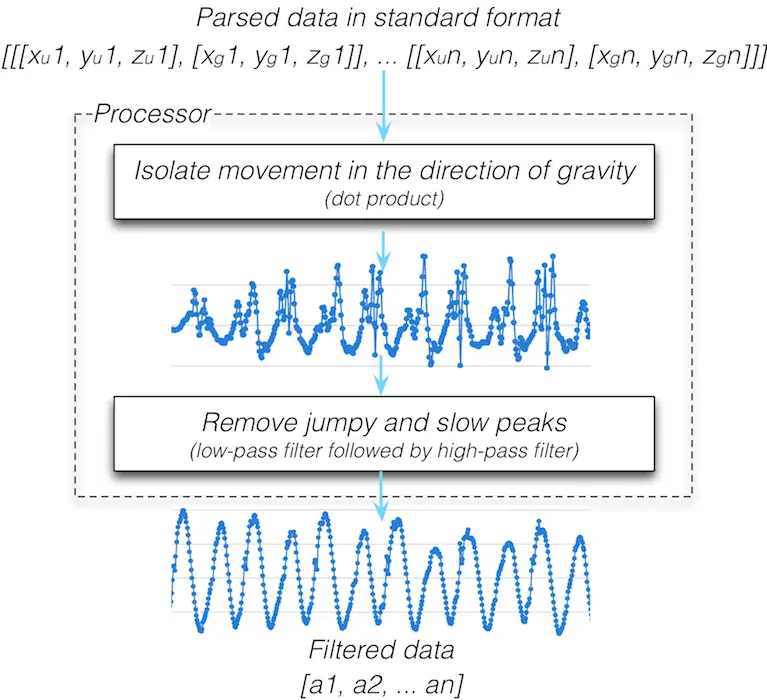
الغرض من المعالجة هو أخذ بياناتنا بالصيغة القياسية وتنظيفها تدريجيًا للوصول بها إلى أقرب حالة ممكنة إلى موجتنا الجيبية المثالية. وعملايتا المعالجة اللتان نُنفّذهما — أخذ حاصل الضرب النقطي والترشيح — متمايزتان تمامًا، لكن كليهما مُعدّ لمعالجة بياناتنا، لذا سننشئ صنفًا واحدًا اسمه Processor.
class Processor

  attr_reader :dot_product_data, :filtered_data

  def self.run(data)
    processor = Processor.new(data)
    processor.dot_product
    processor.filter
    processor
  end

  def initialize(data)
    @data = data
  end

  def dot_product
    @dot_product_data = @data.map do |x|
      x[0][0] * x[1][0] + x[0][1] * x[1][1] + x[0][2] * x[1][2]
    end
  end

  def filter
    @filtered_data = Filter.low_5_hz(@dot_product_data)
    @filtered_data = Filter.high_1_hz(@filtered_data)
  end

end
ومرّة أخرى، نرى نمط run وinitialize. إذ تستدعي run طريقتي المعالِج dot_product وfilter مباشرة. وتحقّق كل طريقة إحدى عمليتَي المعالجة لدينا. فالطريقة dot_product تعزل الحركة في اتجاه الجاذبية، وfilter تطبّق مرشّحي التمرير المنخفض والمرتفع بالتتابع لإزالة القمم المتقطّعة والبطيئة.
وظائف عدّاد الخطوات
ما دام تتوفّر معلومات عن الشخص الذي يستخدم عدّاد الخطوات، يمكننا قياس أكثر من مجرّد الخطوات. فعدّاد خطواتنا سيقيس المسافة المقطوعة والزمن المنقضي، إضافةً إلى الخطوات المقطوعة.
المسافة المقطوعة
يُستخدم عدّاد الخطوات المحمول عادةً من شخص واحد. وتُحسب المسافة المقطوعة أثناء المشية بضرب عدد الخطوات المقطوعة في طول خطوة الشخص. وإذا كان طول الخطوة غير معروف، يمكننا استخدام معلومات اختيارية عن المستخدم مثل الجنس والطول لتقريبه. لننشئ صنف User لاحتواء هذه المعلومات المترابطة.
class User

  GENDER      = ['male', 'female']
  MULTIPLIERS = {'female' => 0.413, 'male' => 0.415}
  AVERAGES    = {'female' => 70.0,  'male' => 78.0}

  attr_reader :gender, :height, :stride

  def initialize(gender = nil, height = nil, stride = nil)
    @gender = gender.to_s.downcase unless gender.to_s.empty?
    @height = Float(height) unless height.to_s.empty?
    @stride = Float(stride) unless stride.to_s.empty?

    raise 'Invalid gender' if @gender && !GENDER.include?(@gender)
    raise 'Invalid height' if @height && (@height <= 0)
    raise 'Invalid stride' if @stride && (@stride <= 0)

    @stride ||= calculate_stride
  end

private

  def calculate_stride
    if gender && height
      MULTIPLIERS[@gender] * height
    elsif height
      height * (MULTIPLIERS.values.reduce(:+) / MULTIPLIERS.size)
    elsif gender
      AVERAGES[gender]
    else
      AVERAGES.values.reduce(:+) / AVERAGES.size
    end
  end

end
في أعلى صنفنا، نُعرِّف ثوابت تفادينا لكتابة الأعداد والسلاسل السحرية في كل أنحاء الشيفرة. ولأغراض هذا النقاش، لنفترض أنّ القيم في MULTIPLIERS وAVERAGES قد حُدِّدت من عيّنة كبيرة من أشخاص متنوّعين.
يقبل مُهيّئنا gender وheight وstride كوسائط اختيارية. فإذا مُرِّرت الوسائط الاختيارية، فإنّ مُهيّئنا يضبط متغيّرات نسخة بالأسماء نفسها بعد إجراء بعض تنسيق البيانات. ونُطلق استثناءً عند القيم غير الصالحة.
حتى حين تُقدَّم كل الوسائط الاختيارية، يبقى طول الخطوة المُدخَل هو المقدَّم. وإذا لم يُقدَّم، فإنّ الطريقة calculate_stride تحدّد أدقّ طول خطوة ممكن للمستخدم. ويجري ذلك باستخدام جملة if:
- أدقّ طريقة لحساب طول الخطوة هي استخدام طول الشخص مع معامل يعتمد على الجنس، شريطة أن يتوفّر لدينا جنس وطول صالحان.
- طول الشخص مؤشّر أفضل لطول الخطوة من جنسه. فإذا كان لدينا الطول لكن ليس الجنس، يمكننا ضرب الطول في متوسّط القيمتين في
MULTIPLIERS. - إذا كان كل ما لدينا هو الجنس، يمكننا استخدام متوسّط طول الخطوة من
AVERAGES. - وأخيرًا، إذا لم يكن لدينا أيّ شيء، يمكننا أخذ متوسّط القيمتين في
AVERAGESواستخدامه كطول خطوة.
لاحظ أنّ كلّما ابتعدنا أكثر في جملة if، أصبح طول خطوتنا أقلّ دقّة. وفي كلّ الأحوال، يحدّد صنف User لدينا طول الخطوة بأفضل ما يستطيع.
الزمن المنقضي
يُقاس الوقت الذي قُضِي في التنقّل بقسمة عدد عينات البيانات في @parsed_data الخاص بـProcessor على معدل أخذ عينات الجهاز، إن كان لدينا معدل. ولأنّ المعدل يتعلّق بالمشكلة التجريبية نفسها أكثر من علاقته للمستخدم، ولأنّ صنف User لا يلزمه فعليًا أن يعرف معدل أخذ العينات، فإنّ هذا هو الوقت المناسب لإنشاء صنف Trial صغير الحجم حقًا.
class Trial

  attr_reader :name, :rate, :steps

  def initialize(name, rate = nil, steps = nil)
    @name  = name.to_s.delete(' ')
    @rate  = Integer(rate.to_s) unless rate.to_s.empty?
    @steps = Integer(steps.to_s) unless steps.to_s.empty?

    raise 'Invalid name'  if @name.empty?
    raise 'Invalid rate'  if @rate && (@rate <= 0)
    raise 'Invalid steps' if @steps && (@steps < 0)
  end

end
كل قارئات السمات في Trial تُضبط في المُهيّئ استنادًا إلى الوسائط المُمرَّرة:
nameهو اسم للتجربة المحدَّدة، للمساعدة في التمييز بين التجارب المختلفة.rateهو معدل أخذ عينات مقياس التسارع أثناء التجربة.stepsيُستخدم لضبط الخطوات الفعلية المقطوعة، حتى نتمكّن من تسجيل الفرق بين الخطوات التي قطعها المستخدم فعليًا وتلك التي عدّها برنامجنا.
وكما في صنف User إلى حدٍّ كبير، فإنّ بعض المعلومات اختيارية. وتُتاح لنا فرصة إدخال تفاصيل التجربة إن كانت لدينا. وإذا لم تكن لدينا تلك التفاصيل، يتجاوز برنامجنا حساب النتائج الإضافية، مثل الوقت الذي قُضِي في التنقّل. وأوجه الشبه الأخرى مع صنف User هي منع القيم غير الصالحة.
الخطوات المقطوعة
حان وقت تنفيذ استراتيجيتنا في عدّ الخطوات في الشيفرة. حتى الآن لدينا صنف Processor الذي يحتوي @filtered_data، وهي سلسلتنا الزمنية النظيفة التي تمثّل تسارع المستخدم في اتجاه الجاذبية. ولدينا أيضًا أصناف تمنحنا المعلومات الضرورية عن المستخدم والتجربة. والمفقود لدينا هو طريقة لتحليل @filtered_data بالمعلومات من User وTrial، ولعدّ الخطوات وقياس المسافة وقياس الزمن.
يختلف الجزء التحليلي في برنامجنا عن التلاعب بالبيانات في Processor، وعن جمع المعلومات وتجميعها في صنفَي User وTrial. لننشئ صنفًا جديدًا اسمه Analyzer لإجراء هذا التحليل.
class Analyzer

  THRESHOLD = 0.09

  attr_reader :steps, :delta, :distance, :time

  def self.run(data, user, trial)
    analyzer = Analyzer.new(data, user, trial)
    analyzer.measure_steps
    analyzer.measure_delta
    analyzer.measure_distance
    analyzer.measure_time
    analyzer
  end

  def initialize(data, user, trial)
    @data  = data
    @user  = user
    @trial = trial
  end

  def measure_steps
    @steps = 0
    count_steps = true

    @data.each_with_index do |data, i|
      if (data >= THRESHOLD) && (@data[i-1] < THRESHOLD)
        next unless count_steps

        @steps += 1
        count_steps = false
      end

      count_steps = true if (data < 0) && (@data[i-1] >= 0)
    end
  end

  def measure_delta
    @delta = @steps - @trial.steps if @trial.steps
  end

  def measure_distance
    @distance = @user.stride * @steps
  end

  def measure_time
    @time = @data.count/@trial.rate if @trial.rate
  end

end
أوّل ما نفعله في Analyzer هو تعريف ثابت THRESHOLD، الذي سنستخدمه لتجنّب عدّ القمم القصيرة خطوات. ولأغراض هذا النقاش، لنفترض أنّنا حلّلنا مجموعات بيانات متنوّعة عديدة وحدّدنا قيمة عتبة تناسب أكبر عدد من تلك المجموعات. ويمكن أن تصبح العتبة لاحقًا ديناميكية وتختلف بين مستخدمين مختلفين، استنادًا إلى الخطوات المحسوبة والخطوات الفعلية التي قطعوها؛ أي خوارزمية تعلّم إن شئت.
يأخذ مُهيّئ Analyzer لدينا وسيط data ونسختي User وTrial، ويضبط متغيّرات النسخة @data و@user و@trial على الوسائط المُمرَّرة. وتستدعي الطريقة run الطرق measure_steps وmeasure_delta وmeasure_distance وmeasure_time. لننظر إلى كل طريقة.
measure_steps
أخيرًا! جزء عدّ الخطوات من تطبيق عدّ الخطوات لدينا. وأوّل ما نفعله في measure_steps هو تهيئة متغيّرين:
- يُستخدَم
@stepsلعدّ عدد الخطوات. - يُستخدَم
count_stepsلأغراض التخلّف، لتحديد ما إذا كان من المسموح لنا أن نعدّ خطوات عند نقطة زمنية بعينها.
ثمّ نكرّر عبر @processor.filtered_data. فإذا كانت القيمة الحالية أكبر من THRESHOLD أو مساوية له، والقيمة السابقة أصغر من THRESHOLD، فقد عبرنا العتبة في الاتجاه الموجب، وهو ما قد يشير إلى خطوة. وتتخطّى جملة unless إلى نقطة البيانات التالية إذا كان count_steps يساوي false، ما يشير إلى أنّنا عددنا بالفعل خطوة لتلك القمة. وإذا لم يكن كذلك، فإنّنا نزيد @steps بمقدار 1، ونضبط count_steps على false لمنع عدّ أيّ خطوات إضافية لتلك القمة. أمّا جملة if التالية فتضبط count_steps على true بمجرّد أن تعبر سلسلتنا الزمنية محور في الاتجاه السالب، فننتقل عندها إلى القمة التالية.
ها قد حصلت على جزء عدّ الخطوات في برنامجنا! فصنف Processor قام بالكثير من العمل لتنظيف السلسلة الزمنية وإزالة الترددات التي كانت ستؤدّي إلى عدّ خطوات زائفة، لذا فإنّ تنفيذ عدّ الخطوات الفعلي لدينا ليس معقّدًا.
تجدر الإشارة إلى أنّنا نخزّن السلسلة الزمنية كاملةً للمشية في الذاكرة. تجاربنا كلّها مشي قصير، لذا لا تُعدّ هذه مشكلة في الوقت الحالي، لكننا نودّ في المستقبل تحليل مشي طويل مع كميات كبيرة من البيانات. ومن المثاليّ أن نرغب في بثّ البيانات وإدخالها تدريجيًا، مع الاحتفاظ بأجزاء صغيرة جدًّا من السلسلة الزمنية في الذاكرة فقط. ومراعاةً لذلك، بذلنا المجهود اللازم لضمان أنّنا لا نحتاج إلّا إلى نقطة البيانات الحالية ونقطة البيانات التي تسبقها. إضافةً إلى ذلك، نفّذنا التخلّف باستخدام قيمة منطقية، لذا لا نحتاج إلى النظر إلى الوراء في السلسلة الزمنية للتأكّد من أنّنا عبرنا محور عند 0.
هناك توازن دقيق بين مراعاة التكرارات المحتملة للمنتج مستقبلًا، وبين الإفراط في هندسة الحلول لكلّ اتجاه محتمل يمكن تصوّره للمنتج. وفي هذه الحالة، من المعقول أن نفترض أننا سنضطر إلى التعامل مع مشي أطول في المستقبل القريب، وتكاليف مراعاة ذلك في عدّ الخطوات منخفضة إلى حدٍّ معقول.
measure_delta
إذا قدّمت التجربة الخطوات الفعلية المقطوعة أثناء المشية، فإنّ measure_delta سيعيد الفرق بين الخطوات المحسوبة والخطوات الفعلية.
measure_distance
تُقاس المسافة بضرب طول خطوة المستخدم في عدد الخطوات. ولأنّ المسافة تعتمد على عدد الخطوات، فلا بدّ من استدعاء measure_steps قبل measure_distance.
measure_time
ما دام لدينا معدل أخذ عينات، فيُحسب الزمن بقسمة إجمالي عدد العيّنات في filtered_data على معدل أخذ العينات. ويترتّب على ذلك أنّ الزمن يُحسب بالثواني.
تجميع كلّ شيء معًا بخط أنابيب المعالجة
أصناف Parser وProcessor وAnalyzer مفيدة كلٌّ منها بمفرده، لكنها أفضل بالتأكيد مجتمعةً. وسيستخدم برنامجنا هذه الأصناف كثيرًا ليمرّ عبر خط أنابيب المعالجة الذي قدّمناه سابقًا. وبما أنّ خط الأنابيب سيحتاج إلى التشغيل كثيرًا، سننشئ صنف Pipeline ليشغّله نيابةً عنا.
class Pipeline

  attr_reader :data, :user, :trial, :parser, :processor, :analyzer

  def self.run(data, user, trial)
    pipeline = Pipeline.new(data, user, trial)
    pipeline.feed
    pipeline
  end

  def initialize(data, user, trial)
    @data  = data
    @user  = user
    @trial = trial
  end

  def feed
    @parser    = Parser.run(@data)
    @processor = Processor.run(@parser.parsed_data)
    @analyzer  = Analyzer.run(@processor.filtered_data, @user, @trial)
  end

end
نستخدم نمط run المألوف لدينا ونزوّد Pipeline ببيانات مقياس التسارع، وبنسختي User وTrial. أمّا الطريقة feed فتنفّذ خط أنابيب المعالجة، ممّا يستلزم تشغيل Parser ببيانات مقياس التسارع، ثمّ استخدام البيانات التي حلّلها المحلّل لتشغيل Processor، وأخيرًا استخدام البيانات التي رُشّحتها المعالِج لتشغيل Analyzer. ويحتفظ Pipeline بمتغيّرات النسخة @parser و@processor و@analyzer، بحيث يتوفّر للبرنامج الوصول إلى معلومات تلك الكائنات لأغراض العرض عبر التطبيق.
إضافة واجهة ودّية
اجتزنا الجزء الأكثر إجهادًا في برنامجنا. بعد ذلك، سنبني تطبيق ويب يعرض البيانات بصيغة تُسعد المستخدم. ف تطبيقات الويب تفصل بطبيعتها معالجة البيانات عن عرضها. فلننظر إلى تطبيقنا من منظور المستخدم قبل الشيفرة.
سيناريو مستخدم
حين يدخل المستخدم التطبيق أوّل مرّة عبر الانتقال إلى /uploads، يرى جدولًا بالبيانات الموجودة ونموذجًا لإرسال بيانات جديدة برفع ملف مُخرَج مقياس التسارع ومعلومات التجربة والمستخدم (app1).
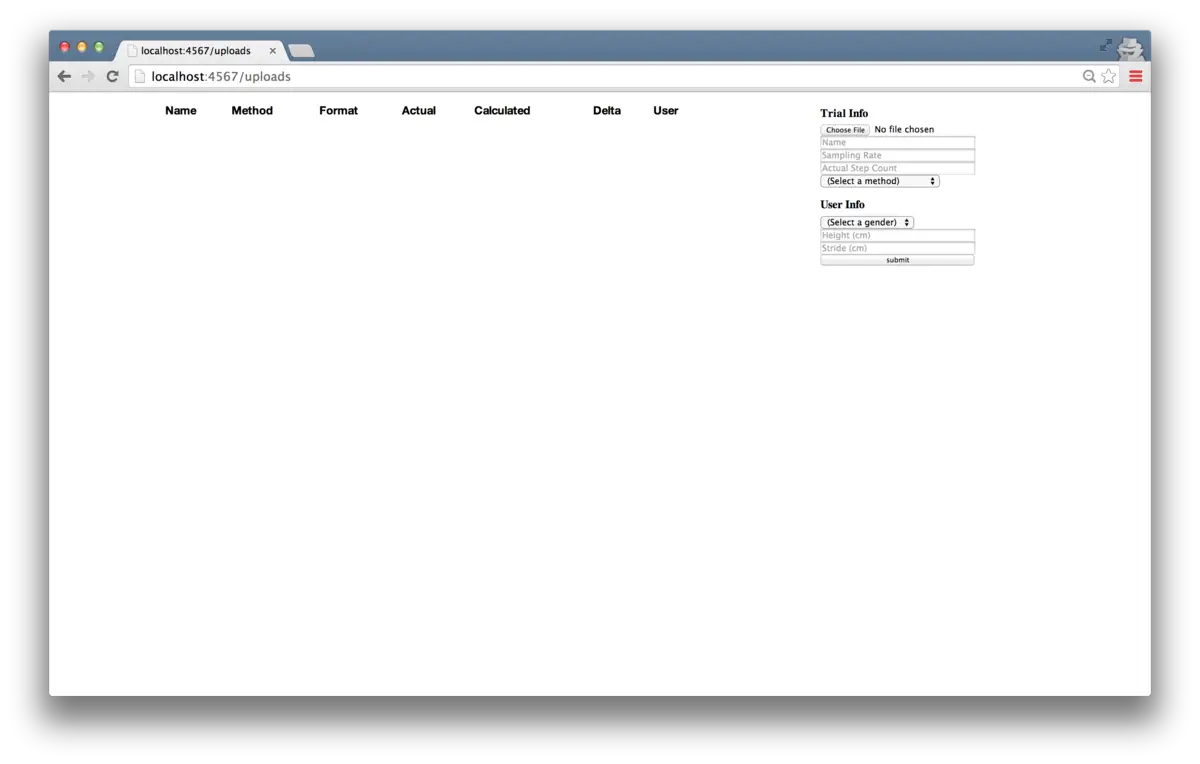
يُخزِّن إرسال النموذج البيانات في نظام الملفات، ويحلّلها ويعالجها ويحللها، ثمّ يعيد التوجيه إلى /uploads حيث يظهر الإدخال الجديد في الجدول.
والنقر على الرابط Detail الخاص بإدخال ما يعرض للمستخدم العرض التالي في app3.
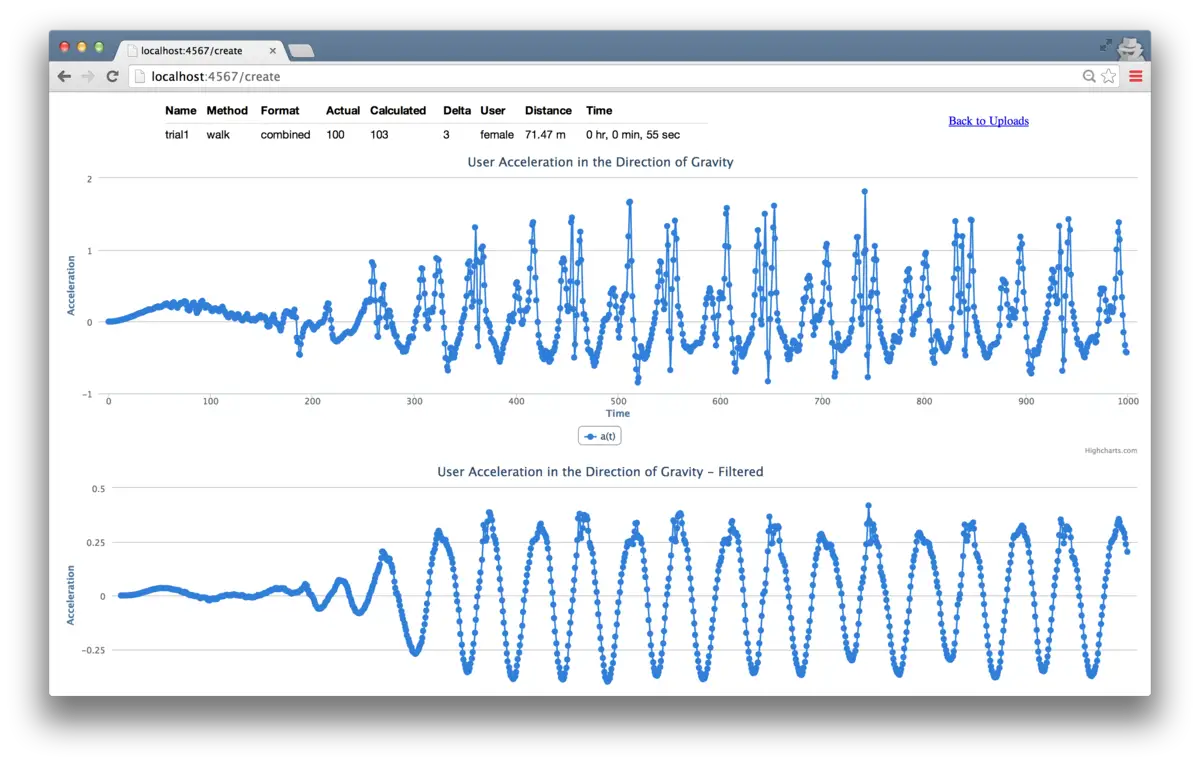
تتضمّن المعلومات المعروضة القيم التي أدخلها المستخدم عبر نموذج الرفع، والقيم التي حسبها برنامجنا، ورسومًا بيانية للسلسلة الزمنية بعد عملية حاصل الضرب النقطي، ثمّ بعد الترشيح مرّة أخرى. ويمكن للمستخدم العودة إلى /uploads عبر الرابط Back to Uploads.
فلننظر إلى ما تفرضه الوظيفة الموصوفة أعلاه علينا من الناحية التقنية. سنحتاج إلى مكوّنين رئيسيين لا نملكهما بعد:
- طريقة لتخزين بيانات إدخال المستخدم واسترجاعها.
- تطبيق ويب بواجهة أساسية.
لنفحص كلًّا من هذين المتطلبين.
1. تخزين البيانات واسترجاعها
يحتاج تطبيقنا إلى تخزين بيانات الإدخال في نظام الملفات، واسترجاع البيانات منه. سننشئ صنف Upload للقيام بذلك. وبما أنّ هذا الصنف يتعامل مع نظام الملفات فحسب ولا صلة له مباشرة بتنفيذ عدّاد الخطوات، فقد تركناه خارج هذا الفصل اختصارًا، لكنّ من المفيد مناقشة وظائفه الأساسية. ويمتلك صنف Upload ثلاث طرائق على مستوى الصنف للوصول إلى نظام الملفات واسترجاع البيانات منه، toutes تُعيد نسخة واحدة أو أكثر من Upload:
- تأخذ
createملفًا مع معلومات المستخدم والتجربة. فهي تخزّن الملف في نظام الملفات، تحت اسم ملف تولّده ليحتوي على معلومات المستخدم والتجربة. وتتيح متغيّرات النسخة@file_pathو@userو@trialالوصول إلى مسار الملف وإلى كائن المستخدم وكائن التجربة على التوالي. - تأخذ
findمسار ملف وتُعيد نسخة منUpload. - تُعيد
allمصفوفة من نسخUpload، واحدة لكل ملف بيانات مقياس تسارع في نظام الملفات.
فصل المسؤوليات في Upload
ومرّة أخرى، كان من الحكمة أن نفصل المسؤوليات في برنامجنا. فكل الشيفرة المتعلقة بالتخزين والاسترجاع محصورة في صنف Upload. ومع نموّ تطبيقنا، من المرجّح أن نرغب في استخدام قاعدة بيانات بدلًا من حفظ كلّ شيء في نظام الملفات. وحين يحين ذلك الوقت، كلّ ما علينا فعله هو تغيير صنف Upload. ويجعل هذا إعادة الهيكلة لدينا بسيطة ونظيفة.
وفي المستقبل يمكننا حفظ كائنات User وTrial في قاعدة البيانات. وستصبح طرائق create وfind وall في Upload ذات صلة أيضًا بكائنَي User وTrial. وهذا يعني أنّه من المرجّح أن نُعيد هندسة هذين الكائنين إلى صنف خاص بهما للتعامل مع تخزين البيانات واسترجاعها على نحو عام، وستورث كلٌّ من أصناف User وTrial وUpload من ذلك الصنف. وقد نضيف لاحقًا طرقًا مساعدة للاستعلامات إلى ذلك الصنف، ونواصل بناءه من هناك.
2. بناء تطبيق ويب
بُنيت تطبيقات الويب مرّات كثيرة، لذا سنستثمر العمل المهمّ لمجتمع المصادر المفتوحة ونستخدم إطارًا قائمًا ليتولّى عنا أعمال التوصيل المملّة. وإطار Sinatra يفعل ذلك تمامًا. وبعبارات الأداة نفسها، فإنّ Sinatra هي «لغة خاصة بنطاق لإنشاء تطبيقات الويب بسرعة في Ruby». ممتاز.
سيحتاج تطبيق الويب لدينا إلى الاستجابة لطلبات HTTP، لذا سنحتاج إلى ملف يعرّف مسارًا (route) وكتلة شيفرة مرتبطة به لكل تركيبة من طريقة HTTP وعنوان URL. ولنسمّه pedometer.rb.
get '/uploads' do
  @error = "A #{params[:error]} error has occurred." if params[:error]
  @pipelines = Upload.all.inject([]) do |a, upload|
    a << Pipeline.run(File.read(upload.file_path), upload.user, upload.trial)
    a
  end

  erb :uploads
end

get '/upload/*' do |file_path|
  upload = Upload.find(file_path)
  @pipeline = Pipeline.run(File.read(file_path), upload.user, upload.trial)

  erb :upload
end

post '/create' do
  begin
    Upload.create(params[:data][:tempfile], params[:user], params[:trial])

    redirect '/uploads'
  rescue Exception => e
    redirect '/uploads?error=creation'
  end
end
يتيح pedometer.rb لتطبيقنا الاستجابة لطلبات HTTP لكل مساراتنا. وكتلة الشيفرة لكل مسار تسترجع بيانات من نظام الملفات أو تخزّن بيانات فيه عبر Upload، ثمّ تعرض طريقة عرض أو تُعيد التوجيه. أمّا متغيّرات النسخة المُنشأة فستُستخدم مباشرةً في طرق العرض لدينا. إذ تعرض طرق العرض البيانات فحسب وليست محور تركيز تطبيقنا، فسنُسقط شيفرتها من هذا الفصل.
فلننظر إلى كل مسار في pedometer.rb على حدة.
GET /uploads
الانتقال إلى http://localhost:4567/uploads يُرسل طلب HTTP GET إلى تطبيقنا، فتُنفَّذ شيفرتنا get '/uploads'. وهذه الشيفرة تشغّل خط أنابيب المعالجة لكل عمليات الرفع الموجودة في نظام الملفات وتعرض طريقة العرض uploads، التي تعرض قائمة بعمليات الرفع ونموذجًا لإرسال عمليات رفع جديدة. وإذا تضمّن المُخرَج معامل خطأ، فإنّ سلسلة نصية عن الخطأ تُنشأ، وستعرض طريقة العرض uploads ذلك الخطأ.
GET /upload/*
والنقر على الرابط Detail لكل عملية رفع يُرسل طلب HTTP GET إلى /upload مع مسار الملف الخاص بتلك العملية. فيُشغَّل خط أنابيب المعالجة وتُعرَض طريقة العرض upload. وتعرض هذه الطريقة تفاصيل عملية الرفع، بما فيها الرسوم البيانية، وهي مُنشأة باستخدام مكتبة جافاسكريبت اسمها HighCharts.
POST /create
.pathour الأخير، وهو طلب HTTP POST إلى create، يُستدعى حين يرسل المستخدم النموذج في طريقة العرض uploads. تُنشئ كتلة الشيفرة عنصر Upload جديدًا، وتستخدم تجزئة params لالتقاط القيم التي أدخلها المستخدم عبر النموذج، ثمّ تعيد التوجيه إلى /uploads. وإذا حدث خطأ أثناء عملية الإنشاء، فإنّ إعادة التوجيه إلى /uploads تتضمّن معامل خطأ لإعلام المستخدم بأنّ شيئًا ما سقط.
تطبيق يعمل بكامل وظيفته
ها قد فعلتها! لقد بنينا تطبيقًا يعمل بالكامل، قابلًا للتطبيق فعليًا.
يقدّم لنا العالم الحقيقي تحدّيات معقّدة ومتشابكة. والبرمجيات قادرة بصفتها الفريدة على معالجة هذه التحدّيات على نطاق واسع بأقلّ الموارد الممكنة. وكمهندسي برمجيات، لدينا القدرة على إحداث تغيير إيجابي في بيوتنا ومجتمعاتنا وعالمنا. وأ/training.training، من المرجّح أنّ تدريبنا الأكاديمي أو غير الأكاديمي زوّدنا بمهارات حلّ المشكلات التي مكنّتنا من كتابة شيفرة تحلّ مشكلات معزولة محدَّدة المعالم. ومع نموّنا وإتقاننا لحرفتنا، فLorraine الأمر متوقّف علينا في أن نمدّ ذلك التدريب ليشمل مشكلات عملية، متشابكة مع كلّ وقائع عالمنا الفوضوية. أرجو أن يكون هذا قد أعطاك لمحة عن تقسيم مشكلة حقيقية إلى أجزاء صغيرة قابلة للمعالجة، وكتابة شيفرة جميلة نظيفة قابلة للتوسّع لبناء حلّ.
ونحن نُشرب على حلّ مشكلات مثيرة للاهتمام في عالم لا يتوقّف عن الإثارة.