التعرّف الضوئي على الحروف (OCR)
مقدّمة
ماذا لو كان حاسوبك قادرًا على غسل صحونك، وغسل ملابسك، وطهي العشاء لك، وتنظيف منزلك؟ وأعتقد أن معظم الناس سيكونون سعداء بالحصول على يدٍ تساعدهم! لكن ما الذي يلزم كي يصبح الحاسوب قادرًا على أداء هذه المهام بالطريقة نفسها التي يؤديها بها البشر؟
اقترح عالم الحاسوب الشهير آلان تورينغ اختبار تورينغ بوصفه وسيلة لتحديد ما إذا كانت الآلة يمكن أن تملك ذكاءً لا يمكن تمييزه عن ذكاء الإنسان. ويعني الاختبار أن يطرح إنسان أسئلة على كائنين مخفيين، أحدهما إنسان والآخر آلة، فيحاول تحديد أيّهما هو الآخر. فإذا عجز المحاوِر عن تحديد الآلة، فإن الآلة تُعدّ متمتعّة الذكاء البشري.
ولرغم أن هنالك جدلًا كثيرًا حول ما إذا كان اختبار تورينغ تقييمًا صالحًا للذكاء، وحول ما إذا كان بإمكاننا بناء آلات ذكية كهذه، فلا شكّ في وجود آلات تمتلك قدرًا من الذكاء أصلًا. وهناك حاليًا برمجيات تساعد الروبوتات على التنقّل في مكتب وأداء مهام صغيرة، أو تساعد من يعانون من الزهايمر. ومن الأمثلة الأكثر شيوعًا على الذكاء الاصطناعي (A.I.) طريقة Google في تقدير ما تبحث عنه حين تبحث عن كلمات مفتاحية، أو طريقة Facebook في تحديد ما تضعه في موجز الأخبار لديك.
من التطبيقات المعروفة جيدًا للذكاء الاصطناعي هو التعرّف الضوئي على الحروف (optical character recognition، OCR). ونظام التعرّف الضوئي على الحروف هو قطعة برمجية تستطيع تلقّي صور للحروف المكتوبة بخط اليد كمدخلات وتفسّرها إلى نص قابل للقراءة آليًا. ورغم أنك قد لا تفكر مرتين حين تُودِع شيكًا مكتوبًا بخط اليد في آلة صرّاف مصرفية، فهناك عمل مثير للاهتمام يجري في الخلفية. وسيفحص هذا الفصل مثالًا عمليًا لنظام تعرّف ضوئي بسيط يتعرّف على الأرقام العشرية باستخدام شبكة عصبية اصطناعية (Artificial Neural Network، ANN). لكن لنضبط أولًا سياقًا أكبر.
ما هو الذكاء الاصطناعي؟
بينما يبدو تعريف تورينغ للذكاء معقولًا، فإن ما يُعدّ ذكاءً هو في الأساس جدلٌ فلسفي. غير أن علماء الحاسوب صنّفوا بعض أنواع الأنظمة والخوارزميات في فروع من الذكاء الاصطناعي. ويُستخدم كل فرع لحلّ مجموعة معيّنة من المسائل. وهذه الفروع تشمل الأمثلة التالية، فضلًا عن الكثير منها:
- الاستدلال المنطقي والاستدلال الاحتمالي بالاستناد إلى معرفة مسبقة المعرَّفة عن عالم ما. فمثلًا، يمكن لـالاستدلال الغامض أن يساعد جهازَ تحكّم في الحرارة على معرفة متى يشغّل المكيّف حين يكتشف أن الحرارة مرتفعة والجو رطبًا
- البحث الاستدلالي. فمثلًا يمكن استخدام البحث للعثور على أفضل حركة تالية ممكنة في لعبة شطرنج، عبر البحث في جميع الحركات الممكنة واختيار الحركة التي تحسّن مركزك إلى أقصى حدّ
- تعلّم الآلة (machine learning، ML) مع نماذج تغذية راجعة. فمثلًا: مسائل التعرّف على الأنماط مثل التعرّف الضوئي على الحروف.
بوجه عام، ينطوي تعلّم الآلة على استخدام مجموعات بيانات كبيرة لتدريب نظام على التعرّف على الأنماط. وقد تكون مجموعات بيانات التدريب موسومة، أي أن مُخرجات النظام المتوقعة محدّدة لمُدخلات معيّنة، أو غير موسومة أي أن المُخرجات المتوقعة غير محدّدة. وتُسمّى الخوارزميات التي تدرّب الأنظمة ببيانات غير موسومة خوارزميات بلا إشراف، وتُسمّى التي تدرّب ببيانات موسومة خوارزميات بإشراف. وهناك خوارزميات وتقنيات تعلّم آلة كثيرة لإنشاء أنظمة تعرّف ضوئي على الحروف، ومنها الشبكات العصبية الاصطناعية إحدى المقاربات.
الشبكات العصبية الاصطناعية
ما هي الشبكات العصبية الاصطناعية؟
الشبكة العصبية الاصطناعية هي بنية تتألّف من عقد مترابطة تتواصل مع بعضها. وهي مستوحاة بنيتها ووظائفها من الشبكات العصبية الموجودة في دماغ حيوي. ونظرية هب تشرح كيف يمكن لهذه الشبكات أن تتعلّم التعرّف على الأنماط عبر تغيير بنيتها وقوة روابطها ماديًا. وعلى نحو مماثل، فإن الشبكة العصبية الاصطناعية النموذجية (المبيَّنة في ann) تحتوي روابط بين العقد لها أوزان تُحدَّث مع تعلّم الشبكة. أما العقد الموسومة بـ«+1» فتُسمّى انحيازات. أما العمود الأزرق الأيسر من العقد فهو عقد دخل، والعمود الأوسط يحتوي عقدًا مخفية، والعمود الأيمن يحتوي عقد خرج. وقد يكون هناك أعمدة كثيرة من العقد المخفية، تُعرَف بـ_الطبقات المخفية_.
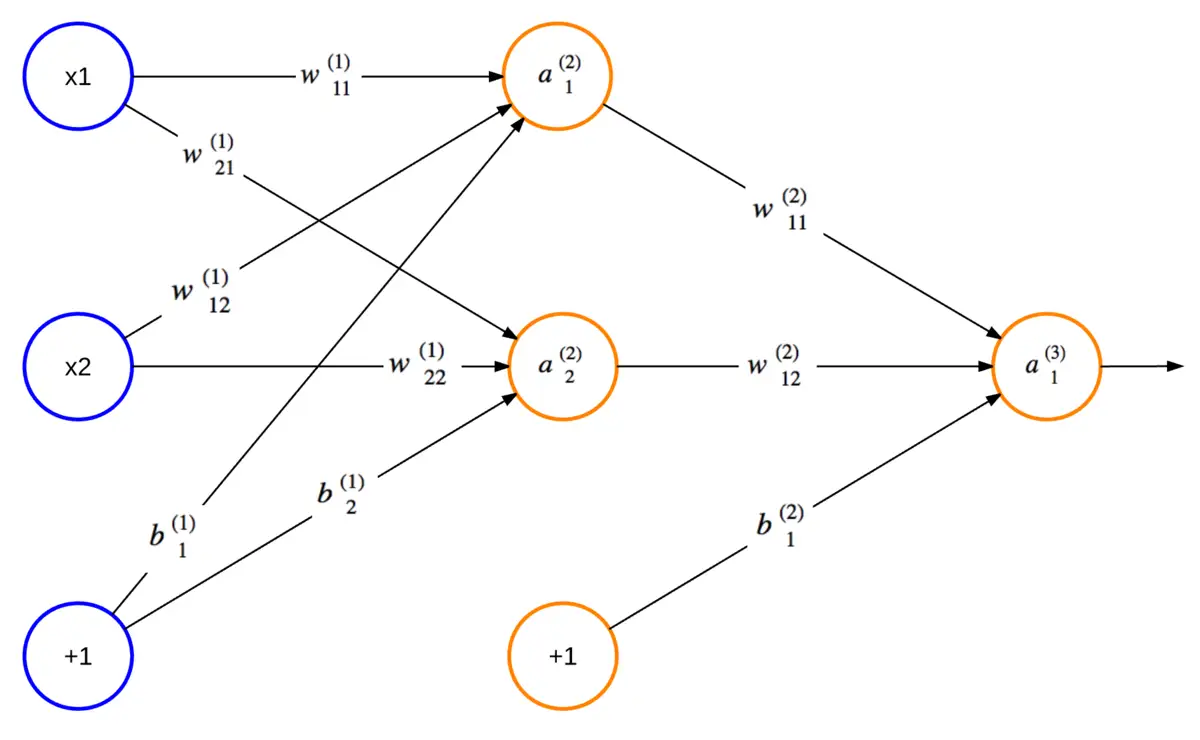
تمثّل القيم داخل جميع العقد الدائرية في ann مُخرجات العقد. فإذا سمّينا مُخرج العقد رقم من أعلى الطبقة بـ، وسمّينا الربط بين العقد رقم في الطبقة والعقدة رقم في الطبقة بـ، فإن مُخرج العقدة هو:
حيث تُعرَف بأنها دالة التفعيل (activation function) و هي الانحياز. ودالة التفعيل هي صانعة القرار بشأن نوع المُخرج الذي تملكه العقدة. والانحياز عقدة إضافية ذات مُخرج ثابت يساوي 1 يمكن إضافتها إلى شبكة عصبية اصطناعية لتحسين دقّتها. وسنرى مزيدًا من التفاصيل حول كليهما في \aosasecref{sec.ocr.feedforward}.
يُسمّى هذا النوع من بنية الشبكة شبكة عصبية أمامية التقدّم (feedforward) لأن لا توجد دورات في الشبكة. أما الشبكات العصبية الاصطناعية التي تتغذّى مخارج عقدها على مداخلها فتُسمّى الشبكات العصبية الدورية. وهناك خوارزميات كثيرة يمكن تطبيقها لتدريب الشبكات العصبية الاصطناعية الأمامية؛ وإحدى الخوارزميات الشائعة تُسمّى الانتشار العكسي (backpropagation). وسيستخدم نظام التعرّف الضوئي على الحروف الذي سننفّذه في هذا الفصل الانتشار العكسي.
كيف نستخدم الشبكات العصبية الاصطناعية؟
كما في معظم مقاربات تعلّم الآلة الأخرى، تتمثل الخطوة الأولى لاستخدام الانتشار العكسي في تحديد كيفية تحويل مشكلتنا أو تقليصها إلى مشكلة يمكن أن تحلّها شبكة عصبية اصطناعية. وبعبارة أخرى، كيف يمكننا التلاعب ببيانات مُدخلاتنا حتى نتمكّن من إدخالها في الشبكة العصبية الاصطناعية؟ وفي حالة نظام التعرّف الضوئي على الحروف، يمكننا استخدام مواضع البكسلات الخاصة برقم معيّن كمدخلات. ومن المفيد الإشارة إلى أن اختيار صيغة المُدخلات غالبًا ما ليس بهذه البساطة. فلو كنّا نحلل صورًا كبيرة للتعرّف على الأشكال فيها، مثلًا، لربما احتجنا إلى معالجة الصورة مسبقًا للتعرّف على محيطاتها. وتكون تلك المحيطات هي المُدخلات.
ومتى اتّخذنا قرار بشأن صيغة مُدخلاتنا، فما التالي؟ وبما أن الانتشار العكسي خوارزمية بإشراف، فستحتاج إلى التدريب ببيانات موسومة، كما ذُكر في \aosasecref{sec.ocr.ai}. وعليه، حين نمرّر مواضع البكسلات كمُدخلات تدريب، فيجب أن نمرّر الرقم المرتبط بها أيضًا. وهذا يعني أننا علينا أن نبحث عن مجموعة بيانات كبيرة من الأرقام المرسومة وقيمها المرتبطة.
الخطوة التالية هي تقسيم مجموعة البيانات إلى مجموعة تدريب ومجموعة تحقّق. تُستخدم بيانات التدريب لتشغيل خوارزمية الانتشار العكسي وضبط أوزان الشبكة العصبية الاصطناعية. وتُستخدم بيانات التحقّق لإجراء التنبؤات باستخدام الشبكة المدرَّبة وحساب دقّتها. ولو كنا نقارن أداء الانتشار العكسي بخوارزمية أخرى على بياناتنا، لسنا نقسم البيانات إلى 50% للتدريب و25% لمقارنة أداء الخوارزميتين (مجموعة التحقّق) و25% الأخيرة لاختبار دقّة الخوارزمية المختارة (مجموعة الاختبار). ولأننا لا نقارن خوارزميات، يمكننا تجميع إحدى مجموعتَي الـ25% كجزء من مجموعة التدريب واستخدام 75% من البيانات لتدريب الشبكة و25% للتحقّق من أنها دُرِّبت جيدًا.
الغرض من تحديد دقّة الشبكة العصبية الاصطناعية twofold. أولًا، هو تجنّب مشكلة فرط التخصيص (overfitting). ويحدث فرط التخصيص عندما تكون دقّة الشبكة في التنبؤ بمجموعة التدريب أعلى بكثير من دقّتها في مجموعة التحقّق. ويخبرنا فرط التخصيص بأن بيانات التدريب المختارة لا تعمّم جيدًا بما يكفي وتحتاج إلى تحسين. ثانيًا، واختبار دقّة عدة أعداد مختلفة من الطبقات المخفية والعقد المخفية يساعد في تصميم الحجم الأمثل للشبكة العصبية الاصطناعية. وسيكون الحجم الأمثل للشبكة العصبية الاصطناعية كافيًا من العقد والطبقات المخفية لإجراء تنبؤات دقيقة، وفي الوقت نفسه أقل عدد ممكن من العقد والروابط لتقليل العبء الحسابي الذي قد يُبطئ التدريب والتنبؤ. وبعد أن يتقرّر الحجم الأمثل وتُدرَّب الشبكة، تكون جاهزة لإجراء التنبؤات!
قرارات التصميم في نظام تعرّف ضوئي بسيط
في الفقرات الماضية راجعنا بعض أساسيات الشبكات العصبية الاصطناعية الأمامية التقدّم وكيفية استخدامها. والآن حان الوقت نتحدث عن كيفية بناء نظام تعرّف ضوئي على الحروف.
أولًا، علينا أن نقرّر ما نريد أن يكون نظامنا قادرًا على فعله. ولإبقاء الأمور بسيطة، لنسمح للمستخدمين برسم رقم واحد فقط وأن يتمكّنوا من تدريب نظام التعرّف الضوئي على الحروف بهذا الرقم المرسوم أو أن يطلبوا من النظام التنبؤ بما هو عليه الرقم المرسوم. وبينما يمكن أن يعمل نظام تعرّف ضوئي محليًا على جهاز واحد، فإن إعدادًا من بنية عميل-خادم يمنح مرونة أكبر بكثير. فهو يجعل التدريب التشاركي للشبكة العصبية الاصطناعية ممكنًا ويسمح للخوادم القوية بالتعامل مع الحسابات المكثّفة.
سيتكوّن نظام التعرّف الضوئي على الحروف لدينا من خمسة مكونات رئيسية، موزّعة على خمسة ملفات. وستكون:
- عميل (
ocr.js) - خادم (
server.py) - واجهة مستخدم بسيطة (
ocr.html) - شبكة عصبية اصطناعية تُدرَّب بالانتشار العكسي (
ocr.py) - نصّ تصميم الشبكة العصبية الاصطناعية (
neural_network_design.py)
ستكون واجهة المستخدم بسيطة: لوحة رسم لرسوم الأرقام عليها، وأزرار لإمّا تدريب الشبكة العصبية الاصطناعية أو طلب تنبؤ. وسيجمع العميل الرقم المرسوم، ويحوّله إلى مصفوفة، ويمرّره إلى الخادم ليُعالَج إمّا كعينة تدريب أو كطلب تنبؤ. وسيكتفي الخادم بتوجيه طلب التدريب أو التنبؤ عبر إجراء استدعاءات واجهة برمجية إلى وحدة الشبكة العصبية الاصطناعية. وستدرّب وحدة الشبكة العصبية الاصطناعية الشبكة بمجموعة بيانات قائمة عند تهيئتها الأولى. ثم ستحفظ أوزان الشبكة العصبية الاصطناعية في ملف وتعيد تحميلها عند الإقلاع اللاحق. وهذه الوحدة هي موضع منطق التدريب والتنبؤ الأساسي. وأخيرًا، نصّ التصميم مخصّص لتجريب أعداد مختلفة من العقد المخفية واتخاذ قرار بشأن أفضل ما يعمل. وتُعطينا هذه القطع معًا نظام تعرّف ضوئي على الحروف شديد البساطة لكنه عملي.
الآن بعد أن فكّرنا في كيفية عمل النظام على المستوى العام، حان الوقت لنحوّل المفاهيم إلى شيفرة!
واجهة بسيطة (ocr.html)
كما ذُكر في وقت سابق، تتمثل الخطوة الأولى في جمع بيانات لتدريب الشبكة. يمكننا رفع سلسلة من الأرقام المكتوبة بخط اليد إلى الخادم، لكن ذلك سيكون غير مريح. وبدلًا من ذلك، يمكننا أن نطلب من المستخدمين كتابة الأرقام فعليًا على الصفحة باستخدام لوحة HTML. ثم يمكننا أن نمنحهم بضعة خيارات لإمّا تدريب الشبكة أو اختبارها، حيث ينطوي تدريب الشبكة أيضًا على تحديد ما هو الرقم الذي رُسم. وهكذا يصبح من الممكن بسهولة تفويض جمع البيانات إلى الخارج، بتوجيه الناس إلى موقع لتلقّي مُدخلاتهم. وهنا بعض شيفرة HTML لنبدأ منها.
<head>
	<script src="ocr.js"></script>
	<link rel="stylesheet" type="text/css" href="ocr.css">
</head>
<body onload="ocrDemo.onLoadFunction()">
	<div id="main-container" style="text-align: center;">
		<h1>OCR Demo</h1>
		<canvas id="canvas" width="200" height="200"></canvas>
		<form name="input">
			<p>Digit: <input id="digit" type="text"> </p>
			<input type="button" value="Train" onclick="ocrDemo.train()">
			<input type="button" value="Test" onclick="ocrDemo.test()">
			<input type="button" value="Reset" onclick="ocrDemo.resetCanvas();"/>
		</form>
	</div>
</body>
عميل التعرّف الضوئي على الحروف (ocr.js)
لأن بكسلًا واحدًا على لوحة HTML قد يكون صعب الرؤية، يمكننا أن نمثّل البكسل الواحد الذي يُدخل إلى الشبكة العصبية الاصطناعية بمربّع من 10×10 بكسلًا حقيقيًا. إذًا، فلوحة HTML الحقيقية هي 200×200 بكسل، ويُعبَّر عنها من منظور الشبكة العصبية الاصطناعية بلوحة 20×20. وستساعدنا المتغيّرات أدناه على تتبّع هذه القياسات.
var ocrDemo = {
    CANVAS_WIDTH: 200,
    TRANSLATED_WIDTH: 20,
    PIXEL_WIDTH: 10, // TRANSLATED_WIDTH = CANVAS_WIDTH / PIXEL_WIDTH
يمكن بعدئذٍ أن نبرز البكسلات في التمثيل الجديد حتى يسهل رؤيتها.
وهنا لدينا شبكة زرقاء مولَّدة بواسطة drawGrid().
    drawGrid: function(ctx) {
        for (var x = this.PIXEL_WIDTH, y = this.PIXEL_WIDTH;
                 x < this.CANVAS_WIDTH; x += this.PIXEL_WIDTH,
                 y += this.PIXEL_WIDTH) {
            ctx.strokeStyle = this.BLUE;
            ctx.beginPath();
            ctx.moveTo(x, 0);
            ctx.lineTo(x, this.CANVAS_WIDTH);
            ctx.stroke();

            ctx.beginPath();
            ctx.moveTo(0, y);
            ctx.lineTo(this.CANVAS_WIDTH, y);
            ctx.stroke();
        }
    },
كما نحتاج إلى تخزين البيانات المرسومة على الشبكة بشكل يمكن إرساله إلى
الخادم. ولتبسيط الأمور، يمكننا إنشاء مصفوفة تُسمّى data تُشير إلى البكسل
السوداء غير الملوّنة بالقيمة 0 وإلى البكسل البيضاء الملوّنة بالقيمة 1. ونحتاج أيضًا
إلى بعض مستمعي الفأرة على اللوحة حتى نعرف متى نستدعي fillSquare() لتلوين
بكسل بالأبيض بينما يرسم المستخدم رقمًا. وينبغي لهذه المستمعات أن
تتتبّع ما إذا كنا في حالة رسم ثم تستدعي fillSquare() لإجراء
بعض الحسابات البسيطة وتقرير أي البكسلات تحتاج إلى تعبئة.
    onMouseMove: function(e, ctx, canvas) {
        if (!canvas.isDrawing) {
            return;
        }
        this.fillSquare(ctx,
            e.clientX - canvas.offsetLeft, e.clientY - canvas.offsetTop);
    },

    onMouseDown: function(e, ctx, canvas) {
        canvas.isDrawing = true;
        this.fillSquare(ctx,
            e.clientX - canvas.offsetLeft, e.clientY - canvas.offsetTop);
    },

    onMouseUp: function(e) {
        canvas.isDrawing = false;
    },

    fillSquare: function(ctx, x, y) {
        var xPixel = Math.floor(x / this.PIXEL_WIDTH);
        var yPixel = Math.floor(y / this.PIXEL_WIDTH);
        this.data[((xPixel - 1)  * this.TRANSLATED_WIDTH + yPixel) - 1] = 1;

        ctx.fillStyle = '#ffffff';
        ctx.fillRect(xPixel * this.PIXEL_WIDTH, yPixel * this.PIXEL_WIDTH,
            this.PIXEL_WIDTH, this.PIXEL_WIDTH);
    },
الآن نحن أقرب إلى الجزء اللذيذ! نحتاج إلى دالة تُهيّئ
بيانات التدريب لإرسالها إلى الخادم. وهنا لدينا دالة train() نسبيًا
بسيطة تُجري بعض فحوص الأخطاء على البيانات المراد إرسالها،
وتضيفها إلى trainArray وترسلها عبر استدعاء sendData().
    train: function() {
        var digitVal = document.getElementById("digit").value;
        if (!digitVal || this.data.indexOf(1) < 0) {
            alert("Please type and draw a digit value in order to train the network");
            return;
        }
        this.trainArray.push({"y0": this.data, "label": parseInt(digitVal)});
        this.trainingRequestCount++;

        // Time to send a training batch to the server.
        if (this.trainingRequestCount == this.BATCH_SIZE) {
            alert("Sending training data to server...");
            var json = {
                trainArray: this.trainArray,
                train: true
            };

            this.sendData(json);
            this.trainingRequestCount = 0;
            this.trainArray = [];
        }
    },
هناك قرار تصميمي مثير للاهتمام يستحقّ الذكر هنا، وهو استخدام trainingRequestCount،
وtrainArray، وBATCH_SIZE. فما يحدث هنا هو أن BATCH_SIZE هو
ثابت معرَّف مسبقًا يحدّد مقدار بيانات التدريب التي يحتفظ بها العميل
قبل أن يرسل طلبًا مجمّعًا إلى الخادم ليُعالَج بواسطة نظام التعرّف الضوئي.
والسبب الرئيسي لتجميع الطلبات هو تجنّب إرهاق الخادم بكثرة الطلبات دفعة واحدة.
وإذا وُجد عملاء كثيرون (مثلًا كثير من المستخدمين على صفحة ocr.html
يدرّبون النظام)، أو إذا وُجدت في العميل طبقة أخرى تلتقط
الأرقام المرسومة الممسوحة ضوئيًا وتحوّلها إلى بكسلات لتدريب الشبكة، فإن
قيمة BATCH_SIZE بقيمة 1 ستنتج طلبات كثيرة لا حاجة إليها. وهذا النهج
جيّد لأنه يمنح العميل مرونة أكبر، غير أنه عمليًا
ينبغي أن يتم التجميع في الخادم أيضًا عند الحاجة. وقد يحدث هجوم حجب خدمة
(DoS) يعمد فيه عميل خبيث إلى إرسال طلبات كثيرة
إلى الخادم حتى يرهقه فيتعطّل.
سنحتاج أيضًا إلى دالة test(). ومثل train()، ينبغي أن تجري
فحصًا بسيطًا على صحّة البيانات وترسلها. أما في حالة test()
فلا يقع أي تجميع، إذ ينبغي أن يستطيع المستخدم طلب تنبؤ
والحصول على نتائج فورًا.
    test: function() {
        if (this.data.indexOf(1) < 0) {
            alert("Please draw a digit in order to test the network");
            return;
        }
        var json = {
            image: this.data,
            predict: true
        };
        this.sendData(json);
    },
وأخيرًا، سنحتاج إلى بعض الدوال لإجراء طلب HTTP POST، وتلقّي استجابة، ومعالجة أي أخطاء محتملة في أثناء ذلك.
    receiveResponse: function(xmlHttp) {
        if (xmlHttp.status != 200) {
            alert("Server returned status " + xmlHttp.status);
            return;
        }
        var responseJSON = JSON.parse(xmlHttp.responseText);
        if (xmlHttp.responseText && responseJSON.type == "test") {
            alert("The neural network predicts you wrote a \'"
                   + responseJSON.result + '\'');
        }
    },

    onError: function(e) {
        alert("Error occurred while connecting to server: " + e.target.statusText);
    },

    sendData: function(json) {
        var xmlHttp = new XMLHttpRequest();
        xmlHttp.open('POST', this.HOST + ":" + this.PORT, false);
        xmlHttp.onload = function() { this.receiveResponse(xmlHttp); }.bind(this);
        xmlHttp.onerror = function() { this.onError(xmlHttp) }.bind(this);
        var msg = JSON.stringify(json);
        xmlHttp.setRequestHeader('Content-length', msg.length);
        xmlHttp.setRequestHeader("Connection", "close");
        xmlHttp.send(msg);
    }
خادم (server.py)
ولرغم أنه خادم صغير لا سوى أن يمرّر المعلومات، إلا أننا نحتاج كذلك إلى التفكير في كيفية تلقّي طلبات HTTP ومعالجتها. أولًا نحتاج إلى تحديد نوع طلب HTTP الذي سنستخدمه. وفي القسم الأخير، يستخدم العميل POST، لكن لماذا اخترنا ذلك؟ ولأن البيانات تُرسَل إلى الخادم، فإن طلب PUT أو POST هو الأنسب. فنحن بحاجة إلى إرسال جسم بصيغة json دون وسائط في العنوان. إذًا من الناحية النظرية كان يكفي طلب GET، لكنه لا يجتمع مع المعنى الدلالي. غير أن الاختيار بين PUT وPOST، يظلّ جدلًا طويلًا مستمرًّا بين المبرمجين؛ وقد لخّص KNPLabs المسألة بأسلوب طريف.
وثمة اعتبار آخر وهو ما إذا كان ينبغي إرسال طلبات «train» مقابل «predict» إلى
نقاط طرفية مختلفة (مثل http://localhost/train وhttp://localhost/predict)
أم إلى نقطة طرفية واحدة تعالج البيانات بعد ذلك. وفي حالتنا،
يمكننا الاعتماد على المقاربة الأخيرة، إذ إن الفرق بين ما يُجرى
مع البيانات في كل حالة طفيف بما يكفي ليدخل في جملة if قصيرة. ومن
الناحية العملية، يكون من الأفضل جعل هذه نقاطًا طرفية منفصلة إذا كان الخادم
سيجري معالجة أكثر تفصيلًا لكل نوع من الطلبات. وهذا القرار بدوره
أثّر في رموز أخطاء الخادم المستخدمة. فمثلًا، يُرسَل خطأ 400
«Bad Request» حين لا يُحدَّد أيٌّ من «train» أو «predict» في
الحمل (payload). ولو استُخدمت نقاط طرفية منفصلة بدلًا من ذلك، لما كانت
هذه مشكلة. المعالجة التي يجريها نظام التعرّف الضوئي في الخلفية قد تفشل لأي
سبب، وإذا لم تُعالَج على نحو صحيح داخل الخادم، يُرسَل خطأ 500 «Internal
Server Error». وبدوره، لو كانت نقاط النهاية منفصلة، لاتّسع المجال
للتوسّع في إرسال أخطاء أكثر ملاءمة. فمثلًا، تحديد أن خطأ داخلي في الخادم
كان في الواقع بسبب طلب سيّئ.
وأخيرًا، نحتاج إلى تحديد متى وأين نُهيّئ نظام التعرّف الضوئي. وستكون
مقاربة جيّدة هي تهيئته داخل server.py لكن قبل بدء تشغيل الخادم.
وذلك لأن نظام التعرّف الضوئي يحتاج عند أول تشغيل إلى تدريب
الشبكة على بعض البيانات الموجودة مسبقًا في المرة الأولى التي يبدأ فيها، وقد يستغرق ذلك
بضع دقائق. فإذا بدأ الخادم قبل اكتمال هذه المعالجة، لأى أي طلب
تدريب أو تنبؤ إلى إطلاق استثناء، إذ لن يكون كائن التعرّف الضوئي
قد تهيّأ بعد، بالنظر إلى التنفيذ الحالي. ويجوز تنفيذ بديل آخر
أن ينشئ شبكة عصبية اصطناعية غير دقيقة أولية تُستخدم
لأول استعلامات قليلة ريثما تُدرَّب الشبكة الجديدة على نحو غير متزامن في
الخلفية. ويتيح هذا المقاربة البديلة استخدام الشبكة العصبية الاصطناعية
فورًا، لكن التنفيذ أكثر تعقيدًا، ولن يوفّر وقتًا إلا عند بدء التشغيل
للخوادم إن كانت تُعاد تهيئتها. وسيكون هذا النوع من التنفيذ
أكثر نفعًا لخدمة تعرّف ضوئي تتطلّب توافرية عالية.
وهنا لدينا معظم شيفرة الخادم في دالة قصيرة واحدة تتعامل مع طلبات POST.
    def do_POST(s):
        response_code = 200
        response = ""
        var_len = int(s.headers.get('Content-Length'))
        content = s.rfile.read(var_len);
        payload = json.loads(content);

        if payload.get('train'):
            nn.train(payload['trainArray'])
            nn.save()
        elif payload.get('predict'):
            try:
                response = {
                    "type":"test",
                    "result":nn.predict(str(payload['image']))
                }
            except:
                response_code = 500
        else:
            response_code = 400

        s.send_response(response_code)
        s.send_header("Content-type", "application/json")
        s.send_header("Access-Control-Allow-Origin", "*")
        s.end_headers()
        if response:
            s.wfile.write(json.dumps(response))
        return
تصميم شبكة عصبية أمامية التقدّم (neural_network_design.py)
عند تصميم شبكة عصبية أمامية التقدّم، هناك بعض العوامل التي علينا مراعاتها. وأولها ما هي دالة التفعيل التي سنستخدمها. وقد ذكرنا دوال التفعيل في وقت سابق بوصفها صانعة القرار في مُخرج العقدة. وسيساعدنا نوع القرار الذي تتّخذه دالة التفعيل في تحديد أيّها نستخدم. وفي حالتنا، سنصمّم شبكة عصبية اصطناعية تُخرج قيمة بين 0 و1 لكل رقم (من 0 إلى 9). وتعني القيم الأقرب إلى 1 أن الشبكة العصبية الاصطناعية تتنبّأ بأن هذا هو الرقم المرسوم، وتعني القيم الأقرب إلى 0 أنها تتنبّأ بأنه ليس الرقم المرسوم. لذلك نريد دالة تفعيل تكون مُخرجاتها قريبة من 0 أو قريبة من 1. ونحتاج أيضًا إلى دالة قابلة للاشتقاق لأننا سنحتاج إلى المشتقة في حساب الانتشار العكسي. والدالة الشائعة في هذه الحالة هي الدالة اللوغاريتمية (sigmoid) لأنها تستوفي كلتا القيدين. وتوفّر StatSoft قائمة جيدة لدوال التفعيل الشائعة وخصائصها.
العامل الثاني الذي يجب مراعاته هو ما إذا كنا نريد تضمين انحيازات. وقد ذكرنا الانحيازات بضع مرات من قبل لكننا لم نتحدّث فعليًا عمّا هي أو لماذا نستخدمها. ولنفهم ذلك فلنعد إلى كيفية حساب مُخرج العقدة في ann. فلنفترض لدينا عقدة دخل واحدة وعقدة خرج واحدة، ستكون صيغة مُخرجنا ، حيث هو المُخرج، و هي دالة التفعيل، و هو وزن الرابط بين العقدتين، و هو مُدخل المتغيّر للعقدة. أما الانحياز فهو في جوهرها عقدة يكون مُخرجها دائمًا . وسيؤدي ذلك إلى تغيير صيغة المُخرج إلى حيث هو وزن الربط بين عقدة الانحياز والعقدة التالية. فإذا اعتبرنا و ثابتين و متغيّرًا، فإن إضافة انحياز تضيف ثابتًا إلى المُدخل الخطي المُدخَل إلى .
لذلك تسمح إضافة الانحياز بإزاحة في -مقطع، وهي تمنح إجمالًا مرونة أكبر في مُخرج العقدة. ومن الممارسات الجيدة عادةً تضمين الانحيازات، وبخاصة في الشبكات العصبية الاصطناعية ذات عدد صغير من المداخل والمخارج. تتيح الانحيازات مرونة أكبر في مُخرج الشبكة العصبية الاصطناعية، ومن ثمّ تمنح الشبكة مساحة أكبر للدقّة. وبدون انحيازات، يقلّ احتمال أن نحصل على تنبؤات صحيحة عبر شبكتنا، أو سنحتاج إلى عدد أكبر من العقد المخفية لإجراء تنبؤات أدقّ.
العوامل الأخرى التي يجب مراعاتها هي عدد الطبقات المخفية وعدد العقد المخفية في كل طبقة. أما الشبكات العصبية الاصطناعية الكبيرة ذات المداخل والمخارج الكثيرة، فتُقرَّر هذه الأعداد بتجريب قيم مختلفة واختبار أداء الشبكة. وهنا يُقاس الأداء بتدريب شبكة عصبية اصطناعية بحجم معين ومعرفة النسبة المئوية من مجموعة التحقّق التي صُنِّفت بصورة صحيحة. وفي معظم الحالات، تكفي طبقة مخفية واحدة لأداء جيّد، لذا لا نجرّب هنا سوى عدد العقد المخفية.
# Try various number of hidden nodes and see what performs best
for i in xrange(5, 50, 5):
    nn = OCRNeuralNetwork(i, data_matrix, data_labels, train_indices, False)
    performance = str(test(data_matrix, data_labels, test_indices, nn))
    print "{i} Hidden Nodes: {val}".format(i=i, val=performance)
هنا نُهيّئ شبكة عصبية اصطناعية بعدد عقد مخفية يتراوح بين 5 و50 بزيادة مقدارها 5.
ثم نستدعي الدالة test().
def test(data_matrix, data_labels, test_indices, nn):
    avg_sum = 0
    for j in xrange(100):
        correct_guess_count = 0
        for i in test_indices:
            test = data_matrix[i]
            prediction = nn.predict(test)
            if data_labels[i] == prediction:
                correct_guess_count += 1

        avg_sum += (correct_guess_count / float(len(test_indices)))
    return avg_sum / 100
الحلقة الداخلية تعدّ عمليات التصنيف الصحيحة التي تُقسَم بدورها
في النهاية على عدد عمليات التصنيف التي جرت محاولتها. ويعطي هذا
نسبةً أو نسبة مئوية من الدقّة للشبكة العصبية الاصطناعية. ولأن أوزان الشبكة قد
تختلف قليلًا في كل مرة تُدرَّب فيها الشبكة، فإننا نكرّر هذه العملية 100 مرة في
الحلقة الخارجية حتى نتمكّن من أخذ متوسط دقّة إعداد الشبكة العصبية الاصطناعية
هذا. وفي حالتنا، تبدو إحدى تشغيلات neural_network_design.py على النحو
التالي:
PERFORMANCE
-----------
5 Hidden Nodes: 0.7792
10 Hidden Nodes: 0.8704
15 Hidden Nodes: 0.8808
20 Hidden Nodes: 0.8864
25 Hidden Nodes: 0.8808
30 Hidden Nodes: 0.888
35 Hidden Nodes: 0.8904
40 Hidden Nodes: 0.8896
45 Hidden Nodes: 0.8928
من هذا المُخرَج يمكننا أن نستنتج أن 15 عقدة مخفية هي الأكثر أمثلية. فإضافة 5 عقد من 10 إلى 15 تمنحنا نحو 1% من الدقّة إضافية، في حين أن رفع الدقّة بنسبة 1% أخرى يتطلب إضافة 20 عقدة. كما أن زيادة عدد العقد المخفية تزيد العبء الحسابي. لذا يستغرق تدريب الشبكات ذات العقد المخفية الأكثر ولإجراء التنبؤات وقتًا أطول. لذلك نختار استخدام آخر عدد للعقد المخفية نتج عنه ارتفاع كبير في الدقّة. وبالطبع، من الممكن عند تصميم شبكة عصبية اصطناعية ألا يكون العبء الحسابي مشكلة وأن يكون الأولوية القصوى هي الحصول على أكثر الشبكات العصبية الاصطناعية دقّة. وفي تلك الحالة يكون من الأفضل اختيار 45 عقدة مخفية بدلًا من 15.
الوظائف الأساسية لنظام التعرّف الضوئي على الحروف
في هذا القسم سنتحدث عن كيفية حدوث التدريب الفعلي عبر الانتشار العكسي، وكيف يمكننا استخدام الشبكة لإجراء التنبؤات، وكذلك قرارات التصميم الأخرى الخاصة بالوظائف الأساسية.
التدريب عبر الانتشار العكسي (ocr.py)
نستخدم خوارزمية الانتشار العكسي لتدريب شبكتنا العصبية الاصطناعية. وهي تتألّف من 4 خطوات رئيسية تُكرَّر لكل عيّنة في مجموعة التدريب، مع تحديث أوزان الشبكة العصبية الاصطناعية في كل مرة.
أولًا، نُهيّئ الأوزان بقيم عشوائية صغيرة (بين -1 و1). وفي
حالتنا، نُهيّئها إلى قيم بين -0.06 و0.06 ونخزّنها في
المصفوفات theta1 وtheta2 وinput_layer_bias وhidden_layer_bias. وبما أن
كل عقدة في طبقة ترتبط بكل عقدة في الطبقة التالية، يمكننا إنشاء
مصفوفة ذات m صف و n عمود، حيث n هو عدد العقد في إحدى
الطبقات وm هو عدد العقد في الطبقة المجاورة. وهذه المصفوفة تمثّل
جميع أوزان الروابط بين هاتين الطبقتين. وهنا تملك theta1
400 عمود لمدخلاتنا البالغة 20×20 بكسل، وصفوفًا بعدد num_hidden_nodes.
وعلى نحو مماثل، تمثّل theta2 الروابط بين الطبقة المخفية وطبقة
الخرج. ولديها أعمدة بعدد num_hidden_nodes وصفوف بعدد NUM_DIGITS (10). أما
المتجهان الآخران (ذوا صف واحد)، input_layer_bias وhidden_layer_bias، فيمثّلان
الانحيازات.
    def _rand_initialize_weights(self, size_in, size_out):
        return [((x * 0.12) - 0.06) for x in np.random.rand(size_out, size_in)]
            self.theta1 = self._rand_initialize_weights(400, num_hidden_nodes)
            self.theta2 = self._rand_initialize_weights(num_hidden_nodes, 10)
            self.input_layer_bias = self._rand_initialize_weights(1,
                                                                  num_hidden_nodes)
            self.hidden_layer_bias = self._rand_initialize_weights(1, 10)
الخطوة الثانية هي الانتشار الأمامي (forward propagation)، وهي في جوهرها حساب
مُخرجات العقد على النحو الموصوف في \aosasecref{sec.ocr.ann}، طبقةً طبقة بدءًا من
عقد الدخل. وهنا، y0 هي مصفوفة من الحجم 400 تحمل المُدخلات التي نرغب في
استخدامها لتدريب الشبكة العصبية الاصطناعية. فنضرب theta1 في y0 بعد تبديل
موضعها، بحيث نحصل على مصفوفتين بالأحجام (num_hidden_nodes x 400) * (400 x 1)،
فيكون لدينا متجّه من مُخرجات الطبقة المخفية بحجم num_hidden_nodes. ثم نضيف
متجّه الانحياز ونطبّق دالة التفعيل اللوغاريتمية بصيغة متجّهية على هذا
متجّه المُخرج، فنحصل على y1. وy1 هو متجّه مُخرجات طبقتنا المخفية. كما يتم
تكرار العملية نفسها مرة أخرى لحساب y2 لعقد الخرج. وy2 هو الآن
متجّه طبقة الخرج لدينا وقيمه تمثّل احتمال أن يكون فهرسُه هو الرقم المرسوم.
فمثلًا، إذا رسم أحدهم الرقم 8، تكون قيمة y2 عند الفهرس الثامن
هي الأكبر إذا كانت الشبكة العصبية الاصطناعية قد أتت بالتوقع الصحيح.
غير أن احتمال أن يكون الرقم 6 هو الرقم المرسوم قد يكون أعلى من احتمال الرقم 1،
لأنه يبدو أكثر شبهًا بالرقم 8 ومن المرجّح أن يستهلك البكسلات نفسها
المرسومة التي يستهلكها الرقم 8. ويصبح y2 أدقّ مع كل رقم مرسوم إضافي
تُدرَّب عليه الشبكة العصبية الاصطناعية.
    # The sigmoid activation function. Operates on scalars.
    def _sigmoid_scalar(self, z):
        return 1 / (1 + math.e ** -z)
            y1 = np.dot(np.mat(self.theta1), np.mat(data['y0']).T)
            sum1 =  y1 + np.mat(self.input_layer_bias) # Add the bias
            y1 = self.sigmoid(sum1)

            y2 = np.dot(np.array(self.theta2), y1)
            y2 = np.add(y2, self.hidden_layer_bias) # Add the bias
            y2 = self.sigmoid(y2)
الخطوة الثالثة هي الانتشار العكسي (back propagation)، وتنطوي على حساب الأخطاء عند
عقد الخرج ثم عند كل طبقة وسيطة رجوعًا نحو الدخل. وهنا
نبدأ بإنشاء متجّه مُخرَج متوقَّع، actual_vals، بالقيمة 1 عند فهرس
الرقم الذي يمثّل قيمة الرقم المرسوم وبأصفار 0 في غير ذلك. ويُحسب
متجّه الأخطاء عند عقد الخرج، output_errors، بطرح
متجّه المُخرج الفعلي y2 من actual_vals. ولكل طبقة مخفية
بعدها، نحسب مكوّنين. أولًا، لدينا مصفوفة أوزان الطبقة التالية
بعد تبديل موضعها مضروبة في أخطاء مُخرجاتها. ثم لدينا
مشتقة دالة التفعيل مطبَّقة على الطبقة السابقة. ثم نُجري
ضربًا على مستوى العناصر بين هذين المكوّنين، فينتج
متجّه أخطاء الطبقة المخفية. وهنا نسمّيه hidden_errors.
            actual_vals = [0] * 10
            actual_vals[data['label']] = 1
            output_errors = np.mat(actual_vals).T - np.mat(y2)
            hidden_errors = np.multiply(np.dot(np.mat(self.theta2).T, output_errors),
                                        self.sigmoid_prime(sum1))
تحديثات الأوزان هي ما يضبط أوزان الشبكة العصبية الاصطناعية بناءً على الأخطاء المحسوبة سابقًا. وتُحدَّث الأوزان في كل طبقة عبر ضرب المصفوفات. فمصفوفة الخطأ في كل طبقة تُضرب في مصفوفة مُخرجات الطبقة السابقة. ثم يُضرب هذا الناتج في عدد نسبي يُسمّى معدّل التعلّم (learning rate) ويُضاف إلى مصفوفة الأوزان. ومعدّل التعلّم هو قيمة بين 0 و1 تؤثّر في سرعة ودقّة التعلّم في الشبكة العصبية الاصطناعية. أما قيم معدّل التعلّم الأكبر فتنتج شبكة عصبية اصطناعية تتعلّم بسرعة لكنها أقل دقّة، في حين أن القيم الأصغر تنتج شبكة عصبية اصطناعية تتعلّم ببطء لكنها أكثر دقّة. وفي حالتنا، لدينا قيمة صغيرة نسبيًا لمعدّل التعلّم، وهي 0.1. وهذا يعمل جيدًا لأننا لا نحتاج إلى أن تكون الشبكة العصبية الاصطناعية مدرَّبة فورًا كي يستطيع المستخدم مواصلة إرسال طلبات التدريب أو التنبؤ. وتُحدَّث الانحيازات بمجرد ضرب معدّل التعلّم في متجّه أخطاء الطبقة.
            self.theta1 += self.LEARNING_RATE * np.dot(np.mat(hidden_errors),
                                                       np.mat(data['y0']))
            self.theta2 += self.LEARNING_RATE * np.dot(np.mat(output_errors),
                                                       np.mat(y1).T)
            self.hidden_layer_bias += self.LEARNING_RATE * output_errors
            self.input_layer_bias += self.LEARNING_RATE * hidden_errors
اختبار شبكة مدرَّبة (ocr.py)
بمجرد أن تُدرَّب الشبكة العصبية الاصطناعية عبر الانتشار العكسي، يصبح استخدامها
لإجراء التنبؤات أمرًا مباشرًا إلى حدٍّ كبير. وكما نرى هنا، فإننا نبدأ بحساب
مُخرج الشبكة العصبية الاصطناعية، y2، بالطريقة نفسها التي فعلناها في الخطوة الثانية من الانتشار العكسي.
ثم نبحث عن الفهرس الذي يحمل القيمة الكبرى في المتجّه. وهذا الفهرس هو
الرقم الذي تنبّأت به الشبكة العصبية الاصطناعية.
    def predict(self, test):
        y1 = np.dot(np.mat(self.theta1), np.mat(test).T)
        y1 =  y1 + np.mat(self.input_layer_bias) # Add the bias
        y1 = self.sigmoid(y1)

        y2 = np.dot(np.array(self.theta2), y1)
        y2 = np.add(y2, self.hidden_layer_bias) # Add the bias
        y2 = self.sigmoid(y2)

        results = y2.T.tolist()[0]
        return results.index(max(results))
قرارات تصميم أخرى (ocr.py)
تتوفّر عبر الإنترنت موارد كثيرة تتناول تنفيذ الانتشار العكسي بتفصيل أكبر. ومن الموارد الجيدة دورة من جامعة ويلاميت. فهي تستعرض خطوات الانتشار العكسي ثم تشرح كيف يمكن ترجمتها إلى صيغة مصفوفات. وبينما تظل كمية الحساب باستعمال المصفوفات هي نفسها المستعملة مع الحلقات، فإن الفائدة هي أن الشيفرة تصبح أبسط وأسهل في القراءة مع حلقات متداخلة أقل. وكما نرى، فإن عملية التدريب كاملة مكتوبة في أقل من 25 سطرًا من الشيفرة باستخدام الجبر بالمصفوفات.
كما ذُكر في مقدّمة \aosasecref{sec.ocr.decisions}، فإن تخزين أوزان الشبكة العصبية الاصطناعية يعني أننا لا نفقد التقدم الذي أحرزناه في تدريبها عند إيقاف الخادم أو انهياره المفاجئ لأي سبب. ونخزّن الأوزان بكتابتها بصيغة JSON في ملف. وعند الإقلاع، يحمّل نظام التعرّف الضوئي أوزان الشبكة العصبية الاصطناعية المحفوظة في الذاكرة. ولا تُستدعى دالة الحفظ داخليًا من نظام التعرّف الضوئي، بل يترك للخادم قرار موعد تنفيذ الحفظ. وفي حالتنا، يحفظ الخادم الأوزان بعد كل تحديث. وهذا حل سريع وبسيط لكنه ليس مثاليًا لأن الكتابة إلى القرص تستهلك وقتًا. كما أن هذا يمنعنا من التعامل مع طلبات متزامنة متعددة لعدم وجود آلية تمنع الكتابات المتزامنة في الملف نفسه. وفي خادم أكثر تعقيدًا، يمكن أن يتم الحفظ عند الإيقاف أو مرة كل بضع دقائق مع شكل ما من الأقفال أو بروتوكول ختم زمني لضمان عدم فقدان أي بيانات.
    def save(self):
        if not self._use_file:
            return

        json_neural_network = {
            "theta1":[np_mat.tolist()[0] for np_mat in self.theta1],
            "theta2":[np_mat.tolist()[0] for np_mat in self.theta2],
            "b1":self.input_layer_bias[0].tolist()[0],
            "b2":self.hidden_layer_bias[0].tolist()[0]
        };
        with open(OCRNeuralNetwork.NN_FILE_PATH,'w') as nnFile:
            json.dump(json_neural_network, nnFile)

    def _load(self):
        if not self._use_file:
            return

        with open(OCRNeuralNetwork.NN_FILE_PATH) as nnFile:
            nn = json.load(nnFile)
        self.theta1 = [np.array(li) for li in nn['theta1']]
        self.theta2 = [np.array(li) for li in nn['theta2']]
        self.input_layer_bias = [np.array(nn['b1'][0])]
        self.hidden_layer_bias = [np.array(nn['b2'][0])]
الخاتمة
الآن بعد أن تعلّمنا عن الذكاء الاصطناعي والشبكات العصبية الاصطناعية والانتشار العكسي، وبناء نظام تعرّف ضوئي على الحروف من الطرف إلى الطرف، فلنُراجع أبرز ما في هذا الفصل والصورة الكبرى.
بدأنا الفصل بإعطاء خلفية عن الذكاء الاصطناعي والشبكات العصبية الاصطناعية، وما سننفّذه تقريبًا. ناقشنا ما هو الذكاء الاصطناعي وأمثلة على استخداماته. ورأينا أن الذكاء الاصطناعي هو في جوهره مجموعة من الخوارزميات أو مقاربات حلّ المشكلات التي يمكنها أن تعطي إجابة عن سؤال بطريقة مشابهة لما يفعله الإنسان. ثم نظرنا في بنية الشبكة العصبية الاصطناعية الأمامية التقدّم. وتعلّمنا أن حساب المُخرج عند عقدة معيّنة كان ببساطة جمعًا لجداء مُخرجات العقد السابقة مع أوزانها الموصّلة. وتحدّثنا عن كيفية استخدام الشبكة العصبية الاصطناعية بصياغة المُدخلات أولًا وتقسيم البيانات إلى مجموعتَي تدريب وتحقّق.
ومتى توفّر لنا بعض الخلفية، بدأنا نتحدث عن إنشاء نظام قائم على الويب من بنية عميل-خادم يتعامل مع طلبات المستخدم لتدريب نظام التعرّف الضوئي على الحروف أو اختباره. ثم ناقشنا كيف سيفسّر العميل البكسلات المرسومة في مصفوفة وينفّذ طلب HTTP إلى خادم التعرّف الضوئي على الحروف لإجراء التدريب أو الاختبار. وناقشنا كيف يقرأ خادمنا البسيط الطلبات وكيف نصمّم شبكة عصبية اصطناعية باختبار أداء عدة أعداد للعقد المخفية. وانتهينا إلى مراجعة شيفرة التدريب والاختبار الأساسية للانتشار العكسي.
ولرغم أننا بنينا نظام تعرّف ضوئي على الحروف يبدو عمليًا، فإن هذا الفصل لا يفعل سوى أن يلامس سطح كيفية عمل نظام تعرّف ضوئي حقيقي. ويمكن لأنظمة التعرّف الضوئي على الحروف الأكثر تعقيدًا أن تعالج مُدخلاتها مسبقًا، أو تستخدم خوارزميات تعلّم آلة هجينة، أو تمرّ بمراحل تصميم أكثر شمولًا، أو تحتوي على تحسينات أخرى لاحقة.