قاعدة بيانات مستوحاة من علم الآثار
title: قاعدة بيانات مستوحاة من علم الآثار author: Yoav Rubin
يوآف روبين مهندس برمجيات أول في مايكروسوفت، وقبل ذلك كان عضوًا في هيئة الباحثين ومخترعًا رئيسيًا في أبحاث IBM. وهو يعمل الآن في مجال أمن البيانات في السحابة، وفي الماضي تركّز عمله على تطوير بيئات تطوير قائمة على السحابة أو الويب. يحمل يوآف ماجستير في البحث الطبي في مجال علم الأعصاب وبكالوريوس في هندسة نظم المعلومات. يتعامل على تويتر باسم @yoavrubin، ويكتب مدونة من حين لآخر على http://yoavrubin.blogspot.com.
مقدمة
يُنظر إلى تطوير البرمجيات غالبًا على أنه عملية صارمة، تكون فيها المدخلات متطلبات والمخرجات منتجًا عاملًا. لكن مطوّري البرمجيات بشر، لهم وجهات نظرهم وتحيّزاتهم الخاصة التي تلوّن نواتج عملهم.
في هذا الفصل، سنستكشف كيف يؤثر تغيّر في منظور شائع في تصميم وتنفيذ نوع مدروس جيدًا من البرمجيات: قاعدة البيانات (database).
صُممت أنظمة قواعد البيانات لتخزين البيانات والاستعلام عنها. وهذا ما يفعله كلعامل في مجال المعلومات؛ لكن الأنظمة نفسها صمّمها علماء حاسوب. ونتيجة لذلك، تتأثر أنظمة قواعد البيانات الحديثة تأثيرًا كبيرًا بتعريف علماء الحاسوب لما هو البيانات، وما يمكن فعله بها.
على سبيل المثال، تنفّذ معظم قواعد البيانات الحديثة التحديثات بأن تدهس البيانات القديمة في مكانها (in place) بدلًا من إلحاق البيانات الجديدة بالاحتفاظ بالقديمة. وهذه الآلية، التي أسماها Rich Hickey اسمها «البرمجة الموجَّهة بالمواضع» (place-oriented programming)، توفّر مساحة تخزين لكنها تجعل استرجاع التاريخ الكامل لسجل بعينه مستحيلًا. وهذا القرار في التصميم يعكس منظور عالم الحاسوب بأن «التاريخ» أقل أهمية من ثمن تخزينه.
ولو سألت عالم آثار بدلًا من ذلك أين يمكن العثور على البيانات القديمة، فسيكون الجواب «إن شاء الله، إنها مدفونة في الأسفل فحسب».
(تنويه: فهمي لآراء عالم الآثار النموذجي مبني على زيارة بضعة متاحف، وقراءة عدة مقالات في ويكيبيديا، ومشاهدة سلسلة Indiana Jones كاملة.)
تصميم قاعدة بيانات كمثل عالم الآثار
لو سألنا عالم الآثار الودود لدينا أن يصمّم قاعدة بيانات، فمن المتوقع أن تعكس المتطلبات ما يمكن العثور عليه في موقع تنقيب:
- كل البيانات موجودة في الموقع ومُفهرسة.
- الحفر أعمق يكشف عن حالة الأمور في أزمنة ماضية.
- القطع الأثرية الموجودة في الطبقة نفسها تنتمي إلى الحقبة نفسها.
- كل قطعة أثرية تتكوّن من الحالة التي تراكمت فيها في حقترات مختلفة.
فمثلًا قد يحمل جدار رموزًا رومانية في طبقة ما، وفي طبقة أدنى قد تكون هناك رموز يونانية. وكلا الملاحظتين يُسجَّلان كجزء من حالة الجدار.
ويمكن تخيّل هذا التشبيه مرسومًا في exc:
- الدائرة كاملة هي موقع التنقيب.
- كل حلقة هي طبقة (هنا مرقّمة من 0 إلى 4).
- كل شريحة قطعة أثرية موسومة (من «A» إلى «E»).
- لكل قطعة أثرية صفة «رمز» (حيث تعني الفراغ أنه لم يجرِ أي تحديث).
- الأسهم المتصلة تدل على تغيّر في الرمز بين الطبقات
- الأسهم المتقطعة علاقات اعتباطية محلّية بين القطع الأثرية (مثلًا من «E» إلى «A»).
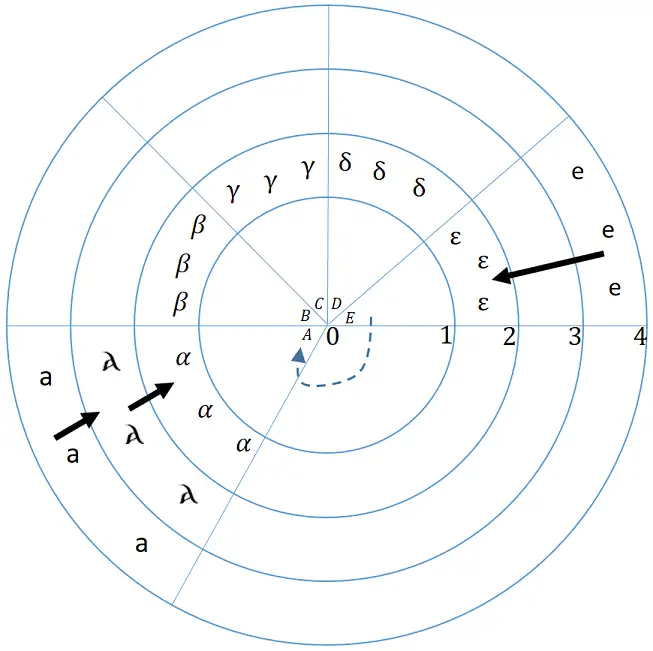
ولو ترجمنا لغة عالم الآثار إلى مصطلحات يستخدمها مصمّم قواعد البيانات لَما استعملها:
- موقع التنقيب هو قاعدة بيانات.
- كل قطعة أثرية هي كيان (entity) له معرِّف (ID) مقابل.
- لكل كيان مجموعة من الخصائص (attributes)، قد تتغير مع الزمن.
- لكل خاصية قيمة (value) بعينها عند زمن بعينه.
قد يبدو هذا مختلفًا جدًا عن أنواع قواعد البيانات التي اعتدت العمل معها. ويُشار إلى هذا التصميم أحيانًا بأنه «قاعدة بيانات وظيفية» (functional database)، لأنه يستخدم أفكارًا من مجال البرمجة الوظيفية. ويصف بقية الفصل كيفية تنفيذ قاعدة بيانات من هذا النوع.
وبما أننا نبني قاعدة بيانات وظيفية، فسنستخدم لغة برمجة وظيفية اسمها Clojure.
تتمتع Clojure بعدة صفات تجعلها لغة تنفيذ جيدة لقاعدة بيانات وظيفية، مثل الثبات (immutability) المدمج، والدوال العليا (higher order functions)، ووسائل البرمجة الميتا (metaprogramming). لكن السبب النهائي لاختيار Clojure هو تأكيدها على التصميم النظيف الصارم، وهي صفة قلّة من لغات البرمجة تمتلكها.
وضع الأساس
لنبدأ بإعلان البنى الأساسية التي تتكوّن منها قاعدة بياناتنا.
(defrecord Database [layers top-id curr-time])
تتألف قاعدة البيانات من:
- طبقات من الكيانات، لكل منها ختم زمني فريد خاص بها (الحلقات في الشكل 1).
- قيمة top-id وهي المعرِّف الفريد المتاح التالي.
- الزمن الذي حُدِّثت فيه قاعدة البيانات آخر مرة.
(defrecord Layer [storage VAET AVET VEAT EAVT])
تتألف كل طبقة من:
- مخزن بيانات للكيانات.
- فهارس تُستخدم لتسريع الاستعلامات على قاعدة البيانات. (وستُشرح هذه الفهارس ومعنى أسمائها لاحقًا.)
في تصميمنا، قد تتألف «قاعدة بيانات» مفهومية واحدة من عدة نسخ Database، كل منها يمثل لقطة من قاعدة البيانات عند curr-time. وقد تتشارك Layer الكيانَ نفسه بالضبط مع Layer أخرى إذا لم تتغير حالة الكيان بين الوقتين اللذين تمثلهما.
الكيانات
لن تكن قاعدة بياناتنا ذات فائدة دون كيانات نخزّن فيها، لذا نعرّفها تاليًا. وكما ناقشنا من قبل، للكيان معرِّف وقائمة من الخصائص؛ وننشئها باستخدام الدالة make-entity.
(defrecord Entity [id attrs])

(defn make-entity
   ([] (make-entity :db/no-id-yet))
   ([id] (Entity.  id {})))
ولاحظ أن المعرِّف إذا لم يُعطى، فيضبط معرِّف الكيان على :db/no-id-yet، أي أن شيئًا آخر مسؤول عن منحه معرِّفًا. وسنرى لاحقًا كيف يعمل هذا.
الخصائص
تتألف كل خاصية من اسمها وقيمتها وختمَي زمن آخر تحديث لها والتحديث الذي قبله. ولكل خاصية أيضًا حقلان يصفان type وcardinality الخاصين بها.
وفي الحالة التي تُستخدم فيها الخاصية لتمثيل علاقة بكيان آخر، فإن type سيكون :db/ref وستكون قيمتها معرِّف الكيان المرتبط. وهذا نظام أنواع بسيط يكون أيضًا نقطة امتداد. فالمستخدمون أحرار في تعريف أنواعهم والاستفادة منها لتوفير دلالات إضافية لبياناتهم.
وتحدّد cardinality الخاصية ما إذا كانت الخاصية تمثل قيمة واحدة أم مجموعة قيم. ونستخدم هذا الحقل لتحديد مجموعة العمليات المسموح بها على هذه الخاصية.
ويتم إنشاء الخاصية باستخدام الدالة make-attr.
(defrecord Attr [name value ts prev-ts])

(defn make-attr
   ([name value type ; these ones are required
       & {:keys [cardinality] :or {cardinality :db/single}} ]
     {:pre [(contains? #{:db/single :db/multiple} cardinality)]}
    (with-meta (Attr. name value -1 -1) {:type type :cardinality cardinality})))
هناك نمطان مثيران للاهتمام مستخدَمان في دالة الإنشاء هذه:
- نستخدم نمط «التصميم بالعقد» (Design by Contract) في Clojure للتحقق من أن معامل cardinality قيمة مسموح بها.
- نستخدم آلية تفكيك البنى (destructuring) في Clojure لتوفير قيمة افتراضية وهي
:db/singleإذا لم تُعطى قيمة. - نستخدم إمكانات البيانات الوصفية (metadata) في Clojure للتمييز بين بيانات الخاصية (الاسم والقيمة والأختام الزمنية) وبين بياناتها الوصفية (النوع والcardinality). وفي Clojure، تتم معالجة البيانات الوصفية باستخدام الدالتين
with-meta(للضبط) وmeta(للقراءة).
لا تكون الخصائص ذات معنى إلا إذا كانت جزءًا من كيان. ونُنشئ هذا الاتصال بالدالة add-attr، التي تضيف خاصية معطاة إلى خريطة خصائص الكيان (المسماة :attrs).
ولاحظ أننا بدلًا من استخدام اسم الخاصية مباشرة، نحوّله أولًا إلى كلمة مفتاحية التزامًا بالاستخدام الاصطلابي لخرائط Clojure.
(defn add-attr [ent attr]
   (let [attr-id (keyword (:name attr))]
      (assoc-in ent [:attrs attr-id] attr)))
التخزين
حتى الآن تحدثنا كثيرًا عن ماذا سنخزّن، دون التفكير في أين سنخزّنه. في هذا الفصل، نلجأ إلى أبسط آلية تخزين: تخزين البيانات في الذاكرة. وهذا ليس موثوقًا بالضرورة، لكنه يبسّط التطوير وتصحيح الأخطاء ويتيح لنا التركيز على أجزاء أكثر إثارة في البرنامج.
وسنصل إلى التخزين عبر بروتوكول (protocol) بسيط، مما يجعل من الممكن تعريف مزوّدين إضافيين للتخزين ليختار منهم مالك قاعدة البيانات.
(defprotocol Storage
   (get-entity [storage e-id] )
   (write-entity [storage entity])
   (drop-entity [storage entity]))
وهذا هو تنقيذنا في الذاكرة للبروتوكول، الذي يستخدم خريطة بوصفها المخزن:
(defrecord InMemory [] Storage
   (get-entity [storage e-id] (e-id storage))
   (write-entity [storage entity] (assoc storage (:id entity) entity))
   (drop-entity [storage entity] (dissoc storage (:id entity))))
فهرسة البيانات
الآن بعد أن عرّفنا العناصر الأساسية لقاعدة بياناتنا، يمكننا أن نبدأ في التفكير كيف سنستعلمها. وبفضل الطريقة التي هيكلنا بها بياناتنا، فإن أي استعلام من المحتمَل أن يهتم، على الأقل، بمعرّف كيان واحد وباسم وقيمة بعض خصائصه. وهذه الثلاثية (entity-id, attribute-name, attribute-value) مهمة إلى حدٍّ كبير في عملية الاستعلام لدرجة أن نعطيها اسمًا صريحًا: وهي datom.
والـdatoms مهمة لأنها تمثل حقائق، وقاعدة بياناتنا تتراكم فيها الحقائق.
ولن أكون قد استخدمت نظام قاعدة بيانات من قبل، فأنت على الأرجح على اطلاع بالفعل بمفهوم الفهرس (_index)، وهو بنية بيانات داعمة تستهلك مسافة إضافية بهدف تقليل متوسط زمن الاستعلام. وفي قاعدة بياناتنا، الفهرس بنية من ثلاثة مستويات تخزّن مكونات الـdatom بترتيب محدد. ويشتق كل فهرس اسمه من الترتيب الذي يخزّن به مكونات الـdatom.
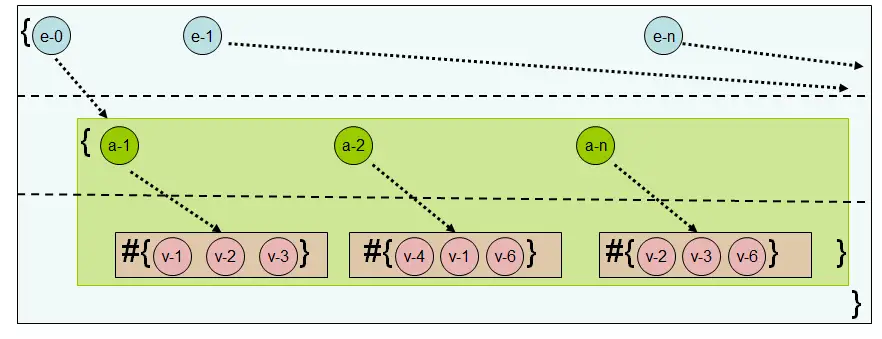
على سبيل المثال، لننظر في الفهرس المرسوم في eavt:
- المستوى الأول يخزّن معرّفات الكيانات
- المستوى الثاني يخزّن أسماء الخصائص المرتبطة
- المستوى الثالث يخزّن القيمة المرتبطة
ويُسمى هذا الفهرس EAVT، لأن الخريطة في المستوى الأعلى تحمل معرّفات الكيانات (Entity IDs)، والمستوى الثاني يحمل أسماء الخصائص (Attribute names)، والأوراق تحمل القيم (Values). أما حرف «T» فيأتي من أن كل طبقة في قاعدة البيانات لها فهارسها الخاصة، لذا فإن الفهرس نفسه ذو صلة بزمن محدد (Time).
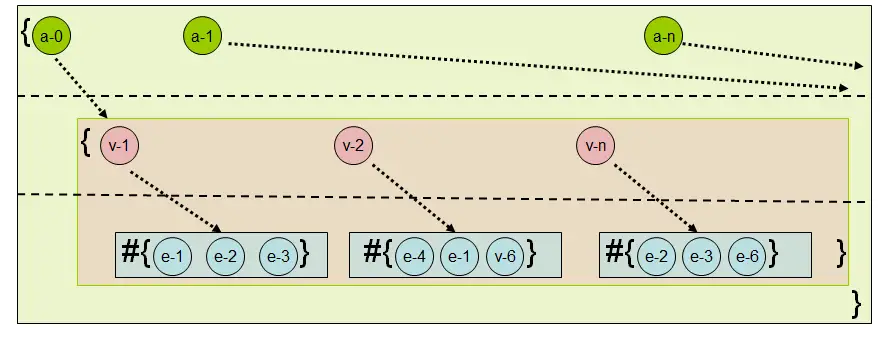
ويُظهر avet فهرسًا سيُسمى AVET لأن:
- خريطة المستوى الأول تحمل اسم الخاصية.
- خريطة المستوى الثاني تحمل القيم (للخصائص).
- مجموعة المستوى الثالث تحمل معرّفات الكيانات (للكيانات التي خاصيتها في المستوى الأول).
تُنفَّذ فهارسنا على هيئة خريطة من خرائط، حيث مفاتيح الخريطة الجذرية تؤدّي دور المستوى الأول، ويشير كل مفتاح من هذه المفاتيح إلى خريطة مفاتيحها تؤدّي دور المستوى الثاني للفهرس، بينما القيم هي المستوى الثالث. وكل عنصر في المستوى الثالث مجموعة (set) تحمل أوراق الفهرس.
ويخزّن كل فهرس مكونات الـdatom بوصفها تبادلًا ما (permutation) لترتيبه المعياري «EAV» (entity_id, attribute-name, attribute-value). غير أن العمل مع الـdatoms خارج الفهرس يجري بمنتظرنا منها الصيغة المعيارية. ومن ثم نوفّر لكل فهرس الدالتين from-eav وto-eav للتحويل من وإلى هذه الترتيبات.
وفي معظم أنظمة قواعد البيانات، تكون الفهارس مكوّنًا اختياريًا؛ فمثلًا في RDBMS (نظام إدارة قواعد البيانات العلائقية) مثل PostgreSQL أو MySQL، ستختار إضافة فهارس إلى أعمدة بعينها في جدول فقط. ونوفّر لكل فهرس الدالة usage-pred التي تحدد، بالنسبة لخاصية، ما إذا كان ينبغي تضمينها في هذا الفهرس أم لا.
(defn make-index [from-eav to-eav usage-pred]
    (with-meta {} {:from-eav from-eav :to-eav to-eav :usage-pred usage-pred}))

 (defn from-eav [index] (:from-eav (meta index)))
 (defn to-eav [index] (:to-eav (meta index)))
 (defn usage-pred [index] (:usage-pred (meta index)))
في قاعدة بياناتنا هناك أربعة فهارس: EAVT (انظر eavt)، وAVET (انظر avet)، وVEAT وVAET. يمكننا الوصول إليها بوصفها متجهًا من القيم التي تعيدها الدالة indexes.
(defn indexes[] [:VAET :AVET :VEAT :EAVT])
ولكي نبيّن كيف يجتمع كل هذا معًا، فإن نتيجة فهرسة الكيانات الخمسة التالية موصّرة في \aosatblref{500l.functionaldb.indextable}.
- يوليوس قيصر (المعروف أيضًا JC) يعيش في روما
- بروتوس (المعروف أيضًا B) يعيش في روما
- كليوباترا (المعروفة أيضًا Cleo) تعيش في مصر
- نهر روما هو النهر Tiber
- نهر مصر هو نهر النيل
| فهرس EAVT | فهرس AVET |
|
|
| فهرس VEAT | فهرس VAET |
|
|
قاعدة البيانات
لدينا الآن جميع المكوّنات التي نحتاجها لبناء قاعدة بياناتنا. ويعني تهيئة قاعدة بياناتنا:
- إنشاء طبقة فارغة أولى لا تحتوي على بيانات
- إنشاء مجموعة من الفهارس الفارغة
- ضبط
top-idوcurr-timeعلى 0
(defn ref? [attr] (= :db/ref (:type (meta attr))))

(defn always[& more] true)

(defn make-db []
   (atom
       (Database. [(Layer.
                   (fdb.storage.InMemory.) ; storage
                   (make-index #(vector %3 %2 %1) #(vector %3 %2 %1) #(ref? %));VAET
                   (make-index #(vector %2 %3 %1) #(vector %3 %1 %2) always);AVET
                   (make-index #(vector %3 %1 %2) #(vector %2 %3 %1) always);VEAT
                   (make-index #(vector %1 %2 %3) #(vector %1 %2 %3) always);EAVT
                  )] 0 0)))
هناك عقبة واحدة رغم ذلك: جميع المجموعات في Clojure غير قابلة للتغيير. ولأن عمليات الكتابة جوهرية في قاعدة البيانات، فإننا نعرّف بنية البيانات لتكون Atom، وهو نوع مرجعي في Clojure يوفّر إمكانية الكتابة الذرّية.
قد تتساءل لماذا نستخدم الدالة always لفهارس AVET وVEAT وEAVT، والمنبِّه ref? لفهرس VAET. السبب هو أن هذه الفهارس تُستخدم في سيناريوهات مختلفة، وهو ما سنراه لاحقًا عندما نستكشف الاستعلامات بعمق.
المحددات الأساسية
قبل أن نتمكن من بناء مرافق استعلام معقدة لقاعدة بياناتنا، نحتاج إلى تقديم واجهة برمجية (API) منخفضة المستوى يمكن لأجزاء مختلفة من النظام استخدامها لجلب المكوّنات التي بنيناها حسب مُعرِّفات المرتبطة من أي لحظة زمنية. ويمكن لمستهلكي قاعدة البيانات أيضًا استخدام هذه الواجهة؛ غير أن من المرجح أكثر أن يستخدموا المكوّنات الأثقل مزايا المبنية فوقها.
تتألف هذه الواجهة منخفضة المستوى من دوال المحدد (accessor) الأربع التالية:
(defn entity-at
   ([db ent-id] (entity-at db (:curr-time db) ent-id))
   ([db ts ent-id] (get-entity (get-in db [:layers ts :storage]) ent-id)))

(defn attr-at
   ([db ent-id attr-name] (attr-at db ent-id attr-name (:curr-time db)))
   ([db ent-id attr-name ts] (get-in (entity-at db ts ent-id) [:attrs attr-name])))

(defn value-of-at
   ([db ent-id attr-name]  (:value (attr-at db ent-id attr-name)))
   ([db ent-id attr-name ts] (:value (attr-at db ent-id attr-name ts))))

(defn indx-at
   ([db kind] (indx-at db kind (:curr-time db)))
   ([db kind ts] (kind ((:layers db) ts))))
وبما أننا نتعامل مع قاعدة بياناتنا كما نتعامل مع أي قيمة أخرى، فإن كل واحدة من هذه الدوال تأخذ قاعدة البيانات كوسيط. ويُسترجع كل عنصر حسب مُعرِّفه المرتبط، وباختيار الطابع الزمني محل الاهتمام. ويُستخدم هذا الطابع الزمني للعثور على الطبقة المقابلة التي ينبغي أن يُطبَّق عليها بحثنا.
التطوّر
أولى استخدامات المحددات الأساسية هي توفير واجهة برمجية «تقرأ في الماضي». وهذا ممكن لأن عملية التحديث في قاعدة بياناتنا تتم بإلحاق طبقة جديدة (بدلًا من الدهس). ومن ثم يمكننا استخدام الخاصية prev-ts للنظر إلى الخاصية عند تلك الطبقة، ومتابعة النظر إلى عمق التاريخ لرصد كيفية تطوّر قيمة الخاصية عبر الزمن.
وهذا بالضبط ما تفعله الدالة evolution-of. فهي تُعيد تسلسلًا من الأزواج، كل زوج مكوّن من الطابع الزمني وقيمة تحديث خاصية ما.
(defn evolution-of [db ent-id attr-name]
   (loop [res [] ts (:curr-time db)]
     (if (= -1 ts) (reverse res)
         (let [attr (attr-at db ent-id attr-name ts)]
           (recur (conj res {(:ts attr) (:value attr)})  (:prev-ts attr))))))
سلوك البيانات ودورة حياتها
حتى الآن، ركّزت مناقشتنا على بنية بياناتنا: ما المكوّنات الأساسية وكيف تُجمَع معًا. حان وقت استكشاف ديناميكيات نظامنا: كيف تتغير البيانات مع الزمن عبر دورة حياة البيانات: إضافة--تحديث--إزالة.
وكما ناقشنا من قبل، فإن البيانات في عالم الآثار لا تتغير حقًا. فبمجرد إنشائها تبقى موجودة إلى الأبد، ولا يمكن إخفاؤها عن العالم إلا ببيانات في طبقة أحدث. ومفهوم «الإخفاء» هو الأهم هنا. فالبيانات القديمة لا «تختفي»— بل تُدفن، ويمكن كشفها من جديد بإظهار طبقة أقدم. وبالمقابل، فإن تحديث البيانات يعني إخفاء القديمة بإضافة طبقة جديدة فوقها تحوي شيئًا آخر. ومن ثم يمكننا «حذف» البيانات بإضافة طبقة من «لا شيء» فوقها.
وهذا يعني أن ما نتحدث عنه حين نتحدث عن دورة حياة البيانات هو في الحقيقة إضافة طبقات إلى بياناتنا عبر الزمن.
الضروريات المجردة
تتألف دورة حياة البيانات من ثلاث عمليات أساسية:
- إضافة كيان بالدالة
add-entity - إزالة كيان بالدالة
remove-entity - تحديث كيان بالدالة
update-entity
وتذكّر أن هذه الدوال، رغم أنها توفّر وهم التغيير (mutation)، لا تفعل في كل حالة سوى إضافة طبقة أخرى إلى البيانات. وأيضًا، بما أننا نستخدم بنى بيانات دائمة (persistent) في Clojure، فإننا من منظور المستدعي ندفع الثمن نفسه مقابل هذه العمليات الذي ندفعه مقابل تغيير «في المكان» (أي عبء أداء مهمل)، مع الحفاظ على الثبات بالنسبة إلى جميع المستخدمين الآخرين لبنية البيانات.
إضافة كيان
تتطلب إضافة كيان أن نؤدي ثلاثة أمور:
- تحضير الكيان للإضافة (بمنحه معرِّفًا وطابعًا زمنيًا)
- وضع الكيان في التخزين
- تحديث الفهارس حسب الحاجة
وتُنفَّذ هذه الخطوات في الدالة add-entity.
(defn add-entity [db ent]
   (let [[fixed-ent next-top-id] (fix-new-entity db ent)
         layer-with-updated-storage (update-in
                            (last (:layers db)) [:storage] write-entity fixed-ent)
         add-fn (partial add-entity-to-index fixed-ent)
         new-layer (reduce add-fn layer-with-updated-storage (indexes))]
    (assoc db :layers (conj (:layers db) new-layer) :top-id next-top-id)))
يتم تحضير الكيان باستدعاء الدالة fix-new-entity ودوالها المساعدة next-id وnext-ts وupdate-creation-ts.
وتُعد دالتا المساعدة الأخيرتان مسؤولتين عن العثور على الطابع الزمني التالي لقاعدة البيانات (بواسطة next-ts)، وتحديث طابع الإنشاء للكيان المعطى (بواسطة update-creation-ts). وتحديث طابع إنشاء الكيان يعني المرور على خصائص الكيان وتحديث حقول :ts فيها.
(defn- next-ts [db] (inc (:curr-time db)))

(defn- update-creation-ts [ent ts-val]
   (reduce #(assoc-in %1 [:attrs %2 :ts ] ts-val) ent (keys (:attrs ent))))

(defn- next-id [db ent]
   (let [top-id (:top-id db)
         ent-id (:id ent)
         increased-id (inc top-id)]
         (if (= ent-id :db/no-id-yet)
             [(keyword (str increased-id)) increased-id]
             [ent-id top-id])))

(defn- fix-new-entity [db ent]
   (let [[ent-id next-top-id] (next-id db ent)
         new-ts               (next-ts db)]
       [(update-creation-ts (assoc ent :id ent-id) new-ts) next-top-id]))
ولإضافة الكيان إلى التخزين، فإننا نحدد أحدث طبقة في قاعدة البيانات ونحدّث التخزين في تلك الطبقة بطبقة جديدة، تُحفظ نتائجها في layer-with-updated-storage.
وأخيرًا، علينا تحديث الفهارس. أي، لكل فهرس (بواسطة التركيبة بين reduce وadd-entity-to-index المُمرَّرة جزئيًا عبر partial في الدالة add-entity):
- إيجاد الخصائص التي ينبغي فهرستها (انظر التركيبة بين
filterوusage-predالخاص بالفهرس الذي يعمل على الخصائص فيadd-entity-to-index) - بناء مسار فهرس من معرّف الكيان (انظر التركيبة بين
update-entry-in-indexالمُمرَّرة جزئيًا عبر \newlinepartialمعfrom-eavفي الدالةupdate-attr-in-index) - إضافة ذلك المسار إلى الفهرس (انظر الدالة
update-entry-in-index)
(defn- add-entity-to-index [ent layer ind-name]
   (let [ent-id (:id ent)
         index (ind-name layer)
         all-attrs  (vals (:attrs ent))
         relevant-attrs (filter #((usage-pred index) %) all-attrs)
         add-in-index-fn (fn [ind attr]
                                 (update-attr-in-index ind ent-id (:name attr)
                                                                  (:value attr)
                                                                  :db/add))]
        (assoc layer ind-name  (reduce add-in-index-fn index relevant-attrs))))

(defn- update-attr-in-index [index ent-id attr-name target-val operation]
   (let [colled-target-val (collify target-val)
         update-entry-fn (fn [ind vl]
                             (update-entry-in-index
                                ind
                                ((from-eav index) ent-id attr-name vl)
                                operation))]
     (reduce update-entry-fn index colled-target-val)))

(defn- update-entry-in-index [index path operation]
   (let [update-path (butlast path)
         update-value (last path)
         to-be-updated-set (get-in index update-path #{})]
     (assoc-in index update-path (conj to-be-updated-set update-value))))
تُضاف جميع هذه المكوّنات بوصفها طبقة جديدة إلى قاعدة البيانات المعطاة. ولم يبقَ سوى تحديث حقول الطابع الزمني وtop-id في قاعدة البيانات. وتحدث هذه الخطوة الأخيرة في السطر الأخير من add-entity، الذي يُعيد أيضًا قاعدة البيانات المحدَّثة.
كما نوفّر دالة راحة add-entities تضيف كيانات متعددة إلى قاعدة البيانات باستدعاء واحد، عبر تطبيق add-entity بشكل متكرر.
(defn add-entities [db ents-seq] (reduce add-entity db ents-seq))
إزالة كيان
تعني إزالة كيان من قاعدة بياناتنا إضافة طبقة لا يوجد فيها. وللقيام بذلك، نحتاج إلى:
- إزالة الكيان نفسه
- تحديث أي خصائص لكيانات أخرى تشير إليه
- مسح الكيان من فهارسنا
وتُنفَّذ هذه العملية المعروفة بـ«البناء بدون» (construct-without) في الدالة remove-entity، التي تبدو مشابهة جدًا لـadd-entity:
(defn remove-entity [db ent-id]
   (let [ent (entity-at db ent-id)
         layer (remove-back-refs db ent-id (last (:layers db)))
         no-ref-layer (update-in layer [:VAET] dissoc ent-id)
         no-ent-layer (assoc no-ref-layer :storage
                                   (drop-entity
                                          (:storage no-ref-layer) ent))
         new-layer (reduce (partial remove-entity-from-index ent)
                                 no-ent-layer (indexes))]
     (assoc db :layers (conj  (:layers db) new-layer))))
ويتم إزالة المراجع بالدالة remove-back-refs:
(defn- remove-back-refs [db e-id layer]
   (let [reffing-datoms (reffing-to e-id layer)
         remove-fn (fn[d [e a]] (update-entity db e a e-id :db/remove))
         clean-db (reduce remove-fn db reffing-datoms)]
     (last (:layers clean-db))))
نبدأ باستخدام reffing-datoms-to للعثور على جميع الكيانات التي تشير إلينا في الطبقة المعطاة؛ وهي تُعيد تسلسلًا من الثلاثيات التي تحتوي معرّف الكيان المُشير، فضلًا عن اسم الخاصية ومعرّف الكيان المُزال.
(defn- reffing-to [e-id layer]
   (let [vaet (:VAET layer)]
         (for [[attr-name reffing-set] (e-id vaet)
               reffing reffing-set]
              [reffing attr-name])))
ثم نطبّق update-entity على كل ثلاثية لتحديث الخصائص التي تشير إلى كياننا المُزال. (وسنستكشف كيف تعمل update-entity في القسم التالي.)
والخطوة الأخيرة في remove-back-refs هي مسح المرجع نفسه من فهارسنا، وتحديدًا من فهرس VAET، لأنه الفهرس الوحيد الذي يخزّن معلومات المراجع.
تحديث كيان
جوهر التحديث هو تعديل قيمة خاصية كيان. وعملية التعديل نفسها تعتمد على cardinality الخاصية: فالخاصية التي cardinality لها هو :db/multiple تحمل مجموعة قيم، لذا يجب أن نسمح بإضافة عناصر إلى هذه المجموعة أو إزالتها منها أو استبدال المجموعة بالكامل. أما الخاصية التي cardinality لها هو :db/single فتحمل قيمة واحدة، ولا تسمح إلا بالاستبدال.
وبما لدينا أيضًا فهارس توفّر عمليات بحث مباشرة على الخصائص وقيمها، فإن هذه الفهارس يتعيّن تحديثها هي أيضًا.
وكما في add-entity وremove-entity، فنحن لن نعدّل كياننا في مكانه في الواقع، بل سنضيف طبقة جديدة تحتوي على الكيان المحدَّث.
(defn update-entity
   ([db ent-id attr-name new-val]
    (update-entity db ent-id attr-name new-val :db/reset-to))
   ([db ent-id attr-name new-val operation]
      (let [update-ts (next-ts db)
            layer (last (:layers db))
            attr (attr-at db ent-id attr-name)
            updated-attr (update-attr attr new-val update-ts operation)
            fully-updated-layer (update-layer layer ent-id
                                              attr updated-attr
                                              new-val operation)]
        (update-in db [:layers] conj fully-updated-layer))))
ولتحديث خاصية، فإننا نحدّدها بـattr-at ثم نستخدم update-attr لإجراء التحديث الفعلي.
(defn- update-attr [attr new-val new-ts operation]
    {:pre  [(if (single? attr)
            (contains? #{:db/reset-to :db/remove} operation)
            (contains? #{:db/reset-to :db/add :db/remove} operation))]}
    (-> attr
       (update-attr-modification-time new-ts)
       (update-attr-value new-val operation)))
ونستخدم دالتي مساعدة لإجراء التحديث. فالدالة update-attr-modification-time تحدّث الأختام الزمنية لتعكس نشأة الأسهم السوداء في الشكل 1:
(defn- update-attr-modification-time
  [attr new-ts]
       (assoc attr :ts new-ts :prev-ts (:ts attr)))
والدالة update-attr-value تحدّث القيمة فعليًا:
(defn- update-attr-value [attr value operation]
   (cond
      (single? attr)    (assoc attr :value #{value})
      ; now we're talking about an attribute of multiple values
      (= :db/reset-to operation)
        (assoc attr :value value)
      (= :db/add operation)
        (assoc attr :value (CS/union (:value attr) value))
      (= :db/remove operation)
        (assoc attr :value (CS/difference (:value attr) value))))
ولم يبقَ سوى إزالة القيمة القديمة من الفهارس وإضافة القيمة الجديدة إليها، ثم بناء الطبقة الجديدة بجميع مكوّناتنا المحدَّثة. ولحسن الحظ، يمكننا الاستفادة من الشيفرة التي كتبناها لإضافة الكيانات وإزالتها للقيام بذلك.
المعاملات
كل عملية في واجهتنا البرمجية منخفضة المستوى تعمل على كيان واحد. غير أن كل قاعدة بيانات تقريبًا توفّر للمستخدمين وسيلة لتنفيذ عمليات متعددة بوصفها معاملة واحدة (transaction). وهذا يعني:
- تُنظر حزمة العمليات على أنها عملية ذرّية واحدة، بحيث تنجح جميع العمليات معًا أو تفشل جميعها معًا.
- تكون قاعدة البيانات في حالة صالحة قبل المعاملة وبعدها.
- تبدو حزمة التحديثات معزولة (isolated)؛ فلا ينبغي أن يرى أي استعلام آخر حالة قاعدة بيانات لم تُطبَّق فيها سوى بعض العمليات.
يمكننا استيفاء هذه المتطلبات عبر واجهة تستهلك قاعدة بيانات ومجموعة عمليات يُنظر إليها، وتُنتج قاعدة بيانات تعكس التغييرات المعطاة. وينبغي تطبيق جميع التغييرات المقدَّمة في الحزمة عبر إضافة طبقة واحدة. لكن لدينا مشكلة: جميع الدوال التي كتبناها في واجهتنا البرمجية منخفضة المستوى تضيف طبقة جديدة إلى قاعدة البيانات. فلو نفّذنا حزمة بـ عمليات، ل رأينا طبقة جديدة تُضاف، بينما ما نريده حقًا هو طبقة جديدة واحدة بالضبط.
المفتاح هنا هو أن الطبقة التي نريدها هي الطبقة العليا (top) التي كان سينتجها تنفيذ تلك التحديثات بالتسلسل. وعليه، فإن الحل هو تنفيذ عمليات المستخدم واحدة تلو الأخرى، كل منها تُنشئ طبقة جديدة. وحين تُنشأ الطبقة الأخيرة، نأخذ تلك الطبقة العليا فحسب ونضعها على قاعدة البيانات الأولية (مع ترك كل الطبقات الوسيطة تشتاق إلى الفيوردات). ولن نحدّث الطابع الزمني لقاعدة البيانات إلا بعد أن نكون قد أنهينا كل هذا.
ويجري كل هذا في الدالة transact-on-db، التي تتلقّى القيمة الأولية لقاعدة البيانات وحزمة العمليات المراد تنفيذها، وتُعيد قيمتها المحدَّثة.
(defn transact-on-db [initial-db ops]
    (loop [[op & rst-ops] ops transacted initial-db]
      (if op
          (recur rst-ops (apply (first op) transacted (rest op)))
          (let [initial-layer  (:layers initial-db)
                new-layer (last (:layers transacted))]
            (assoc initial-db :layers (conj initial-layer new-layer)
                              :curr-time (next-ts initial-db)
                              :top-id (:top-id transacted))))))
ولاحظ أننا استخدمنا هنا مصطلح القيمة، ما يعني أن المُطالِع على هذه الدالة وحده هو من يرى الحالة المحدَّثة؛ أما جميع المستخدمين الآخرين لقاعدة البيانات فلا يعلمون بهذا التغيير (لأن قاعدة البيانات قيمة، وبالتالي لا يمكن أن تتغير).
ولكي نحصل على نظام يستطيع فيه المستخدمون رؤية تغييرات الحالة التي أجراها الآخرون، لا يتفاعل المستخدمون مع قاعدة البيانات مباشرة، بل يشيران إليها عبر مستوى آخر من التوجيه (indirection). وهذا المستوى الإضافي مُنفَّذ باستخدام Atom في Clojure، وهو نوع مرجعي. وهنا نستفيد من ثلاث صفات رئيسية لـAtom، وهي:
- إنه يشير إلى قيمة.
- من الممكن تحديث الإشارة التي يشير إليها
Atomإلى قيمة أخرى بتنفيذ معاملة (باستخدام قدرات الذاكرة المعاملات البرمجية في Clojure). تقبل المعاملةAtomودالة. وتعمل هذه الدالة على قيمةAtomوتُعيد قيمة جديدة. وبعد تنفيذ المعاملة، يشيرAtomإلى القيمة التي أُعيدت من الدالة. - والوصول إلى القيمة التي يشير إليها
Atomيتم عبر فكّ الإشارة إليها (dereferencing)، وهو ما يُعيد حالة ذلكAtomفي ذلك الوقت.
وبين Atom في Clojure والعمل المنفَّذ في transact-on-db، ما زال ثمة فجوة يتعيّب ردمها؛ وتحديدًا استدعاء المعاملة بالمدخلات الصحيحة.
ولكي نحصل على أبسط ووضوح واجهات برمجية، نودّ أن يقدّم المستخدمون ببساطة Atom وقائمة العمليات، وتقوم قاعدة البيانات بتحويل مُدخَل المستخدم إلى معاملة سليمة.
ويحدث هذا التحويل في سلسلة استدعاءات المعاملة التالية:
transact → _transact → swap! → transact-on-db
يستدعي المستخدمون transact مع Atom (أي الاتصال) والعمليات المراد تنفيذها، وهي تبدّل مُدخلها إلى _transact، مُضافةً إليها اسم الدالة التي تحدّث Atom وهي swap!.
(defmacro transact [db-conn & txs] `(_transact ~db-conn swap! ~@txs))
وتُهيّئ _transact الاستدعاء إلى swap!. وتفعل ذلك بإنشاء قائمة تبدأ بـswap!، يليها Atom، ثم الرمز transact-on-db وحزمة العمليات.
(defmacro  _transact [db op & txs]
   (when txs
     (loop [[frst-tx# & rst-tx#] txs  res#  [op db `transact-on-db]  accum-txs# []]
       (if frst-tx#
           (recur rst-tx# res#  (conj  accum-txs#  (vec frst-tx#)))
           (list* (conj res#  accum-txs#))))))
يستدعي swap! الدالة transact-on-db داخل معاملة (بالمدخلات المُهيّأة سابقًا)، وتُنشئ transact-on-db الحالة الجديدة لقاعدة البيانات وتُعيدها.
وفي هذه المرحلة يمكننا أن نرى أنه بتعديلات طفيفة قليلة يمكننا أيضًا توفير وسيلة لطرح أسئلة «ماذا لو». ويمكن أن يتم ذلك باستبدال swap! بدالة لا تُحدث أي تغيير في النظام. وهذا السيناريو مُنفَّذ بسلسلة استدعاءات what-if:
what-if _transact _what-if transact-on-db
يستدعي المستخدم what-if مع قيمة قاعدة البيانات والعمليات المراد تنفيذها. ثم يبدّل هذه المدخلات إلى _transact، مُضيفًا إليها دالة تحاكي واجهات swap! دون أثرها (المسماة _what-if).
(defmacro what-if [db & ops] `(_transact ~db _what-if ~@ops))
وتُهيّئ _transact الاستدعاء إلى _what-if. وتفعل ذلك بإنشاء قائمة تبدأ بـ_what-if، يليها قاعدة البيانات، ثم الرمز transact-on-db وحزمة العمليات. وتستدعي _what-if الدالة transact-on-db، تمامًا كما يفعل swap! في سيناريو المعاملة، لكنها لا تُلحق أي تغيير بالنظام.
(defn- _what-if [db f txs] (f db txs))
ولاحظ أننا لا نستخدم دوال بل ماكروهات. وسبب استخدامنا للماكروهات هنا هو أن وسائط الماكرو لا تُقيَّم عندحدوث الاستدعاء؛ وهذا يتيح لنا تقديم تصميم واجهة أنظف يقدّم فيه المستخدم العمليات مُنظَّمة بالطريقة نفسها التي يُنظَّم بها أي استدعاء دالة في Clojure.
ويمكن رؤية العملية أعلاه في الأمثلة التالية. بالنسبة إلى المعاملة، يكون استدعاء المستخدم:
(transact db-conn (add-entity e1) (update-entity e2 atr2 val2 :db/add))
يتحوّل إلى:
(_transact db-conn swap! (add-entity e1) (update-entity e2 atr2 val2 :db/add))
والذي يصبح:
(swap! db-conn transact-on-db [[add-entity e1][update-entity e2 atr2 val2 :db/add]])
وبالنسبة إلى what-if، يكون استدعاء المستخدم:
(what-if my-db (add-entity e3) (remove-entity e4))
يتحوّل إلى:
(_transact my-db _what-if (add-entity e3) (remove-entity e4))
ثم:
(_what-if my-db transact-on-db [[add-entity e3] [remove-entity e4]])
وفي النهاية:
(transact-on-db my-db [[add-entity e3] [remove-entity e4]])
استخراج الرؤى في هيئة مكتبات
أصبح لدينا الآن الوظيفة الأساسية لقاعدة البيانات في مكانها، وحان الوقت لإضافة سبب وجودها (raison d’être): استخراج الرؤى. والمقاربة المعمارية التي استخدمناها هنا هي السماح بإضافة هذه القدرات بوصفها مكتبات، لأن مختلف استعمالات قاعدة البيانات ستحتاج آليات مختلفة من هذا النوع.
اجتياز الرسوم البيانية
يُنشأ اتصال مرجعي بين الكيانات عندما يكون نوع خاصية كيان ما هو :db/ref، أي أن قيمة تلك الخاصية هي معرّف كيان آخر. وحين يُضاف كيان مُشير إلى قاعدة البيانات، تُفهرس المرجع في فهرس VAET.
ويمكن الاستفادة من المعلومات الموجودة في فهرس VAET لاستخراج جميع الروابط الداخلة إلى كيان. ويتم ذلك في الدالة incoming-refs، التي تجمع كل الأوراق التي يمكن بلوغها من الكيان عند ذلك الفهرس:
(defn incoming-refs [db ts ent-id & ref-names]
   (let [vaet (indx-at db :VAET ts)
         all-attr-map (vaet ent-id)
         filtered-map (if ref-names
                          (select-keys ref-names all-attr-map)
                          all-attr-map)]
      (reduce into #{} (vals filtered-map))))
ويمكننا أيضًا المرور على جميع خصائص كيان معطى وجمع كل قيم الخصائص من نوع :db/ref، وبذلك نستخرج كل المراجع الخارجة من ذلك الكيان. ويقوم بذلك الدالة outgoing-refs.
(defn outgoing-refs [db ts ent-id & ref-names]
   (let [val-filter-fn (if ref-names #(vals (select-keys ref-names %)) vals)]
   (if-not ent-id []
     (->> (entity-at db ts ent-id)
          (:attrs) (val-filter-fn) (filter ref?) (mapcat :value)))))
تعمل هاتان الدالتان بوصفهما اللبنتين الأساسيتين لأي عملية اجتياز في الرسوم البيانية، لأنهما اللتان ترفعان مستوى التجريد من الكيانات والخصائص إلى العقد والوصلات في رسم بياني. وبمجرد أن نتمكّن من النظر إلى قاعدة بياناتنا بوصفها رسمًا بيانيًا، يمكننا أن نقدّم واجهات برمجية متنوّعة لاجتياز الرسوم البيانية والاستعلام عنها. ونترك هذا تمرينًا محلولًا للقارئ؛ ويمكن العثور على أحد الحلول في شيفرة مصدر الفصل (انظر graph.clj).
الاستعلام عن قاعدة البيانات
توفّر المكتبة الثانية التي نقدّمها قدرات الاستعلام، وهي الرئيسي اهتمام هذا القسم. ولا تقل قاعدة البيانات نفعًا لمستخدميها كثيرًا من دون آلية استعلام قوية. وعادة ما تُتاح هذه الميزة للمستخدمين عبر لغة استعلام (query language) تُستخدم لتحديد مجموعة البيانات محل الاهتمام تصريحيًا.
يعتمد نموذج بياناتنا على تراكم الحقائق (أي الـdatoms) عبر الزمن. وبالنسبة لهذا النموذج، فإن المكان الطبيعي للبحث عن لغة الاستعلام الملائمة هو البرمجة المنطقية (logic programming). ومن لغات الاستعلام الشائعة التي تأثرت بالبرمجة المنطقية لغة Datalog التي، إضافة إلى ملاءمتها لنموذج بياناتنا، لديها تكيف أنيق جدًا مع صياغة Clojure. وستنفّذ محرّك الاستعلام لدينا مجموعة فرعية من لغة Datalog من قاعدة بيانات Datomic.
لغة الاستعلام
لننظر في مثال استعلام بلغتنا المقترحة. هذا الاستعلام يسأل: «ما أسماء الكيانات وتواريخ ميلادها التي تحب البيتزا وتتحدث الإنجليزية ولديها عيد ميلاد في هذا الشهر؟»
{  :find [?nm ?bd ]
   :where [
      [?e  :likes "pizza"]
      [?e  :name  ?nm]
      [?e  :speak "English"]
      [?e  :bday (bday-mo? ?bd)]]}
الصياغة
نستخدم صياغة البيانات الحرفية في Clojure مباشرة لتوفير الصياغة الأساسية لاستعلاماتنا. وهذا يتيح لنا تفادي الحاجة إلى كتابة محلّل (parser) متخصص، مع الاستمرار في توفير صورة مألوفة وسهلة القراءة للمبرمجين المعتادين على Clojure.
والاستعلام خريطة بعنصرين:
- عنصر المفتاح فيه
:whereوالقيمة قاعدة (rule). والقاعدة متجه من جُمل (clauses)، والجملة متجه مكوّن من ثلاثة مسندات (predicates)، كل مسند يعمل على مكوّن مختلف من الـdatom. وفي المثال أعلاه،[?e :likes "pizza"]هي جملة. ويعرّف عنصر:whereهذه قاعدة تؤدّي دور مُرشِّح على الـdatoms في قاعدة بياناتنا (مثل بندWHEREفي SQL.) - عنصر المفتاح فيه
:findوالقيمة متجه. ويحدّد المتجه مكوّنات الـdatom المختار التي ينبغي إسقاطها (project) في النتائج (مثل بندSELECTفي SQL.)
ويُغفل الوصف أعلاه متطلبًا بالغ الأهمية: كيفية جعل الجمل المختلفة متزامنة على قيمة (أي تنفيذ عملية دمج join بينها)، وكيفية تنظيم القيم الموجودة في المخرجات (المحدَّد في جزء :find).
ونستوفي كلا المتطلبين باستخدام المتغيرات (variables) التي تُدوَّن بعلامة ? في بدايتها. والاستثناء الوحيد لهذا التعريف هو المتغير «لا يهم» _ (شرطة سفلية).
والجملة في الاستعلام مكوَّنة من ثلاثة مسندات؛ ويحدّد \aosatblref{500l.functionaldb.predicates} ما يمكن أن يكون مسندًا في لغتنا للاستعلام.
| الاسم | المعنى | مثال |
| ثابت | هل قيمة العنصر في الـdatom مساوية للثابت؟ | :likes |
| متغير | اربط قيمة العنصر في الـdatom بالمتغير وأعد true. | ?e |
| لا يهم | يُعيد true دائمًا. | _ |
| عامل أحادي | عملية أحادية تأخذ متغيرًا كoperand لها. اربط قيمة عنصر الـdatom بالمتغير (ما لم يكن '_'). استبدل المتغير بقيمة العنصر في الـdatom. أعد نتيجة تطبيق العملية. |
(bday-mo? _) |
| عامل ثنائي | عملية ثنائية يجب أن يكون أحد operands لها متغيرًا. اربط قيمة عنصر الـdatom بالمتغير (ما لم يكن '_'). استبدل المتغير بقيمة العنصر في الـdatom. أعد نتيجة العملية. |
(> ?age 20) |
قيود لغتنا للاستعلام
الهندسة كلها تدور حول إدارة المفاضلات، وتصميم محرّك الاستعلام لدينا لا استثناء. وفي حالتنا، المفاضلة الرئيسة التي يجب أن نعالجها هي غنى الميزات مقابل التعقيد. ويقتضي حسم هذه المفاضلة النظر في حالات الاستخدام الشائعة للنظام، ومن ثم تقرير ما إذا كانت القيود مقبولة.
وفي قاعدة بياناتنا، قررنا بناء محرّك استعلام القيود التالية:
- لا يستطيع المستخدمون تعريف عمليات منطقية بين الجمل؛ فهي تُدمج دائمًا معًا بـ«AND». (ويمكن تجاوز ذلك باستخدام مسندات أحادية أو ثنائية.)
- إذا كان في الاستعلام أكثر من جملة، فيجب أن يوجد متغير واحد يوجد في كل جمل ذلك الاستعلام. وهذا المتغير يؤدّي دور متغير الدمج. وهذا القيد يُبسّط محسّن الاستعلام.
- لا يُنفَّذ الاستعلام إلا على قاعدة بيانات واحدة.
ولرغم أن قرارات التصميم هذه تُنتج لغة استعلام أقل ثراءً من Datalog، إلا أننا ما زلنا قادرين على دعم أنواع كثيرة من الاستعلامات البسيطة والمفيدة.
تصميم محرّك الاستعلام
بينما تتيح لغتنا للمستخدم تحديد ماذا يريد الوصول إليه، فإنها تخفي تفاصيل كيف سيتحقق ذلك. ومحرّك الاستعلام هو مكوّن قاعدة البيانات المسؤول عن تقديم البيانات لاستعلام معطى.
وهذا ينطوي على أربع خطوات:
- التحويل إلى تمثيل داخلي: تحويل الاستعلام من صيغته النصية إلى بنية بيانات يستهلكها مخطّط الاستعلام.
- بناء خطة استعلام: تحديد خطة (plan) فعّالة لتقديم نتائج الاستعلام المعطى. وفي حالتنا، خطة الاستعلام هي دالة يُستدعى تنفيذها.
- تنفيذ الخطة: تنفيذ الخطة وإرسال نتائجها إلى المرحلة التالية.
- التوحيد والإبلاغ: استخراج النتائج التي يلزم الإبلاغ عنها فقط وتنسيقها على النحو المحدَّد.
المرحلة 1: التحويل
في هذه المرحلة، نحوّل الاستعلام المعطى من تمثيل يسهل على المستخدم فهمه إلى تمثيل يمكن لمخطّط الاستعلام استهلاكه بكفاءة.
ويُحوَّل جزء :find من الاستعلام إلى مجموعة من أسماء المتغيرات المعطاة:
(defmacro symbol-col-to-set [coll] (set (map str coll)))
ويحتفظ جزء :where من الاستعلام ببنيته المتداخلة من المتجهات. غير أن كل حد من حدود كل جملة يُستبدل بمسند وفقًا لـ\aosatblref{500l.functionaldb.predicates}.
(defmacro clause-term-expr [clause-term]
   (cond
    (variable? (str clause-term)) ;variable
      #(= % %)
    (not (coll? clause-term)) ;constant
      `#(= % ~clause-term)
    (= 2 (count clause-term)) ;unary operator
      `#(~(first clause-term) %)
    (variable? (str (second clause-term)));binary operator, 1st operand is variable
      `#(~(first clause-term) % ~(last clause-term))
    (variable? (str (last clause-term)));binary operator, 2nd operand is variable
      `#(~(first clause-term) ~(second clause-term) %)))
ولكل جملة، يُضبط متجه بأسماء المتغيرات المستخدمة في تلك الجملة كبيانات وصفية له.
(defmacro clause-term-meta [clause-term]
   (cond
   (coll? clause-term)  (first (filter #(variable? % false) (map str clause-term)))
   (variable? (str clause-term) false) (str clause-term)
   :no-variable-in-clause nil))
ونستخدم pred-clause للتمرير على الحدود في كل جملة:
(defmacro pred-clause [clause]
   (loop [[trm# & rst-trm#] clause exprs# [] metas# []]
     (if  trm#
          (recur rst-trm# (conj exprs# `(clause-term-expr ~ trm#))
                       (conj metas#`(clause-term-meta ~ trm#)))
          (with-meta exprs# {:db/variable metas#}))))
أما التمرير على الجمل نفسها فيتم في q-clauses-to-pred-clauses:
(defmacro  q-clauses-to-pred-clauses [clauses]
     (loop [[frst# & rst#] clauses preds-vecs# []]
       (if-not frst#  preds-vecs#
         (recur rst# `(conj ~preds-vecs# (pred-clause ~frst#))))))
ونحن نعتمد مرة أخرى على حقيقة أن الماكروهات لا تقيّم وسائطها بدفّة. وهذا يتيح لنا تعريف واجهة أبسط يقدّم فيها المستخدمون أسماء المتغيرات كرموز (مثل ?name) بدلاً من مطالبة المستخدم بفهم تفاصيل المحرّك عبر تقديم أسماء المتغيرات كنصوص (مثل "?name")، أو الأسوأ من ذلك، اقتباس اسم المتغير (مثل '?name).
وفي نهاية هذه المرحلة، يُنتج مثالنا المجموعة التالية لجزء :find:
#{"?nm" "?bd"}
والبنية التالية في \aosatblref{500l.functionaldb.clauses} لجزء :where. (كل خلية في عمود Predicate Clause تحمل البيانات الوصفية الموجودة في جارتها في عمود Meta Clause.)
| جملة الاستعلام | جملة المسند | جملة البيانات الوصفية |
| [?e :likes "pizza"] | [#(= % %) #(= % :likes) #(= % "pizza")] | ["?e" nil nil] |
| [?e :name ?nm] | [#(= % %) #(= % :name) #(= % %)] | ["?e" nil "?nm"] |
| [?e :speak "English"] | [#(= % %) #(= % :speak) #(= % "English")] | ["?e" nil nil] |
| [?e :bday (bday-mo? ?bd)] | [#(= % %) #(= % :bday) #(bday-mo? %)] | ["?e" nil "?bd"] |
وتعمل هذه البنية بوصفها الاستعلام الذي يُنفَّذ في مرحلة لاحقة، بمجرد أن يقرر المحرّك خطة التنفيذ المناسبة.
المرحلة 2: وضع الخطة
في هذه المرحلة، نفحص الاستعلام من أجل بناء خطة جيدة تنتج النتيجة التي يصفها.
عمومًا، سيتضمن هذا اختيار الفهرس المناسب (\aosatblref{500l.functionaldb.indexselection}) وبناء خطة على هيئة دالة. ونختار الفهرس استنادًا إلى متغير الدمج الوحيد (الذي يمكن أن يعمل على نوع واحد فقط من العناصر).
| متغير الدمج يعمل على | الفهرس الذي يُستخدم |
| معرّفات الكيانات | AVET |
| أسماء الخصائص | VEAT |
| قيم الخصائص | EAVT |
وسيصبح الاستدلال وراء هذه المطابقة أوضح في القسم التالي، حين ننفّذ بالفعل الخطةَ التي تنتجها. أما الآن فملاحظة فقط أن المفتاح هنا هو اختيار فهرس تحمل أوراقه العناصر التي يعمل عليها متغير الدمج.
ويتم تحديد فهرس متغير الدمج بالدالة index-of-joining-variable:
(defn index-of-joining-variable [query-clauses]
   (let [metas-seq  (map #(:db/variable (meta %)) query-clauses)
         collapsing-fn (fn [accV v] (map #(when (= %1 %2) %1)  accV v))
         collapsed (reduce collapsing-fn metas-seq)]
     (first (keep-indexed #(when (variable? %2 false) %1)  collapsed))))
نبدأ باستخراج البيانات الوصفية لكل جملة في الاستعلام. وهذه البيانات الوصفية المستخرجة متجه من ثلاثة عناصر؛ كل عنصر إما اسم متغير أو nil. (ولاحظ أنه لا يوجد أكثر من اسم متغير واحد في ذلك المتجه.) وبمجرد استخراج المتجه، ننتج منه (بتطبيق reduce عليه) قيمة واحدة، تكون إما اسم متغير أو nil. فإذا أُنتج اسم متغير، فإنه كان موجودًا في جميع متجهات البيانات الوصفية عند الفهرس نفسه؛ أي أن هذا هو متغير الدمج. ومن ثم يمكننا أن نختار استخدام الفهرس ذي الصلة بهذا متغير الدمج بناءً على المطابقة الموصوفة أعلاه.
وبمجرد اختيار الفهرس، نبني خطتنا، وهي دالة تُغلق على الاستعلام واسم الفهرس وتنفّذ العمليات اللازمة لإعادة نتائج الاستعلام.
(defn build-query-plan [query]
   (let [term-ind (index-of-joining-variable query)
         ind-to-use (case term-ind 0 :AVET 1 :VEAT 2 :EAVT)]
      (partial single-index-query-plan query ind-to-use)))
وفي مثالنا فإن الفهرس المختار هو فهرس AVET، لأن متغير الدمج يعمل على معرّفات الكيانات.
المرحلة 3: تنفيذ الخطة
رأينا في المرحلة السابقة أن خطة الاستعلام لدينا تنتهي باستدعاء single-index-query-plan. وهذه الدالة ستقوم بـ:
- تطبيق كل جملة مسند على فهرس (كل مسند على مستوى الفهرس المناسب له).
- تنفيذ عملية AND على النتائج.
- دمج النتائج في بنية بيانات أبسط.
(defn single-index-query-plan [query indx db]
   (let [q-res (query-index (indx-at db indx) query)]
     (bind-variables-to-query q-res (indx-at db indx))))
ولشرح هذه العملية على نحو أفضل، سنعرضها باستخدام استعلامنا النموذجي، مع افتراض أن قاعدة بياناتنا تحتوي على الكيانات الواردة في \aosatblref{500l.functionaldb.exampleentities}.
| معرّف الكيان | اسم الخاصية | قيمة الخاصية |
| 1 | :name :likes :speak :bday | USA Pizza English July 4, 1776 |
| 2 | :name :likes :speak :bday | France Red wine French July 14, 1789 |
| 3 | :name :likes :speak :bday | Canada Snow English July 1, 1867 |
والآن حان وقت التعمق في ثقب الأرنب والنظر إلى الدالة query-index، حيث يبدأ استعلامنا أخيرًا فيإbibsr بعض النتائج:
(defn query-index [index pred-clauses]
   (let [result-clauses (filter-index index pred-clauses)
         relevant-items (items-that-answer-all-conditions (map last result-clauses)
                                                          (count pred-clauses))
         cleaned-result-clauses (map (partial mask-path-leaf-with-items
                                              relevant-items)
                                     result-clauses)]
     (filter #(not-empty (last %)) cleaned-result-clauses)))
تبدأ هذه الدالة بتطبيق جمل المسندات على الفهرس المختار سابقًا. وكل تطبيق لجملة مسند على فهرس يُعيد جملة نتيجة (result clause).
أما الخصائص الرئيسية للنتيجة فهي:
- إنها مبنية من ثلاثة عناصر، كل عنصر من مستوى مختلف من الفهرس، وقد اجتاز كلٌّ منها مسنده المقابل.
- يطابق ترتيب العناصر بنية مستويات الفهرس. (جمل المسندات دائمًا بترتيب EAV.) ويجري إعادة الترتيب عند تطبيق
from-eavالخاص بالفهرس على جملة المسند. - البيانات الوصفية لجملة المسند مُرفقة بها.
ويجري كل هذا في الدالة filter-index.
(defn filter-index [index predicate-clauses]
   (for [pred-clause predicate-clauses
         :let [[lvl1-prd lvl2-prd lvl3-prd] (apply (from-eav index) pred-clause)]
         [k1 l2map] index  ; keys and values of the first level
         :when (try (lvl1-prd k1) (catch Exception e false))
         [k2  l3-set] l2map  ; keys and values of the second level
         :when (try (lvl2-prd k2) (catch Exception e false))
         :let [res (set (filter lvl3-prd l3-set))] ]
     (with-meta [k1 k2 res] (meta pred-clause))))
وبافتراض أن الاستعلام نُفِّذ في الرابع من يوليو، فإن نتائج تنفيذه على البيانات أعلاه مبيَّنة في \aosatblref{500l.functionaldb.queryresults}.
| جملة النتيجة | بيانات النتيجة الوصفية |
| [:likes Pizza #{1}] | ["?e" nil nil] |
| [:name USA #{1}] | ["?e" nil "?nm"] |
| [:speak "English" #{1, 3}] | ["?e" nil nil] |
| [:bday "July 4, 1776" #{1}] | ["?e" nil "?bd"] |
| [:name France #{2}] | ["?e" nil "?nm"] |
| [:bday "July 14, 1789" #{2}] | ["?e" nil "?bd"] |
| [:name Canada #{3}] | ["?e" nil "?nm"] |
| [:bday "July 1, 1867" {3}] | ["?e" nil "?bd"] |
وبمجرد أن ننتج جميع جمل النتائج، نحتاج إلى تنفيذ عملية AND بينها. ويتم ذلك بالعثور على جميع العناصر التي اجتازت كل جمل المسندات:
(defn items-that-answer-all-conditions [items-seq num-of-conditions]
   (->> items-seq ; take the items-seq
         (map vec) ; make each collection (actually a set) into a vector
         (reduce into []) ;reduce all the vectors into one vector
         (frequencies) ;count for each item in how many collections (sets) it was in
         (filter #(<= num-of-conditions (last %))) ;items that answered all conditions
         (map first) ; take from the duos the items themselves
         (set))) ; return it as set
وفي مثالنا، تكون نتيجة هذه الخطوة مجموعةً تحمل القيمة 1 (وهي معرّف الكيان USA).
والآن علينا إزالة العناصر التي لم تجتز كل الشروط:
(defn mask-path-leaf-with-items [relevant-items path]
     (update-in path [2] CS/intersection relevant-items))
وأخيرًا، نزيل جميع جمل النتائج التي «فارغة» (أي أن عنصرها الأخير فارغ). ونفعل ذلك في السطر الأخير من الدالة query-index. ويترك لنا مثالنا بالعناصر الواردة في \aosatblref{500l.functionaldb.filteredqueryresults}.
| جملة النتيجة | بيانات النتيجة الوصفية |
| [:likes Pizza #{1}] | ["?e" nil nil] |
| [:name USA #{1}] | ["?e" nil "?nm"] |
| [:bday "July 4, 1776" #{1}] | ["?e" nil "?bd"] |
| [:speak "English" #{1}] | ["?e" nil nil] |
ونحن الآن مستعدون للإبلاغ عن النتائج. وبنية جملة النتيجة مرهقة لهذا الغرض، لذا سنحوّلها إلى بنية شبيهة بالفهرس (خريطة من خرائط)—مع فرق جوهري.
لفهم هذا الفرق، علينا أولًا تقديم فكرة زوج الربط (binding pair)، وهو زوج يطابق اسم متغير بقيمته. واسم المتغير هو الاسم المستخدم في جمل المسندات، والقيمة هي القيمة الموجودة في جمل النتائج.
ويتمثل الفرق في بنية الفهرس في أننا الآن نحمل زوج ربط من معرّف الكيان / اسم الخاصية / القيمة في الموضع الذي كنا نحمل فيه معرّف كيان / اسم خاصية / قيمة في فهرس:
(defn bind-variables-to-query [q-res index]
   (let [seq-res-path (mapcat (partial combine-path-and-meta (from-eav index))
                               q-res)
         res-path (map #(->> %1 (partition 2)(apply (to-eav index))) seq-res-path)]
     (reduce #(assoc-in %1  (butlast %2) (last %2)) {} res-path)))

(defn combine-path-and-meta [from-eav-fn path]
    (let [expanded-path [(repeat (first path)) (repeat (second path)) (last path)]
          meta-of-path (apply from-eav-fn (map repeat (:db/variable (meta path))))
          combined-data-and-meta-path (interleave meta-of-path expanded-path)]
       (apply (partial map vector) combined-data-and-meta-path)))
وفي نهاية المرحلة 3 من مثالنا التنفيذي، لدينا البنية التالية في المتناول:
{[1 "?e"]{
	{[:likes nil]    ["Pizza" nil]}
	{[:name nil]     ["USA" "?nm"]}
	{[:speaks nil]   ["English" nil]}
	{[:bday nil] ["July 4, 1776" "?bd"]}
}}
المرحلة 4: التوحيد والإبلاغ
في هذه النقطة، أنتجنا مجموعةً فوقية من النتائج التي طلبها المستخدم في الأصل. وفي هذه المرحلة سنستخرج القيم التي يريدها المستخدم. وتُسمى هذه العملية التوحيد (unification): وهنا سنوحّد بنية أزواج الربط مع متجه أسماء المتغيرات التي عرّفها المستخدم في بند :find من الاستعلام.
(defn unify [binded-res-col needed-vars]
   (map (partial locate-vars-in-query-res needed-vars) binded-res-col))
وتُعالَج كل خطوة توحيد بواسطة الدالة locate-vars-in-query-result، التي تمر على نتيجة استعلام (مُنظَّمة كمدخل فهرس، لكن بأزواج ربط) لكشف جميع المتغيرات والقيم التي طلبها المستخدم.
(defn locate-vars-in-query-res [vars-set q-res]
   (let [[e-pair av-map]  q-res
         e-res (resultify-bind-pair vars-set [] e-pair)]
     (map (partial resultify-av-pair vars-set e-res)  av-map)))

(defn resultify-bind-pair [vars-set accum pair]
   (let [[ var-name _] pair]
      (if (contains? vars-set var-name) (conj accum pair) accum)))

(defn resultify-av-pair [vars-set accum-res av-pair]
   (reduce (partial resultify-bind-pair vars-set) accum-res av-pair))
وفي نهاية هذه المرحلة، تكون نتائج مثالنا هي:
[("?nm" "USA") ("?bd" "July 4, 1776")]
تشغيل العرض
لقد بنينا أخيرًا جميع المكوّنات التي نحتاجها لآلية الاستعلام التي تواجه المستخدم، وهي الماكرو q التي تتلقّى كوسيطين قاعدة بيانات واستعلام.
(defmacro q
  [db query]
  `(let [pred-clauses#  (q-clauses-to-pred-clauses ~(:where query))
         needed-vars# (symbol-col-to-set  ~(:find query))
         query-plan# (build-query-plan pred-clauses#)
         query-internal-res# (query-plan# ~db)]
     (unify query-internal-res# needed-vars#)))
الخلاصة
بدأت رحلتنا بتصور نوع مختلف من قواعد البيانات، وانتهت بقاعدة بيانات:
- تدعم معاملات ACI (فقد ضاعت الديمومة حين قررنا تخزين البيانات في الذاكرة).
- تدعم تفاعلات «ماذا لو».
- تجيب عن الأسئلة المتعلقة بالزمن.
- تتعامل مع استعلامات datalog بسيطة مُحسَّنة بالفهارس.
- تقدّم واجهات برمجية لاستعلامات الرسوم البيانية.
- تقدّم وتنفّذ فكرة الاستعلامات التطورية.
ولا يزال هناك الكثير مما يمكننا تحسينه: يمكننا إضافة تخزين مؤقت (caching) إلى عدة مكوّنات لتحسين الأداء؛ ودعم استعلامات أغنى؛ وإضافة دعم تخزين حقيقي لتوفير ديمومة البيانات، لتذكر بعض الأمور.
غير أن منتجنا النهائي يستطيع أن يفعل أشياء كثيرة جدًا، وقد نُفِّذ في 488 سطرًا من شيفرة Clojure المصدرية، منها 73 سطرًا فارغًا و55 سطرًا سلاسل توثيق.
وأخيرًا، هناك أمر واحد لا يزال مفقودًا: اسم. والخيار المعقول الوحيد لقاعدة بيانات وظيفية مخزَّنة في الذاكرة، مُحسَّنة بالفهارس، داعمة للاستعلامات، صديقة لمطوّري المكتبات، واعية بالزمن، منفَّذة في 360 سطرًا من شيفرة Clojure هو CircleDB.