مجدول ورشة التدفق
@الدكتور كريستيان مويزه باحث زميل في مجموعة MERS في مختبر CSAIL بمعهد ماساتشوستس للتكنولوجيا. وهو مهتم بمجموعة متنوعة من المواضيع تشمل الذكاء الاصطناعي، والمشاريع القائمة على البيانات، ورسم الخرائط، ونظرية الرسوم البيانية، وتصور البيانات، وكذلك الموسيقى السلتية، والنحت، وكرة القدم، والقهوة.
مجدول ورشة التدفق
جدولة ورشة التدفق (flow shop scheduling) إحدى أصعب المشكلات وأكثرها دراسةً في بحس العمليات. وكما في كثير من مشكلات التحسين الصعبة، فإن العثور على أفضل حل ببساطة غير ممكن في المشكلات ذات الحجم العملي. وفي هذا الفصل نبحث في تنفيذ حَلّال جدولة ورشة التدفق يستخدم تقنية تُدعى البحث المحلي (local search). يسمح البحث المحلي لنا بالعثور على حل «جيد بما يكفي» حين لا يمكن العثور على أفضل حل. وسيحاول الحَلّال إيجاد حلول جديدة للمشكلة لفترة زمنية محددة، ثم ينتهي بإعادة أفضل حل عثر عليه.
الفكرة الكامنة وراء البحث المحلي هي تحسين حل قائم بشكل استدلالي، بالنظر في حلول مشابهة قد تكون أفضل قليلًا. ويستخدم الحَلّال مجموعة متنوعة من الاستراتيجيات كي (1) يحاول العثور على حلول مشابهة، و(2) يختار حلاً واعدًا باستكشافه تاليًا. وقد كُتب التنفيذ بلغة Python، وليس له أي متطلبات خارجية. ومن خلال الاستفادة من بعض إمكانات Python الأقل شهرة، يغيّر الحَلّال استراتيجية بحثه ديناميكيًا أثناء عملية الحل اعتمادًا على الاستراتيجيات التي تنجح.
سنقدّم أولًا بعض المواد الخلفية عن مشكلة جدولة ورشة التدفق وتقنيات البحث المحلي. ثم ننظر بالتفصيل إلى شيفرة الحَلّال العامة، وإلى مختلف الاستدلالات (heuristics) واستراتيجيات اختيار الجوار التي نستخدمها. بعد ذلك نبحث في الاختيار الديناميكي للاستراتيجية الذي يستخدمه الحَلّال لربط كل ذلك معًا. وأخيرًا، نختم بملخص للمشروع وبعض الدروس المستفادة خلال عملية التنفيذ.
الخلفية
جدولة ورشة التدفق
مشكلة جدولة ورشة التدفق هي مشكلة تحسين نحدّد فيها زمن معالجة المهام المختلفة في عمل ما، من أجل جدولة تلك المهام بحيث نقلّل الزمن الكلي المستغرق في إتمام العمل. لنأخذ مثلًا شركة سيارات ذات خط تجميع، تُنجز فيه كل قطعة من السيارة تباعًا على آلات مختلفة. وقد تكون للطلبات المختلفة متطلبات خاصة، مما يجعل مهمة طلاء الهيكل مثلًا تختلف من سيارة إلى أخرى. وفي مثالنا، كل سيارة هي عمل (job) جديد، وكل قطعة من السيارة تُدعى مهمة (task). وسيكون لكل عمل تسلسل المهام نفسه لإكماله.
الهدف في جدولة ورشة التدفق هو تقليل الزمن الكلي اللازم لمعالجة كل المهام في كل الأعمال حتى إتمامها. (وعادة ما يُشار إلى هذا الزمن الكلي بأنه مدة الإنجاز الكلي (makespan).) وهذه المشكلة لها تطبيقات عديدة، لكنها ترتبط أساسًا بتحسين منشآت الإنتاج.
تتألف كل مشكلة من مسائل ورشة التدفق من آلة و عمل. وفي مثال السيارات لدينا، ستكون هناك محطات للعمل على السيارة و سيارة في الإجمالي. ويتكوّن كل عمل من مهمة بالضبط، ويمكننا أن نفترض أن المهمة رقم من عمل ما يجب أن تستخدم الآلة وتتطلب زمن معالجة محددًا مسبقًا: هو زمن المعالجة للمهمة رقم في العمل . وعلاوة على ذلك، ينبغي أن يتبع ترتيب المهام لأي عملٍ ما ترتيب الآلات المتاحة؛ فبالنسبة إلى عمل ما، يجب أن تُنجز المهمة قبل بدء المهمة . وفي مثال السيارات، لا نريد أن نبدأ طلاء السيارة قبل أن تُجمَّع هيكلها. والقيود الأخير هو أنه لا يمكن معالجة مهمتين على آلة واحدة في الوقت نفسه.
ولأن ترتيب المهام داخل العمل محدد مسبقًا، يمكن تمثيل حل مشكلة جدولة ورشة التدفق على هيئة تبادل (permutation) للأعمال. وسيكون ترتيب الأعمال المعالَجة على أي آلة هو نفسه لكل الآلات، وبالنظر إلى تبادل معيّن، تُجدوَل مهمة الآلة في العمل لتكون الأحدث من الاحتمالين التاليين:
-
إكمال مهمة الآلة في العمل (أي أحدث مهمة على الآلة نفسها)، أو
-
إكمال مهمة الآلة في العمل (أي أحدث مهمة في العمل نفسه)
ولأننا نختار القيمة الكبرى من هاتين القيمتين، سيُنشأ زمن خمول (idle time) للآلة أو للعمل ، أي لأحدهما. وهو هذا الزمن الخامل هو ما نريد في النهاية تقليله، إذ سيؤدي إلى رفع مدة الإنجاز الكلي.
ولأن ترتيب المهام داخل العمل محدد مسبقًا، يمكن تمثيل حل مشكلة جدولة ورشة التدفق على هيئة تبادل (permutation) للأعمال. وسيكون ترتيب الأعمال المعالَجة على أي آلة هو نفسه لكل الآلات، وبالنظر إلى تبادل معيّن، تُجدوَل مهمة الآلة في العمل لتكون الأحدث من الاحتمالين التاليين:
لننظر في مثال بسيط فيه عملان وآلتان. لدى العمل الأول مهمتان و، تستغرقان 1 و2 دقيقة على التوالي لإتمامهما. ولدى العمل الثاني مهمتان و، تستغرقان 2 و1 دقيقة على التوالي. وتذكّر أن يجب أن تأتي قبل وأن يجب أن تأتي قبل . ولأن لدينا عملين، فلدينا تبادلان فقط نأخذهما في الحسبان. إن رتّبنا العمل 2 قبل العمل 1، فإن مدة الإنجاز الكلي 5 (example1)؛ وفي المقابل، إن رتّبنا العمل 1 قبل العمل 2، فإن مدة الإنجاز الكلي 4 فقط (example2).
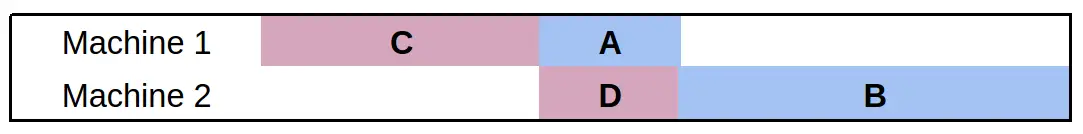
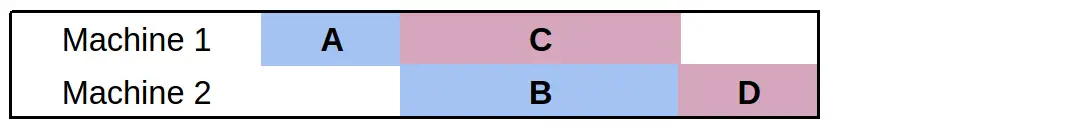
ولاحظ أنه لا توجد مساحة كافية لدفع أي من المهام إلى وقت أبكر. والمبدأ الإرشادي للتبادل الجيد هو تقليل الوقت الذي تبقى فيه أي آلة بلا مهمة تعالجها.
البحث المحلي
البحث المحلي استراتيجية لحل مشكلات التحسين حين يكون حساب الحل الأمثل صعبًا جدًا. ومن الناحية الحدسية، فإنها تنتقل من حل يبدو جيدًا إلى حدٍّ كبير إلى حل يبدو أفضل. وبدلًا من فحص كل حل ممكن بوصفه مرشحًا للتركيز عليه تاليًا، فإننا نعرّف ما يُعرف بـالجوار (neighbourhood): مجموعة الحلول التي نعتبرها مشابهة للحل الحالي. ولأن أي تبادل للأعمال حل صالح، يمكننا أن ننظر إلى أي آلية تُعيد ترتيب الأعمال على أنها إجراء بحث محلي (وهذا في الواقع ما نفعله أدناه).
ولاستخدام البحث المحلي secara رسمية، علينا أن نجيب عن بضعة أسئلة:
- من أي حل ينبغي أن نبدأ؟
- معطى حلٌّ، ما هي الحلول المجاورة التي ينبغي أن نأخذها في الحسبان؟
- معطى مجموعة المرشحين المجاورين، أيّهم ينبغي أن ننتقل إليه تاليًا؟
وتتناول الأقسام الثلاثة التالية هذه الأسئلة بالترتيب.
الحَلّال العام
في هذا القسم نقدّم الإطار العام لمجدول ورشة التدفق. نبدأ بالاستيرادات اللازمة في Python وإعدادات الحَلّال:
import sys, os, time, random

from functools import partial
from collections import namedtuple
from itertools import product

import neighbourhood as neigh
import heuristics as heur

##############
## Settings ##
##############
TIME_LIMIT = 300.0 # Time (in seconds) to run the solver
TIME_INCREMENT = 13.0 # Time (in seconds) in between heuristic measurements
DEBUG_SWITCH = False # Displays intermediate heuristic info when True
MAX_LNS_NEIGHBOURHOODS = 1000 # Maximum number of neighbours to explore in LNS
هناك إعدادان يستحقان شرحًا أكثر. سيُستخدم الإعداد TIME_INCREMENT كجزء من الاختيار الديناميكي للاستراتيجية، وسيُستخدم الإعداد MAX_LNS_NEIGHBOURHOODS كجزء من استراتيجية اختيار الجوار. وكلاهما موصوف بمزيد من التفصيل أدناه.
يمكن كشف هذه الإعدادات للمستخدم كمعاملات سطر أوامر، لكن في هذه المرحلة نقدّم بيانات الإدخال بدلاً من ذلك بوصفها معاملات للبرنامج. ويُفترض أن مسألة الإدخال — مسألة من مجموعة Taillard المرجعية (benchmark) — تكون بصيغة قياسية لجدولة ورشة التدفق. وتُستخدم الشيفرة التالية كطريقة __main__ لملف الحَلّال، وتستدعي الدوال المناسبة بناءً على عدد المعاملات المُدخلة إلى البرنامج:
if __name__ == '__main__':

    if len(sys.argv) == 2:
        data = parse_problem(sys.argv[1], 0)
    elif len(sys.argv) == 3:
        data = parse_problem(sys.argv[1], int(sys.argv[2]))
    else:
        print "\nUsage: python flow.py <Taillard problem file> [<instance number>]\n"
        sys.exit(0)

    (perm, ms) = solve(data)
    print_solution(data, perm)
وصفنا لتحليل ملفات مسائل Taillard وصفًا موجزًا. (والملفات متاحة على الإنترنت.)
تتوقع طريقة solve أن يكون المتغير data قائمة من الأعداد الصحيحة تحتوي على مدد الأنشطة لكل عمل. وتبدأ طريقة solve بتهيئة مجموعة عالمية من الاستراتيجيات (الموصوفة أدناه). والمفتاح هنا هو أننا نستخدم متغيرات strat_* للاحتفاظ بإحصاءات عن كل استراتيجية. وهذا يساعد في اختيار الاستراتيجية ديناميكيًا أثناء عملية الحل.
def solve(data):
    """Solves an instance of the flow shop scheduling problem"""

    # We initialize the strategies here to avoid cyclic import issues
    initialize_strategies()
    global STRATEGIES

    # Record the following for each strategy:
    #  improvements: The amount a solution was improved by this strategy
    #  time_spent: The amount of time spent on the strategy
    #  weights: The weights that correspond to how good a strategy is
    #  usage: The number of times we use a strategy
    strat_improvements = {strategy: 0 for strategy in STRATEGIES}
    strat_time_spent = {strategy: 0 for strategy in STRATEGIES}
    strat_weights = {strategy: 1 for strategy in STRATEGIES}
    strat_usage = {strategy: 0 for strategy in STRATEGIES}
ومن السمات الجذابة في مشكلة جدولة ورشة التدفق أن كل تبادل يمثل حلاً صالحًا، وأن واحدًا منها على الأقل سيكون له مدة الإنجاز الكلي الأمثل (مع أن كثيرًا منها سيكون له مدة إنجاز فظيعة). وهذا يتيح لنا الاستغناء عن التحقق من أننا نبقى ضمن فضاء الحلول المجتملة (feasible) عند الانتقال من تبادل إلى آخر — فكل شيء مجتمل!
غير أنه، لبدء بحث محلي في فضاء التباديل، علينا أن نملك تبادلًا ابتدائيًا. ولإبقاء الأمور بسيطة، نهيّئ بحثنا المحلي بخلط قائمة الأعمال عشوائيًا:
    # Start with a random permutation of the jobs
    perm = range(len(data))
    random.shuffle(perm)
بعد ذلك، نهيّئ المتغيرات التي تتيح لنا متابعة أفضل تبادل عثرنا عليه حتى الآن، إضافة إلى معلومات التوقيت اللازمة لتقديم المخرجات.
    # Keep track of the best solution
    best_make = makespan(data, perm)
    best_perm = perm
    res = best_make

    # Maintain statistics and timing for the iterations
    iteration = 0
    time_limit = time.time() + TIME_LIMIT
    time_last_switch = time.time()

    time_delta = TIME_LIMIT / 10
    checkpoint = time.time() + time_delta
    percent_complete = 10

    print "\nSolving..."
ولأن هذا حَلّال بحث محلي، فإننا ببساطة نواصل محاولة تحسين الحلول ما دام الحد الزمني لم يُبلغ. ونقدّم مخرجات تبيّن تقدّم الحَلّال، ونتابع عدد التكرارات التي حسبناها:
    while time.time() < time_limit:

        if time.time() > checkpoint:
            print " %d %%" % percent_complete
            percent_complete += 10
            checkpoint += time_delta

        iteration += 1
وسنصف أدناه كيفية اختيار الاستراتيجية، لكنه يكفي في الوقت الحالي أن نعرف أن الاستراتيجية توفّر دالة neighbourhood ودالة heuristic. فالأولى تعطينا مجموعة من المرشحين التاليين نأخذهم في الحسبان، بينما تختار الثانية أفضل مرشّح من المجموعة. ومن هاتين الدالتين نحصل على تبادل جديد (perm) ونتيجة جديدة لمدة الإنجاز الكلي (res):
        # Heuristically choose the best strategy
        strategy = pick_strategy(STRATEGIES, strat_weights)

        old_val = res
        old_time = time.time()

        # Use the current strategy's heuristic to pick the next permutation from
        # the set of candidates generated by the strategy's neighbourhood
        candidates = strategy.neighbourhood(data, perm)
        perm = strategy.heuristic(data, candidates)
        res = makespan(data, perm)
شيفرة حساب مدة الإنجاز الكلي بسيطة إلى حدٍّ كبير: يمكننا حسابها من تبادل بتقييم الوقت الذي يُتم عنده العمل الأخير. وسنرى أدناه كيف تعمل compile_solution، لكنه يكفي في الوقت الحالي أن نعلم أن مصفوفة ثنائية الأبعاد تُعاد، وأن العنصر عند [-1][-1] يوافق زمن بدء العمل الأخير في الجدولة:
def makespan(data, perm):
    """Computes the makespan of the provided solution"""
    return compile_solution(data, perm)[-1][-1] + data[perm[-1]][-1]
وللمساعدة في اختيار استراتيجية، نحتفظ بإحصاءات عن (1) مقدار ما خفّضته الاستراتيجية من الحل، و(2) مقدار الوقت الذي أمضته الاستراتيجية في حساب المعلومات، و(3) عدد المرات التي استُخدمت فيها الاستراتيجية. ونحدّث كذلك متغيرات أفضل تبادل إذا صادفنا حلًا أفضل:
        # Record the statistics on how the strategy did
        strat_improvements[strategy] += res - old_val
        strat_time_spent[strategy] += time.time() - old_time
        strat_usage[strategy] += 1

        if res < best_make:
            best_make = res
            best_perm = perm[:]
وعلى فترات منتظمة، تُحدَّث إحصاءات استخدام الاستراتيجيات. وقد حذفنا المقطع المرتبط منها لأجل الوضوح، ونفصّل الشيفرة أدناه. وكخطوة أخيرة، بمجرد اكتمال حلقة while (أي بلوغ الحد الزمني) نُخرج بعض الإحصاءات عن عملية الحل ونعيد أفضل تبادل مع مدة إنجازه الكلي:
    print " %d %%\n" % percent_complete
    print "\nWent through %d iterations." % iteration

    print "\n(usage) Strategy:"
    results = sorted([(strat_weights[STRATEGIES[i]], i)
                      for i in range(len(STRATEGIES))], reverse=True)
    for (w, i) in results:
        print "(%d) \t%s" % (strat_usage[STRATEGIES[i]], STRATEGIES[i].name)

    return (best_perm, best_make)
تحليل المسائل
كمدخل لإجراء التحليل، نقدّم اسم الملف الذي يمكن العثور على المدخلات فيه ورقم المثال الذي ينبغي استخدامه. (يحتوي كل ملف على عدد من الحالات.)
def parse_problem(filename, k=1):
    """Parse the kth instance of a Taillard problem file

    The Taillard problem files are a standard benchmark set for the problem
    of flow shop scheduling.

    print "\nParsing..."
نبدأ التحليل بقراءة الملف وتحديد السطر الذي يفصل بين كل حالة من حالات المسألة:
    with open(filename, 'r') as f:
        # Identify the string that separates instances
        problem_line = ('/number of jobs, number of machines, initial seed, '
                        'upper bound and lower bound :/')

        # Strip spaces and newline characters from every line
        lines = map(str.strip, f.readlines())
ولتسهيل العثور على الحالة الصحيحة، نفترض أن الأسطر ستُفصل بمحرف '/'. ويتيح لنا ذلك تقسيم الملف على أساس نص شائع يظهر في أعلى كل حالة، وإضافة محرف '/' في بداية السطر الأول تتيح للمعالجة النصية أدناه أن تعمل بشكل صحيح بغض النظر عن الحالة التي نختارها. ونكتشف أيضًا متى يكون رقم الحالة المُقدَّم خارج النطاق بالنظر إلى مجموعة الحالات الموجودة في الملف.
        # We prep the first line for later
        lines[0] = '/' + lines[0]

        # We also know '/' does not appear in the files, so we can use it as
        #  a separator to find the right lines for the kth problem instance
        try:
            lines = '/'.join(lines).split(problem_line)[k].split('/')[2:]
        except IndexError:
            max_instances = len('/'.join(lines).split(problem_line)) - 1
            print "\nError: Instance must be within 1 and %d\n" % max_instances
            sys.exit(0)
نحلّل البيانات مباشرة، محوِّلين زمن معالجة كل مهمة إلى عدد صحيح وتخزينه في قائمة. وأخيرًا فإننا نضغط البيانات (zip) لعكس الصفوف والأعمدة بحيث يتوافق الشكل مع ما تتوقعه شيفرة الحل أعلاه. (يجب أن يوافق كل عنصر في data عملًا بعينه.)
        # Split every line based on spaces and convert each item to an int
        data = [map(int, line.split()) for line in lines]

    # We return the zipped data to rotate the rows and columns, making each
    #  item in data the durations of tasks for a particular job
    return zip(*data)
ترجمة الحلول
يتكوّن حل مشكلة جدولة ورشة التدفق من توقيت دقيق لكل مهمة في كل عمل. ولأننا نمثّل الحل ضمنيًا على هيئة تبادل للأعمال، فإننا نقدّم الدالة compile_solution لتحويل التبادل إلى أوقات دقيقة. وكمدخلات، تأخذ الدالة بيانات المسألة (التي تعطينا مدد كل مهمة) وتبادلًا للأعمال.
تبدأ الدالة بتهيئة بنية البيانات المستخدمة لتخزين زمن بدء كل مهمة، ثم بتضمين مهام العمل الأول في التبادل.
def compile_solution(data, perm):
    """Compiles a scheduling on the machines given a permutation of jobs"""

    num_machines = len(data[0])

    # Note that using [[]] * m would be incorrect, as it would simply
    #  copy the same list m times (as opposed to creating m distinct lists).
    machine_times = [[] for _ in range(num_machines)]

    # Assign the initial job to the machines
    machine_times[0].append(0)
    for mach in range(1,num_machines):
        # Start the next task in the job when the previous finishes
        machine_times[mach].append(machine_times[mach-1][0] +
                                   data[perm[0]][mach-1])
ثم نضيف كل مهام بقية الأعمال. وستبدأ المهمة الأولى في أي عمل دائمًا بمجرد اكتمال المهمة الأولى في العمل السابق. أما المهام المتبقية، فنجدولة العمل في أبكر وقت ممكن: القيمة الكبرى بين زمن اكتمال المهمة السابقة في العمل نفسه وزمن اكتمال المهمة السابقة على الآلة نفسها.
    # Assign the remaining jobs
    for i in range(1, len(perm)):

        # The first machine never contains any idle time
        job = perm[i]
        machine_times[0].append(machine_times[0][-1] + data[perm[i-1]][0])

        # For the remaining machines, the start time is the max of when the
        #  previous task in the job completed, or when the current machine
        #  completes the task for the previous job.
        for mach in range(1, num_machines):
            machine_times[mach].append(max(
                machine_times[mach-1][i] + data[perm[i]][mach-1],
                machine_times[mach][i-1] + data[perm[i-1]][mach]))

    return machine_times
طباعة الحلول
حين تكتمل عملية الحل، يُخرج البرنامج معلومات عن الحل بصيغة مختصرة. وبدلًا من تقديم التوقيت الدقيق لكل مهمة في كل عمل، فإننا نُخرج قطع المعلومات التالية:
- تبادل الأعمال الذي أنتج أفضل مدة إنجاز كلي
- مدة الإنجاز الكلي المحسوبة للتبادل
- زمن البدء وزمن الانتهاء وزمن الخمول لكل آلة
- زمن البدء وزمن الانتهاء وزمن الخمول لكل عمل
ويوافق زمن بدء العمل أو الآلة بدء المهمة الأولى في العمل أو على الآلة. وبالمثل، يوافق زمن انتهاء العمل أو الآلة نهاية المهمة الأخيرة في العمل أو على الآلة. أما زمن الخمول فهو مقدار الفسحة بين المهام لعمل ما أو لآلة ما. وفي الحالة المثلى نودّ تقليل مقدار زمن الخمول، إذ يعني ذلك أن زمن العملية الكلي سينخفض أيضًا.
لقد ناقشنا شيفرة ترجمة الحل (أي حساب أزمنة البدء لكل مهمة) بالفعل، أما إخراج التبادل ومدة الإنجاز الكلي فالأمر تافه:
def print_solution(data, perm):
    """Prints statistics on the computed solution"""

    sol = compile_solution(data, perm)

    print "\nPermutation: %s\n" % str([i+1 for i in perm])

    print "Makespan: %d\n" % makespan(data, perm)
بعد ذلك، نستخدم وظيفة تنسيق النصوص في Python لطباعة جدول أزمنة البدء والانتهاء والخمول لكل من الآلات والأعمال. ولاحظ أن زمن خمول العمل هو الزمن من بدء العمل حتى اكتماله، مطروحًا منه مجموع أزمنة المعالجة لكل مهمة في العمل. ونحسب زمن خمول الآلة بطريقة مماثلة.
    row_format ="{:>15}" * 4
    print row_format.format('Machine', 'Start Time', 'Finish Time', 'Idle Time')
    for mach in range(len(data[0])):
        finish_time = sol[mach][-1] + data[perm[-1]][mach]
        idle_time = (finish_time - sol[mach][0]) - sum([job[mach] for job in data])
        print row_format.format(mach+1, sol[mach][0], finish_time, idle_time)

    results = []
    for i in range(len(data)):
        finish_time = sol[-1][i] + data[perm[i]][-1]
        idle_time = (finish_time - sol[0][i]) - sum([time for time in data[perm[i]]])
        results.append((perm[i]+1, sol[0][i], finish_time, idle_time))

    print "\n"
    print row_format.format('Job', 'Start Time', 'Finish Time', 'Idle Time')
    for r in sorted(results):
        print row_format.format(*r)

    print "\n\nNote: Idle time does not include initial or final wait time.\n"
الأحياء
الفكرة الكامنة وراء البحث المحلي هي الانتقال محليًا (locally) من حل إلى حلول أخرى قريبة منه. ونُشير إلى الجوار (neighbourhood) لحل معيّن بأنه الحلول الأخرى المحلية بالنسبة إليه. وفي هذا القسم نفصّل أربعة أحياء محتملة، كل واحد منها أكثر تعقيدًا من سابقه.
ينتج الجوار الأول عددًا معيّنًا من التباديل العشوائية. ولا يأخذ هذا الجوار في الحسبان حتى الحل الذي نبدأ منه، لذا فإن مصطلح «الجوار» يجرح الحقيقة قليلًا. غير أن إدخال بعض العشوائية في البحث ممارسة جيدة، لأنه يعزّز استكشاف فضاء البحث.
def neighbours_random(data, perm, num = 1):
    # Returns <num> random job permutations, including the current one
    candidates = [perm]
    for i in range(num):
        candidate = perm[:]
        random.shuffle(candidate)
        candidates.append(candidate)
    return candidates
وبالنسبة للجوار التالي، فإننا نفكر في تبديل أي عملين في التبادل. وباستخدام الدالة combinations من حزمة itertools، يمكننا أن نمر بسهولة على كل زوج من الفهارس وأن ننشئ تبادلًا جديدًا يوافق تبديل الأعمال الموجود عند كل فهرس. وبمعنى ما، فإن هذا الجوار ينتج تبادلات مشابهة جدًا للذي بدأنا منه.
def neighbours_swap(data, perm):
    # Returns the permutations corresponding to swapping every pair of jobs
    candidates = [perm]
    for (i,j) in combinations(range(len(perm)), 2):
        candidate = perm[:]
        candidate[i], candidate[j] = candidate[j], candidate[i]
        candidates.append(candidate)
    return candidates
أما الجوار التالي الذي نأخذه في الحسبان فيستخدم معلومات خاصة بالمسألة المطروحة. فنجد الأعمال التي بها أكثر قدر من زمن الخمول ونفكر في تبديلها بكل طريقة ممكنة. ونأخذ قيمة size وهي عدد الأعمال التي نأخذها في الحسبان: أكثر size عملًا خمولًا. والخطوة الأولى في العملية هي حساب زمن الخمول لكل عمل في التبادل:
def neighbours_idle(data, perm, size=4):
    # Returns the permutations of the <size> most idle jobs
    candidates = [perm]

    # Compute the idle time for each job
    sol = flow.compile_solution(data, perm)
    results = []

    for i in range(len(data)):
        finish_time = sol[-1][i] + data[perm[i]][-1]
        idle_time = (finish_time - sol[0][i]) - sum([t for t in data[perm[i]]])
        results.append((idle_time, i))
بعد ذلك، نحسب قائمة من size عملًا هي التي تملك أكثر قدر من زمن الخمول.
    # Take the <size> most idle jobs
    subset = [job_ind for (idle, job_ind) in reversed(sorted(results))][:size]
وأخيرًا، نبني الجوار بالنظر في كل تبادل للأعمال الأكثر خمولًا التي حددناها. وللعثور على التبادلات، نستفيد من الدالة permutations من حزمة itertools.
    # Enumerate the permutations of the idle jobs
    for ordering in permutations(subset):
        candidate = perm[:]
        for i in range(len(ordering)):
            candidate[subset[i]] = perm[ordering[i]]
        candidates.append(candidate)

    return candidates
ويُشار إلى الجوار الأخير الذي نأخذه في الحسبان عادةً بأنه البحث في الحيّ الكبير (Large Neighbourhood Search، LNS). ومن الناحية الحدسية، يعمل LNS بالنظر في مجموعات صغيرة من التبادل الحالي على حدة — فالعثور على أفضل تبادل لمجموعة الأعمال هذه يعطينا مرشحًا واحدًا لجوار LNS. وبإعادة هذه العملية لعدة مجموعات (أو جميعها) بحجم معيّن، يمكننا زيادة عدد المرشحين في الجوار. ونحدّ عدد الجيران الذي نأخذهم في الحسبان عبر المعامل MAX_LNS_NEIGHBOURHOODS، لأن عدد الجيران قد ينمو بسرعة كبيرة. والخطوة الأولى في حساب LNS هي حساب قائمة عشوائية بمجموعات الأعمال التي سنفكر في تبديلها، باستخدام الدالة combinations من حزمة itertools:
def neighbours_LNS(data, perm, size = 2):
    # Returns the Large Neighbourhood Search neighbours
    candidates = [perm]

    # Bound the number of neighbourhoods in case there are too many jobs
    neighbourhoods = list(combinations(range(len(perm)), size))
    random.shuffle(neighbourhoods)
بعد ذلك، نمر على المجموعات للعثور على أفضل تبادل للأعمال في كل واحدة منها. وقد رأينا شيفرة مماثلة أعلاه للمرور على كل تبادلات الأعمال الأكثر خمولًا. والفارق الجوهري هنا أننا نسجّل أفضل تبادل للمجموعة فقط، لأن الحيّ الأكبر يُبنى باختيار تبادل واحد لكل مجموعة من الأعمال التي نأخذها في الحسبان.
    for subset in neighbourhoods[:flow.MAX_LNS_NEIGHBOURHOODS]:

        # Keep track of the best candidate for each neighbourhood
        best_make = flow.makespan(data, perm)
        best_perm = perm

        # Enumerate every permutation of the selected neighbourhood
        for ordering in permutations(subset):
            candidate = perm[:]
            for i in range(len(ordering)):
                candidate[subset[i]] = perm[ordering[i]]
            res = flow.makespan(data, candidate)
            if res < best_make:
                best_make = res
                best_perm = candidate

        # Record the best candidate as part of the larger neighbourhood
        candidates.append(best_perm)

    return candidates
ولو ضبطنا المعامل size على أن يساوي عدد الأعمال، لأُخذ في الحسبان كل تبادل واختير أفضلها. غير أن في الواقع نحتاج إلى تحديد حجم المجموعة بنحو 3 أو 4؛ فأي حجم أكبر من ذلك سيجعل الدالة neighbours_LNS تستغرق زمنًا لا يُعتدّ به.
الاستدلالات
يُعيد الاستدلال (heuristic) تبادلًا واحدًا مرشحًا من مجموعة المرشحين المقدَّمة. كما يُمنح الاستدلال وصولًا إلى بيانات المسألة كي يقيّم أي مرشّح قد يكون مفضَّلًا.
وأول استدلال نأخذه في الحسبان هو heur_random. وهذا الاستدلال يختار عشوائيًا مرشحًا من القائمة دون تقييم أيّها قد يكون مفضَّلًا:
def heur_random(data, candidates):
    # Returns a random candidate choice
    return random.choice(candidates)
ويستخدم الاستدلال التالي heur_hillclimbing الطرف المقابل تمامًا. فبدلًا من اختيار مرشّح عشوائيًا، فإنه يختار المرشح الذي لديه أفضل مدة إنجاز كلي. ولاحظ أن القائمة scores ستحتوي على ثنائيات من الشكل (make,perm) حيث make هي قيمة مدة الإنجاز الكلي للتبادل perm. وترتيب هذه القائمة يضع الثنائي ذو أفضل مدة إنجاز في بداية القائمة؛ ومن هذا الثنائي نعيد التبادل.
def heur_hillclimbing(data, candidates):
    # Returns the best candidate in the list
    scores = [(flow.makespan(data, perm), perm) for perm in candidates]
    return sorted(scores)[0][1]
أمّا الاستدلال الأخير، heur_random_hillclimbing، فيجمع بين الاستدلالين العشوائي وصعود التل أعلاه. فعند إجراء البحث المحلي، قد لا ترغب دائمًا في اختيار مرشّح عشوائي، ولا حتى أفضل واحد. ويُعيد الاستدلال heur_random_hillclimbing حلًا «جيدًا بما يكفي» باختيار أفضل مرشّح باحتمال 0.5، ثم الثاني الأفضل باحتمال 0.25، وهكذا. وتقوم حلقة while في جوهرها بإلقاء عملة معدنية في كل تكرار لترى ما إذا كان ينبغي لها أن تواصل زيادة الفهرس (مع وضع حدّ لحجم القائمة). ويقابل الفهرس النهائي المختار المرشح الذي يختاره الاستدلال.
def heur_random_hillclimbing(data, candidates):
    # Returns a candidate with probability proportional to its rank in sorted quality
    scores = [(flow.makespan(data, perm), perm) for perm in candidates]
    i = 0
    while (random.random() < 0.5) and (i < len(scores) - 1):
        i += 1
    return sorted(scores)[i][1]
ولأن مدة الإنجاز الكلي هي المعيار الذي نحاول تحسينه، فإن صعود التل سيوجّه عملية البحث المحلي نحو الحلول ذات مدة الإنجاز الأفضل. وإدخال العشوائية يتيح لنا استكشاف الجوار بدلاً من التوجه الأعمى نحو أفضل حل في كل خطوة.
الاختيار الديناميكي للاستراتيجية
في قلب البحث المحلي عن تبادل جيد يكمن استخدام استدلال ودالة جوار معيّنين للانتقال من حل إلى آخر. فكيف نختار مجموعة خيارات دون أخرى؟ وفي الواقع، فإن تبديل الاستراتيجيات أثناء البحث يعود بالفائدة كثيرًا. وسيبدّل الاختيار الديناميكي للاستراتيجية الذي نستخدمه بين تركيبات من دوال الاستدلال ودوال الجوار، محاولًا الانتقال ديناميكيًا إلى تلك الاستراتيجيات التي تنجح أكثر. وبالنسبة إلينا، الاستراتيجية هي تكوين معيّن لدوال الاستدلال ودوال الجوار (بما في ذلك قيم معاملاتها).
لنبدأ، فشيفرتنا تبني مدى الاستراتيجيات التي نريد أخذها في الحسبان أثناء الحل. وفي تهيئة الاستراتيجيات، نستخدم الدالة partial من حزمة functools لإسناد المعاملات جزئيًا لكل من الأحياء. وإضافة إلى ذلك، نبني قائمة بدوال الاستدلال، وأخيرًا نستخدم عامل الضرب لإضافة كل تركيبة من دالة جوار ودالة استدلال كاستراتيجية جديدة.
################
## Strategies ##
#################################################
## A strategy is a particular configuration
##  of neighbourhood generator (to compute
##  the next set of candidates) and heuristic
##  computation (to select the best candidate).
##

STRATEGIES = []

# Using a namedtuple is a little cleaner than using dictionaries.
#  E.g., strategy['name'] versus strategy.name
Strategy = namedtuple('Strategy', ['name', 'neighbourhood', 'heuristic'])

def initialize_strategies():

    global STRATEGIES

    # Define the neighbourhoods (and parameters) that we would like to use
    neighbourhoods = [
        ('Random Permutation', partial(neigh.neighbours_random, num=100)),
        ('Swapped Pairs', neigh.neighbours_swap),
        ('Large Neighbourhood Search (2)', partial(neigh.neighbours_LNS, size=2)),
        ('Large Neighbourhood Search (3)', partial(neigh.neighbours_LNS, size=3)),
        ('Idle Neighbourhood (3)', partial(neigh.neighbours_idle, size=3)),
        ('Idle Neighbourhood (4)', partial(neigh.neighbours_idle, size=4)),
        ('Idle Neighbourhood (5)', partial(neigh.neighbours_idle, size=5))
    ]

    # Define the heuristics that we would like to use
    heuristics = [
        ('Hill Climbing', heur.heur_hillclimbing),
        ('Random Selection', heur.heur_random),
        ('Biased Random Selection', heur.heur_random_hillclimbing)
    ]

    # Combine every neighbourhood and heuristic strategy
    for (n, h) in product(neighbourhoods, heuristics):
        STRATEGIES.append(Strategy("%s / %s" % (n[0], h[0]), n[1], h[1]))
وبعد تعريف الاستراتيجيات، لا نريد بالضرورة أن نتشبث بخيار واحد أثناء البحث. وبدلًا من ذلك، نختار عشوائيًا أيًّا من الاستراتيجيات، لكننا نُرجّح الاختيار (weight the selection) بحسب مدى أداء الاستراتيجية. سنصف هذا الترجيح أدناه، لكنه يكفي للدالة pick_strategy أن يكون لدينا قائمة استراتيجيات وقائمة أوزان متناظرة (أي رقم سيفي). ولاختيار استراتيجية عشوائية بالأوزان المعطاة، نختار عددًا بانتظام بين 0 ومجموع كل الأوزان. بعدها نجد أدنى فهرس بحيث يكون مجموع كل الأوزان ذات الفهارس الأصغر من أكبر من العدد العشوائي الذي اخترناه. وتُعرف هذه التقنية أحيانًا باسم اختيار عجلة الرولت (roulette wheel selection)، وهي تختار لنا استراتيجية عشوائيًا وتمنح فرصة أكبر للاستراتيجيات ذات الوزن الأعلى.
def pick_strategy(strategies, weights):
    # Picks a random strategy based on its weight: roulette wheel selection
    #  Rather than selecting a strategy entirely at random, we bias the
    #  random selection towards strategies that have worked well in the
    #  past (according to the weight value).
    total = sum([weights[strategy] for strategy in strategies])
    pick = random.uniform(0, total)
    count = weights[strategies[0]]

    i = 0
    while pick > count:
        count += weights[strategies[i+1]]
        i += 1

    return strategies[i]
والآن يبقى وصف كيفية زيادة الأوزان أثناء البحث عن حل. ويحدث هذا في حلقة while الرئيسية في الحَلّال على فترات موقوتة بانتظام (تُعرَّف بالمتغير TIME_INCREMENT):
        # At regular intervals, switch the weighting on the strategies available.
        #  This way, the search can dynamically shift towards strategies that have
        #  proven more effective recently.
        if time.time() > time_last_switch + TIME_INCREMENT:

            time_last_switch = time.time()
وتذكّر أن strat_improvements يخزّن مجموع كل التحسينات التي أحدثتها الاستراتيجية، بينما يخزّن strat_time_spent الوقت الذي مُنح للاستراتيجية خلال الفاصل الأخير. ونُطبّع التحسينات التي أُحدثت على الوقت الإجمالي المنقضي لكل استراتيجية للحصول على مقياس لأداء كل استراتيجية في الفاصل الأخير. ولأن الاستراتيجية قد لا تكون قد حصلت على فرصة للعمل إطلاقًا، فإننا نختار قدرًا صغيرًا من الزمن كقيمة افتراضية.
            # Normalize the improvements made by the time it takes to make them
            results = sorted([
                (float(strat_improvements[s]) / max(0.001, strat_time_spent[s]), s)
                for s in STRATEGIES])
والآن وقد أصبح لدينا ترتيبٌ لأداء كل استراتيجية، فإننا نضيف إلى وزن أفضل استراتيجية (بافتراض أننا كنا لدينا استراتيجيات)، و إلى الاستراتيجية التالية الأفضل، وهكذا. وستُزاد وزن كل استراتيجية، فيما سترى أضعف استراتيجية في القائمة زيادة قدرها 1 فقط.
            # Boost the weight for the successful strategies
            for i in range(len(STRATEGIES)):
                strat_weights[results[i][1]] += len(STRATEGIES) - i
وكإجراء إضافي، فإننا نرفع أوزان كل الاستراتيجيات التي لم تُستخدم رفعًا اصطناعيًا. ويجري ذلك كي لا ننسى الاستراتيجية كليًا. فقد تبدو إحدى الاستراتيجيات سيئة الأداء في البداية، لكنها في وقت لاحق من البحث قد تثبت فائدتها إلى حدٍّ بعيد.
                # Additionally boost the unused strategies to avoid starvation
                if results[i][0] == 0:
                    strat_weights[results[i][1]] += len(STRATEGIES)
وأخيرًا، نُخرج بعض المعلومات عن ترتيب الاستراتيجيات (إذا كان العَلَم DEBUG_SWITCH مضبوطًا)، ونعيد تعيين المتغيرين strat_improvements وstrat_time_spent من أجل الفاصل التالي.
            if DEBUG_SWITCH:
                print "\nComputing another switch..."
                print "Best: %s (%d)" % (results[0][1].name, results[0][0])
                print "Worst: %s (%d)" % (results[-1][1].name, results[-1][0])
                print results
                print sorted([strat_weights[STRATEGIES[i]]
                              for i in range(len(STRATEGIES))])

            strat_improvements = {strategy: 0 for strategy in STRATEGIES}
            strat_time_spent = {strategy: 0 for strategy in STRATEGIES}
نقاش
لقد رأينا في هذا الفصل ما يمكن إنجازه بكميات صغيرة نسبيًا من الشيفرة لحل مشكلة التحسين المعقدة وهي جدولة ورشة التدفق. وقد يكون العثور على أفضل حل لمشكلة تحسين كبيرة مثل ورشة التدفق صعبًا. وفي حالة مثل هذه، يمكننا أن نلجأ إلى تقنيات تقريب مثل البحث المحلي لحساب حل جيد بما يكفي. ومع البحث المحلي يمكننا الانتقال من حل إلى آخر، بهدف العثور على حل ذي جودة عالية.
والحدس العام الكامن وراء البحث المحلي يمكن تطبيقه على مدى واسع من المشكلات. وقد ركّزنا على (1) توليد جوار من حلول مرتبطة بمسألة ما انطلاقًا من حل مرشح واحد، و(2) وضع طرق لتقييم الحلول ومقارنتها. ومع هذين المكوّنين في متناول اليد، يمكننا أن نستخدم نموذج البحث المحلي للعثور على حل ذي قيمة حين يكون الخيار الأفضل صعبًا جدًا في الحساب.
وبدلًا من استخدام أي استراتيجية واحدة لحل المسألة، رأينا كيف يمكن اختيار استراتيجية ديناميكيًا بحيث تتبدّل أثناء عملية الحل. وهذه التقنية البسيطة القوية تمنح البرنامج القدرة على مزج الاستراتيجيات الجزئية ومطابقتها مع المسألة المطروحة، كما تعني أيضًا أن المطوّر ليس مضطرًا إلى تفصيل الاستراتيجية تكييفًا يدويًا.