Contingent: نظام بناء ديناميكي بالكامل
بدأ براندون رودز يستخدم Python في أواخر تسعينيات القرن الماضي، وقد أداب على صيانة مكتبة PyEphem للفلكيين الهواة على مدى 17 عاماً. يعمل في Dropbox، وقد درّس دورات برمجة Python لعملاء الشركات، وشاور في مشاريع مثل موقع «Go Botany» المبني على Django تابعاً لجمعية نيو إنجلاند للزهور البرية، وسيترأس مؤتمر PyCon في 2016 و2017. يرى براندون أن الشيفرة المكتوبة بإتقان صورة من صور الأدب، وأن الشيفرة المنسَّق تنسيقاً جميلاً عمل من أعمال التصميم الجرافيكي، وأن الشيفرة الصحيحة إحدى أكثر صور الفكر شفافية.
يحب دانيال روكو Python والقهوة والحرفة والـ stout وتصميم الكائنات والأنظمة، وbourbon والتعليم والأشجار والغيتار اللاتيني. وبما أنه مبهور بأنه يكتب Python لكسب رزقه، فإنه يبحث دائماً عن فرص للتعلم من الآخرين في المجتمع، وأن يسهم عبر مشاركة المعرفة. وهو متحدث متكرر في PyAtl حول المواضيع التمهيدية والاختبار والتصميم والأشياء اللامعة؛ يحب رؤية بريق الدهشة والبهجة في عيون الناس حين يشارك أحدهم فكرة مبتكرة أو مفاجئة أو جميلة. يعيش دانيال في أتلانتا مع أحياء مجهرية وأربعة صواريخ طموحين.
مقدمة
ظلت أنظمة البناء أداة قياسية في البرمجة الحاسوبية لوقت طويل.
طُوِّر نظام البناء القياسي make،
الذي فاز مؤلفه بجائزة ACM لنظام برمجي،
لأول مرة عام 1976.
وهو لا يتيح لك فحسب التصريح
بأن ملف مخرج يعتمد على مُدخل واحد (أو أكثر)،
بل يتيح لك فعل ذلك على نحو تكراري.
فبرنامج ما قد يعتمد مثلاً على ملف كائن
يعتمد بدوره على الشيفرة المصدرية المقابلة:
    prog: main.o
            cc -o prog main.o

    main.o: main.c
            cc -C -o main.o main.c
إذا اكتشف make عند استدعائه التالي
أن ملف الشيفرة المصدرية main.c
لم يعد طابع زمن التعديل الخاص به أحدث من main.o،
فإنه لن يعيد بناء ملف الكائن main.o فحسب
بل سيعيد بناء prog نفسه أيضاً.
أنظمة البناء مشروع فصلي شائع يُكلَّف به طلاب علوم الحاسوب في مرحلة البكالوريوس — ليس فقط لأن أنظمة البناء تُستخدم في كل مشاريع البرمجيات تقريباً، بل لأن بنائها يتضمّن بنى بيانات وخوارزميات أساسية على الرسوم البيانية الموجّهة (وسنناقشها في هذا الفصل لاحقاً بمزيد من التفصيل).
وبعقود من الاستخدام والممارسة وراء أنظمة البناء،
قد يُنتظر أن تكون قد صارت صالحة لكل الغايات
وجاهزة حتى لأغنى المطالب. لكن في الواقع إن نوعاً من التفاعلات
الشائعة بين مخرجات البناء —
مشكلة الإحالات المتقاطعة الديناميكية —
تعالجه معظم أنظمة البناء معالجة سيّئة
لدرجة ألّهمتني في هذا الفصل
ألّا أعيد تقديم الحل الكلاسيكي
والبنى البيانات المستعملة لحل مشكلة make فحسب،
بل أن أوسّع ذلك الحل توسيعاً بالغاً، نحو مجال أكثر تطلّباً بكثير.
المشكلة، مرة أخرى، هي الإحالات المتقاطعة. أين تميل الإحالات المتقاطعة إلى الظهور؟ في المستندات النصية والتوثيق والكتب المطبوعة!
المشكلة: بناء أنظمة المستندات
أنظمة إعادة بناء المستندات المنسَّقة من المصدر تبدو دائماً وكأنها تعمل أكثر مما ينبغي، أو أقل مما ينبغي.
فهي تعمل أكثر مما ينبغي حين تستجيب لتعديل طفيف بأن تجعلك تنتظر إعادة تحليل الفصول غير ذات الصلة وإعادة تنسيقها. لكنها قد تعيد بناء أقل مما ينبغي أيضاً، فتترك لك منتجاً نهائياً غير متسق.
لنأخذ Sphinx — باني المستندات
الذي يُستخدم في توثيق لغة Python الرسمي
وفي مشاريع كثيرة أخرى داخل مجتمع Python.
عادةً ما يتضمّن ملف index.rst
في مشروع Sphinx جدول محتويات:
   Table of Contents
   =================

   .. toctree::

      install.rst
      tutorial.rst
      api.rst
تخبر هذه القائمة بأسماء ملفات الفصول
Sphinx بأن يدرج رابطاً لكل فصل من الفصول الثلاثة المذكورة
حين يبني ملف المخرجات index.html.
كما أنه سيدرج روابط إلى أي أقسام داخل كل فصل.
مجرّدة من ترميزها،
قد يبدو النص الناتج من العنوان
أمر toctree أعلاه كالتالي:
  Table of Contents

  • Installation

  • Newcomers Tutorial
      • Hello, World
      • Adding Logging

  • API Reference
      • Handy Functions
      • Obscure Classes
جدول المحتويات هذا، كما ترى، مزيج
من معلومات واردة من أربعة ملفات مختلفة.
فترتيبه وبنيته الأساسيان يأتيان من index.rst،
بينما تُسحب عناوين كل فصل وقسم فعلياً
من ملفات الفصول المصدرية الثلاثة نفسها.
إن أعدت النظر لاحقاً في عنوان فصل الدليل —
فكلمة «الوافد» تبدو قديمة الطراز،
وكأن مستخدميك مستوطون وصلوا لتوّهم إلى وايومنغ الطامري —
فأنت عندئذٍ ستحرّر السطر الأول من tutorial.rst
وتكتب شيئاً أفضل:
  -Newcomers Tutorial
  +Beginners Tutorial
   ==================

   Welcome to the tutorial!
   This text will take you through the basics of...
وحين تكون مستعداً لإعادة البناء،
سيفعل Sphinx الشيء الصحيح تماماً!
فهو سيعيد بناء فصل الدليل نفسه،
وكذلك الفهرس.
(وإخراج النتيجة عبر cat يجعل Sphinx
يذكر كل ملف أُعيد بناؤه في سطر مستقل،
بدلاً من استخدام محارف الرجوع (carriage returns)
لإعادة كتابة سطر واحد مراراً بتلك تحديثات التقدم.)
   $ make html | cat
   writing output... [ 50%] index
   writing output... [100%] tutorial
ولأن Sphinx اختار إعادة بناء المستندين معاً،
لن يكتفي tutorial.html الآن بعرض عنوانه الجديد في الأعلى،
بل سيعرض ملف المخرجات index.html عنوان الفصل المحدَّث
في جدول المحتويات.
فقد أعاد Sphinx بناء كل شيء بحيث يكون المخرجات متسقة.
وماذا لو كان تعديلك على tutorial.rst أكثر تفصيلاً؟
   Beginners Tutorial
   ==================

  -Welcome to the tutorial!
  +Welcome to our project tutorial!
   This text will take you through the basics of...
في هذه الحالة لا حاجة إلى إعادة بناء index.html
لأن هذا التعديل الطفيف داخل فقرة
لا يغيّر أياً من المعلومات الموجودة في جدول المحتويات.
لكن اتضح أن Sphinx ليس ذكياً إلى هذا الحد
كما قد يبدو للوهلة الأولى!
فهو سينطلق ويؤدي العمل الزائد بإعادة بناء
index.html رغم أن المحتوى الناتج
سيكون مطابقاً تماماً لما كان عليه.
   writing output... [ 50%] index
   writing output... [100%] tutorial
يمكنك تشغيل diff
على نسختَي index.html «قبل» و«بعد»
لتتأكد من أن تعديلك الصغير
لم يكن له أي أثر على الصفحة الأولى —
مع أن Sphinx جعلك تنتظر أثناء إعادة بنائها على أي حال.
قد لا تلاحظ حتى الجهد الإضافي لإعادة البناء
في المستندات الصغيرة سهلة التصريف. لكن التأخير في سير عملك
قد يصبح كبيراً
حين تجري تعديلات وتغييرات متكررة
على مستندات طويلة ومعقدة، أو تنطوي على توليد
محتوى متعدد الوسائط مثل الرسوم البيانية أو الحركات.
ولأن Sphinx على الأقل يحاول
ألا يعيد بناء كل فصل حين تجري تغييراً واحداً —
فهو مثلاً لم يُعد بناء install.html أو api.html
استجابةً لتعديلك على tutorial.rst —
فهو يفعل أكثر مما ينبغي.
لكن اتضح أن Sphinx يفعل شيئاً أسوأ: فهو أحياناً يفعل أقل مما ينبغي، فيترك لك مخرجات غير متسقة قد يلاحظها المستخدمون.
لترى أحد أبسط إخفاقاته، أضف أولاً إحالة متقاطعة في أعلى توثيق الـ API الخاص بك:
   API Reference
   =============

  +Before reading this, try reading our :doc:`tutorial`!
  +
   The sections below list every function
   and every single class and method offered...
ومع حذره المعتاد بشأن جدول المحتويات،
سيُعيد Sphinx بناء كل من مستند مرجع الـ API هذا
وكذلك الصفحة الرئيسية index.html لمشروعك:
   writing output... [ 50%] api
   writing output... [100%] index
في ملف المخرجات api.html يمكنك التأكد
من أن Sphinx قد أدرج العنوان الجذاب المقروء من قبل الإنسان
لفصل الدليل داخل وسم الإرساء الخاص بالإحالة المتقاطعة:
   <p>Before reading this, try reading our
   <a class="reference internal" href="tutorial.html">
     <em>Beginners Tutorial</em>
   </a>!</p>
وماذا لو أجريت الآن تعديلاً آخر
على العنوان في أعلى ملف tutorial.rst؟
فقد أبطلت صلاحية ثلاثة ملفات مخرجات:
-
العنوان في أعلى
tutorial.htmlلم يعد محدَّثاً، لذا يحتاج الملف إلى إعادة البناء. -
جدول المحتويات في
index.htmlما زال يحمل العنوان القديم، لذا يحتاج ذلك المستند إلى إعادة البناء. -
الإحالة المتقاطعة المضمّنة في الفقرة الأولى من
api.htmlما زالت تحمل عنوان الفصل القديم، وتحتاج أيضاً إلى إعادة البناء.
وماذا يفعل Sphinx؟
   writing output... [ 50%] index
   writing output... [100%] tutorial
أوه لا.
أُعيد بناء ملفَّين فقط، لا ثلاثة. فشل Sphinx في إعادة بناء توثيقك على نحو صحيح.
إن دفعت الآن صفحة HTML الخاصة بك إلى الويب،
سيرى المستخدمون العنوان القديم في الإحالة المتقاطعة
في أعلى api.html
لكنهم سيرون بعد ذلك عنواناً مختلفاً — العنوان الجديد —
ما إن ينقلهم الرابط إلى tutorial.html نفسها.
وهذا يمكن أن يحدث لكثير من أنواع الإحالات المتقاطعة التي يدعمها Sphinx:
عناوين الفصول، وعناوين الأقسام، والفقرات،
والأصناف، والتوابع، والدوال.
أنظمة البناء والاتساق
المشكلة المبيَّنة أعلاه ليست خاصة بـ Sphinx.
فهي لا تطارد أنظمة المستندات الأخرى مثل LaTeX فحسب،
بل قد تصيب حتى المشاريع
التي تحاول ببساطة توجيه خطوات التصريف
باستخدام الأداة venerable make،
إذا كانت أصولها تتقاطع بالإحالات بطرق مثيرة للاهتمام.
ولأن المشكلة قديمة وعامة، فحلها ينحدر من نسب Equally طويلة:
   $ rm -r _build/
   $ make html
إن حذفت كل المخرجات،
فأنت مضمون إعادة بناء كاملة!
بل إن بعض المشاريع تعيّن rm -r هدفاً باسم clean
بحيث لا يكفي سوى make clean سريع لمحو اللوح.
وبإزالة كل نسخة من كل أصل وسيط أو مُخرَج،
يستطيع rm -r كبير أن يفرض على البناء البدء من جديد
دون أي شيء مخزَّن مؤقتاً — دون أي ذاكرة لحالته السابقة
قد تؤدي بالضرورة إلى نتاج مهمَل.
لكن هل يمكننا تطوير منهج أفضل؟
ماذا لو كان نظام البناء لديك عملية دائمة تلاحظ كل عنوان فصل، وكل عنوان قسم، وكل عبارة مشار إليها بإحالة متقاطعة وهي تنتقل من الشيفرة المصدرية لمستند إلى نص مستند آخر؟ ستكون قراراته بشأن إعادة بناء مستندات أخرى بعد تغيير في ملف مصدر واحد دقيقة، لا مجرد تخمينات، وصحيحة، بدل أن تترك المخرجات في حالة غير متسقة.
لكن النتيجة ستكون نظاماً مثل أداة make الساكنة القديمة،
غير أنه يتعلّم التبعيات بين الملفات أثناء بنائها —
يضيف التبعيات ويزيلها ديناميكياً
مع إضافة الإحالات المتقاطعة وتحديثها وحذفها.
في الأقسام التالية سنبني أداة كهذه، نسمّيها Contingent، بـ Python. تضمن Contingent الصحة عند وجود تبعيات ديناميكية بينما تُنفّذ أقل عدد ممكن من خطوات إعادة البناء. ولأنها قابلة للتطبيق على أي مجال مشكل، سنطبّقها على نسخة مصغّرة من المشكلة المبيَّنة أعلاه.
ربط المهام لبناء رسم بياني
يحتاج أي نظام بناء إلى وسيلة لربط المُدخلات بالمخرجات. فالنصوص الثلاثة الموسومة في نقاشنا أعلاه، مثلاً، ينتج كل منها ملف مخرجات HTML مقابلاً. وإن أكثر الطرق طبيعية للتعبير عن هذه العلاقات هي مجموعة من الصناديق والأسهم — أو، بالمصطلح الرياضي، عقد وحافات — لتكوّن رسماً بيانياً (graph).
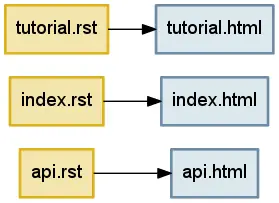
ستوفّر كل لغة قد يلجأ إليها مبرمج لبناء نظام بناء بنى بيانات متنوّعة يمكن بها تمثيل مثل هذا الرسم البياني من العقد والحافات.
فكيف يمكننا تمثيل مثل هذا الرسم البياني في Python؟
تمنح لغة Python الأولوية لأربع بنى بيانات عامة بمنحها دعماً مباشراً في صياغة اللغة. يمكنك إنشاء نسخ جديدة من بنى البيانات الأربع العظمى هذه بمجرد كتابة تمثيلها الحرفي في شيفرتك المصدرية، بينما تتوفر كائنات أنواعها الأربعة كرموز مدمجة يمكن استخدامها دون استيراد.
الـ tuple تسلسل للقراءة فقط يُستخدم للاحتفاظ ببيانات غير متجانسة — فكل خانة في الـ tuple تعني عادةً شيئاً مختلفاً. هنا يحتفظ الـ tuple باسم مضيف ورقم منفذ معاً، وسيفقد معناه إن أُعيد ترتيب عناصره:
('dropbox.com', 443)
الـ list تسلسل قابل للتغيير يُستخدم للاحتفاظ ببيانات متجانسة — فكل عنصر له عادةً البنية والمعنى نفسيهما قياساً بنظرائه. يمكن استخدام القوائم إمّا للحفاظ على ترتيب مُدخل البيانات الأصلي، وإمّا لإعادة ترتيبها أو فرزها لترتيب جديد وأكثر فائدة.
['C', 'Awk', 'TCL', 'Python', 'JavaScript']
أما الـ set فلا يحافظ على الترتيب. فهو يتذكّر فقط ما إذا أُضيفت قيمة معيّنة، لا عدد المرات، لذلك فهو بنية البيانات المفضّلة لإزالة التكرارات من تدفّق بيانات. مثلاً، سيكون لكل من المجموعتين التاليتين ثلاثة عناصر:
{3, 4, 5}
{3, 4, 5, 4, 4, 3, 5, 4, 5, 3, 4, 5}
أما الـ dict فهو بنية بيانات ترابطية لتخزين قيم يمكن الوصول إليها عبر مفتاح. تتيح القواميس للمبرمج أن يختار المفتاح الذي يُفهرَس به كل قيمة، بدلاً من استخدام الفهرسة العددية التلقائية كما يفعل الـ tuple والـ list. ويستند البحث إلى جدول تجزئة، ما يعني أن البحث عن مفتاح في الـ dict يجري بالسرعة نفسها سواء كان الـ dict يملك اثني عشر مفتاحاً أو مليون مفتاح.
{'ssh': 22, 'telnet': 23, 'domain': 53, 'http': 80}
مفتاح مرونة Python هو أن بنى البيانات الأربع هذه قابلة للتركيب. فيمكن للمبرمج أن يتداخل بينها عشوائياً لينتج مخازن بيانات أكثر تعقيداً تبقى قواعدها وصياغتها القواعد والصياغة البسيطة للـ tuples والقوائم والمجموعات والقواميس الأساسية.
ولأن كل حافة من حواف رسمنا البياني تحتاج أن تعرف على الأقل عقدة أصلها وعقدة وجهتها، فأبسط تمثيل ممكن سيكون tuple. قد تبدو الحافة العليا في graph كالتالي:
('tutorial.rst', 'tutorial.html')
فكيف يمكننا تخزين عدة حواف؟
ورغم أن دافعنا الأول قد يكون
أن نرمى كل tuples حوافنا في قائمة،
فذلك له عيوب.
فالقائمة تحرص على الحفاظ على الترتيب،
لكن من غير المعقول الحديث عن ترتيب مطلق
لحواف رسم بياني.
ولن ترفض القائمة أن تحمل عدة نسخ
من الحافة نفسها تماماً،
رغم أننا نريد أن يكفي
سهم واحد بين tutorial.rst وtutorial.html.
الخيار الصحيح هو إذن المجموعة،
التي تجعلنا نمثّل graph كالتالي:
    {('tutorial.rst', 'tutorial.html'),
     ('index.rst', 'index.html'),
     ('api.rst', 'api.html')}
وهذا يتيح تكراراً سريعاً على كل حوافنا، وعمليات إدراج وحذف سريعة لحافة واحدة، وطريقاً سريعاً للتحقق مما إذا كانت حافة بعينها موجودة.
للأسف، تلك ليست العمليات الوحيدة التي نحتاجها.
فنظام بناء مثل Contingent
يحتاج إلى فهم العلاقة بين عقدة معيّنة
وبين كل العقد المتصلة بها.
مثلاً، حين يتغير api.rst،
يحتاج Contingent أن يعرف ما هي الأصول المتأثرة، إن وُجدت،
بتغيير ما،
لتقليل العمل المنفَّذ
مع ضمان اكتمال البناء في الوقت نفسه.
وللإجابة عن هذا السؤال —
«ما العُقد الواردة في تيار api.rst؟» —
نحتاج إلى فحص الحواف الخارجة من api.rst.
لكن بناء رسم التبعيات البياني يتطلب أن
يهتم Contingent بـ مُدخلات العقدة أيضاً.
ما المُدخلات التي استُخدمت، مثلاً،
حين جمع نظام البناء مستند المخرجات tutorial.html؟
إنه بمراقبته مُدخل كل عقدة
يستطيع Contingent أن يعرف أن api.html تعتمد على api.rst لكن
tutorial.html لا تعتمد عليها.
ومع تغيّر المصادر وحدوث عمليات إعادة البناء،
يعيد Contingent بناء الحواف الداخلة لكل عقدة متغيّرة
لإزالة الحواف التي قد تكون مهملة
ليتعلّم من جديد الموارد التي تستخدمها المهمة هذه المرة.
أما مجموعة الـ tuples الخاصة بنا فتجعل الإجابة
عن أيٍّ من هذين السؤالين غير سهلة.
لو احتجنا أن نعرف العلاقة بين api.html
وبقية الرسم البياني،
لضروري سنضطر إلى اجتياز المجموعة كلها
بحثاً عن حواف تبدأ أو تنتهي عند عقدة api.html.
فبنية بيانات ترابطية مثل dict في Python ستجعل هذه الأعمال أسهل بإتاحتها البحث المباشر عن كل الحواف الخاصة بعقدة بعينها:
    {'tutorial.rst': {('tutorial.rst', 'tutorial.html')},
     'tutorial.html': {('tutorial.rst', 'tutorial.html')},
     'index.rst': {('index.rst', 'index.html')},
     'index.html': {('index.rst', 'index.html')},
     'api.rst': {('api.rst', 'api.html')},
     'api.html': {('api.rst', 'api.html')}}
أصبح البحث عن حواف عقدة بعينها سريعاً جداً الآن، على حساب اضطرارنا لتخزين كل حافة مرتين: مرة في مجموعة الحواف الداخلة، ومرة في مجموعة الحواف الخارجة. لكن الحواف في كل مجموعة سيتعين فحصها يدوياً لرؤية أيها داخلة وأيها خارجة. كما أن تكرار تسمية العقدة في مجموعة حوافها مرة بعد مرة أمر زائد بعض الشيء.
والحل لهذين الاعتراضين معاً هو وضع الحواف الداخلة والخارجة في بنيتي بيانات منفصلتين خاصتهما، وهذا سيعفينا أيضاً من الحاجة إلى ذكر العقدة مرة بعد مرة لكل حافة من الحواف التي تشارك فيها.
    incoming = {
        'tutorial.html': {'tutorial.rst'},
        'index.html': {'index.rst'},
        'api.html': {'api.rst'},
        }

    outgoing = {
        'tutorial.rst': {'tutorial.html'},
        'index.rst': {'index.html'},
        'api.rst': {'api.html'},
        }
لاحظ أن outgoing يمثّل، مباشرةً في صياغة Python،
تماماً ما رسمناه في graph سابقاً:
فالمستندات المصدرية على اليسار
سيحوّلها نظام البناء إلى
مستندات المخرجات على اليمين.
وفي هذا المثال البسيط يشير كل مصدر إلى مُخرج واحد فقط —
فكل مجموعات المخرجات تحتوي عنصراً واحداً فقط —
لكننا سنرى بعد قليل أمثلة يكون فيها عقدة مُدخل واحدة
عواقب نزولية متعددة.
كل حافة في بنية بيانات القاموس-من-المجموعات هذه
تُمثَّل مرتين فعلاً،
مرة كحافة خارجة من عقدة
(tutorial.rst → tutorial.html)
ومرة أخرى كحافة داخلة إلى الأخرى
(tutorial.html ← tutorial.rst).
وهذان التمثيلان يلتقطان العلاقة نفسها تماماً،
بل من منظورَي العقدتين المتقابلتين
على طرفي الحافة.
لكن مقابل هذه التكرارية،
تدعم بنية البيانات البحث السريع الذي يحتاجه Contingent.
الاستخدام الصحيح للأصناف
ربما فاجأك غياب الأصناف في نقاش بنى بيانات Python أعلاه. فالأصناف، بعد كل شيء، آلية متكررة لتنظيم التطبيقات وموضوع لا يقل تكراراً عن جدل محتدم بين أنصارها ومانعيها. وقد ظُنّ وقتاً ما أن الأصناف مهمة بالقدر الذي صُممت حوله مناهج تعليمية كاملة، وتضمّ معظم لغات البرمجة الشائعة صياغة مخصّصة لتعريفها واستخدامها.
لكن اتضح أن الأصناف غالباً ما تكون متعامدة مع مسألة تصميم بنى البيانات. فهي لا تقدّم لنا نموذجاً بديلاً تماماً لنمذجة البيانات، بل تكتفي بتكرار بنى البيانات التي رأيناها بالفعل:
- نسخة الصنف مُنفَّذة على هيئة dict.
- نسخة الصنف تُستخدم مثل tuple قابل للتغيير.
يقدّم الصنف البحث بالمفتاح عبر صياغة أجمل،
حيث يمكنك أن تكتب graph.incoming
بدلاً من graph["incoming"].
لكن في الواقع، نادراً ما تُستخدم نسخ الأصناف
كمخازن مفاتيح-قيم عامة.
بدلاً من ذلك، تُستخدم لتنظيم بيانات مترابطة لكنها غير متجانسة
حسب اسم الخاصية،
مع تفاصيل التنفيذ مغلّفة خلف
واجهة متسقة يسهل تذكّرها.
فبدلاً من ضم اسم مضيف ورقم منفذ معاً في tuple
والاضطرار إلى تذكّر أيهما جاء أولاً وأيهما جاء ثانياً،
تنشئ صنف Address
تملك نسخه كل منها سمتي host وport.
بعدها تستطيع تمرير كائنات Address هنا وهناك
حيث كان عليك وإلا أن تستعمل tuples مجهولة الهوية.
تصير الشيفرة أسهل في القراءة وأسهل في الكتابة.
لكن استخدام نسخة صنف لا يغيّر حقاً
أياً من الأسئلة التي واجهناها أعلاه عند تصميم البيانات،
بل يوفّر حاوية أجمل وأقل جهالة.
فالقيمة الحقيقية للأصناف إذن ليست في أنها تغيّر علم تصميم البيانات. بل قيمة الأصناف في أنها تتيح لك إخفاء تصميم بياناتك عن بقية البرنامج!
فنجاح تصميم التطبيقات
يقوم على قدرتنا على الاستفادة
من بنى البيانات المدمجة القوية التي توفّرها لنا Python
مع تقليل حجم التفاصيل التي يُشترط علينا
الاحتفاظ بها في أذهاننا في كل لحظة.
تقدّم الأصناف آلية لحل هذه المعضلة الظاهرية:
فالصنف المستخدم بفاعلية يوفّر واجهة
حول مجموعة فرعية صغيرة من تصميم النظام الإجمالي.
وحين نعمل داخل مجموعة فرعية واحدة — كـ Graph مثلاً —
يستطيع المرء أن ينسى تفاصيل التنفيذ للمجموعات الفرعية الأخرى
طالما استطاع تذكّر واجهاتها.
وهكذا يجد المبرمجون أنفسهم غالباً يتنقّلون
بين عدة مستويات من التجريد
أثناء كتابة نظام،
فتارة يعملون بنموذج البيانات وتفاصيل التنفيذ
لنظام فرعي بعينه،
وتارة يربطون المفاهيم الأعلى عبر واجهاتها.
فمثلاً، من الخارج،
يمكن للشيفرة أن تطلب نسخة Graph جديدة ببساطة:
>>> from contingent import graphlib
>>> g = graphlib.Graph()
دون الحاجة إلى فهم تفاصيل كيفية عمل Graph.
والشيفرة التي تستخدم الرسم البياني فحسب
ترى أفعال الواجهة — استدعاءات التوابع —
عند التعامل مع رسم بياني،
كما حين تُضاف حافة أو تُنفَّذ عملية أخرى:
>>> g.add_edge('index.rst', 'index.html')
>>> g.add_edge('tutorial.rst', 'tutorial.html')
>>> g.add_edge('api.rst', 'api.html')
ولعلّ القراء الدقيقين لاحظوا أننا أضفنا حواف إلى رسمنا البياني دون أن ننشئ صراحةً كائنات «عقدة» و«حافة»، وأن العقد في هذه الأمثلة المبكرة ليست سوى سلاسل نصية. المنحدر من لغات وتقاليد أخرى، قد كان المرء يتوقع أن يرى أصنافاً وواجهات معرّفة من المستخدم لكل شيء في النظام:
    Graph g = new ConcreteGraph();
    Node indexRstNode = new StringNode("index.rst");
    Node indexHtmlNode = new StringNode("index.html");
    Edge indexEdge = new DirectedEdge(indexRstNode, indexHtmlNode);
    g.addEdge(indexEdge);
تُشدّد لغة Python ومجتمعها صراحةً وبقصد على استخدام بنى بيانات بسيطة وعامة لحل المشكلات، بدلاً من إنشاء أصناف مخصّصة لكل تفصيل دقيق في المشكلة التي نريد معالجتها. وهذه إحدى وجوه مفهوم الحلول «البايثونية»: فالحلول البايثونية تحاول تقليل العبء الصياغي والاستفادة من أدوات Python المدمجة القوية ومكتبتها القياسية الواسعة.
ولهذه الاعتبارات في الاعتبار،
لنعد إلى صنف Graph،
نفحص تصميمه وتنفيذه لنرى
التفاعل بين بنى البيانات وواجهات الأصناف.
حين تُبنى نسخة Graph جديدة،
فقد سبق أن بُني زوج من القواميس
لتخزين الحواف بالمنطق الذي خطّطناه في القسم السابق:
class Graph:
    """A directed graph of the relationships among build tasks."""

    def __init__(self):
        self._inputs_of = defaultdict(set)
        self._consequences_of = defaultdict(set)
الشرطة السفلية السابعة
أمام أسماء السمتين _inputs_of و_consequences_of
هي عُرف شائع في مجتمع Python
للإشارة إلى أن السمة خاصة.
وهذا العرف إحدى الطرق التي يقترح بها المجتمع
أن يتبادل المبرمجون الرسائل والتحذيرات
بين بعضهم عبر المكان والزمن.
ولما ادركوا الحاجة إلى الإشارة إلى الفرق بين
سمات الكائن العامة والداخلية،
اعتمد المجتمع الشرطة السفلية السابعة المفرغة
مؤشراً موجزاً ومتّسقاً إلى حدّ كبير
للمبرمجين الآخرين،
بما في ذلك أنفسنا في المستقبل،
على أن تُعامَل هذه السمة باعتبارها
جزءاً من الآلية الداخلية غير المرئية للصنف.
ولماذا نستخدم defaultdict بدل dict عادية؟
فالمشكلة الشائعة عند تركيب القواميس
مع بنى بيانات أخرى هي معالجة المفاتيح المفقودة.
ومع dict عادية،
يجلب مفتاح غير موجود خطأً من نوع KeyError:
>>> consequences_of = {}
>>> consequences_of['index.rst'].add('index.html')
Traceback (most recent call last):
     ...
KeyError: 'index.rst'
وتتطلب استخدام dict عادية فحوصاً خاصة في أنحاء الشيفرة لمعالجة هذه الحالة تحديداً، مثلاً عند إضافة حافة جديدة:
    # Special case to handle “we have not seen this task yet”:

    if input_task not in self._consequences_of:
        self._consequences_of[input_task] = set()

    self._consequences_of[input_task].add(consequence_task)
وهذه الحاجة شائعة لدرجة أن تتضم Python أداة خاصة
هي defaultdict، التي تتيح لك تقديم دالة
تُعيد قيمة للمفاتيح الغائبة.
وحين نسأل عن حافة لم يرها Graph بعد،
سنحصل على set فارغ بدلاً من استثناء:
>>> from collections import defaultdict
>>> consequences_of = defaultdict(set)
>>> consequences_of['api.rst']
set()
وتعني صياغة تنفيذنا بهذه الطريقة أن أول استخدام لكل مفتاح يمكن أن يبدو مطابقاً تماماً لاستخدامه الثاني وما بعده:
>>> consequences_of['index.rst'].add('index.html')
>>> 'index.html' in consequences_of['index.rst']
True
وبهذه التقنيات، لنفحص تنفيذ
add_edge، التي استخدمناها سابقاً
لبناء الرسم البياني لـ graph.
    def add_edge(self, input_task, consequence_task):
        """Add an edge: `consequence_task` uses the output of `input_task`."""
        self._consequences_of[input_task].add(consequence_task)
        self._inputs_of[consequence_task].add(input_task)
تُخفي هذه الطريقة الحقيقة أن خطوتي تخزين، لا خطوة واحدة،
مطلوبتان لكل حافة جديدة
كي نعرف عنها في الاتجاهين معاً.
ولاحظ كيف لا يعرف add_edge() ولا يهمّه
ما إذا كانت أي من العقدتين قد ظهرت من قبل.
ولأن بنى المُدخلات والعواقب
كلاً منهما defaultdict(set)،
يبقى تابع add_edge() غافلاً تماماً
بشأن كون العقدة جديدة —
فـ defaultdict يتولى الفرق
بإنشاء كائن set جديد على الطيار.
وكما رأينا أعلاه، كان add_edge() سيطول
ثلاثة أضعاف لو لم نستخدم defaultdict.
والأهم من ذلك، سيكون من الأصعب
فهم الشيفرة الناتجة واستنتاج سلوكها.
يُظهر هذا التنفيذ منهجاً بايثونياً
في معالجة المشكلات: بسيط ومباشر وموجز.
كما ينبغي أن يُمنح المستدعون طريقة بسيطة لزيارة كل حافة دون أن يضطروا لتعلّم كيفية اجتياز بنية بياناتنا:
    def edges(self):
        """Return all edges as ``(input_task, consequence_task)`` tuples."""
        return [(a, b) for a in self.sorted(self._consequences_of)
                       for b in self.sorted(self._consequences_of[a])]
ويحاول تابع Graph.sorted()
فرز العقد
بترتيب فرز طبيعي
(مثل الأبجدية)
يمكن أن يوفّر ترتيب مخرجات مستقراً للمستخدم.
وباستخدامنا طريقة الاجتياز هذه نرى أن،
في ضوء استدعاءات «add» الثلاثة السابقة،
يمثّل g الآن الرسم البياني نفسه الذي رأيناه في graph.
>>> from pprint import pprint
>>> pprint(g.edges())
[('api.rst', 'api.html'),
 ('index.rst', 'index.html'),
 ('tutorial.rst', 'tutorial.html')]
ولأننا نملك الآن كائن Python حياً حقيقياً،
لا مجرد رسم تخطيطي،
بوسعنا أن نطرح عليه أسئلة ممتعة!
فمثلاً، حين يبني Contingent مدونة من ملفات مصدرية،
سيحتاج إلى معرفة أمور مثل «ماذا يعتمد على api.rst؟» حين
يتغير محتوى api.rst:
>>> g.immediate_consequences_of('api.rst')
['api.html']
يُخبر هذا Graph لـ Contingent أن،
حين يتغير api.rst،
فقد أصبح api.html مهملاً ويجب إعادة بنائه.
وماذا عن index.html؟
>>> g.immediate_consequences_of('index.html')
[]
لقد أُعيدت قائمة فارغة،
في إشارة إلى أن index.html يقع على الحافة اليمنى من الرسم البياني
وبالتالي لا يلزم إعادة بناء أي شيء آخر إن تغيّر.
ويمكن التعبير عن هذا الاستعلام ببساطة تامة
بفضل العمل الذي أُنجز بالفعل في تخطيط بياناتنا:
    def immediate_consequences_of(self, task):
        """Return the tasks that use `task` as an input."""
        return self.sorted(self._consequences_of[task])
 >>> from contingent.rendering import as_graphviz
 >>> open('figure1.dot', 'w').write(as_graphviz(g)) and None
تجاهل graph إحدى أهم العلاقات التي اكتشفناها في القسم الافتتاحي من فصلنا: طريقة ظهور عناوين المستندات في جدول المحتويات. لنملأ هذه التفصيلة. سننشئ عقدة لكل سلسلة عنوان يجب أن تُولَّد بتحليل ملف مُدخل ثم تُمرَّر إلى أحد إجراءاتنا الأخرى:
>>> g.add_edge('api.rst', 'api-title')
>>> g.add_edge('api-title', 'index.html')
>>> g.add_edge('tutorial.rst', 'tutorial-title')
>>> g.add_edge('tutorial-title', 'index.html')
والنتيجة رسم بياني (graph2) يستطيع على نحو صحيح التعامل مع إعادة بناء جدول المحتويات الذي ناقشناه في افتتاح هذا الفصل.
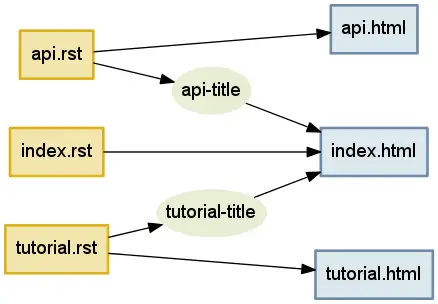
ويوضّح هذا المسح اليدوي ما سيفعله
Contingent في النهاية نيابةً عنا:
فالرسم البياني g يلتقط المُدخلات والعواقب
للمخرجات المختلفة في توثيق مشروعنا.
تعلّم الاتصالات
لدينا الآن طريقة تمكّن Contingent
من تتبّع المهام والعلاقات بينها.
لكن إذا أمعنا النظر في graph2،
لرينا أنه في الواقع قليل الافتراض والتغموض:
كيف يُنتَج api.html من api.rst؟
وكيف نعرف أن index.html يحتاج عنوان الدليل؟
وكيف تُحَلّ هذه التبعية؟
وقد خدمتنا الحدس الأوّلي بهذه الأفكار حين كنا نبني رسوم العواقب يدوياً، لكن الحاسوب للأسف ليس بديهياً إلى حدّ بعيد، لذلك سنحتاج إلى أن نكون أدقّ فيما نريده.
ما الخطوات اللازمة لإنتاج المخرجات من المصادر؟ وكيف تُعرَّف هذه وتُنفَّذ؟ وكيف يمكن لـ Contingent أن يعرف الاتصالات بينها؟
في Contingent، تُنمذَج مهام البناء كتوابع مع وسائط. وتعرّف التوابع إجراءاتً يفهم مشروعٌ بعينه كيفية أدائها. وتقدّم الوسائط التفاصيل: أي مستند مصدر ينبغي قراءته، وأي عنوان مدونة هو المطلوب. وأثناء تشغيلها، قد تستدعي هذه التوابع بدورها توابع مهام أخرى، مع تمرير ما تحتاجه من وسائط لتُجيب عنها.
ولكي نرى كيف يعمل هذا، سننفّذ فعلاً الآن باني التوثيق الموصوف في مطلع الفصل. ولمنع أنفسنا من الغرق في مستنقع من التفاصيل، سنتعامل في هذا المثال التوضيحي مع تنسيقات مستندات مُدخل ومُخرج مبسّطة. ستتألف مستندات مُدخلنا من عنوان في السطر الأول، مع تكوّن بقية النص جسمَ المستند. أما الإحالات المتقاطعة فستكون مجرد أسماء ملفات مصدرية مليوفة بعلامة ارتدة، تُستبدل عند المخرجات بعنوان المستند المقابل في المخرجات.
وهذا هو محتوى مثالنا
index.txt وapi.txt وtutorial.txt،
يوضّح العناوين وجسوم المستندات والإحالات المتقاطعة
من تنسيق مستنداتنا الصغير:
>>> index = """
... Table of Contents
... -----------------
... * `tutorial.txt`
... * `api.txt`
... """

>>> tutorial = """
... Beginners Tutorial
... ------------------
... Welcome to the tutorial!
... We hope you enjoy it.
... """

>>> api = """
... API Reference
... -------------
... You might want to read
... the `tutorial.txt` first.
... """
الآن وبعد أن توفّرت لدينا بعض المواد المصدرية للعمل عليها، ما التوابع التي سيحتاجها باني المدونات المبني على Contingent؟
في الأمثلة البسيطة أعلاه، تنتقل ملفات مخرجات HTML مباشرةً من المصدر، لكن في نظام واقعي، يتطلب تحويل المصدر إلى ترميز عدة خطوات: قراءة النص الخام من القرص، وتحليل النص إلى تمثيل داخلي مريح، ومعالجة أي توجيهات يكون المؤلف قد حدّدها، وحلّ الإحالات المتقاطعة أو غيرها من التبعيات الخارجية (مثل ملفات التضمين)، ثم تطبيق تحويل عرض واحد أو أكثر لتحويل التمثيل الداخلي إلى صيغة مخرجه.
يدير Contingent المهام عبر تجميعها في Project،
وهو نوع من الشخصيات المتسلّطة في أنظمة البناء
يحقن نفسه في منتصف عملية البناء،
مُدوِّناً كل مرة تتحدث فيها مهمة إلى أخرى
ليكوّن رسماً بيانياً للعلاقات بين جميع المهام.
>>> from contingent.projectlib import Project, Task
>>> project = Project()
>>> task = project.task
قد ينطوي نظام البناء للمثال المذكور في مطلع الفصل على بضع مهام.
وستتظاهر مهمة read() لدينا بأنها تقرأ الملفات من القرص.
ولأننا عرّفنا النص المصدر فعلياً في متغيّرات،
فكل ما عليها فعله هو التحويل من اسم ملف
إلى النص المقابل.
  >>> filesystem = {'index.txt': index,
  ...               'tutorial.txt': tutorial,
  ...               'api.txt': api}
  ...
  >>> @task
  ... def read(filename):
  ...     return filesystem[filename]
وتفسّر مهمة parse() النص الخام لمحتويات الملف
وفقاً لمواصفة تنسيق مستنداتنا.
وتنسيقنا بسيط جداً:
يظهر عنوان المستند في السطر الأول،
وتُعتبر بقية المحتوى جسم المستند.
  >>> @task
  ... def parse(filename):
  ...     lines = read(filename).strip().splitlines()
  ...     title = lines[0]
  ...     body = '\n'.join(lines[2:])
  ...     return title, body
ولأن التنسيق بسيط إلى هذا الحد، فالمحلّل ساذج بعض الشيء، لكنه يوضّح مسؤوليات التفسير التي مُلزَم المحلّلات بالاضطلاع بها. (التحليل بصفة عامة موضوع مثير للاهتمام جداً وقد كُتبت عنه كتب كثيرة إما جزئياً أو كلياً.) ففي نظام مثل Sphinx، يجب أن يفهم المحلّل رموز الترميز العديدة، والتوجيهات والأوامر التي يعرّفها النظام، محوّلاً نص المُدخل إلى شيء تستطيع بقية النظام العمل معه.
ولاحظ نقطة الاتصال بين
parse() وread() —
فالخطوة الأولى في التحليل هي تمرير اسم الملف المُعطى
إلى read()، التي تجد محتوى ذلك الملف وتعيده.
مهمة title_of()، عند إعطائها اسم ملف مصدر،
تُعيد عنوان المستند:
  >>> @task
  ... def title_of(filename):
  ...     title, body = parse(filename)
  ...     return title
توضّح هذه المهمة بسهولة
الفصل بين المسؤوليات بين
أجزاء نظام معالجة المستندات.
فالدالة title_of() تعمل مباشرةً
من تمثيل في الذاكرة لمستند —
في هذه الحالة، tuple —
بدلاً من أن تتولى بنفسها إعادة تحليل
المستند بأكمله مرة أخرى لمجرد إيجاد العنوان.
فالدالة parse() وحدها هي التي تنتج التمثيل في الذاكرة،
وفقاً لعقد مواصفة النظام،
بينما تستخدم بقية دوال معالجة باني المدونات
مثل title_of() مخرجات هذه الدالة كمرجع وحيدة لها.
وإن كنت قادماً من تقليد كائني متّفق عليه في التوجّه الكائني،
فقد يبدو هذا التصميم المعتمد على الدوال غريباً بعض الشيء.
في حل كائني تقليدي،
سيقوم parse() بإعادة كائن من نوع Document
يحتوي title_of() كتابع أو خاصية.
وفي الواقع، يعمل Sphinx بهذه الطريقة تماماً:
فنظامه الفرعي Parser ينتج كائن «شجرة مستندات Docutils» (Docutils document tree)
تستخدمه بقية أجزاء النظام.
Contingent ليس مت حازمّاً بشأن أنماط التصميم هذه المختلفة، وهو يدعم أيّ من النهجين على قدم المساواة. وسنُبقي الأمور بسيطة في هذا الفصل.
أما المهمة الأخيرة،
render()،
فتحوّل التمثيل في الذاكرة لمستند
إلى صيغة مخرَج.
هي، بعبارة أخرى، عكس parse().
فبينما تأخذ parse() مستند مُدخل
مطابقاً لمواصفة
وتحوّله إلى تمثيل في الذاكرة،
تأخذ render() تمثيلاً في الذاكرة
وتنتج مستند مخرجات
مطابقاً لمواصفة ما.
  >>> import re
  >>>
  >>> LINK = '<a href="{}">{}</a>'
  >>> PAGE = '<h1>{}</h1>\n<p>\n{}\n<p>'
  >>>
  >>> def make_link(match):
  ...     filename = match.group(1)
  ...     return LINK.format(filename, title_of(filename))
  ...
  >>> @task
  ... def render(filename):
  ...     title, body = parse(filename)
  ...     body = re.sub(r'`([^`]+)`', make_link, body)
  ...     return PAGE.format(title, body)
وهذا مثال على تشغيل
يستدعي كل مرحلة من المنطق أعلاه —
أي يصيّر tutorial.txt لينتج مخرجه:
>>> print(render('tutorial.txt'))
<h1>Beginners Tutorial</h1>
<p>
Welcome to the tutorial!
We hope you enjoy it.
<p>
يوضّح graph3 رسم المهام الذي يصل عبر الوساطة جميع المهام المطلوبة لإنتاج المخرجات، من قراءة ملف المُدخل، إلى تحليل المستند وتحويله، ثم صياغته:

واتضح أن graph3 لم يُرسم يدوياً لهذا الفصل،
بل أُنشئ مباشرةً من Contingent!
فبناء هذا الرسم ممكن لكائن Project
لأنه يحتفظ بمكدس استدعاء خاص به،
شبيهاً بمكدس إطارات التنفيذ الحيّة
الذي يحتفظ به Python ليتذكّر أي تابع يواصل التشغيل
حين يعود الحالي منها.
وفي كل مرة تُستدعى فيها مهمة جديدة، يستطيع Contingent أن يفترض أنها استُدعيت — وأن مخرجاتها ستُستخدم — من المهمة الموجودة حالياً في قمة المكدس. والحفاظ على المكدس يتطلب خطوات إضافية عديدة تحيط باستدعاء المهمة T:
- ادفع T إلى المكدس.
- نفّذ T، ودعها تستدعي أي مهام أخرى تحتاجها.
- اسحب T من المكدس.
- أعِد نتيجتها.
ولاعتراض استدعاءات المهام،
يستفيد Project من خاصية رئيسية في Python: مزخرفات الدوال (function decorators).
ويُسمح للمزخرف بأن يعالج دالةً أو يحوّلها
لحظة تعريفها.
ويستغل مزخرف Project.task هذه الفرصة
ليغلّف كل مهمة داخل دالة أخرى، وهي غلاف (wrapper)،
يتيح فصلاً نظيفاً للمسؤوليات
بين الغلاف —
الذي سيقلق بشأن إدارة الرسم البياني والمكدس
نيابةً عن المشروع —
وبين توابع المهام التي تركز على معالجة المستندات.
وهكذا يبدو هيكل مزخرف task:
        from functools import wraps

        def task(function):
            @wraps(function)
            def wrapper(*args):
                # wrapper body, that will call function()
            return wrapper
وهذا تصريح نمطي تماماً لمزخرف في Python.
ثم يمكن تطبيقه على دالة
بذكر اسمها بعد محرف @ فوق def
الذي ينشئ تلك الدالة:
    @task
    def title_of(filename):
        title, body = parse(filename)
        return title
وحين يكتمل هذا التعريف،
يشير الاسم title_of إلى
النسخة المغلَّفة من الدالة.
ويمكن للغلاف الوصول إلى النسخة الأصلية من الدالة
عبر الاسم function،
فتستدعيها في الوقت المناسب.
ويجري جسم غلاف Contingent
شيئاً على النحو التالي:
    def task(function):
        @wraps(function)
        def wrapper(*args):
            task = Task(wrapper, args)
            if self.task_stack:
                self._graph.add_edge(task, self.task_stack[-1])
            self._graph.clear_inputs_of(task)
            self._task_stack.append(task)
            try:
                value = function(*args)
            finally:
                self._task_stack.pop()

            return value
        return wrapper
ويؤدي هذا الغلاف عدة خطوات صيانة جوهرية:
-
يغلّف المهمة — دالة مع وسائطها — في كائن صغير لأغراض الراحة. واسم
wrapperهنا يشير إلى النسخة المغلَّفة من دالة المهمة. -
إذا استُدعيت هذه المهمة من مهمة جارية بالفعل، فإضافة حافة تسجّل أن هذه المهمة مُدخل للمهمة الجارية.
-
أنسَ كل ما قد تعلّمناه في المرة السابقة عن المهمة، لأنها قد تتخذ قرارات مختلفة هذه المرة — فإذا لم يعد النص المصدري لدليل الـ API يذكر الدليل، مثلاً، فلن يطلب
render()منهtitle_of()لمستند الدليل. -
ادفع هذه المهمة إلى قمة مكدس المهام تحسباً لأن تقرّر بدورها استدعاء مزيد من المهام في أثناء تنفيذ عملها.
-
استدعِ المهمة داخل كتلة
try...finallyتضمن لنا إزالة المهمة المنتهية من المكدس على نحو صحيح، حتى لو ماتت بإثارة استثناء. -
أعِد قيمة إرجاع المهمة، كي لا يستطيع المستدعون لهذا الغلاف أن يتيقنوا أنهم لم يستدعوا دالة المهمة المجرّدة نفسها.
وتحافظ الخطوتان 4 و5 على مكدس المهام ذاته، ثم تستخدمه الخطوة 2 في إجراء تتبّع العواقب الذي هو سببنا كله لبناء مكدس المهام في المقام الأول.
ولأن كل مهمة تُحاط بنسختها الخاصة من دالة الغلاف، فإن مجرد استدعاء مكدس المهام العادي وتنفيذه سينتج رسماً بيانياً للعلاقات كأثر جانبي غير مرئي. ولهذا على استخدام الغلاف حول كل خطوة معالجة عرّفناها:
    @task
    def read(filename):
        # body of read

    @task
    def parse(filename):
        # body of parse

    @task
    def title_of(filename):
        # body of title_of

    @task
    def render(filename):
        # body of render
وبفضل هذه الأغلفة،
حين استدعينا parse('tutorial.txt')
تعلّم المزخرف
الاتصال بين parse وread.
ويمكننا السؤال عن العلاقة ببناء tuple Task آخر
والسؤال عن العواقب التي ستكون
لو تغيّرت قيمة مخرجه:
>>> task = Task(read, ('tutorial.txt',))
>>> print(task)
read('tutorial.txt')
>>> project._graph.immediate_consequences_of(task)
[parse('tutorial.txt')]
ونتيجة إعادة قراءة ملف tutorial.txt
والاكتشاف بأن محتوياته قد تغيّرت
هي أننا بحاجة إلى إعادة تنفيذ الإجراء parse() لذلك المستند.
وماذا يحدث إذا صوّرنا مجموعة المستندات بأكملها؟
هل سيكون Contingent قادراً على تعلّم عملية البناء كلها؟
>>> for filename in 'index.txt', 'tutorial.txt', 'api.txt':
...     print(render(filename))
...     print('=' * 30)
...
<h1>Table of Contents</h1>
<p>
* <a href="tutorial.txt">Beginners Tutorial</a>
* <a href="api.txt">API Reference</a>
<p>
==============================
<h1>Beginners Tutorial</h1>
<p>
Welcome to the tutorial!
We hope you enjoy it.
<p>
==============================
<h1>API Reference</h1>
<p>
You might want to read
the <a href="tutorial.txt">Beginners Tutorial</a> first.
<p>
==============================
نجح! ومن المخرجات نرى أن تحويلنا قد استبدل بعناوين المستندات التوجيهات في مستنداتنا المصدرية، مما يدل على أن Contingent استطاع اكتشاف الاتصالات بين المهام المختلفة اللازمة لبناء مستنداتنا.
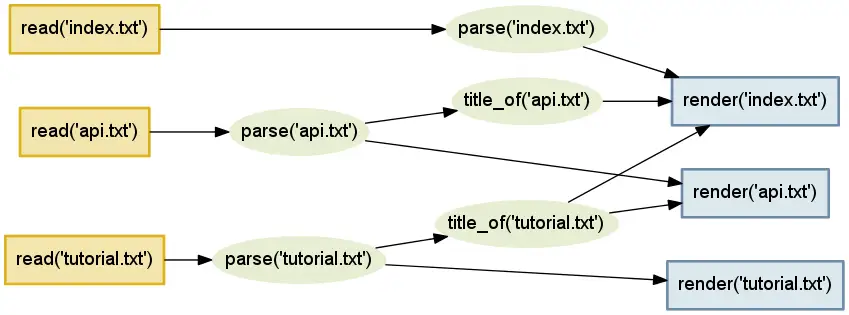
وبمراقبة مهمة تستدعي مهمة أخرى
عبر آليات غلاف task،
تعلّم Project تلقائياً
رسم المُدخلات والعواقب.
ولأنه يمتلك رسماً كاملاً للعواقب
في متناوله،
يعرف Contingent كل ما يلزم إعادة بنائه
لو تغيّرت مُدخلات أي مهمة.
ملاحقة العواقب
ما إن تكتمل البناء الأولي،
يحتاج Contingent إلى مراقبة ملفات المُدخل بحثاً عن تغييرات.
وحين ينهي المستخدم تعديلاً جديداً ويضغط «حفظ»،
يلزم استدعاء كل من تابع read() وعواقبه.
وسيتطلب ذلك أن نُسير في الرسم البياني بالاتجاه المعاكس
للاتجاه الذي أُنشئ به.
فقد بُني، كما تتذكّر، باستدعاء
render() لمرجع الـ API وجعل ذلك الاستدعاء ينادي parse()
الذي استدعى بدوره مهمة read().
والآن نذهب في الاتجاه الآخر:
نعلم أن read() ستُعيد الآن محتوى جديداً،
ونحتاج إلى تحديد ما إذا كانت هناك عواقب في مجرى النهرالأولى..
وتجميع العواقب عملية تكرارية،
إذ يمكن لكل عاقبة أن تكون لها هي الأخرى مهام تعتمد عليها.
ويمكننا تنفيذ هذا التكرار يدوياً
عبر استدعاءات متكررة للرسم البياني.
(ولاحظ أننا نستفيد هنا
من أن موجّه Python يحفظ آخر قيمة معروضة
باسم _ لاستخدامها في التعبير التالي.)
>>> task = Task(read, ('api.txt',))
>>> project._graph.immediate_consequences_of(task)
[parse('api.txt')]
>>> t1, = _
>>> project._graph.immediate_consequences_of(t1)
[render('api.txt'), title_of('api.txt')]
>>> t2, t3 = _
>>> project._graph.immediate_consequences_of(t2)
[]
>>> project._graph.immediate_consequences_of(t3)
[render('index.txt')]
>>> t4, = _
>>> project._graph.immediate_consequences_of(t4)
[]
وهذه المهمة التكرارية التي تبحث مراراً عن العواقب الفورية
ولا تتوقف إلا عند بلوغنا مهام لا عواقب لها فحسب،
هي عملية رسم بيانية بالقدر الكافي من البساطة
فتُدعم مباشرةً بطريقة على صنف Graph:
>>> # Secretly adjust pprint to a narrower-than-usual width:
>>> _pprint = pprint
>>> pprint = lambda x: _pprint(x, width=40)
>>> pprint(project._graph.recursive_consequences_of([task]))
[parse('api.txt'),
 render('api.txt'),
 title_of('api.txt'),
 render('index.txt')]
وفي الحقيقة، تحاول recursive_consequences_of() أن تكون ذكية بعض الشيء.
فإذا ظهرت مهمة بعينها مراراً كعاقبة لاحقة
لمهام أخرى عديدة،
فإنها حريصة على ذكرها مرة واحدة فقط في قائمة المخرجات،
وعلى نقلها قرب النهاية
بحيث لا تظهر إلا بعد المهام التي تمثّل مُدخلاتها.
وتستمد هذه الذكاء من التنفيذ الكلاسيكي بالعمق أولاً
للفرز الطوبولوجي،
وهي خوارزمية (algorithm) يتهيّر كتابتها في Python بسهولة تامة
عبر تابع مساعد تكراري خفي.
تفحّص شيفرة graphlib.py للتفاصيل.
وإذا، عند اكتشاف تغيير،
حرصنا على إعادة تشغيل كل مهمة في العواقب التكرارية،
فسيتمكّن Contingent من تجنّب إعادة بناء أقل مما ينبغي.
أما تحدّينا الثاني،
فكان تجنّب إعادة البناء أكثر مما ينبغي.
ارجع مرة أخرى إلى graph4.
نريد تجنّب إعادة بناء المستندات الثلاثة كلها
في كل مرة يُغيَّر فيها tutorial.txt،
إذ لن يؤثر معظم التعديلات على العنوان بل على الجسم فحسب.
فكيف يمكن إنجاز ذلك؟
الحل هو جعل إعادة حساب الرسم البياني معتمدة على التخزين المؤقت. فحين نتقدّم إلى الأمام في العواقب التكرارية للتغيير، لن نستدعي إلا المهام التي تختلف مُدخلاتها عن المرة السابقة.
وسيطوي هذا التحسين على بنية بيانات أخيرة.
سنمنح Project مجموعة _todo
نتذكّر بها كل مهمة
تغيّر فيها قيمة مُدخل واحد على الأقل،
وبالتالي تتطلب إعادة التنفيذ.
ولأن المهام الواردة في _todo وحدها هي المهملة،
فقد يستطيع عملية البناء تخطّي تشغيل أي مهمة
إلا إذا ظهرت هناك.
مرة أخرى، يجعل تصميم Python المريح والموحّد
هذه الميزات سهلة الترميز جداً.
ولأن كائنات المهام قابلة للتجزئة،
يمكن أن تكون _todo مجرد مجموعة
تتذكّر عناصر المهمة بالهوية —
مما يضمن ألّا تظهر المهمة أبداً مرتين —
ويمكن أن يكون _cache لقيم الإرجاع من التشغيلات السابقة
قاموساً تكون المهام فيه هي المفاتيح.
وبدقّة أكبر، يجب أن تستمر خطوة إعادة البناء في التكرار
ما دامت _todo غير فارغة.
وفي كل دورة، ينبغي أن:
-
تنادي
recursive_consequences_of()وتمرّر إليها كل مهمة مذكورة في_todo. وستكون القيمة المُرجَعة قائمة لا على المهام في_todoنفسها فحسب، بل على كل مهمة تنحدر منها — أي بكل مهمة، بمعنى آخر، قد تحتاج إلى إعادة تنفيذ لو خرجت المخرجات مختلفة هذه المرة. -
لكل مهمة في القائمة، تتحقق مما إذا كانت مذكورة في
_todo. فإن لم تكن، فيمكننا تخطي تشغيلها، لأن أيا من المهام التي أعِدنا استدعاؤها في مجرى النهر الأعلى منها لم يُنتج قيمة إرجاع جديدة تستوجب إعادة حساب تلك المهمة. -
أما أي مهمة مذكورة فعلاً في
_todoحين نصل إليها، فعلينا أن نطلب منها أن تعيد التشغيل وتعيد حساب قيمة إرجاعها. فإذا اكتشفت دالة غلاف المهمة أن قيمة الإرجاع هذه لا تطابق القيمة القديمة المخزَّنة مؤقتاً، فستُضاف مهامها اللاحقة تلقائياً إلى_todoقبل أن نصل إليها في قائمة العواقب التكرارية.
وحين نصل إلى نهاية القائمة،
ينبغي أن تكون كل مهمة قد تحتاج إلى إعادة التشغيل
أُعيد تشغيلها فعلاً.
لكن احتياطاً، سنفحص _todo
ونحاول مرة أخرى إن لم تكن فارغة بعد.
حتى مع أشجار تبعيات شديدة التغيّر،
ينبغي أن يستقر هذا سريعاً.
ولا يمكن أن يبقي الباني في حلقة لا نهائية
سوى وجود دورة —
حيث تحتاج مهمة A مثلاً إلى مخرج المهمة B
التي تحتاج بدورها إلى مخرج المهمة A —
وذلك فقط إن لم تستقر قيم إرجاعها أبداً.
ولحسن الحظ، مهام البناء في العالم الحقيقي خالية عادةً من الدورات.
ولنتتبّع سلوك هذا النظام عبر مثال.
فلنفترض أنك حرّرت tutorial.txt
وغيّرت العنوان ومحتوى الجسم معاً.
ويمكننا محاكاة ذلك بتعديل القيمة
في قاموس filesystem لدينا:
>>> filesystem['tutorial.txt'] = """
... The Coder Tutorial
... ------------------
... This is a new and improved
... introductory paragraph.
... """
والآن وقد تغيّرت المحتويات،
يستطيع Project إعادة تشغيل مهمة read()
باستخدام مدير السياق cache_off() الخاص به
الذي يعطّل مؤقتاً استعداده
لإعادة نتيجة قديمة مخزَّنة مؤقتاً لمهمة ووسائط معيّنة:
>>> with project.cache_off():
...     text = read('tutorial.txt')
لقد قُرئ الآن نص الدليل الجديد إلى المخزن المؤقت. كم عدد المهام النازلة التي ستحتاج إلى إعادة التنفيذ؟
ولتساعدنا في الإجابة عن هذا السؤال،
يدعم صنف Project آلية تتبّع بسيطة
تخبرنا بالمهام التي نُفِّذت في أثناء
عملية إعادة بناء.
ولأن التغيير السابق في tutorial.txt
يؤثر في جسمه وعنوانه معاً،
فإن كل ما ينحدر منه سيحتاج إلى إعادة الحساب:
>>> project.start_tracing()
>>> project.rebuild()
>>> print(project.stop_tracing())
calling parse('tutorial.txt')
calling render('tutorial.txt')
calling title_of('tutorial.txt')
calling render('api.txt')
calling render('index.txt')
وبالنظر إلى الوراء في graph4،
سترى أن، كما هو متوقّع،
هذه هي كل مهمة عاقبة فورية أو نازلة
لـ read('tutorial.txt').
لكن ماذا لو حرّرناه مرة أخرى، لكن مع ترك العنوان كما هو هذه المرة؟
>>> filesystem['tutorial.txt'] = """
... The Coder Tutorial
... ------------------
... Welcome to the coder tutorial!
... It should be read top to bottom.
... """
>>> with project.cache_off():
...     text = read('tutorial.txt')
هذا التغيير الصغير والمحدود لا ينبغي أن يكون له أي أثر على المستندات الأخرى.
>>> project.start_tracing()
>>> project.rebuild()
>>> print(project.stop_tracing())
calling parse('tutorial.txt')
calling render('tutorial.txt')
calling title_of('tutorial.txt')
نجح!
أُعيد بناء مستند واحد فقط.
وحقيقة أن title_of()، وقد أُعطيت مستند مُدخل جديداً،
أعادت القيمة نفسها في كل الأحوال، تعني أن كل المهام
النازلة الأبعد قد اعتُزلت عن التغيير
ولم تُستدعَ من جديد.
الخاتمة
هناك لغات ومنهجيات برمجية تحت ظلالها يكون فيها Contingent غابةً خانقة من أصناف صغيرة ضئيلة، تُعطى فيها أسماء مطوّلة لكل مفهوم في مجال المشكلة.
غير أن برمجتنا لـ Contingent بـ Python،
تجاوزنا إنشاء بضع عشرات من الأصناف الممكنة مثل
TaskArgument وCachedResult وConsequenceList.
واعتمدنا بدلاً من ذلك على تقليد Python القوي
في حل المشكلات العامة ببنى بيانات عامة،
فأنتج ذلك شيفرة تستخدم مراراً مجموعة صغيرة من الأفكار
المأخوذة من بنى البيانات الأساسية: tuple وlist وset وdict.
لكن ألّا يسبب هذا مشكلة؟
فبنى البيانات العامة، بطبيعتها، مجهولة الهوية.
مشروع project._cache هو set.
وكذلك كل مجموعة من العقد الداخلة والنازلة
داخل Graph.
هل نحن معرَّضون لرؤية رسائل خطأ عامة من نوع set
مع عدم معرفة إن كان علينا البحث في تنفيذ المشروع أم الرسم البياني؟
أجل، أقلعنا ذلك.
ولحسن الحظ، لا نحن في خطر!
فبفضل انضباط التغليف الدقيق —
بالسماح لشيفرة Graph وحدها بلمس مجموعات الرسم البياني،
ولشيفرة Project وحدها بلمس مجموعة المشروع —
لن يقع أي التباس أبداً إذا أرجعت عملية على مجموعة
خطأ في مرحلة لاحقة من المشروع.
فاسم أعمق تابع قيد التنفيذ لحظة وقوع الخطأ
سيوجّهنا بالضبط إلى الصنف والمجموعة
المتورّطين في الخطأ.
ولا حاجة إلى إنشاء صنف فرعي من set
لكل تطبيق ممكن لنوع البيانات،
ما دمنا نضع تلك الشرطة السفلية الاصطلاحية أمام سمات بنى
البيانات ثم نحرص على عدم لمسها
من شيفرة خارج الصنف.
من كتاب أنماط التصميم (Design Patterns) الأجيالي، يُظهر Contingent مدى أهمية نمط الواجهة (Facade)، لبرنامج Python المصمَّم بعناية. فليست كل بنية بيانات وكل جزء من البيانات في برنامج Python يستحق أن يكون صنفه الخاص. بدلاً من ذلك، تُستخدم الأصناف باعتدال، عند المفاصل المفاهيمية في الشيفرة حيث يمكن لفكرة كبرى — كفكرة رسم التبعيات البياني — أن تُغلَّف في واجهة (Facade) تخفي تفاصيل بنى البيانات العامة البسيطة التي تقع تحتها.
والشيفرة خارج الواجهة تسمّي المفاهيم الكبرى التي تحتاجها والعمليات التي ترغب في تنفيذها. وداخل الواجهة، يتعامل المبرمج مع القطع المتحركة الصغيرة والمريحة في لغة برمجة Python لإنجاز تلك العمليات.