التجميع بالتوافق
داستن مطوّر برمجيات مفتوحة المصدر ومهندس إصدارات في موزيلا. عمل على مشاريع متنوّعة كتظام إعدادات مضيف في Puppet، وإطار عمل ويب مبني على Flask، واختبارات وحدات لإعدادات الجُدُر النارية، وإطار تكامل مستمر في Python التوأم. تجده على GitHub باسم @djmitche أو على dustin@mozilla.com.
مقدّمة
في هذا الفصل، سنستكشف تنفيذ بروتوكول شبكي مصمَّم لدعم الحوسبة الموزّعة الموثوقة. وقد يكون من الصعب تنفيذ بروتوكولات الشبكة تنفيذاً صحيحاً، لذا سننظر في بعض التقنيات لتقليل الأخطاء وللالتقاط ما تبقى منها وإصلاحه. كما يتطلّب بناء برمجيات موثوقة بدورها بعض التقنيات الخاصة في التطوير والتنقيح.
مثال تحفيزي
يركّز هذا الفصل على تنفيذ البروتوكول، لكن دعنا نتأمّل، كمثال تحفيزي، خدمة بسيطة لإدارة الحسابات المصرفية. في هذه الخدمة، لكل حساب رصيد حالي ويُعرَّف برقم حساب. يصل إليها المستخدمون بطلب عمليات مثل «إيداع» أو «تحويل» أو «جلب الرصيد». وتعمل عملية «التحويل» على حسابين في الوقت نفسه - حساب المصدر وحساب الوجهة - ويجب رفضها إذا كان رصيد حساب المصدر منخفضاً جداً.
إن كانت الخدمة مستضافة على خادم واحد، فتنفيذ ذلك سهل: استخدم قفلاً (lock) للتأكّد من أن عمليات التحويل لا تعمل على التوازي، وتحقّق من رصيد حساب المصدر داخل تلك الدالة. لكن لا يمكن المصرفي الاعتماد على خادم واحد لأرصدة حساباته الحرجة. بدلاً من ذلك، تكون الخدمة موزَّعة على عدة خوادم، يعمل كل منها نسخة منفصلة من الشيفرة نفسها بالضبط. ويمكن للمستخدمين عندئذٍ الاتصال بأي خادم لتنفيذ عملية.
في تنفيذي ساذج للمعالجة الموزّعة، سيحتفظ كل خادم بنسخة محلية من رصيد كل حساب. وسيعالج أي عمليات يتلقّاها، ويرسل تحديثات لأرصدة الحسابات إلى الخوادم الأخرى. لكن هذا النهج يقدّم وضع فشل خطيراً: إذا عالج خادمان عمليات للحساب نفسه في الوقت نفسه، فأي رصيد جديد هو الصحيح؟ وحتى لو تبادل الخوادم العمليات فيما بينها بدلاً من الأرصدة، فإن تحولين متزامنين من حساب واحد قد يُفرِغان الحساب إلى ما دون الصفر.
في جوهرها، تحدث هذه الإخفاقات عندما تستخدم الخوادم حالتها المحلية لتنفيذ العمليات، دون التأكّد أولاً من أن الحالة المحلية تطابق الحالة على الخوادم الأخرى. فمثلاً، تخيّل أن الخادم A يتلقّى عملية تحويل من الحساب 101 إلى الحساب 202، بينما يكون الخادم B قد عالج بالفعل تحويلاً آخر لرصيد الحساب 101 كاملاً إلى الحساب 202، دون أن يكون قد أخبر الخادم A بعد. الحالة المحلية على الخادم A تختلف عن نظيرتها على الخادم B، لذا يسمح الخادم A خطأً بإتمام التحويل، رغم أن النتيجة هي سحب رصيد الحساب 101 إلى ما دون الصفر.
آلات الحالة الموزّعة
تُسمّى التقنية التي تتجنّب هذه المشاكل «آلة حالة موزّعة» (distributed state machine). والفكرة أن كل خادم ينفّذ آلة حالة حتمية (deterministic) نفسها تماماً على المدخلات نفسها تماماً. وبطبيعة آلات الحالة، سي يرى كل خادم المخرجات نفسها تماماً. وتمثّل عمليات مثل «التحويل» أو «جلب الرصيد»، مع وسائطها (أرقام الحسابات والمبالغ)، المدخلات الخاصة بآلة الحالة.
آلة الحالة لهذا التطبيق بسيطة:
    def execute_operation(state, operation):
        if operation.name == 'deposit':
            if not verify_signature(operation.deposit_signature):
                return state, False
            state.accounts[operation.destination_account] += operation.amount
            return state, True
        elif operation.name == 'transfer':
            if state.accounts[operation.source_account] < operation.amount:
                return state, False
            state.accounts[operation.source_account] -= operation.amount
            state.accounts[operation.destination_account] += operation.amount
            return state, True
        elif operation.name == 'get-balance':
            return state, state.accounts[operation.account]
لاحظ أن تنفيذ عملية «جلب الرصيد» لا يعدّل الحالة، لكنه مع ذلك منفَّذ كانتقال حالة. وهذا يضمن أن الرصيد المُرجَع هو أحدث معلومة في مجموعة الخوادم (cluster)، وليس مستمدّاً من الحالة المحلية (والتي قد تكون قديمة) على خادم واحد.
قد يبدو هذا مختلفاً عن آلة الحالة المعتادة التي ستتعلّمها في دورة علوم حاسوب. فبدلاً من مجموعة منتهية من الحالات المسمّاة ذات انتقالات موسومة، تكون حالة هذه الآلة هي مجموعة أرصدة الحسابات، لذا فهناك عدد لا نهائي من الحالات الممكنة. ومع ذلك، تنطبق القواعد المعتادة لآلات الحالة الحتمية: البدء بالحالة نفسها ومعالجة العمليات نفسها سينتج دائماً المخرجات نفسها.
إذن، تقنية آلة الحالة الموزّعة تضمن أن العمليات نفسها تحدث على كل مضيف. لكن المشكلة تبقى في ضمان أن يتفق كل خادم على مدخلات آلة الحالة. وهذه مسألة توافق (consensus)، وسنعالجها باستخدام اشتقاق من خوارزمية Paxos.
التوافق عبر Paxos
صَفَ Leslie Lamport خوارزمية Paxos في ورقة خيالية، قُدِّمت أول مرة عام 1990 ونُشرت في النهاية عام 1998، بعنوان «البرلمان بدوام جزئي»[1]. وتتضمّن ورقة Lamport تفصيلاً أكبر بكثير مما سنُغوص فيه هنا، وهي قراءة ممتعة. وتصف المراجع في نهاية الفصل بعض امتدادات الخوارزمية التي تبنّينا عليها في هذا التنفيذ.
تقدّم أبسط صيغة لـ Paxos طريقةً لمجموعة من الخوادم للاتفاق على قيمة واحدة، إلى الأبد. وتبني Multi-Paxos على هذه الأساس بالتّفق على تسلسل مرقّم من الوقائع، واحداً تلو الآخر. ولتنفيذ آلة حالة موزّعة، نستخدم Multi-Paxos للاتفاق على كل مُدخَل من مُدخلات آلة الحالة، ثم ننفّذها بالتسلسل.
Paxos البسيط
لنبدأ إذن بـ «Paxos البسيط»، المعروف أيضاً ببروتوكول Synod، الذي يوفّر طريقة للاتفاق على قيمة واحدة لا يمكن أن تتغيّر أبداً. واسم Paxos يأتي من الجزيرة الخيالية في «البرلمان بدوام جزئي»، حيث يصوّت المشرّعون على التشريعات عبر عملية سماّاها Lamport بروتوكول Synod.
الخوارزمية لبنة بناء لخوارزميات أعقد، كما سنرى أدناه. والقيمة الوحيدة التي سنتفق عليها في هذا المثال هي أول معاملة يعالجها مصرفنا الافتراضي. فبينما سيعالج المصرف المعاملات كل يوم، فإن أول معاملة ستحدث مرة واحدة فقط ولن تتغيّر أبداً، ولذلك يمكننا استخدام Paxos البسيط للاتفاق على تفاصيلها.
يعمل البروتوكول عبر سلسلة من جولات الاقتراع (ballots)، يقود كل منها عضو واحد من مجموعة الخوادم، ويُسمّى مقدِّم الاقتراع (proposer). ولكل جولة اقتراع رقم اقتراع فريد قائم على عدد صحيح وهوية مقدّم الاقتراع. والهدف من المقدّم أن يحصل على قبول عدد من أعضاء مجموعة الخوادم، مجتمعين بصفتهم قابلين للقبول (acceptors)، لقيمته، لكن فقط إذا لم تكن هناك قيمة أخرى قد حُسمت بالفعل.
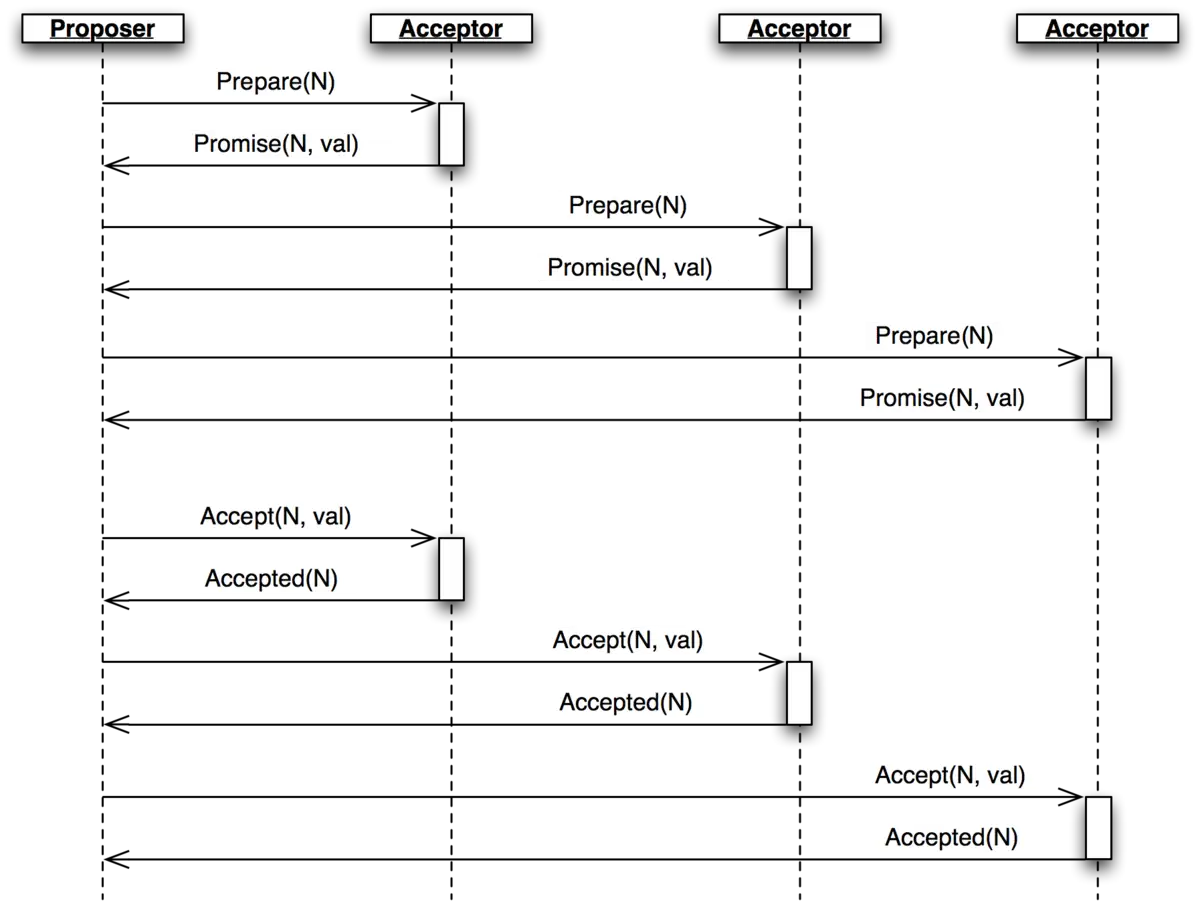
تبدأ جولة الاقتراع بأن يرسل المقدّم رسالة Prepare تحمل رقم الاقتراع N إلى القابلين للقبول وينتظر أن يسمع منهم الأغلبية (ballot.)
وتُعدّ رسالة Prepare طلباً للقيمة المقبولة (إن وُجدت) ذات أعلى رقم اقتراع أصغر من N. ويستجيب القابلون للقبول برسالة Promise تتضمّن أي قيمة سبق أن قبلوها، مع وعد بألّا يقبلوا في المستقبل أي جولة اقتراع رقمها أصغر من N. وإذا كان القابل للقبول قد وعد مسبقاً برقم اقتراع أكبر، فإنه يدرج ذلك الرقم في Promise، مما يدل على أن المقدّم قد سبقَه غيره. وفي هذه الحالة تكون جولة الاقتراع قد انتهت، لكن يبقى للمقدّم أن يحاول مرة أخرى في جولة أخرى (لكن برقم اقتراع أكبر).
وحين يسمع المقدّم ردوداً من أغلبية القابلين للقبول، يرسل رسالة Accept تتضمّن رقم الاقتراع والقيمة إلى جميع القابلين للقبول. فإن لم يتلقَّ المقدّم أي قيمة موجودة من أي قابل للقبول، فإنه يرسل قيمته التي يريدها. وإلا فإنه يرسل القيمة الواردة في الوعد ذو الرقم الأعلى.
ما لم يكن في ذلك انتهاك لوعد، يسجّل كل قابل للقبول القيمة الواردة في رسالة Accept على أنها مقبولة ويرد برسالة Accepted. وتصبح جولة الاقتراع مكتملة وتُحسم القيمة حين يسمع المقدّم رقم جولته من أغلبية القابلين للقبول.
والعودة إلى المثال، لن تكون هناك أي قيمة أخرى مقبولة في البداية، لذا سيرد جميع القابلين للقبول برسالة Promise بلا قيمة، ويرسل المقدّم رسالة Accept تتضمّن قيمته، لنقل:
operation(name='deposit', amount=100.00, destination_account='Mike DiBernardo')
إذا بدأ مقدّم آخر لاحقاً جولة اقتراع برقم اقتراع أصغر وبعملية مختلفة (لنقل تحويلاً إلى حساب 'Dustin J. Mitchell')، فسيرفض القابلون للقبول ببساطة قبولها. أما إذا كانت تلك الجولة تحمل رقم اقتراع أكبر، فستخبر رسالة Promise القادمة من القابلين للقبول المقدّم بعملية إيداع مايكل بمبلغ 100.00 دولار، وسيرسل المقدّم تلك القيمة في رسالة Accept بدلاً من التحويل إلى داستن. وستُقبَل جولة الاقتراع الجديدة، لكن لصالح القيمة نفسها التي افترضتها جولة الاقتراع الأولى.
في الواقع، لن يسمح البروتوكول أبداً بحسم قيمتين مختلفتين، حتى لو تداخلت جولات الاقتراع أو تأخّرت الرسائل أو فشل عدد قليل من القابلين للقبول.
حين يقدّم عدة مقدّمين جولات اقتراع في الوقت نفسه، من السهل ألا تُقبَل أيّ من الجولتين. عندئذٍ يعيد المقدّمان تقديم اقتراحيهما، ونأمل أن يفوز أحدهما، لكن التجمّد (deadlock) قد يستمر إلى ما لا نهاية إذا كان التوقيت مناسباً تماماً.
تأمّل تسلسل الأحداث التالي:
- يؤدّي المقدّم A مرحلة
Prepare/Promiseلجولة الاقتراع رقم 1. - قبل أن يتمكّن المقدّم A من جعل اقتراحه مقبولاً، يؤدّي المقدّم B مرحلة \newline
Prepare/Promiseلجولة الاقتراع رقم 2. - حين يرسل المقدّم A أخيراً رسالة
Acceptبرقم الاقتراع 1، يرفضها القابلون للقبول لأنهم وعدوا فعلاً برقم الاقتراح 2. - يتفاعل المقدّم A فوراً بإرسال
Prepareبرقم اقتراع أعلى (3)، قبل أن يتمكّن المقدّم B من إرسال رسالةAcceptالخاصة به. - تُرفض
Acceptالتالية للمقدّم B، وتتكرّر العملية.
مع توقيت محظوظ المعاكس - وهو أشيع على الاتصالات بعيدة المدى حيث يكون الوقت بين إرسال الرسالة وتلقّي الرد طويلاً - يمكن أن يستمر هذا التجمّد (deadlock) لجولات عديدة.
Multi-Paxos
الوصول إلى توافق على قيمة ساكنة واحدة ليس ذا فائدة كبيرة بحد ذاته. فالأنظمة المُجمَّعة (clustered) مثل خدمة الحسابات المصرفية تريد أن تتفق على حالة بعينها (أرصدة الحسابات) تتغيّر مع الزمن. ونستخدم Paxos للاتفاق على كل عملية، باعتبارها انتقالاً في آلة الحالة.
Multi-Paxos هو، في فعليته، تسلسل من نسخ Paxos البسيطة (خانات/ slots) مرقّمة بالتسلسل. ويُسنَد لكل انتقال حالة «رقم خانة»، وينفّذ كل عضو في المجموعة الانتقالات بترتيب عددي صارم. ولتغيير حالة المجموعة (لتنفيذ عملية تحويل مثلاً)، نحاول تحقيق التوافق على تلك العملية في الخانة التالية. وبعبارات ملموسة، يعني هذا إضافة رقم خانة إلى كل رسالة، مع تتبّع كل حالة البروتوكول على أساس لكل خانة على حدة.
تشغيل Paxos لكل خانة، بما يتطلّبه من ذهاب وإياب لا يقلّ عن جولتين، سيكون بطيئاً أكثر من اللازم. ويحسّن Multi-Paxos الأداء باستخدام مجموعة أرقام الاقتراع نفسها لكل الخانات، وبإجراء مرحلة Prepare/Promise لكل الخانات دفعة واحدة.
Paxos المصعَّب
تنفيذ Multi-Paxos في برمجيات عملية مشهود بالصعوبة، وقد أنتج عدد من الأوراق البحثية الذي يسخر من «Paxos Made Simple» لريفس، بعناوين مثل «Paxos Made Practical».
أولاً، يمكن أن تُصبح مشكلة تعدّد المقدّمين الموصوفة أعلاه مشكلة حقيقية في بيئة مزدحمة، إذ يحاول كل عضو في المجموعة جعل عملية آلة الحالة الخاصة به محسومة في كل خانة. والحل هو انتخاب «قائد» (leader) مسؤول عن تقديم جولات الاقتراع لكل خانة. وتُرسل عندئذٍ عُقد المجموعة الأخرى كل عملياتها الجديدة إلى القائد لتنفيذها. وهكذا، في التشغيل الطبيعي بقائد واحد فقط، لا تحدث تعارضات في جولات الاقتراع.
يمكن أن تعمل مرحلة Prepare/Promise كنوع من انتخاب القائد: وأي عضو في المجموعة يملك رقم الاقتراع الذي وُعد به في الآخرة يُعدّ القائد. وعندئذٍ يبقى للقائد أن ينفّذ مرحلة Accept/Accepted مباشرةً دون تكرار المرحلة الأولى. وكما سنرى أدناه، فإن انتخاب القائد أمر معقّد في الواقع.
على الرغم من أن Paxos البسيط يضمن أن المجموعة لن تصل إلى قرارات متعارضة، فإنه لا يستطيع ضمان أن أي قرار سيُتَّخذ. فمثلاً، إذا فُقدت رسالة Prepare الأولية ولم تصل إلى القابلين للقبول، فإن المقدّم سينتظر رسالة Promise لن تصل أبداً. وإصلاح هذا يستلزم إعادة إرسال منسّقة بعناية: بقدر يكفي لتحقيق التقدّم في النهاية، لا بقدر يغرق المجموعة في عاصفة من الحزم.
وتتمثّل مشكلة أخرى في نشر القرارات. فبثّ بسيط لرسالة Decision سيفي بالغرض في الحالة العادية. لكن إذا فُقدت الرسالة، فقد تبقى عقدة ما جاهلة بالقرار بشكل دائم وعاجزة عن تطبيق انتقالات آلة الحالة للخانات اللاحقة. ولذلك يحتاج التنفيذ إلى آلية لمشاركة معلومات عن المقترحات المحسومة.
أما استخدامنا لآلة حالة موزّعة فيقدّم تحدّياً مثيراً للاهتمام آخر: بدء التشغيل. فحين تبدأ عقدة جديدة، عليها أن تلحق بالحالة القائمة للمجموعة. ورغم أنها تستطيع أن تفعل ذلك بلحاق القرارات الخاصة بكل الخانات منذ الخانة الأولى، فإن هذا في مجموعة ناضجة قد يشمل ملايين الخانات. وإضافةً إلى ذلك، نحتاج إلى بعض طريقة لتهيئة مجموعة جديدة.
لكننا كفاية عن النظرية والخوارزميات - فلننظر إلى الشيفرة.
تقديم Cluster
تنفّذ مكتبة Cluster في هذا الفصل صيغة مبسّطة من Multi-Paxos. وقد صُمّمت بوصفها مكتبة لتوفير خدمة توافق لتطبيق أكبر.
سيعتمد مستخدمو هذه المكتبة على صحّتها، لذا من المهم تنظيم الشيفرة بحيث نتمكّن من رؤية - واختبار - تطابقها مع المواصفة. للبروتوكولات المعقّدة أن تُظهر إخفاقات معقّدة، ولذلك سنبني دعماً لإعادة إنتاج الإخفاقات النادرة وتنقيحها.
التنفيذ في هذا الفصل هو شيفرة إثبات للمفهوم (proof-of-concept): كافية لبيان أن المفهوم الأساسي عملي، لكنها تفتقر إلى كل التجهيزات المطلوبة للاستخدام في الإنتاج. وقد رُتّبت الشيفرة بحيث يمكن إضافة تلك التجهيزات لاحقاً بأقل تغيير ممكن في التنفيذ الأساسي.
لنبدأ.
الأنواع والثوابت
يستخدم بروتوكول Cluster خمسة عشر نوعاً مختلفاً من الرسائل، كلٌّ منها معرَّف كـ namedtuple في Python.
    Accepted = namedtuple('Accepted', ['slot', 'ballot_num'])
    Accept = namedtuple('Accept', ['slot', 'ballot_num', 'proposal'])
    Decision = namedtuple('Decision', ['slot', 'proposal'])
    Invoked = namedtuple('Invoked', ['client_id', 'output'])
    Invoke = namedtuple('Invoke', ['caller', 'client_id', 'input_value'])
    Join = namedtuple('Join', [])
    Active = namedtuple('Active', [])
    Prepare = namedtuple('Prepare', ['ballot_num'])
    Promise = namedtuple('Promise', ['ballot_num', 'accepted_proposals'])
    Propose = namedtuple('Propose', ['slot', 'proposal'])
    Welcome = namedtuple('Welcome', ['state', 'slot', 'decisions'])
    Decided = namedtuple('Decided', ['slot'])
    Preempted = namedtuple('Preempted', ['slot', 'preempted_by'])
    Adopted = namedtuple('Adopted', ['ballot_num', 'accepted_proposals'])
    Accepting = namedtuple('Accepting', ['leader'])
يساعد استخدام الصفوف المسمّاة (named tuples) لوصف كل نوع من الرسائل في إبقاء الشيفرة نظيفة ويساعد على تجنّب بعض الأخطاء البسيطة. فباني الصف المسمّى سيرفع استثناءً إن لم تُعطَ الصفات الدقيقة تماماً، ما يجعل الأخطاء الإملائية بارزة. كما تُنسَّق هذه الصفوف بنفسها في رسائل السجل، وكميزة إضافية لا تستهلك من الذاكرة بقدر ما يستهلكه القاموس (dictionary).
وإنشاء رسالة أمر بديهي بطبع:
msg = Accepted(slot=10, ballot_num=30)
وتكون حقول تلك الرسالة متاحة بأقل قدر ممكن من الكتابة الإضافية:
got_ballot_num = msg.ballot_num
وسنرى ما تعنيه هذه الرسائل في الأقسام التالية. وتقدّم الشيفرة أيضاً بعض الثوابت، معظمها يعرّف مهلاً زمنية لرسائل مختلفة:
    JOIN_RETRANSMIT = 0.7
    CATCHUP_INTERVAL = 0.6
    ACCEPT_RETRANSMIT = 1.0
    PREPARE_RETRANSMIT = 1.0
    INVOKE_RETRANSMIT = 0.5
    LEADER_TIMEOUT = 1.0
    NULL_BALLOT = Ballot(-1, -1)  # sorts before all real ballots
    NOOP_PROPOSAL = Proposal(None, None, None)  # no-op to fill otherwise empty slots
وأخيراً، يستخدم Cluster نوعَي بيانات سُمّيا بحيث بحيث يطابقان وصف البروتوكول:
    Proposal = namedtuple('Proposal', ['caller', 'client_id', 'input'])
    Ballot = namedtuple('Ballot', ['n', 'leader'])
نموذج المكوّنات
يحدّ البشر بما نستطيع حمله في ذاكرتهم العاملة. فنحن لا نستطيع أن نستنتج تنفيذ Cluster كله دفعة واحدة - فهو كثير جداً - ومن السهل أن تفوتنا تفاصيل. ولأسباب مشابهة، يصعب اختبار قواعد الشيفرة الكبيرة الأحادية: إذ يجب على حالات الاختبار أن تتعامل مع قطع متحرّكة كثيرة وهي هشّة، وتفشل عند أي تغيير تقريباً في الشيفرة.
ولتشجيع قابلية الاختبار وإبقاء الشيفرة مقروءة، نقسّم Cluster إلى حفنة من الأصناف (classes) المطابقة للأدوار الموصوفة في البروتوكول. وكل منها صنف فرعي من Role.
class Role(object):

    def __init__(self, node):
        self.node = node
        self.node.register(self)
        self.running = True
        self.logger = node.logger.getChild(type(self).__name__)

    def set_timer(self, seconds, callback):
        return self.node.network.set_timer(self.node.address, seconds,
                                           lambda: self.running and callback())

    def stop(self):
        self.running = False
        self.node.unregister(self)
تُلحم مجموعة الأدوار التي تمتلكها عقدة المجموعة معاً بواسطة الصنف Node، الذي يمثّل عقدة واحدة على الشبكة. وتُضاف الأدوار إلى العقدة وتُزال منها مع تقدّم التنفيذ. أما الرسائل التي تصل إلى العقدة فتُمرَّر إلى جميع الأدوار النشطة، مع استدعاء دالة اسمها اسم نوع الرسالة مع بادئة do_. وتتلقّى دوال do_ هذه صفات الرسالة كوسائط مسمّاة لسهولة الوصول. ويوفّر الصنف Node أيضاً دالة send للراحة، مستخدماً functools.partial لتزويد بعض الوسائط إلى الدوال نفسها في الصنف Network.
class Node(object):
    unique_ids = itertools.count()

    def __init__(self, network, address):
        self.network = network
        self.address = address or 'N%d' % self.unique_ids.next()
        self.logger = SimTimeLogger(
            logging.getLogger(self.address), {'network': self.network})
        self.logger.info('starting')
        self.roles = []
        self.send = functools.partial(self.network.send, self)

    def register(self, roles):
        self.roles.append(roles)

    def unregister(self, roles):
        self.roles.remove(roles)

    def receive(self, sender, message):
        handler_name = 'do_%s' % type(message).__name__

        for comp in self.roles[:]:
            if not hasattr(comp, handler_name):
                continue
            comp.logger.debug("received %s from %s", message, sender)
            fn = getattr(comp, handler_name)
            fn(sender=sender, **message._asdict())
واجهة التطبيق
ينشئ التطبيق كائن Member ويشغّله على كل عضو في مجموعة الخوادم، موفّراً آلة حالة خاصة بالتطبيق وقائمة بالأقران. يضيف كائن العضو دور bootstrap إلى العقدة إذا كان ينضم إلى مجموعة قائمة، أو دور seed إذا كان ينشئ مجموعة جديدة. ثم يشغّل البروتوكول (عبر Network.run) في خيط منفصل.
يتفاعل التطبيق مع المجموعة عبر الدالة invoke، التي تبدأ اقتراحاً بانتقال حالة. وبمجرد حسم ذلك الاقتراح وتشغيل آلة الحالة، تُرجع invoke مخرجات الآلة. وتستخدم الدالة طابور Queue متزامناً بسيطاً لانتظار النتيجة من خيط البروتوكول.
class Member(object):

    def __init__(self, state_machine, network, peers, seed=None,
                 seed_cls=Seed, bootstrap_cls=Bootstrap):
        self.network = network
        self.node = network.new_node()
        if seed is not None:
            self.startup_role = seed_cls(self.node, initial_state=seed, peers=peers,
                                      execute_fn=state_machine)
        else:
            self.startup_role = bootstrap_cls(self.node,
                                      execute_fn=state_machine, peers=peers)
        self.requester = None

    def start(self):
        self.startup_role.start()
        self.thread = threading.Thread(target=self.network.run)
        self.thread.start()

    def invoke(self, input_value, request_cls=Requester):
        assert self.requester is None
        q = Queue.Queue()
        self.requester = request_cls(self.node, input_value, q.put)
        self.requester.start()
        output = q.get()
        self.requester = None
        return output
أصناف الأدوار
لننظر إلى كل صنف من أصناف الأدوار في المكتبة واحداً تلو الآخر.
Acceptor
ينفّذ Acceptor دور القابل للقبول في البروتوكول، لذا يجب أن يخزّن رقم الاقتراع الذي يمثّل أحدث وعدٍ قطعه، إلى جانب مجموعة المقترحات المقبولة لكل خانة. ثم يستجيب لرسالتَي Prepare وAccept وفق البروتوكول. والنتيجة صنف قصير يسهل مقارنته بالبروتوكول.
وبالنسبة إلى القابلين للقبول، يبدو Multi-Paxos أشبه كثيراً بـ Paxos البسيط، مع إضافة أرقام الخانات إلى الرسائل.
class Acceptor(Role):

    def __init__(self, node):
        super(Acceptor, self).__init__(node)
        self.ballot_num = NULL_BALLOT
        self.accepted_proposals = {}  # {slot: (ballot_num, proposal)}

    def do_Prepare(self, sender, ballot_num):
        if ballot_num > self.ballot_num:
            self.ballot_num = ballot_num
            # we've heard from a scout, so it might be the next leader
            self.node.send([self.node.address], Accepting(leader=sender))

        self.node.send([sender], Promise(
            ballot_num=self.ballot_num,
            accepted_proposals=self.accepted_proposals
        ))

    def do_Accept(self, sender, ballot_num, slot, proposal):
        if ballot_num >= self.ballot_num:
            self.ballot_num = ballot_num
            acc = self.accepted_proposals
            if slot not in acc or acc[slot][0] < ballot_num:
                acc[slot] = (ballot_num, proposal)

        self.node.send([sender], Accepted(
            slot=slot, ballot_num=self.ballot_num))
Replica
الصنف Replica هو أصعب أصناف الأدوار، إذ له مسؤوليات مترابطة عن قرب:
- تقديم مقترحات جديدة؛
- استدعاء آلة الحالة المحلية حين تُحسم المقترحات؛
- تتبّع القائد الحالي؛ و
- إضافة العقد التي بدأت حديثاً إلى المجموعة.
ينشئ الـ replica مقترحات جديدة استجابةً لرسائل Invoke القادمة من العملاء، ويختار ما يعتقد أنه خانة غير مستعملة ويرسل رسالة Propose إلى القائد الحالي (replica.) وإضافةً إلى ذلك، إذا كان التوافق على الخانة المختارة من أجل مقترح مختلف، فيجب على الـ replica أن يعيد اقتراحه في خانة جديدة.
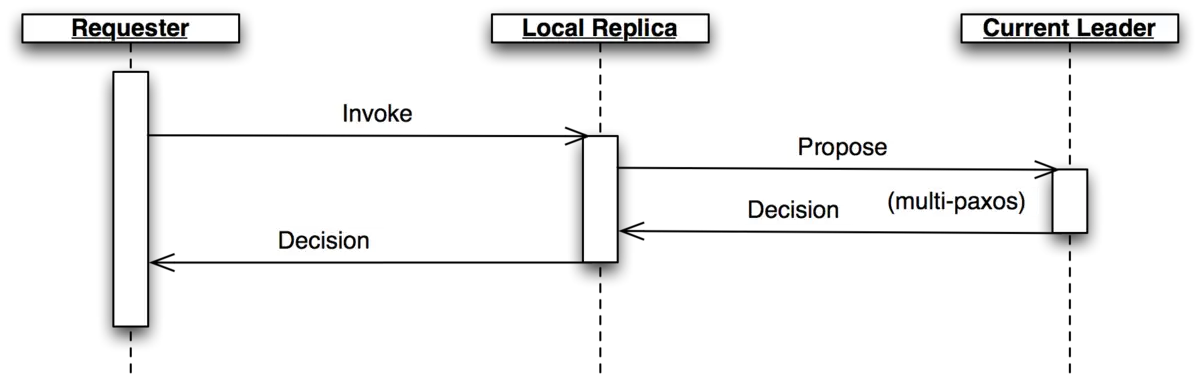
تمثّل رسائل Decision الخانات التي توصلت المجموعة إلى توافق بشأنها. وهنا تخزّن الـ replicas القرار الجديد، ثم تشغّل آلة الحالة حتى تبلغ خانة غير محسومة. وتميّز الـ replicas بين الخانات المحسومة (decided) التي اتفقت المجموعة عليها، والخانات المثبَّتة (committed) التي عالجتها آلة الحالة المحلية. وحين تُحسم الخانات بترتيب مختلف، قد تتأخّر المقترحات المثبَّتة في انتظار أن تُحسم الخانة التالية. وحين تُثبَّت خانة، ترسل كل replica رسالة Invoked إلى الطالب مع نتيجة العملية.
في بعض الظروف، قد تكون هناك خانة بلا مقترحات نشطة ولا قرار. آلة الحالة ملزَمة بتنفيذ الخانات واحدةً تلو الأخرى، لذا يجب أن توصل المجموعة إلى توافق على شيء يملأ الخانة. وللتحمي من هذا الاحتمال، تقدّم الـ replicas مقترحاً «بلا أثر» (no-op) كلما لحقت بخانة. فإذا حُسم هذا المقترح في النهاية، فإن آلة الحالة لا تفعل شيئاً بالنسبة إلى تلك الخانة.
وكذلك، من الممكن أن يُحسم المقترح نفسه مرتين. ويتخطّى الـ replica استدعاء آلة الحالة لأي مقترحات مكرّرة من هذا النوع، فلا ينفّذ أي انتقال بالنسبة إلى تلك الخانة.
تحتاج الـ replicas إلى معرفة أي عقدة هي القائد النشط كي ترسل إليها رسائل Propose. وهناك مقدار مفاجئ من الدقّة والعناية مطلوب لإتمام هذا على النحو الصحيح، كما سنرى لاحقاً. وتتتبّع كل replica القائد النشط بثلاثة مصادر للمعلومات.
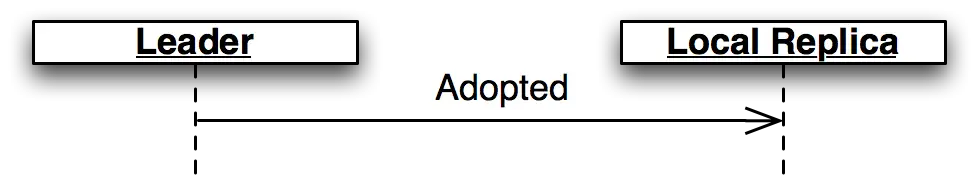
حين يصبح دور القائد نشطاً، يرسل رسالة Adopted إلى الـ replica الموجودة على العقدة نفسها (adopted.)
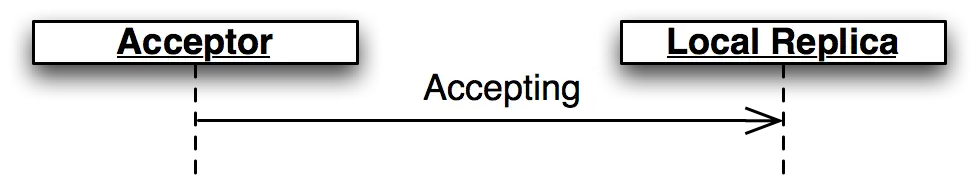
وحين يرسل دور القابل للقبول رسالة Promise إلى قائد جديد، فإنه يرسل رسالة Accepting إلى الـ replica المحلية (accepting.)
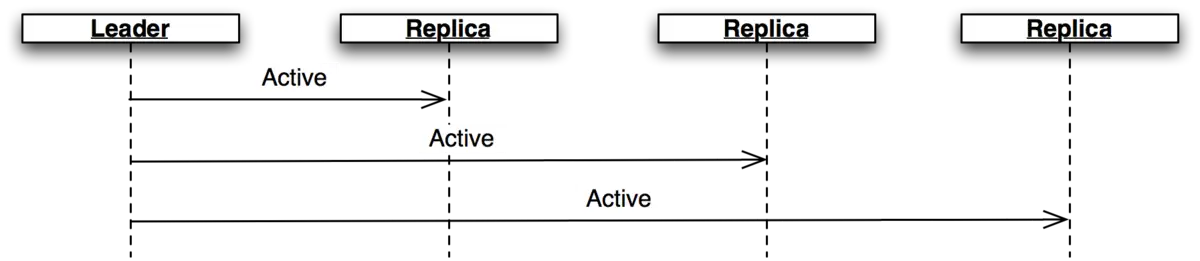
يرسل القائد النشط رسائل Active بوصفها نبضاً للحياة (active.) فإذا لم تصل أي رسالة من هذا النوع قبل انتهاء صلاحية LEADER_TIMEOUT، تفترض الـ replica أن القائد قد مات وتنتقل إلى القائد التالي. وفي هذه الحالة، من المهم أن تختار جميع الـ replicas القائد الجديد نفسه، وهو ما نحققه بترتيب الأعضاء واختيار التالي في القائمة.
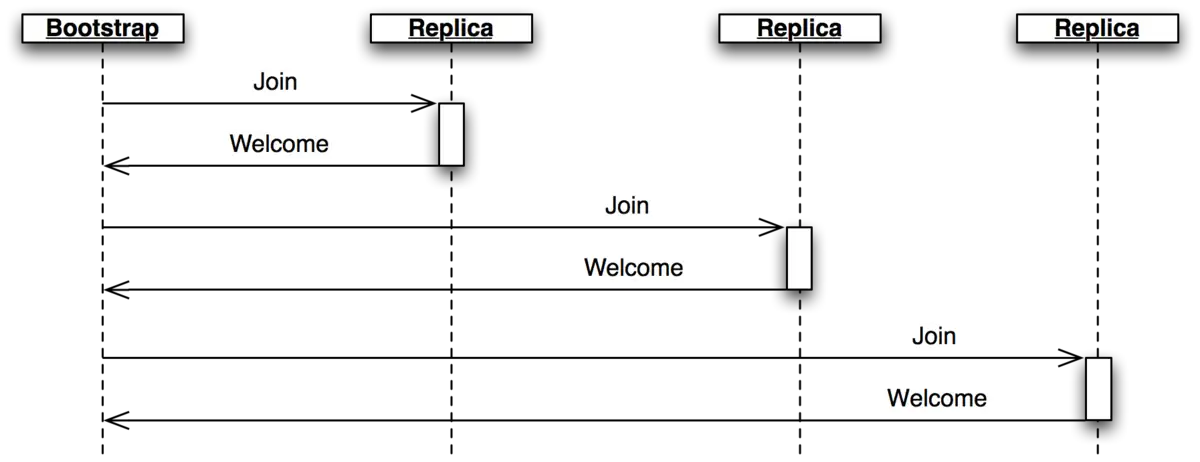
وأخيراً، حين تنضم عقدة إلى الشبكة، يرسل دور bootstrap رسالة Join (bootstrap.) وتستجيب الـ replica برسالة Welcome تحتوي على أحدث حالة لها، مما يتيح للعقدة الجديدة أن تلحق بالركب بسرعة.
class Replica(Role):

    def __init__(self, node, execute_fn, state, slot, decisions, peers):
        super(Replica, self).__init__(node)
        self.execute_fn = execute_fn
        self.state = state
        self.slot = slot
        self.decisions = decisions
        self.peers = peers
        self.proposals = {}
        # next slot num for a proposal (may lead slot)
        self.next_slot = slot
        self.latest_leader = None
        self.latest_leader_timeout = None

    # making proposals

    def do_Invoke(self, sender, caller, client_id, input_value):
        proposal = Proposal(caller, client_id, input_value)
        slot = next((s for s, p in self.proposals.iteritems() if p == proposal), None)
        # propose, or re-propose if this proposal already has a slot
        self.propose(proposal, slot)

    def propose(self, proposal, slot=None):
        """Send (or resend, if slot is specified) a proposal to the leader"""
        if not slot:
            slot, self.next_slot = self.next_slot, self.next_slot + 1
        self.proposals[slot] = proposal
        # find a leader we think is working - either the latest we know of, or
        # ourselves (which may trigger a scout to make us the leader)
        leader = self.latest_leader or self.node.address
        self.logger.info(
            "proposing %s at slot %d to leader %s" % (proposal, slot, leader))
        self.node.send([leader], Propose(slot=slot, proposal=proposal))

    # handling decided proposals

    def do_Decision(self, sender, slot, proposal):
        assert not self.decisions.get(self.slot, None), \
                "next slot to commit is already decided"
        if slot in self.decisions:
            assert self.decisions[slot] == proposal, \
                "slot %d already decided with %r!" % (slot, self.decisions[slot])
            return
        self.decisions[slot] = proposal
        self.next_slot = max(self.next_slot, slot + 1)

        # re-propose our proposal in a new slot if it lost its slot and wasn't a no-op
        our_proposal = self.proposals.get(slot)
        if (our_proposal is not None and
            our_proposal != proposal and our_proposal.caller):
            self.propose(our_proposal)

        # execute any pending, decided proposals
        while True:
            commit_proposal = self.decisions.get(self.slot)
            if not commit_proposal:
                break  # not decided yet
            commit_slot, self.slot = self.slot, self.slot + 1

            self.commit(commit_slot, commit_proposal)

    def commit(self, slot, proposal):
        """Actually commit a proposal that is decided and in sequence"""
        decided_proposals = [p for s, p in self.decisions.iteritems() if s < slot]
        if proposal in decided_proposals:
            self.logger.info(
                "not committing duplicate proposal %r, slot %d", proposal, slot)
            return  # duplicate

        self.logger.info("committing %r at slot %d" % (proposal, slot))
        if proposal.caller is not None:
            # perform a client operation
            self.state, output = self.execute_fn(self.state, proposal.input)
            self.node.send([proposal.caller],
                Invoked(client_id=proposal.client_id, output=output))

    # tracking the leader

    def do_Adopted(self, sender, ballot_num, accepted_proposals):
        self.latest_leader = self.node.address
        self.leader_alive()

    def do_Accepting(self, sender, leader):
        self.latest_leader = leader
        self.leader_alive()

    def do_Active(self, sender):
        if sender != self.latest_leader:
            return
        self.leader_alive()

    def leader_alive(self):
        if self.latest_leader_timeout:
            self.latest_leader_timeout.cancel()

        def reset_leader():
            idx = self.peers.index(self.latest_leader)
            self.latest_leader = self.peers[(idx + 1) % len(self.peers)]
            self.logger.debug("leader timed out; tring the next one, %s",
                self.latest_leader)
        self.latest_leader_timeout = self.set_timer(LEADER_TIMEOUT, reset_leader)

    # adding new cluster members

    def do_Join(self, sender):
        if sender in self.peers:
            self.node.send([sender], Welcome(
                state=self.state, slot=self.slot, decisions=self.decisions))
القائد والكشّاف والقائد المأمور
المهمة الأساسية للقائد هي تلقّي رسائل Propose التي تطلب جولات اقتراع جديدة وإنتاج القرارات. يكون القائد «نشطاً» عندما ينفّذ بنجاح الجزء Prepare/Promise من البروتوكول. ويستطيع القائد النشط أن يرسل رسالة Accept فوراً استجابةً لـ Propose.
وفي إطار نموذج «صنف لكل دور»، يفوّض القائد دورَي scout (الكشّاف) وcommander (القائد المأمور) لتنفيذ كل جزء من البروتوكول.
class Leader(Role):

    def __init__(self, node, peers, commander_cls=Commander, scout_cls=Scout):
        super(Leader, self).__init__(node)
        self.ballot_num = Ballot(0, node.address)
        self.active = False
        self.proposals = {}
        self.commander_cls = commander_cls
        self.scout_cls = scout_cls
        self.scouting = False
        self.peers = peers

    def start(self):
        # reminder others we're active before LEADER_TIMEOUT expires
        def active():
            if self.active:
                self.node.send(self.peers, Active())
            self.set_timer(LEADER_TIMEOUT / 2.0, active)
        active()

    def spawn_scout(self):
        assert not self.scouting
        self.scouting = True
        self.scout_cls(self.node, self.ballot_num, self.peers).start()

    def do_Adopted(self, sender, ballot_num, accepted_proposals):
        self.scouting = False
        self.proposals.update(accepted_proposals)
        # note that we don't re-spawn commanders here; if there are undecided
        # proposals, the replicas will re-propose
        self.logger.info("leader becoming active")
        self.active = True

    def spawn_commander(self, ballot_num, slot):
        proposal = self.proposals[slot]
        self.commander_cls(self.node, ballot_num, slot, proposal, self.peers).start()

    def do_Preempted(self, sender, slot, preempted_by):
        if not slot:  # from the scout
            self.scouting = False
        self.logger.info("leader preempted by %s", preempted_by.leader)
        self.active = False
        self.ballot_num = Ballot((preempted_by or self.ballot_num).n + 1,
                                 self.ballot_num.leader)

    def do_Propose(self, sender, slot, proposal):
        if slot not in self.proposals:
            if self.active:
                self.proposals[slot] = proposal
                self.logger.info("spawning commander for slot %d" % (slot,))
                self.spawn_commander(self.ballot_num, slot)
            else:
                if not self.scouting:
                    self.logger.info("got PROPOSE when not active - scouting")
                    self.spawn_scout()
                else:
                    self.logger.info("got PROPOSE while scouting; ignored")
        else:
            self.logger.info("got PROPOSE for a slot already being proposed")
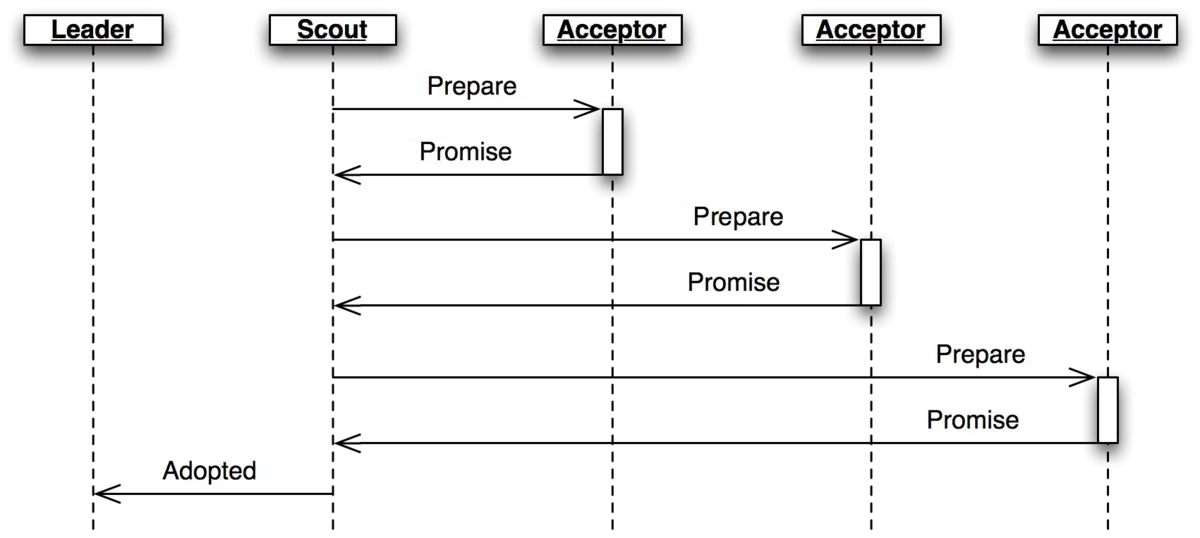
ينشئ القائد دور scout عندما يريد أن يصبح نشطاً، استجابةً لتلقّيه رسالة Propose وهو غير نشط (leaderscout.) ويرسل scout رسالة Prepare (ويعيد إرسالها عند الحاجة) ويجمع ردود Promise حتى يسمع من أغلبية أقرانه أو حتى يُسبقَه غيره. ثم يتواصل مع القائد عبر Adopted أو Preempted على التوالي.
class Scout(Role):

    def __init__(self, node, ballot_num, peers):
        super(Scout, self).__init__(node)
        self.ballot_num = ballot_num
        self.accepted_proposals = {}
        self.acceptors = set([])
        self.peers = peers
        self.quorum = len(peers) / 2 + 1
        self.retransmit_timer = None

    def start(self):
        self.logger.info("scout starting")
        self.send_prepare()

    def send_prepare(self):
        self.node.send(self.peers, Prepare(ballot_num=self.ballot_num))
        self.retransmit_timer = self.set_timer(PREPARE_RETRANSMIT, self.send_prepare)

    def update_accepted(self, accepted_proposals):
        acc = self.accepted_proposals
        for slot, (ballot_num, proposal) in accepted_proposals.iteritems():
            if slot not in acc or acc[slot][0] < ballot_num:
                acc[slot] = (ballot_num, proposal)

    def do_Promise(self, sender, ballot_num, accepted_proposals):
        if ballot_num == self.ballot_num:
            self.logger.info("got matching promise; need %d" % self.quorum)
            self.update_accepted(accepted_proposals)
            self.acceptors.add(sender)
            if len(self.acceptors) >= self.quorum:
                # strip the ballot numbers from self.accepted_proposals, now that it
                # represents a majority
                accepted_proposals = \
                    dict((s, p) for s, (b, p) in self.accepted_proposals.iteritems())
                # We're adopted; note that this does *not* mean that no other
                # leader is active.  # Any such conflicts will be handled by the
                # commanders.
                self.node.send([self.node.address],
                    Adopted(ballot_num=ballot_num,
                            accepted_proposals=accepted_proposals))
                self.stop()
        else:
            # this acceptor has promised another leader a higher ballot number,
            # so we've lost
            self.node.send([self.node.address],
                Preempted(slot=None, preempted_by=ballot_num))
            self.stop()
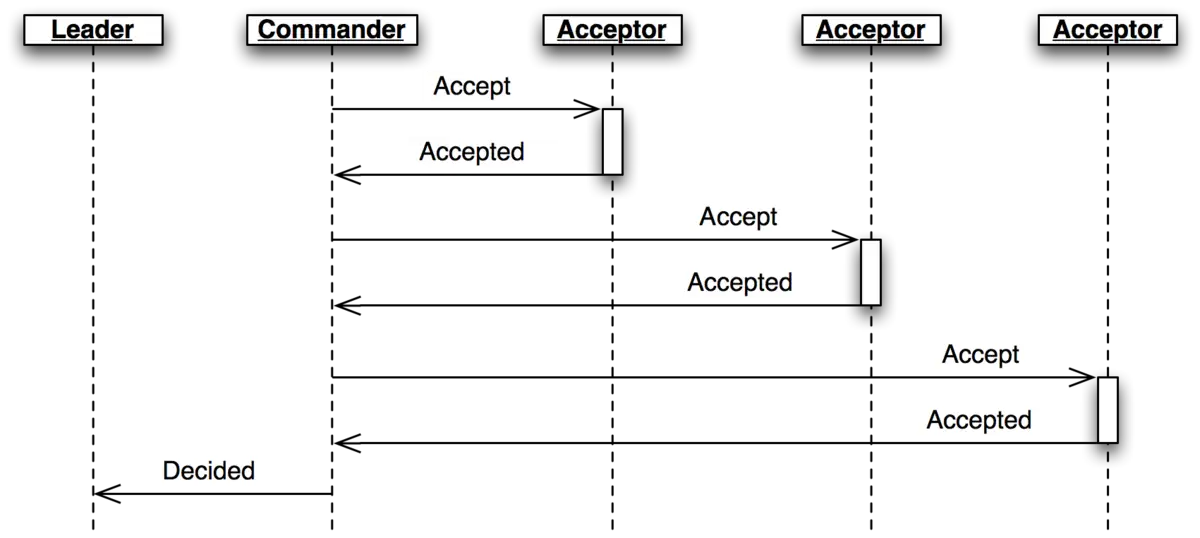
وينشئ القائد دور commander (القائد المأمور) لكل خانة لديه فيها مقترح نشط (leadercommander.) ومثل scout، يرسل commander رسائل Accept ويعيد إرسالها وينتظر ردّ أغلبية القابلين للقبول بـ Accepted، أو خبراً بتوقّفه. وحين يُقبَل مقترح، يبثّ commander رسالة Decision إلى جميع العقد. ويستجيب للقائد بـ Decided أو Preempted.
class Commander(Role):

    def __init__(self, node, ballot_num, slot, proposal, peers):
        super(Commander, self).__init__(node)
        self.ballot_num = ballot_num
        self.slot = slot
        self.proposal = proposal
        self.acceptors = set([])
        self.peers = peers
        self.quorum = len(peers) / 2 + 1

    def start(self):
        self.node.send(set(self.peers) - self.acceptors, Accept(
            slot=self.slot, ballot_num=self.ballot_num, proposal=self.proposal))
        self.set_timer(ACCEPT_RETRANSMIT, self.start)

    def finished(self, ballot_num, preempted):
        if preempted:
            self.node.send([self.node.address],
                           Preempted(slot=self.slot, preempted_by=ballot_num))
        else:
            self.node.send([self.node.address],
                           Decided(slot=self.slot))
        self.stop()

    def do_Accepted(self, sender, slot, ballot_num):
        if slot != self.slot:
            return
        if ballot_num == self.ballot_num:
            self.acceptors.add(sender)
            if len(self.acceptors) < self.quorum:
                return
            self.node.send(self.peers, Decision(
                           slot=self.slot, proposal=self.proposal))
            self.finished(ballot_num, False)
        else:
            self.finished(ballot_num, True)
وللإشارة، ظهر هنا خلل دقيق إلى حدٍّ مفاجئ أثناء التطوير. ففي ذلك الوقت، كان محاكي الشبكة يُدخل فقد الحزم (packet loss) حتى على الرسائل داخل العقدة الواحدة. وحين كانت جميع رسائل Decision تضيع، لا يستطيع البروتوكول أن يتقدّم. وواصلت الـ replica إعادة إرسال رسائل Propose، لكن القائد تجاهلها لأنه كان لديه مقترح لتلك الخانة أصلاً. ولم تكن عملية الالتحاق لدى الـ replica قادرة على إيجاد النتيجة، إذ لم تسمع أي replica بالقرار. وكان الحل هو ضمان تسليم الرسائل المحلية دائماً، كما هو الحال في حزم الشبكات الحقيقية.
Bootstrap
حين تنضم عقدة إلى المجموعة، عليها أن تحدّد حالة المجموعة الحالية قبل أن تتمكّن من المشاركة. ويتعامل دور bootstrap مع ذلك بإرسال رسائل Join إلى كل أقران واحداً تلو الآخر حتى يتلقّى Welcome. ويظهر مخطّط اتصال bootstrap أعلاه في \aosasecref{sec.cluster.replica}.
وقد بدأ إصدار مبكر من التنفيذ تشغيل كل عقدة بمجموعة كاملة من الأدوار (replica وleader وacceptor)، كلٌّ منها يبدأ في مرحلة «بدء تشغيل» منتظراً معلومات من رسالة Welcome. وقد شتّت ذلك منطق التهيئة على كل دور، فكان يلزم اختبار كل منها على حدة. أمّا التصميم النهائي فيضيف دور bootstrap بقية الأدوار الأخرى إلى العقدة بمجرد اكتمال بدء التشغيل، ممرّراً الحالة الأولية إلى بانياتها.
class Bootstrap(Role):

    def __init__(self, node, peers, execute_fn,
                 replica_cls=Replica, acceptor_cls=Acceptor, leader_cls=Leader,
                 commander_cls=Commander, scout_cls=Scout):
        super(Bootstrap, self).__init__(node)
        self.execute_fn = execute_fn
        self.peers = peers
        self.peers_cycle = itertools.cycle(peers)
        self.replica_cls = replica_cls
        self.acceptor_cls = acceptor_cls
        self.leader_cls = leader_cls
        self.commander_cls = commander_cls
        self.scout_cls = scout_cls

    def start(self):
        self.join()

    def join(self):
        self.node.send([next(self.peers_cycle)], Join())
        self.set_timer(JOIN_RETRANSMIT, self.join)

    def do_Welcome(self, sender, state, slot, decisions):
        self.acceptor_cls(self.node)
        self.replica_cls(self.node, execute_fn=self.execute_fn, peers=self.peers,
                         state=state, slot=slot, decisions=decisions)
        self.leader_cls(self.node, peers=self.peers, commander_cls=self.commander_cls,
                        scout_cls=self.scout_cls).start()
        self.stop()
Seed
في التشغيل الطبيعي، حين تنضم عقدة إلى المجموعة، فإنها تتوقّع أن تجد المجموعة قيد العمل بالفعل، مع عقدة واحدة على الأقل مستعدة للاستجابة لرسالة Join. لكن كيف تُشغَّل المجموعة؟ أحد الخيارات أن يحدّد دور bootstrap - بعد أن يحاول الاتصال بكل عقدة أخرى - أنه الأول في المجموعة. لكن لهذا مشكلتان. الأولى، أنه في مجموعة كبيرة يعني ذلك انتظاراً طويلاً بينما تنتهي مهلة كل Join على حدة. والأهم، أنه في حال انقسام الشبكة، قد تعجز عقدة جديدة عن الاتصال بأي عقدة أخرى فتشغّل مجموعة جديدة.
تُعدّ انقسامات الشبكة أصعب حالات الإخفاق في التطبيقات المُجمَّعة. ففي انقسام الشبكة، تبقى جميع أعضاء المجموعة أحياء، لكن الاتصال يفشل بين بعض الأعضاء. فمثلاً، إذا فشل وصلة الشبكة التي تربط مجموعة فيها عقد في برلين وتايبيه، فإن الشبكة تكون منقسمة. وإذا واصل جزآا المجموعة العمل أثناء الانقسام، فإن إعادة ضمّ الجزأين بعد استعادة وصلة الشبكة قد تكون صعبة. وفي حالة Multi-Paxos، فإن الشبكة المُرمَّمة كانت ستحتضن مجموعتين لهما قرارات مختلفة على أرقام الخانات نفسها.
ولتجنّب هذه النتيجة، فإن إنشاء مجموعة جديدة عملية يحدّدها المستخدم. فالعقدة الواحدة بالضبط في المجموعة تشغّل دور seed، بينما تشغّل البقية دور bootstrap كالمعتاد. وينتظر seed حتى يتلقّى رسائل Join من أغلبية أقرانه، ثم يرسل Welcome تحمل حالة أولية لآلة الحالة ومجموعة فارغة من القرارات. ثم يوقف دور seed نفسه ويشغّل دور bootstrap للانضمام إلى المجموعة التي جُذِعت حديثاً.
يحاكي seed جزء Join/Welcome من تفاعل bootstrap/replica، لذا فإن مخطّط اتصاله هو نفسه مخطّط دور replica.
class Seed(Role):

    def __init__(self, node, initial_state, execute_fn, peers,
                 bootstrap_cls=Bootstrap):
        super(Seed, self).__init__(node)
        self.initial_state = initial_state
        self.execute_fn = execute_fn
        self.peers = peers
        self.bootstrap_cls = bootstrap_cls
        self.seen_peers = set([])
        self.exit_timer = None

    def do_Join(self, sender):
        self.seen_peers.add(sender)
        if len(self.seen_peers) <= len(self.peers) / 2:
            return

        # cluster is ready - welcome everyone
        self.node.send(list(self.seen_peers), Welcome(
            state=self.initial_state, slot=1, decisions={}))

        # stick around for long enough that we don't hear any new JOINs from
        # the newly formed cluster
        if self.exit_timer:
            self.exit_timer.cancel()
        self.exit_timer = self.set_timer(JOIN_RETRANSMIT * 2, self.finish)

    def finish(self):
        # bootstrap this node into the cluster we just seeded
        bs = self.bootstrap_cls(self.node,
                                peers=self.peers, execute_fn=self.execute_fn)
        bs.start()
        self.stop()
Requester
يدير دور requester طلباً موجّهاً إلى آلة الحالة الموزّعة. ويكتفي صنف الدور ببساطة بإرسال رسائل Invoke إلى الـ replica المحلية حتى يتلقّى Invoked مقابلة. انظر قسم «Replica» أعلاه للحصول على مخطّط اتصال هذا الدور.
class Requester(Role):

    client_ids = itertools.count(start=100000)

    def __init__(self, node, n, callback):
        super(Requester, self).__init__(node)
        self.client_id = self.client_ids.next()
        self.n = n
        self.output = None
        self.callback = callback

    def start(self):
        self.node.send([self.node.address],
                       Invoke(caller=self.node.address,
                              client_id=self.client_id, input_value=self.n))
        self.invoke_timer = self.set_timer(INVOKE_RETRANSMIT, self.start)

    def do_Invoked(self, sender, client_id, output):
        if client_id != self.client_id:
            return
        self.logger.debug("received output %r" % (output,))
        self.invoke_timer.cancel()
        self.callback(output)
        self.stop()
خلاصة
ولإعادة التلخيص، فإن أدوار مجموعة الخوادم (cluster) هي:
- Acceptor -- تقديم الوعود وقبول المقترحات
- Replica -- إدارة آلة الحالة الموزّعة: تقديم المقترحات، وتثبيت القرارات، والاستجابة للطالبين
- Leader -- قيادة جولات خوارزمية Multi-Paxos
- Scout -- تنفيذ الجزء
Prepare/Promiseمن خوارزمية Multi-Paxos نيابةً عن القائد - Commander -- تنفيذ الجزء
Accept/Acceptedمن خوارزمية Multi-Paxos نيابةً عن القائد - Bootstrap -- تقديم عقدة جديدة إلى مجموعة قائمة
- Seed -- إنشاء مجموعة خوادم جديدة
- Requester -- طلب عملية على آلة الحالة الموزّعة
ويبقى هناك قطع واحدة أخرى فقط من التجهيزات مطلوبة كي تعمل Cluster، وهي الشبكة التي تتواصل عبرها جميع العقد.
Network
يحتاج أي بروتوكول شبكي القدرة على إرسال الرسائل وتلقّيها، وإلى وسيلة لاستدعاء الدوال في وقت مستقبلي.
يوفّر الصنف Network شبكة محاكاة بسيطة بهذه القدرات، كما يحاكي فقد الحزم وتأخيرات انتشار الرسائل.
تُعالَج المؤقتات (timers) باستخدام وحدة heapq في Python، مما يسمح باختيار الحدث التالي بكفاءة. ويقوم ضبط المؤقت بدفع كائن Timer إلى الكومة (heap). ولأن إزالة العناصر من الكومة غير فعّالة، فإن المؤقتات الملغاة تُترك في مكانها لكن تُوسم كملغاة.
ويستخدم إرسال الرسائل وظيفة المؤقت لجدولة تسليم لاحق للرسالة عند كل عقدة، مستخدماً تأخيراً محاكى عشوائياً. ونستخدم functools.partial مرة أخرى لإعداد استدعاء مستقبلي لدالة receive في عقدة الوجهة مع وسائط مناسبة.
ولا يتطلّب تشغيل المحاكاة سوى إخراج المؤقتات من الكومة وتنفيذها إن لم تكن ملغاة وإن كانت عقدة الوجهة ما زالت نشطة.
class Timer(object):

    def __init__(self, expires, address, callback):
        self.expires = expires
        self.address = address
        self.callback = callback
        self.cancelled = False

    def __cmp__(self, other):
        return cmp(self.expires, other.expires)

    def cancel(self):
        self.cancelled = True

class Network(object):
    PROP_DELAY = 0.03
    PROP_JITTER = 0.02
    DROP_PROB = 0.05

    def __init__(self, seed):
        self.nodes = {}
        self.rnd = random.Random(seed)
        self.timers = []
        self.now = 1000.0

    def new_node(self, address=None):
        node = Node(self, address=address)
        self.nodes[node.address] = node
        return node

    def run(self):
        while self.timers:
            next_timer = self.timers[0]
            if next_timer.expires > self.now:
                self.now = next_timer.expires
            heapq.heappop(self.timers)
            if next_timer.cancelled:
                continue
            if not next_timer.address or next_timer.address in self.nodes:
                next_timer.callback()

    def stop(self):
        self.timers = []

    def set_timer(self, address, seconds, callback):
        timer = Timer(self.now + seconds, address, callback)
        heapq.heappush(self.timers, timer)
        return timer

    def send(self, sender, destinations, message):
        sender.logger.debug("sending %s to %s", message, destinations)
        # avoid aliasing by making a closure containing distinct deep copy of
        # message for each dest
        def sendto(dest, message):
            if dest == sender.address:
                # reliably deliver local messages with no delay
                self.set_timer(sender.address, 0,
                               lambda: sender.receive(sender.address, message))
            elif self.rnd.uniform(0, 1.0) > self.DROP_PROB:
                delay = self.PROP_DELAY + self.rnd.uniform(-self.PROP_JITTER,
                                                           self.PROP_JITTER)
                self.set_timer(dest, delay,
                               functools.partial(self.nodes[dest].receive,
                                                 sender.address, message))
        for dest in (d for d in destinations if d in self.nodes):
            sendto(dest, copy.deepcopy(message))
رغم أنه غير مشمول في هذا التنفيذ، فإن نموذج المكوّنات يتيح لنا استبدال تنفيذ شبكي حقيقي، يتواصل بين خوادم فعلية على شبكة فعلية، من دون أي تغيير في بقية المكوّنات. ويمكن إجراء الاختبار والتنقيح باستخدام الشبكة المحاكاة، بينما يعمل استخدام المكتبة في الإنتاج فوق أجهزة شبكة حقيقية.
Debugging Support
عند تطوير نظام معقّد مثل هذا، تنتقل الأخطاء سريعاً من أخطاء تافهة، مثل NameError بسيط، إلى إخفاقات غامضة لا تظهر إلا بعد عدة دقائق من تشغيل البروتوكول (المحاكى). وتتبّع أخطاء كهذه ينطوي على العمل انطلاقاً من النقطة التي صار فيها الخطأ واضحاً. والمفكّكات التفاعلية عديمة الفائدة هنا، لأنها لا تستطيع إلا أن تتقدّم بالزمن إلى الأمام.
وأهم ميزة تنقيح في Cluster هي محاكٍ حتمي (deterministic). فبخلاف الشبكة الحقيقية، سيتصرّف تماماً بالطريقة نفسها في كل جولة، معطَىً البذرة نفسها لمولّد الأعداد العشوائية. وهذا يعني أننا نستطيع إضافة فحوص أو مخرجات تنقيح إضافية إلى الشيفرة وإعادة تشغيل المحاكاة لنرى الإخفاق نفسه بتفصيل أكبر.
بالطبع، فإن الكثير من ذلك التفصيل يكمن في الرسائل المتبادلة بين العقد في المجموعة، لذا فتلك الرسائل تُسجَّل تلقائياً بكاملها. ويشمل ذلك التسجيل صنف الدور الذي أرسل الرسالة أو تلقّاها، وكذلك الختم الزمني المحاكى الذي يُحقَن عبر الصنف SimTimeLogger.
class SimTimeLogger(logging.LoggerAdapter):

    def process(self, msg, kwargs):
        return "T=%.3f %s" % (self.extra['network'].now, msg), kwargs

    def getChild(self, name):
        return self.__class__(self.logger.getChild(name),
                              {'network': self.extra['network']})
وغالباً ما يستطيع بروتوكول مرن مثل هذا أن يعمل مدة طويلة بعد إشعال خلل فيه. فمثلاً، أثناء التطوير، سبّب خطأ في الأسماء المستعارة (aliasing) للبيانات إلى أن تتشارك جميع الـ replicas القاموس decisions نفسه. وهذا يعني أن بمجرد معالجة قرار على عقدة ما، رأته جميع العقد الأخرى قراراً محسوماً بالفعل. وبرغم هذا الخلل الجسيم، أنتجت المجموعة نتائج صحيحة لعدة معاملات قبل أن تتجمّد.
والتحققات (assertions) أداة مهمة لالتقاط هذا النوع من الأخطاء مبكراً. وينبغي أن تشمل التحققات أي ثوابت (invariants) ناتجة عن تصميم الخوارزمية، لكن حين لا تتصرّف الشيفرة كما نتوقّع، فإن التحقّق من توقّعاتنا طريقة ممتازة لرؤية أين ذهبت الأمور على غير ما يرام.
    assert not self.decisions.get(self.slot, None), \
            "next slot to commit is already decided"
    if slot in self.decisions:
        assert self.decisions[slot] == proposal, \
            "slot %d already decided with %r!" % (slot, self.decisions[slot])
وتحديد الافتراضات الصحيحة التي نحرص عليها أثناء قراءة الشيفرة جزء من فن التنقيح. ففي هذه الشيفرة من Replica.do_Decision، كانت المشكلة أن Decision الخاصة بالخانة التالية المطلوب تثبيتها كانت تُتجاهَل لأنها موجودة بالفعل في self.decisions. والافتراض الأساسي المنتهك كان أن الخانة التالية المطلوب تثبيتها لم تُحسم بعد. والتحقّق من هذا في بداية do_Decision كشف الخلل وأدى سريعاً إلى الإصلاح. وعلى نحو مماثل، أدّت أخطاء أخرى إلى حالات حُسم فيها مقترحات مختلفة في الخانة نفسها - وهو خطأ جسيم.
وأُضيفت التحققات كثيرة أخرى أثناء تطوير البروتوكول، لكن تلافياً للإطالة لم يبقَ سوى قليل منها.
Testing
في وقت ما خلال السنوات العشر الماضية، صار البرمجة دون اختبارات جنوناً في نهاية المطاف، كالقيادة دون حزام أمان. فالشيفرة دون اختبارات على الأرجح غير صحيحة، وتعديل الشيفرة محفوف بالمخاطر ما لم تكن هناك طريقة لمعرفة ما إذا كان سلوكها قد تغيّر.
وتكون الاختبارات أكثر فاعلية عندما تُنظَّم الشيفرة لأغراض قابلية الاختبار. وهناك مدارس فكرية نشطة قليلة في هذا المجال، لكن النهج الذي اتّخذناه هو تقسيم الشيفرة إلى وحدات صغيرة مترابطة بأقل قدر ممكن، ويمكن اختبارها بمعزل عن بعضها. وهذا يتّفق في جماله مع نموذج الأدوار، حيث يكون لكل دور غرض محدّد ويمكن أن يعمل بمعزل عن الأدوار الأخرى، مما ينتج صنفاً مضغوطاً مكتفياً بذاته.
وكُتب Cluster على نحو يزيد هذا العزل إلى أقصى حد: فكل التواصل بين الأدوار يتم عبر الرسائل، باستثناء إنشاء الأدوار الجديدة. وبذلك، يمكن إلى حدّ كبير اختبار الأدوار بإرسال رسائل إليها ومراقبة استجاباتها.
اختبار الوحدة
الاختبارات الوحدوية لـ Cluster بسيطة وقصيرة:
class Tests(utils.ComponentTestCase):
    def test_propose_active(self):
        """A PROPOSE received while active spawns a commander."""
        self.activate_leader()
        self.node.fake_message(Propose(slot=10, proposal=PROPOSAL1))
        self.assertCommanderStarted(Ballot(0, 'F999'), 10, PROPOSAL1)
تختبر هذه الدالة سلوكاً واحداً (إطلاق commander) لوحدة واحدة (الصنف Leader). وهي تتبع النمط المعروف «رتّب، نفّذ، تحقّق»: هيّئ قائداً نشطاً، وأرسل إليه رسالة، ثم افحص النتيجة.
حقن الاعتماديات
نستخدم تقنية تُسمّى «حقن الاعتماديات» (dependency injection) للتعامل مع إنشاء الأدوار الجديدة. يأخذ كل صنف دور يضيف أدواراً أخرى إلى الشبكة قائمةً من كائنات الأصناف كوسائط للبناء، مع القيم الافتراضية المساوية للأصناف الفعلية. فمثلاً، يبدو باني Leader هكذا:
class Leader(Role):
    def __init__(self, node, peers, commander_cls=Commander, scout_cls=Scout):
        super(Leader, self).__init__(node)
        self.ballot_num = Ballot(0, node.address)
        self.active = False
        self.proposals = {}
        self.commander_cls = commander_cls
        self.scout_cls = scout_cls
        self.scouting = False
        self.peers = peers
وتنشئ الدالة spawn_scout (وكذلك spawn_commander) كائن الدور الجديد باستخدام self.scout_cls:
class Leader(Role):
    def spawn_scout(self):
        assert not self.scouting
        self.scouting = True
        self.scout_cls(self.node, self.ballot_num, self.peers).start()
وتسحر هذه التقنية في أنه، أثناء الاختبار، يمكن إعطاء Leader أصنافاً وهمية، وبالتالي اختباره بمعزل عن Scout وCommander.
صحة الواجهة
ومن محاذير التركيز على الوحدات الصغيرة أنها لا تختبر الواجهات بين الوحدات. فمثلاً، تتحقّق اختبارات الوحدة لدور القابل للقبول من صيغة الصفة accepted في رسالة Promise، وتقدّم اختبارات الوحدة لدور scout قيماً مصاغة على نحو سليم لتلك الصفة. ولا يتحقّق أيّ من الاختبارين من تطابق تلك الصيغ.
وأحد الحلول لهذه المشكلة هو جعل الواجهات تفرض نفسها. وفي Cluster، يتجنّب استخدام الصفوف المسمّاة والوسائط المسمّاة أي خلاف حول صفات الرسائل. ولأن التفاعل الوحيد بين أصناف الأدوار يتم عبر الرسائل، فإن هذا يغطي جزءاً كبيراً من الواجهة.
وللمشكلات المحدّدة مثل صيغة accepted_proposals، يمكن التحقّق من البيانات الحقيقية والبيانات الاختبارية باستخدام الدالة نفسها، وفي حالتنا verifyPromiseAccepted. وتستخدم اختبارات القابل للقبول هذه الدالة للتحقّق من كل Promise مُرجَعة، وتستخدم اختبارات scout منها للتحقّق من كل Promise وهمي.
اختبار التكامل
وآخر حصن ضد مشكلات الواجهة وأخطاء التصميم هو اختبار التكامل. يجمع اختبار التكامل عدة وحدات معاً ويختبر أثرها المُجمَع. وفي حالتنا، يعني ذلك بناء شبكة من عدة عقد، وحقن بعض الطلبات فيها، والتحقّق من النتائج. وإن كانت هناك أي مشكلات في الواجهة لم تُكتشف في اختبارات الوحدة، فينبغي أن تجعل اختبارات التكامل تفشل بسرعة.
ولأن البروتوكول مصمَّم للتعامل مع تعطّل العقد بأمان، فإننا نختبر أيضاً بعض سيناريوهات الإخفاق، بما في ذلك التعطّل المبكر للقائد النشط.
واختبارات التكامل أصعب في الكتابة من اختبارات الوحدة، لأنها أقلّ عزلاً. بالنسبة إلى Cluster، يتّضح هذا في اختبار القائد الفاشل، إذ يمكن لأي عقدة أن تكون القائد النشط. وحتى مع شبكة حتمية، فإن تغيير رسالة واحدة يغيّر حالة مولّد الأعداد العشوائية، وبدذلك يغيّر الأحداث اللاحقة بشكل غير متوقّع. وبدلاً من تثبيت القائد المتوقّع كتابةً، يجب أن تنقّب شيفرة الاختبار في الحالة الداخلية لكل قائد لتجد واحداً يعتقد نفسه نشطاً.
اختبار الضباب
من الصعب جداً اختبار شيفرة متينة: فمن المرجّح أنها متينة تجاه أخطائها هي، لذا قد لا تكتشف اختبارات التكامل أخطاء خطيرة جداً. كما يصعب تخيل اختبارات وبناؤها لكل وضع فشل ممكن.
ومن الأساليب الشائعة لهذه النوعية من المشكلات «اختبار الضباب» (fuzz testing): تشغيل الشيفرة مراراً بمدخلات متغيّرة عشوائياً حتى ينكسر شيء ما. وحين ينكسر شيء ما فعلاً، تصبح كل وسائل التنقيح حيوية: فإذا تعذّر إعادة إنتاج الإخفاق، وكانت معلومات التسجيل غير كافية لإيجاد الخلل، فستعجز عن إصلاحه!
وقد أجريت بعض اختبارات الضباب اليدوية للمجموعة أثناء التطوير، لكن بنية اختبار ضباب كاملة تتجاوز نطاق هذا المشروع.
صراع السلطة
المجموعة التي فيها قادة نشطون كثيرون مكان صاخب جداً، إذ يرسل الكشّافون أرقام اقتراعات متزايدة أبداً إلى القابلين للقبول، دون حسم أي جولات اقتراع. أما المجموعة التي لا قائد نشط فيها فهي هادئة، لكنها معطّلة بالقدر نفسه. وفموازنة التنفيذ بحيث تتفق المجموعة على قائد واحد بالضبط في كل وقت أمر لافت للنظر في صعوبته.
ومن السهل بما يكفي تجنّب القادة المتنازعين: فحين يُسبق القائد، لا بدّ أن يقبل حالة عدم نشطه الجديدة. لكن هذا يقود بسهولة إلى حالة لا يوجد فيها قادة نشطون، بحيث يحاول القائد غير النشط أن يصبح نشطاً في كل مرة يتلقّى فيها رسالة Propose.
وإن لم تتفق المجموعة كلها على أي عضو هو القائد النشط، فالوضع سيئ: فالـ replicas المختلفة ترسل رسائل Propose إلى قادة مختلفين، مما يقود إلى كشّافين يتحاربان. ولهذا من المهم أن تُحسم انتخابات القادة بسرعة، وأن يطّلع جميع أعضاء المجموعة على النتيجة في أقرب وقت ممكن.
وتتعامل Cluster مع ذلك بكشف تغيّر القائد في أقرب وقت ممكن: فحين يرسل قابل للقبول رسالة Promise، فإن فرص أن يكون العضو المُوعود به هو القائد التالي جيدة. وتُكتشف الإخفاقات عبر بروتوكول نبض للحياة.
امتدادات أخرى
بالطبع، هناك طرق كثيرة يمكننا بها توسيع هذا التنفيذ وتحسينه.
اللحاق بالركب
في Multi-Paxos «الخالص»، قد تكون العقد التي تفشل في تلقّي الرسائل متأخّرة عن بقية المجموعة بعدد كبير من الخانات. وما دام لا تُطالَب حالة آلة الحالة الموزّعة إلا عبر انتقالات آلة الحالة، فإن هذا التصميم صالح. أما لقراءة الحالة، فيطلب العميل انتقالاً في آلة الحالة لا يغيّر الحالة فعلاً، لكنه يُرجع القيمة المطلوبة. ويُنفَّذ هذا الانتقال على كامل المجموعة، مما يضمن أنه يُرجع القيمة نفسها في كل مكان، بالاستناد إلى الحالة عند الخانة التي اقترح فيها.
وحتى في الحالة المثلى، هذا بطيء، إذ يتطلّب عدة عمليات ذهاب وإياب لمجرد قراءة قيمة. ولو كان متجر كائنات موزّع يقدّم مثل هذا الطلب لكل وصول إلى كائن، فإن أداءه سيكون بائساً. لكن حين تكون العقدة التي تتلقّى الطلب متأخّرة، فإن تأخّر الطلب أكبر بكثير، إذ يجب على تلك العقدة أن تلحق ببقية المجموعة قبل أن تقدّم اقتراحاً ناجحاً.
ومن الحلول البسيطة تنفيذ بروتوكول بنمط الثرثرة (gossip)، حيث تتواصل كل replica دورياً مع الـ replicas الأخرى لمشاركة أعلى خانة تعرفها ولطلب معلومات عن الخانات المجهولة. وعندئذٍ، حتى لو ضاعت رسالة Decision، ستسرع الـ replica في معرفة القرار من أحد أقرانها.
استخدام الذاكرة المتّسق
تقدّم مكتبة إدارة المجموعات موثوقية في حضور مكوّنات غير موثوقة. ولا ينبغي أن تضيف هي عدم موثوقية خاصة بها. وللأسف، لن تعمل Cluster طويلاً دون أن تتعطّل بسبب النمو المتواصل في استخدام الذاكرة وحجم الرسائل.
وفي تعريف البروتوكول، يشكّل القابلون للقبول والـ replicas «ذاكرة» البروتوكول، لذا عليهم أن يتذكّروا كل شيء. فهذه الأصناف لا تعرف أبداً متى ستتلقّى طلباً يخصّ خانة قديمة، ربما من replica أو قائد متأخّر. ولصيانة الصحّة، تحتفظ بقائمة بكل قرار أُخذ منذ بدء المجموعة. والأسوأ أن هذه القرارات تُنقل بين الـ replicas في رسائل Welcome، ما يجعل هذه الرسائل هائلة في مجموعة طويلة العمر.
ومن التقنيات لمعالجة هذه المشكلة أن نأخذ «نقطة تحقّق» (checkpoint) دورية لحالة كل عقدة، مع الاحتفاظ بمعلومات عن عدد محدود من القرارات. أما العقد التي تأخّرت بحيث لم تثبّت كل الخانات حتى نقطة التحقّق، فعليها أن «تعيد ضبط» نفسها بمغادرة المجموعة والانضمام إليها من جديد.
التخزين الدائم
على حين أن تعطّل أقلية من أعضاء المجموعة مقبول، فإن سماح القابل للقبول بأن «ينسى» أي قيمة قبلها أو أي وعد قطعه ليس مقبولاً.
وللأسف، هذا هو بالضبط ما يحدث حين يعجز عضو مجموعة ويعيد التشغيل: فنسخة Acceptor المُهيّأة حديثاً لا تملك أي سجل بالوعود التي قطعها سابقتها. والمشكلة في أن النسخة التي بدأت حديثاً تحلّ محل القديمة.
وهناك طريقتان لحل هذه المشكلة. أما الحل الأبسط فيتضمّن كتابة حالة القابل للقبول على القرص وإعادة قراءة تلك الحالة عند بدء التشغيل. أما الحل الأعقد فيتمثّل في إزالة أعضاء المجموعة الفاشلين من المجموعة، واشتراط أن تُضاف أعضاء جدد إليها. وهذا النوع من التعديل الديناميكي لعضوية المجموعة يسمّى «تغيير المشهد» (view change).
تغييرات المشهد
يحتاج مهندسو العمليات إلى القدرة على تغيير حجم المجموعات لتلبية متطلبات الحمل والإتاحة. فقد يبدأ مشروع اختبار بسيط بمجموعة مصغّرة من ثلاث عقد، يمكن لأيٍّ منها أن تتعطّل دون أثر. لكن حين ينتقل المشروع إلى «التشغيل الفعلي» (live)، فإن الحمل الإضافي سيتطلّب مجموعة أكبر.
وCluster، على نحوها مكتوبة الآن، لا تستطيع تغيير مجموعة الأقران في مجموعة خوادم دون إعادة تشغيل المجموعة بأكملها. والأفضل لو تستطيع المجموعة الحفاظ على توافق بشأن عضويتها، تماماً كما تفعل بشأن انتقالات آلة الحالة. وهذا يعني أن مجموعة أعضاء المجموعة (أي المشهد view) يمكن تغييرها بمقترحات خاصة لتغيير المشهد. لكن خوارزمية Paxos تعتمد على اتفاق عام بشأن أعضاء المجموعة، لذا علينا تعريف المشهد لكل خانة.
وتعالج Lamport هذا التحدّي في الفقرة الأخيرة من «Paxos Made Simple»:
We can allow a leader to get commands ahead by letting the set of servers that execute instance of the consensus algorithm be specified by the state after execution of the th state machine command. (Lamport, 2001)
والفكرة أن كل نسخة من Paxos (خانة) تستخدم المشهد من خانة أسبق. وهذا يتيح للمجموعة أن تعمل على خانة كحد أقصى في أي لحظة، لذا فإن قيمة صغيرة جداً تحدّ من التوازي، بينما قيمة كبيرة جداً تجعل تغييرات المشهد بطيئة الأثر.
وفي المسودّات المبكرة لهذا التنفيذ (محفوظة بعناية في تاريخ git!)، نفّذت دعماً لتغييرات المشهد (باستخدام بدلاً من 3). وأدت هذه البسيطة ظاهرياً إلى قدر هائل من التعقيد:
- تتبّع المشهد لكل واحد من آخر خانة مثبَّتة ومشاركته على نحو صحيح مع العقد الجديدة،
- تجاهل المقترحات التي لا تتوفّر لها خانة،
- كشف العقد الفاشلة،
- التسلسل الصحيح لعدة تغييرات مشهد متنافسة، و
- نقل معلومات المشهد بين القائد والـ replica.
وكانت النتيجة أكبر بكثير من أن تتّسع لهذا الكتاب!
المراجع
إلى جانب ورقة Paxos الأصلية وورقة Lamport اللاحقة «Paxos Made Simple»[2]، أضاف تنفيذنا امتدادات استلهمناها من عدة مصادر أخرى. وأُخذت أسماء الأدوار من «Paxos Made Moderately Complex»[3]. وكان «Paxos Made Live»[4] مفيداً بقدر ما يخصّ اللقطات تحديداً، بينما وصف «Paxos Made Practical» تغييرات المشهد (وإن لم يكن من النوع الموصوف هنا). ووفّرت ورقة Liskov «From Viewstamped Replication to Byzantine Fault Tolerance»[5] منظوراً آخر لتغييرات المشهد. وأخيراً، كان نقاش على Stack Overflow مفيداً في تعلّم كيفية إضافة الأعضاء وإزالتها من النظام.
L. Lamport, "The Part-Time Parliament," ACM Transactions on Computer Systems, 16(2):133–169, May 1998. ↩︎
L. Lamport, "Paxos Made Simple," ACM SIGACT News (Distributed Computing Column) 32, 4 (Whole Number 121, December 2001) 51-58. ↩︎
R. Van Renese and D. Altinbuken, "Paxos Made Moderately Complex," ACM Comp. Survey 47, 3, Article 42 (Feb. 2015) ↩︎
T. Chandra, R. Griesemer, and J. Redstone, "Paxos Made Live - An Engineering Perspective," Proceedings of the twenty-sixth annual ACM symposium on Principles of distributed computing (PODC '07). ACM, New York, NY, USA, 398-407. ↩︎
B. Liskov, "From Viewstamped Replication to Byzantine Fault Tolerance," In Replication, Springer-Verlag, Berlin, Heidelberg 121-149 (2010) ↩︎